Ein anonymes Modell verbrannte 26 Billionen Tokens in vier Tagen. Die Preisliste kam später: 24 Cent.
Am 20. August 2026 erschien auf OpenRouter ein Modell ohne Labor, ohne Model Card und ohne Preis unter dem Namen stealth/ox-alpha. Vier Tage später hatten OpenCode-Nutzer 26 Billionen Tokens hindurchgeschickt. Sechs Tage später bekannte sich Z.AI dazu: GLM-5.3-Flash, 320 Milliarden Parameter, MIT-Lizenz, 0,15 Dollar pro Million Eingabe-Tokens. Warum Labore Modelle inzwischen ohne eigenen Namen veröffentlichen, was die Traffic-Zahlen wirklich messen und was ein Mischpreis von 24 Cent für Sprachpipelines bedeutet.
Am 20. August 2026 erschien auf OpenRouter ein Modell unter dem Slug stealth/ox-alpha. Kein Labor war angegeben. Keine Model Card, kein Benchmark-Blatt, kein Ankündigungsthread. Im Preisfeld stand 0 Dollar Eingabe, 0 Dollar Ausgabe. Vorhanden waren ein Kontextfenster von 1.048.576 Tokens, Eingabe von Text, Bild und Video sowie eine einzeilige Beschreibung über langfristige Softwareentwicklung.
Vier Tage später teilte OpenCode mit, seine Nutzer hätten 26 Billionen Tokens durch das Modell geschickt.
Sechs Tage später bestätigte Z.AI gegenüber Bloomberg, dass es sich um ein eigenes Modell handelt, veröffentlichte die Gewichte unter MIT-Lizenz und hängte eine Preisliste an: 15 Cent pro Million Eingabe-Tokens, 50 Cent pro Million Ausgabe-Tokens. Der Name lautet GLM-5.3-Flash. Das Wort „Flash" leistet in diesem Satz enorm viel Arbeit, und genau deshalb schreiben wir diesen Beitrag.
Dies ist ein Kommentar, keine Release-Berichterstattung. Es folgen: die Chronologie der sechs Tage samt Traffic-Zahlen und den nötigen Einschränkungen, ein Argument dafür, warum Labore zunehmend Modelle ohne eigenen Namen ausliefern, die Spezifikationen und unabhängigen Bewertungen nach der Enthüllung, eine ausdrückliche Liste der Behauptungen, die wir nicht verifizieren konnten, und eine durchgerechnete Kalkulation, was ein Mischpreis von 24 Cent für die Kosten einer Sprachverarbeitungspipeline bedeutet. Es ist die direkte Fortsetzung unseres Vorher-Nachher-Vergleichs zum Comeback der lokalen Modelle, und es weist in dieselbe Richtung: Der Preis kompetenter Maschinenintelligenz fällt weiter, schneller als die meisten Produkt-Roadmaps annehmen.
Kurzfassung:
- Der Traffic war echt und rekordverdächtig. 26 Billionen Tokens auf OpenCode in vier Tagen über 327.000 eindeutige Nutzer, und 11,6 Billionen auf OpenRouter in drei Tagen — der größte Modellstart in der Geschichte von OpenRouter, gegenüber einem bisherigen Bestwert von 4,4 Billionen.
- Die Identität ist erstquellenmäßig bestätigt. Z.AI teilte Bloomberg am 26. August 2026 mit, dass Ox Alpha ein Modell der GLM-Reihe ist; OpenRouters eigene Seite besagt inzwischen, das Stealth-Listing sei „von ZAI entwickelt und betrieben und als ZAI GLM-5.3-Flash offengelegt" worden.
- Der Preis ist die eigentliche Nachricht. 320 Mrd. Parameter gesamt bei 18 Mrd. aktiven, MIT-Lizenz, 0,15 Dollar Eingabe und 0,50 Dollar Ausgabe pro Million Tokens — gemischt 0,24 Dollar, gegenüber 10,00 Dollar für das geschlossene Flaggschiff von vor sechs Monaten, das es im Intelligence Index von Artificial Analysis um 12,1 Punkte schlägt.
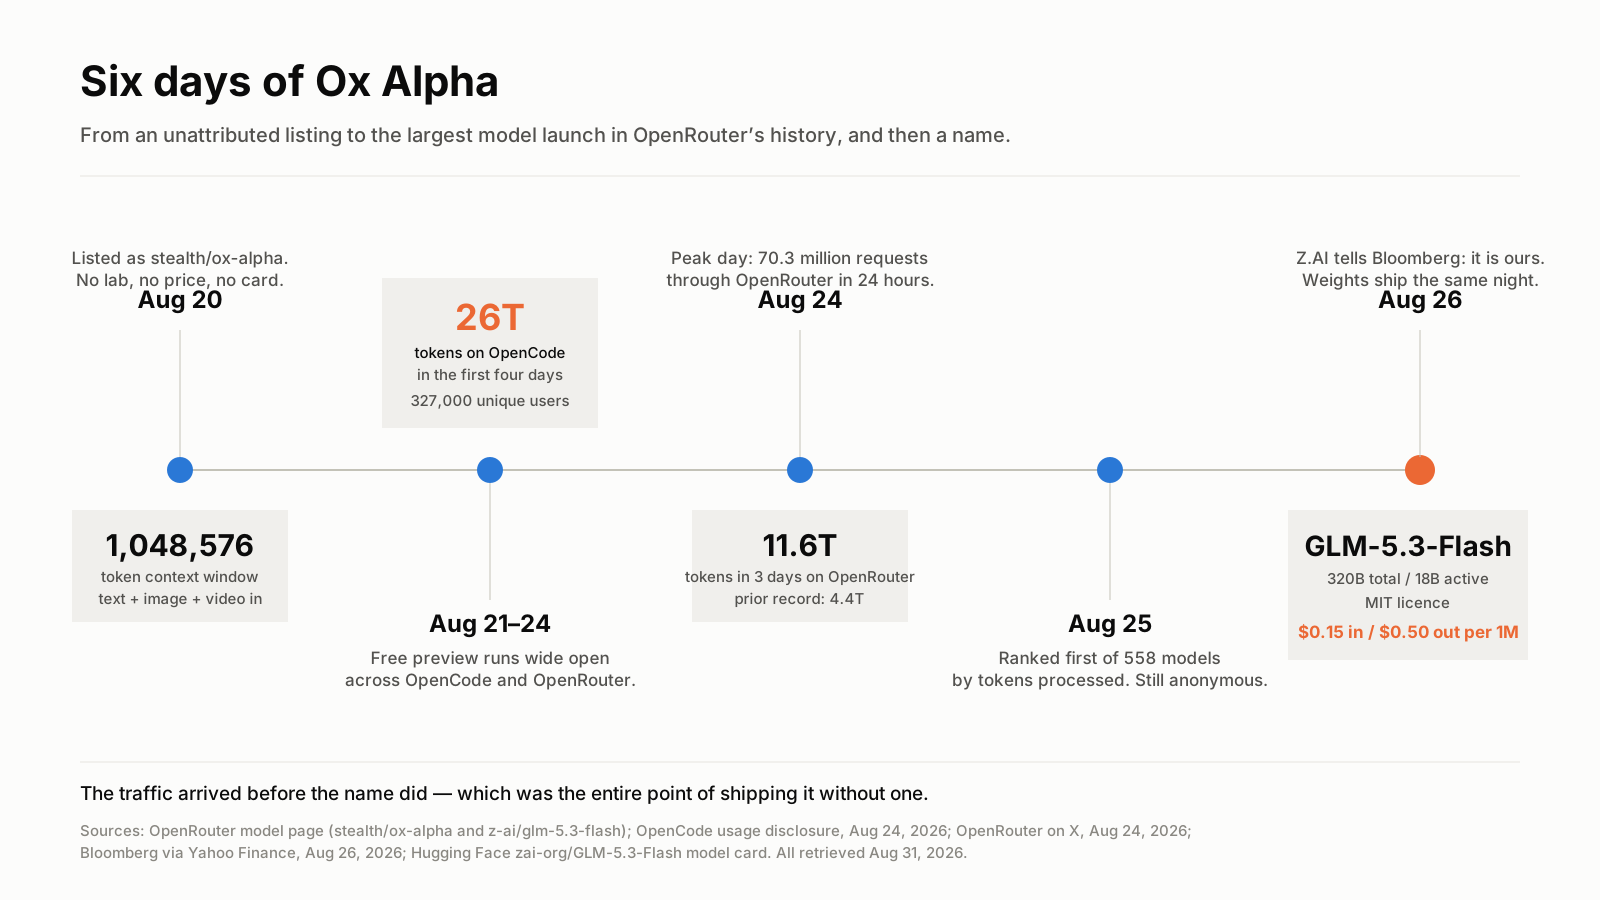
Das ganze Ereignis dauerte von Anfang bis Ende keine Woche. Quellen am Ende des Beitrags.
Sechs Tage, in der Reihenfolge, in der sie geschahen
-
August: Das Listing geht auf OpenRouter live und gleichzeitig innerhalb von OpenCode, dem quelloffenen Terminal-Coding-Agenten von Dax Raad. OpenCode bewirbt es als kostenlos, praktisch unbegrenzt und ohne Datenspeicherung über die eigene Route und gibt an, Kapazität für bis zu 100 Billionen Tokens pro Tag gesichert zu haben.
-
bis 24. August: Die Nutzung steigt an jedem einzelnen Tag. Der Model-Activity-Endpunkt von OpenRouter verzeichnete 27,0 Millionen Anfragen am 21. August, 54,4 Millionen am 22. August (plus 101,2 Prozent), 63,9 Millionen am 23. August und 70,3 Millionen am 24. August.
-
August: OpenCode veröffentlicht die Zahlen. 26 Billionen Tokens in den ersten vier Tagen, über 327.000 eindeutige Nutzer und 8.328.244 abgeschlossene Sitzungen — im Schnitt 3,2 Millionen Tokens pro Sitzung und rund 25 Sitzungen pro Nutzer. Damit lag Ox Alpha auf Platz zwei der von OpenCode erfassten Modelle, hinter DeepSeek V4 Flash mit 33 Billionen und vor Xiaomis MiMo-V2.5 mit 12 Billionen. OpenRouter meldete separat 11,6 Billionen Tokens in den ersten drei vollen Tagen und nannte es den größten Modellstart der Plattformgeschichte; der bisherige Rekordhalter kam im selben Zeitfenster auf 4,4 Billionen.
-
August: Die Models-API von OpenRouter, sortiert nach verarbeiteten Tokens der Vorwoche, führt Ox Alpha auf Platz eins von 558 zurückgegebenen Modellen. Außerhalb des Labors weiß niemand, wer es gebaut hat.
-
August: Z.AI bestätigt gegenüber Bloomberg, dass Ox Alpha ein neues Modell seiner GLM-Reihe ist. Die Gewichte erscheinen noch in derselben Nacht. Im eigenen Launch-Beitrag des Unternehmens heißt es, man habe GLM-5.3-Flash anonym als
ox-alphaauf OpenCode und OpenRouter getestet, „um Nutzer-Feedback zu sammeln". Auch die Stealth-Seite auf OpenRouter wurde ergänzt: Das Modell sei „von ZAI entwickelt und betrieben und als ZAI GLM-5.3-Flash offengelegt" worden.
Die Traffic-Zahl ist echt. Ein Qualitätsurteil ist sie nicht.
Hier ging die meiste Berichterstattung schief, also seien wir präzise: Was genau misst 26 Billionen Tokens?
Sie misst Durchsatz an einem kostenlosen Endpunkt mit einem Millionen-Token-Fenster, verbraucht überwiegend von Coding-Agenten. OpenCodes eigenes Dashboard weist aus, dass 93 Prozent der Eingabe-Tokens aus dem Cache bedient wurden — derselbe Repository-Kontext, über eine lange Sitzung hinweg immer wieder gelesen. Eine Rangliste, die nach verarbeiteten Tokens sortiert, verschafft jedem kostenlosen Modell mit riesigem Fenster einen enormen mechanischen Vorteil, denn Agenten-Harnesses schieben Kontext erneut hinein, wiederholen fehlgeschlagene Tool-Aufrufe und leiten Tool-Ausgaben zurück in den Prompt. Lange Sitzungen blähen die Zahl konstruktionsbedingt auf.
Die Angabe von 100 Billionen Tokens pro Tag verlangt dieselbe Behandlung. Das war OpenCodes Beschreibung der aggregierten Servicekapazität, nicht der gelieferten Nutzung und kein Kontingent pro Nutzer. Die tatsächliche Nutzung lag in den ersten vier Tagen im Schnitt bei etwa 6,5 Billionen Tokens pro Tag — 6,5 Prozent der beworbenen Obergrenze. Der Analyst Teortaxes wies darauf hin, dass die Erzeugung von 100 Billionen Ausgabe-Tokens pro Tag bei 80 Tokens pro Sekunde rund 580.000 GPU-Äquivalente erfordern würde. Genau solche Zahlen sollten einen dazu bringen zu fragen, was da eigentlich gezählt wird, bevor man sie weitergibt.
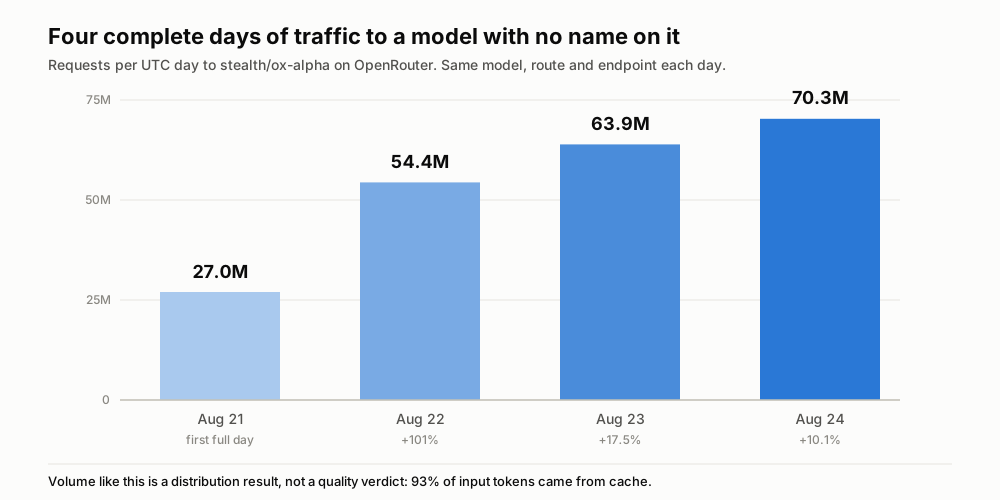
Tägliche Anfragezahlen aus dem Model-Activity-Endpunkt von OpenRouter, Snapshot vom 25. August 2026. Die Plattform kann Werte nachträglich korrigieren.
Was beweist der Traffic also tatsächlich? Dass ein kostenloses Modell in Frontier-Form mit einem Millionen-Token-Fenster, platziert an genau den beiden Orten, an denen Coding-Agenten ohnehin leben, die Nachfrage binnen 24 Stunden sättigt. Das ist ein Distributionsergebnis, und Distributionsergebnisse sind für sich genommen studierenswert. Über die Qualität des Modells in Ihrem Repository sagt es nichts.
Warum ein Labor heute ein Modell ohne eigenen Namen ausliefert
Hier kommt der Punkt, und wir markieren den Übergang deutlich: Alles bisher war Messung, was folgt, ist unsere Lesart davon.
Anonym auszuliefern verschafft einem Labor drei Dinge, die es sich anders nicht kaufen kann. Nennen wir die Kombination die Anonymitätsdividende.
Das Erste ist eine saubere Evaluierung. Jede namentliche Veröffentlichung landet in einer Vorannahme. Ein Modell aus einem chinesischen Labor wird an „erstaunlich gut für ein offenes Modell" gemessen, eines aus einem US-Frontier-Labor an „rechtfertigt das die Preiserhöhung". Nimmt man den Namen weg, bleibt Entwicklerinnen und Entwicklern nur noch die Ausgabe zur Bewertung. Die Einschätzungen, die während der Stealth-Woche zurückkamen, stammten von Menschen, die keine Ahnung hatten, wessen Modell sie da lobten — das teuerste Gut im KI-Marketing, und das billigste, wenn man es schlicht dadurch bekommt, dass man nichts sagt.
Das Zweite ist das Schwungrad. Das Rätsel ist die Kampagne. Niemand schreibt einen forensischen Blogbeitrag über ein Routine-Update, aber eine Woche Tokenizer-Fingerprinting, Serving-Layer-Analyse und Spekulation erzeugt eine enorme Menge Berichterstattung, die das Labor nicht kaufen musste. Die Enthüllung trifft dann auf ein Publikum, das in die Antwort bereits investiert ist. Z.AI bekam eine Woche kostenlose Aufmerksamkeit und danach einen Launch-Tag mit eingebauter Pointe.
Das Dritte ist Telemetrie in einem Umfang, den Geld nur schwer kauft. 8,3 Millionen abgeschlossene Agenten-Sitzungen echter, unordentlicher, produktionsnaher Arbeit sind ein Datensatz. Auf der OpenRouter-Seite von Ox Alpha stand, dass Prompts und Completions vom Anbieter gespeichert und ausdrücklich nicht zum Training verwendet werden — dazu gleich mehr. Doch selbst reine Speicherung liefert Fehlermuster, Latenzverteilungen, Fehlerraten bei Tool-Aufrufen und Degradationskurven über lange Kontexte hinweg, quer über Hunderttausende reale Repositories. Aus einer internen Eval-Suite bekommt man das nicht.
Diese Zeile zu den Datenbedingungen verdient eine eigene Anmerkung, denn sie ist das einzig wirklich Ungewöhnliche an dieser Geschichte. Von den vierzehn Stealth-Listings, die OpenRouter seit April 2025 betrieben hat, trugen dreizehn eine Variante von „Prompts und Completions werden vom Anbieter protokolliert und können zur Verbesserung des Modells verwendet werden". Nur bei Ox Alpha stand stattdessen: gespeichert, nicht zum Training verwendet. Ob Sie das beruhigt, hängt davon ab, wie viel Gewicht Sie einer Textzeile auf der Modellseite einer Routing-Plattform beimessen. Es ist mindestens eine bewusste Entscheidung — und das erste Mal, dass ein Stealth-Listing sie trifft.
Der Codename ist inzwischen ein eigenes Genre
Das ist kein neues Manöver. Es ist ein Muster mit fünf erstquellenmäßig belegten Fällen, und diese Bilanz zu kennen, ist die Voraussetzung dafür, das nächste richtig einzuordnen.
| Codename | Stellte sich heraus als | Bestätigt durch | Datum | Beleg |
|---|---|---|---|---|
| Quasar Alpha | GPT-4.1, OpenAI-Snapshot vor Release | OpenRouters eigener Blog | 14.04.2025 | Erstquelle |
| Optimus Alpha | GPT-4.1, näher an der Endfassung | OpenRouters eigener Blog | 14.04.2025 | Erstquelle |
| Horizon Alpha / Horizon Beta | Frühe GPT-5-Checkpoints | OpenRouter, „GPT-5 is now live" | 07.08.2025 | Erstquelle |
| Sonoma Dusk Alpha / Sonoma Sky Alpha | xAI Grok 4 Fast, ohne und mit Reasoning | Nur Community-Vermutung | — | Berichtet, unbestätigt |
| Hunter Alpha / Healer Alpha | Xiaomi MiMo | Xiaomis eigenes MiMo-Team | 18.03.2026 | Erstquelle |
| Owl Alpha | Meituan LongCat-2.0-Preview | Meituan-Blog und @Meituan_LongCat | 30.06.2026 | Erstquelle |
| Cypher Alpha / Aurora Alpha | Nie aufgeklärt | — | — | Keiner |
| Ox Alpha | Z.AI GLM-5.3-Flash | Z.AI gegenüber Bloomberg; OpenRouter-Seite ergänzt | 26.08.2026 | Erstquelle |
Zwei Dinge fallen aus dieser Tabelle heraus. Sieben der dreizehn historischen Listings wurden am Ende durch eine Erstquelle bestätigt — eine deutlich bessere Aufklärungsquote, als die Folklore nahelegt. Und drei dieser Bestätigungen kamen vom Labor, nicht von OpenRouter, weshalb Zusammenstellungen, die nur den OpenRouter-Blog beobachten, systematisch zu niedrig zählen. Außerdem hat das Genre die Bühne gewechselt. Die Zeilen von 2025 gehören OpenAI und xAI. Die Zeilen von 2026 gehören Xiaomi, Meituan und Z.AI. Chinesische Labore haben den Stealth-Drop nicht erfunden; industrialisiert haben ihn sie.
Die Enthüllung: 320 Mrd. gesamt, 18 Mrd. aktiv, MIT
Jetzt die Spezifikationen, direkt aus der Model Card von Z.AI statt aus irgendjemandes Zusammenfassung.
GLM-5.3-Flash wird von seinen Autoren als „das erste nativ multimodale Modell der GLM-5-Reihe" beschrieben, mit 320 Milliarden Gesamtparametern und 18 Milliarden aktiven in einer Mixture-of-Experts-Konfiguration, trainiert auf einem multimodalen Korpus von 30 Billionen Tokens. Die Architektur kombiniert erstmals in dieser Reihe sparse und lineare Attention und ergänzt sie um eine Technik, die das Paper Manifold-Constrained Hyper-Connections nennt. Das Kontextfenster umfasst 1.048.576 Tokens, die maximale Einzelantwort 131.072 Tokens. Die Reasoning-Tiefe ist als Parameter reasoning_effort mit den Stufen low, high und max zugänglich, Standard ist max. Die Lizenz ist MIT — keine maßgeschneiderte Community-Lizenz mit Nutzerzahl-Schwelle, sondern MIT.
Die eigene Leistungsangabe von Z.AI lohnt das exakte Zitat, denn sie ist zurückhaltender als die Berichterstattung darum herum: Das Modell „übertrifft GLM-5.2 über Benchmarks und reale Workloads hinweg zu einem Zehntel des Preises und nähert sich Claude Opus 4.8 bei Coding- und Agenten-Benchmarks an". Nähert sich an. Nicht: schlägt.
Für eine unabhängige Einschätzung hat Artificial Analysis das Modell inzwischen vermessen. GLM-5.3-Flash erreicht 57 Punkte im Artificial Analysis Intelligence Index, gegenüber einem Median von 29 bei vergleichbaren Open-Weight-Modellen. Der Durchlauf der vollständigen Evaluierungssuite kostete 138,02 Dollar an API-Ausgaben — eine Zahl, die wir zitieren, weil sie in diesem gesamten Beitrag der ehrlichste Einzelwert dafür ist, was Frontier-nahe Intelligenz heute in der Nutzung kostet. Dieselbe Evaluierung markiert zwei echte Schwächen: Mit 45 Ausgabe-Tokens pro Sekunde ist das Modell langsam, und es erzeugte für den Index 150 Millionen Tokens gegenüber einem Median von 110 Millionen, ist also weitschweifig. Weitschweifigkeit ist eine Rechnung, auch wenn der Preis pro Token klein ist.
Dass ein Modell der Flash-Klasse 57 Punkte erreicht, ist die eigentliche Nachricht
Nebeneinandergestellt, mit derselben gemischten 3:1-Konvention aus Eingabe zu Ausgabe, die Epoch AI für Preisvergleiche verwendet.
| Claude Opus 4.6 Max | Qwen3.8-27B | GLM-5.3-Flash | |
|---|---|---|---|
| Veröffentlicht | 05.02.2026 | 14.08.2026 | 26.08.2026 |
| Gewichte | Geschlossen | Apache 2.0 | MIT |
| Intelligence Index | 44,9 | 52,0 | 57 |
| Preis pro 1 Mio. Eingabe | 5,00 $ | 0,45 $ | 0,15 $ |
| Preis pro 1 Mio. Ausgabe | 25,00 $ | 3,20 $ | 0,50 $ |
| Gemischt (3:1) | 10,00 $ | 1,09 $ | 0,24 $ |
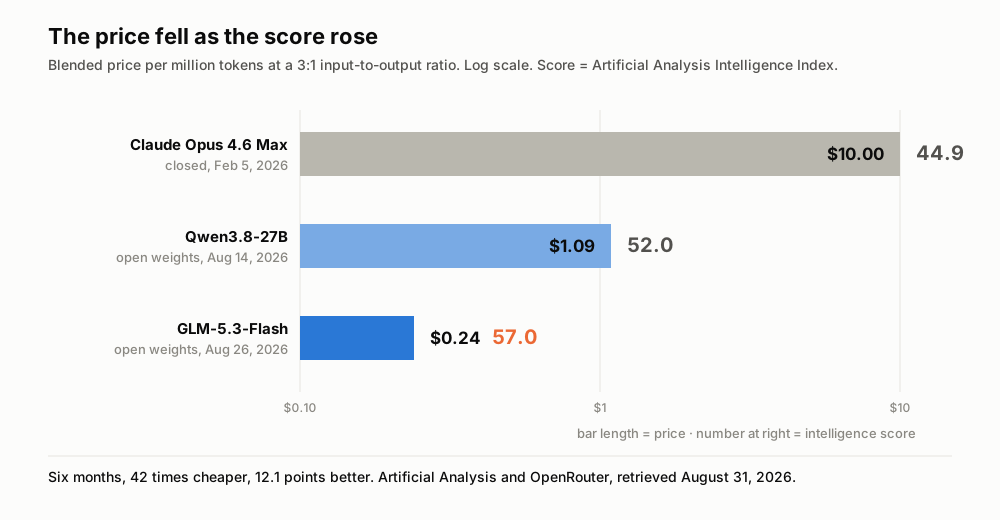
Die Balkenlänge ist der Preis, die Zahl rechts jedes Balkens der Intelligenzwert. Artificial Analysis und OpenRouter, abgerufen am 31. August 2026.
GLM-5.3-Flash kostet 42-mal weniger als das geschlossene Flaggschiff vom Februar und erreicht im selben unabhängigen Index 12,1 Punkte mehr. Gegenüber dem offenen 27B, über das wir vor zehn Tagen geschrieben haben, ist es 4,6-mal günstiger und 5 Punkte besser. Beide Abstände sind innerhalb von sechs Monaten entstanden.
Das ist dieselbe Kurve, die unser Qwen3.8-Beitrag vom anderen Ende her vermessen hat: Epoch AIs Zeitreihe mit festem Schwellenwert, die einen Benchmark-Wert konstant hält und das jeweils günstigste Modell verfolgt, das ihn erreicht, fand für GPT-4-Niveau einen Preisverfall von 37,50 Dollar pro Million Tokens im März 2023 auf 0,18 Dollar im Februar 2025 — 208-mal günstiger in 23 Monaten. GLM-5.3-Flash zeigt, wie diese Kurve aussieht, wenn sie die aktuelle Frontier erreicht statt einer drei Jahre alten.
Und beachten Sie die Klasse. Das ist nicht das Flaggschiff. „Flash" bedeutet in der Namenskonvention jedes Labors das günstige, schnelle Hochvolumen-Geschwistermodell dessen, von dem man eigentlich beeindruckt sein soll. Die interessante Tatsache ist nicht, dass ein chinesisches Labor ein starkes Modell veröffentlicht hat. Sie ist, dass die Budget-SKU der Frontier inzwischen nahe genug kommt, dass eine Woche anonymer Direktvergleiche das Spiel nicht sofort verriet.
Vier Dinge, die wir nicht verifizieren konnten — als solche gekennzeichnet
Die Begeisterung um diese Veröffentlichung eilt an bestimmten Stellen den Belegen voraus. Hier sind sie.
Die Behauptung, Ox Alpha „übertreffe GPT-5.6" in Tests mit einer Million Tokens Kontext, stammt aus Beiträgen Dritter, nicht aus einer veröffentlichten Methodik, die wir prüfen konnten — und Z.AIs eigener Vergleichsmaßstab ist Claude Opus 4.8, nicht GPT-5.6. Behandeln Sie den GPT-5.6-Vergleich als unbestätigte Community-Behauptung.
Der vielzitierte Wert von 80 Prozent DeepSWE pass@1 ist nicht vergleichbar mit den Werten von über 96 Prozent auf SWE-bench Verified, die in denselben Tabellen daneben stehen. Anderes Harness, anderer Aufgabensatz, andere Schwierigkeit. Jede Tabelle, die beide in benachbarte Zeilen setzt, erzeugt eine Rangfolge, die es nicht gibt.
Z.AIs Angabe, die gesamte Stealth-Woche sei auf inländischen chinesischen Beschleunigern ausgeliefert worden, mit dreifacher End-to-End-Serving-Verbesserung und Kosten pro Token vergleichbar mit NVIDIA-Hardware, ist eine Herstellerangabe und wurde nicht unabhängig geprüft. Wenn sie hält, ist sie das folgenreichste Detail der Geschichte; im Moment ist sie eine Pressebehauptung.
Und die kostenlose Vorschau war eine Subvention, keine Preisstufe. Sie ist beendet. Die aktuellen Preise liegen bei 0,15 und 0,50 Dollar, mit einem Aktionsrabatt von 50 Prozent bis zum 9. September 2026, 16:00 UTC — die ehrliche Dauerzahl ist also die unrabattierte, und Sie sollten mit 0,15 / 0,50 Dollar kalkulieren statt mit dem Preis dieser Woche.
Was 24 Cent mit einer Pipeline machen, die zuhört, übersetzt und zusammenfasst
Sprachprodukte sind Token-Preisen ungewöhnlich stark ausgesetzt, weil sie Transkripte erzeugen und diese dann wiederholt lesen. Jeder nachgelagerte Schritt — Bereinigung, Übersetzung, Zusammenfassung, Beantwortung von Fragen — nimmt denselben Text erneut auf. Hier ist die Rechnung, mit allen offengelegten Annahmen.
- Beginnen Sie mit einer realen Arbeitseinheit. Eine 60-minütige Besprechung zu zweit bei etwa 130 Wörtern pro Minute ergibt rund 7.800 Wörter. Mit Sprecherkennzeichnung und Zeitstempeln rechnen wir mit 12.000 Tokens Transkript.
- Fügen Sie den Zusammenfassungsdurchlauf hinzu. Das vollständige Transkript hinein, strukturierte Notizen heraus: 12.000 Eingabe-Tokens, rund 800 Ausgabe-Tokens.
- Fügen Sie Live-Übersetzung in drei Zielsprachen hinzu. Jeder Durchlauf liest das Transkript und schreibt ein vergleichbares Volumen: 12.000 hinein und 12.000 heraus, dreimal.
- Summieren Sie die Besprechung. 48.000 Eingabe-Tokens und 36.800 Ausgabe-Tokens.
- Bepreisen Sie es zweimal. Zu GLM-5.3-Flashs 0,15 / 0,50 Dollar kostet diese Besprechung 2,6 Cent. Zu Claude Opus 4.6 mit 5,00 / 25,00 Dollar kostet dieselbe Besprechung 1,16 Dollar.
Ein Unterschied um den Faktor 45 bei einer einzigen Stunde Audio ist keine Optimierung einer Kostenposition. Es ist der Unterschied zwischen einer Funktion, deren Nutzung man sorgfältig abrechnet, und einer, die man standardmäßig eingeschaltet lässt. Bei 1,16 Dollar pro Besprechung ist die Übersetzung in drei Sprachen für alle Nutzer eine Entscheidung, die jemand aus dem Finanzbereich genehmigen muss. Bei 2,6 Cent ist sie ein Häkchen.
Das ist der Teil der Geschichte, der den Codenamen überlebt. Der Stealth-Drop war ein Marketingmanöver, und ein gutes. Die dauerhafte Tatsache ist, dass die günstige Stufe im Portfolio eines mittelgroßen Labors heute 57 Indexpunkte für gemischte 24 Cent liefert, mit MIT-Lizenz obendrauf, damit Sie es selbst betreiben können, falls sich der Preis je in die falsche Richtung bewegt.
Fazit: Die Frontier ist nicht mehr der Ort mit den interessanten Preisen
Drei Jahre lang lautete die Frage bei der Modellauswahl: „Wie nah an der Frontier können Sie es sich leisten zu sein?" Die sechs Tage von Ox Alpha beantworteten eine andere: Wie viel Leistungsfähigkeit liegt inzwischen unterhalb der Flaggschiff-Klasse, als Massenware bepreist, und wird von Laboren ausgeliefert, die selbstbewusst genug sind, sie ohne ihren Namen zu testen.
Die Anonymitätsdividende zahlt sich nur aus, wenn das Modell gut genug ist, eine markenlose Woche zu überstehen. Z.AI hat kassiert. Der nächste Codename, der auf einer Routing-Plattform auftaucht, verdient dieselbe Behandlung wie Ox Alpha: Lassen Sie ihn auf Ihren eigenen Aufgaben laufen, bevor Ihnen jemand sagt, wessen Modell es ist — denn für diese eine Woche ist das die einzige ehrliche Evaluierung, die irgendjemand bekommt.
Wo Telli.sh hineinpasst: Diese Kurve ist der Grund, warum wir unsere Sprachpipeline auf einer Engine-Provider-Schicht aufbauen statt rund um die API eines einzelnen Anbieters. Telli.sh leitet Transkription, Übersetzung und Zusammenfassung über austauschbare Engines, sodass ein Schritt auf dieser Preiskurve als bessere Notizen zum gleichen Preis ankommt und nicht als Preisankündigung. Was keine Modellveröffentlichung erledigt, ist der Rest der Arbeit: eine Stunde Audio zuverlässig aufzunehmen, Sprecher auseinanderzuhalten, live über 15 Sprachen hinweg zu übersetzen und Notizen zu hinterlassen, die Sie auch im nächsten Quartal noch durchsuchen können.
Quellen
- OpenRouter-Modellseite für
stealth/ox-alpha— Listing-Datum 20. August 2026, 1 Mio. Kontext und der ergänzte Hinweis auf ZAI GLM-5.3-Flash; abgerufen am 31. August 2026 - OpenRouter-Modellseite für
z-ai/glm-5.3-flash— aktuelle Preise und das Aktionsfenster bis zum 9. September 2026; abgerufen am 31. August 2026 - Hugging-Face-Model-Card, zai-org/GLM-5.3-Flash — 320 Mrd. Gesamt- / 18 Mrd. aktive Parameter, multimodaler Korpus mit 30 Billionen Tokens, MIT-Lizenz,
reasoning_effort-Stufen und die Formulierung zur Annäherung an Claude Opus 4.8 - Anonymes Ox Alpha verarbeitet 26 Bio. Tokens auf OpenCode und bricht den OpenRouter-Launch-Rekord — RuntimeWire, 26. August 2026 — 26 Billionen Tokens, 327.000 Nutzer, 8.328.244 Sitzungen, der 93-Prozent-Cache-Wert und OpenRouters Rekord von 11,6 Billionen Tokens
- Ox Alpha: Nutzung, Spezifikationen und Indizien zur Modellidentität — LLM Rumors, 25. August 2026 — tägliche Anfragezahlen und Platz eins von 558 Modellen
- Frontier-Stealth-Modell Ox Alpha erscheint kostenlos auf OpenRouter und OpenCode — WinBuzzer, 24. August 2026 — die Kapazitätsangabe von 100 Billionen Tokens pro Tag und die GPU-Schätzung von Teortaxes
- Chinas Z.AI baute das Stealth-Modell Ox Alpha, das DeepSeek Konkurrenz macht — Bloomberg via Yahoo Finance, 26. August 2026 — die erstquellenmäßige Bestätigung der Identität
- Das Stealth-Modell, das DeepSeek schlug, gehört Zhipu — The Next Web — Berichterstattung zur Enthüllung und zur Zusage offener Gewichte
- OpenRouter-Stealth-Modelle: Wer sie am Ende waren — Digital Applied, 22. August 2026 — die Erhebung über vierzehn Listings, Enthüllungsdaten, Belegstufen und der Vergleich der Datenbedingungen
- Artificial Analysis: GLM-5.3-Flash — Intelligenz, Leistung und Preisanalyse — Intelligence Index 57, Evaluierungskosten von 138,02 Dollar, 45 Tokens pro Sekunde, 150 Mio. erzeugte Tokens; abgerufen am 31. August 2026
- Epoch AI, „LLM inference prices have fallen rapidly but unequally across tasks", 12. März 2025 — die Preisleiter mit festem Schwellenwert hinter der 208-fachen Angabe
- Unser Vorher-Nachher zum Comeback der lokalen Modelle — die Zahlen zu Qwen3.8-27B, die Preiskurve und der Aufholabstand