음성 인식도 조용히 오픈 웨이트가 됐다 — 용량은 1.56GB
알리바바 Qwen3-ASR 모델은 아파치 2.0 라이선스에 52개 언어와 방언을 지원하고, 내려받으면 2기가바이트가 안 됩니다. 오픈 웨이트 전사 계층을 쉬운 말로 정리했습니다. 지금 무엇이 나와 있는지, 내 노트북에서 직접 돌리면 실제로 무엇을 얻는지, 그리고 닫힌 API가 여전히 이기는 지점은 어디인지.
이제 노트북에서도 오픈 웨이트 음성 인식을 실행할 수 있습니다. 알리바바 Qwen 팀이 Apache 2.0 라이선스로 Qwen3-ASR-0.6B, Qwen3-ASR-1.7B와 보조 모델 Qwen3-ForcedAligner-0.6B를 공개했습니다. 가장 작은 파일은 1.56GB이고 52개 언어와 방언을 지원하며, 6월 26일부터 표준 Python 세 줄로 실행할 수 있습니다. 직접 실행하면 요청별 전사 비용을 피할 수 있습니다.
오픈 언어 모델을 지켜본 사람에게 익숙한 변화입니다. 자체 호스팅은 비용, 개인정보 보호, 오프라인 사용을 더 통제하게 해 주고, 호스팅 API는 운영이 더 쉽습니다. 음성 인식도 이제 같은 선택지를 갖추며 발전하고 있습니다.
이 가이드는 오픈 웨이트 음성 인식의 작동 방식, 모델과 라이선스의 차이, 작은 모델을 노트북에서 실행할 때의 조건, 호스팅 API가 여전히 유리한 지점을 설명합니다.
TL;DR:
- 오픈 웨이트 전사는 이미 실전에서 쓸 수 있습니다. Qwen3-ASR은 아파치 2.0에 52개 언어·방언, 위스퍼는 MIT, 엔비디아 패러키트와 캐너리는 CC BY 4.0, 미스트랄 복스트랄은 아파치 2.0입니다.
- 직접 호스팅하면 프라이버시, 오프라인 동작, 비용 통제를 얻습니다. 독립 벤치마크인 Artificial Analysis 기준으로 오픈 모델 호스팅은 1,000분당 1.50달러, 마이크로소프트 MAI-Transcribe-1.5는 6.00달러, Gemini 3.1 Pro Preview는 18.15달러입니다.
- 정확도 1위는 여전히 내려받을 수 없는 닫힌 프리뷰 엔드포인트입니다. 다만 아파치 2.0 오픈 모델인 복스트랄 스몰이 5위에 올라 있고, 1위와의 격차는 단어 오류율 약 1퍼센트포인트입니다.
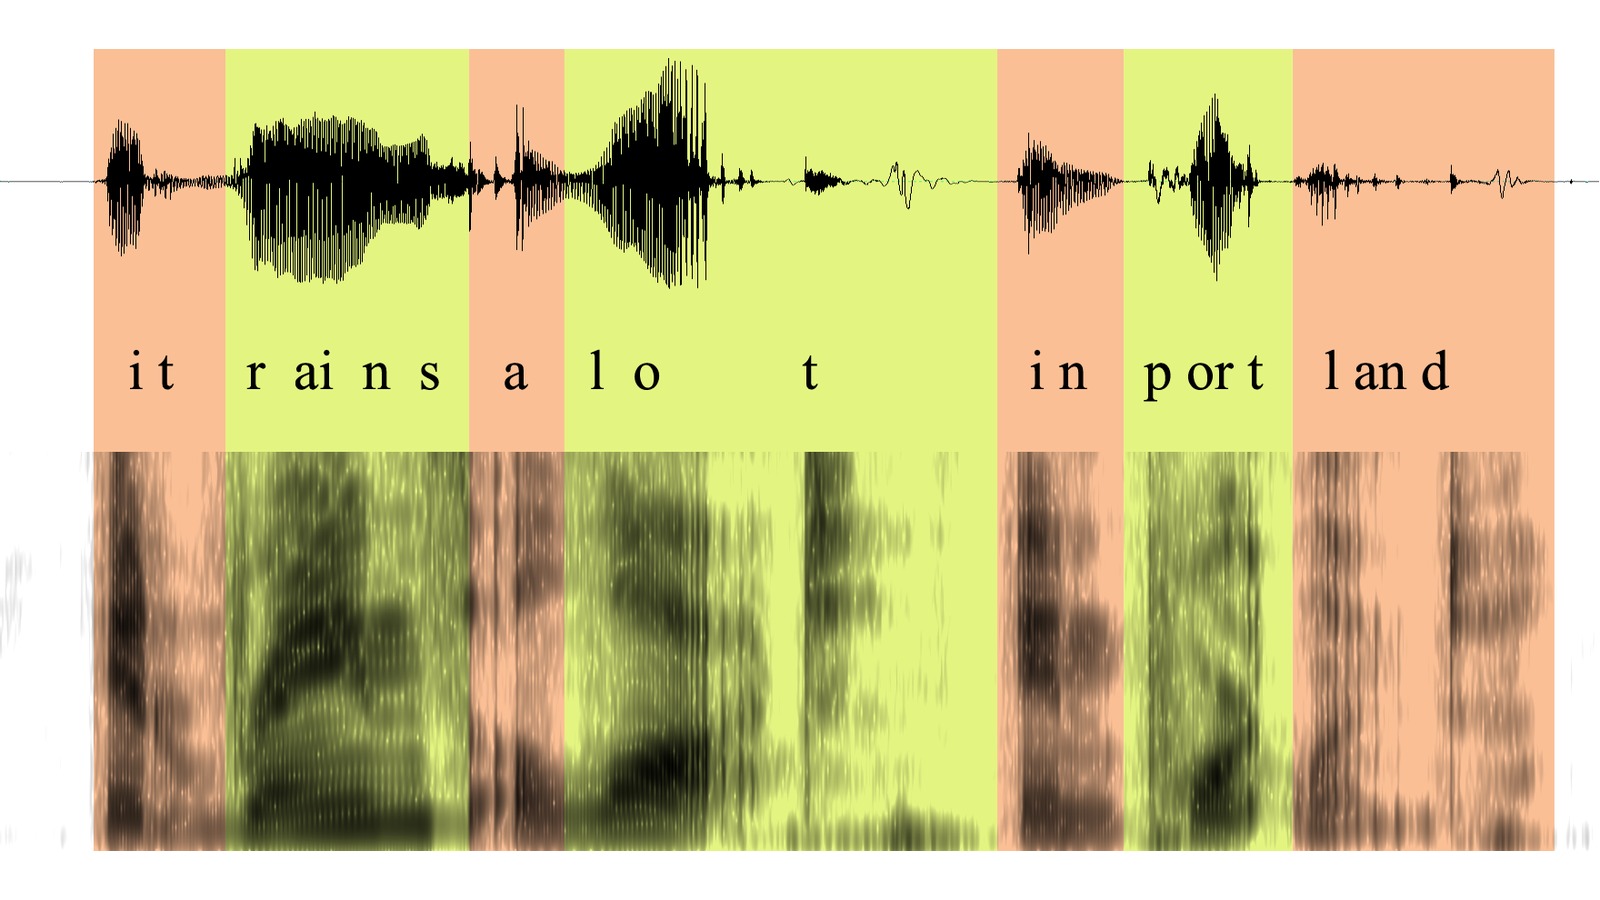
이미지: Aaron Parecki, Wikimedia Commons, CC BY 2.0. "it rains a lot in Portland"라는 문장의 파형과 스펙트로그램이고, 글자가 대응하는 오디오 구간 위에 놓여 있습니다. 모든 음성 인식 모델이 다루는 원재료가 바로 이것입니다.
전사 모델을 내려받는다는 건 뭘 내려받는 걸까
ASR 모델, 즉 자동 음성 인식 모델은 STT나 음성-텍스트 변환과 같은 말로 쓰이는데, 오디오를 넣으면 텍스트를 내놓는 프로그램입니다. 그게 일의 전부입니다. 누가 말했는지 판단하지 않고, 요약하지 않으며, 회의가 무슨 내용이었는지도 모릅니다. 말을 듣고 받아 적을 뿐입니다.
"오픈 웨이트"는 연구소가 완성된 모델 파일 자체를 공개했다는 뜻입니다. 모델의 가중치는 학습 과정에서 익힌 거대한 숫자 격자이고, 이걸 공개했다는 건 그 파일을 내려받아 내 하드웨어에서 돌리고 그 위에 제품을 만들 수 있다는 뜻이죠. 누구의 허락도, 요청당 과금도 필요 없습니다. 반대편은 닫힌 모델입니다. 가중치는 공급사 서버에 남아 있고, 여러분은 API로 접근권을 빌립니다. 오디오를 올리면 텍스트가 돌아오고, 분 단위로 청구됩니다.
이름에 붙은 숫자는 파라미터 수인데, 음성 모델에서는 이 숫자가 유난히 실질적입니다. "0.6B"는 파라미터 6억 개 정도라는 뜻이고, 실제로 Qwen3-ASR-0.6B는 1.56GB 파일, Qwen3-ASR-1.7B는 4.08GB 파일입니다. 둘 다 노트북 SSD에 올려둬도 티가 안 나는 크기죠. 중국 오픈 모델 정리 글에서 다룬 언어 모델과 비교해 보세요. 그쪽 대표 모델은 96개 조각에 1.56테라바이트였고, 로드하는 것만으로도 클러스터가 필요했습니다. 음성 모델은 최전선 텍스트 모델보다 천 배쯤 작고, 이 사실 하나가 이번 변화가 그때보다 더 세게 와닿는 이유입니다.
이 크기 범위를 노트북 티어라고 부르겠습니다. 모델이 작아 시험해 보는 일이 하드웨어 예산 결정이 아니라 다운로드만으로 가능해지는 구간입니다. 대부분의 프런티어 텍스트 모델은 여기에 들지 않지만, 많은 음성 모델은 포함됩니다.
모델을 도입하기 전에 라이선스를 확인하세요. Apache 2.0과 MIT는 사용, 수정, 상업적 배포를 허용합니다. NVIDIA 모델에 쓰이는 CC BY 4.0도 상업적 사용을 허용하지만 출처 표시가 필요합니다.
Qwen은 1월에 냈고, 6월에 쉬워졌다
이제 이 글을 쓰게 만든 그 출시를 볼 차례인데, 알려진 설명 하나는 바로잡아야 합니다. Qwen3-ASR 계열은 6월에 나온 게 아닙니다. 원래 저장소는 2026년 1월 28일에 올라왔고, 기술 보고서는 그다음 날 arXiv에 실렸습니다. 6월 26일에 일어난 일은 Qwen이 세 모델의 -hf 버전을 공개한 것입니다. 허깅페이스 Transformers v5.13.0부터 별도 도구 없이 바로 돌아가는 체크포인트죠.
패키징 변경으로 설정 방식이 더 익숙해졌습니다. Qwen의 qwen-asr 패키지나 vLLM 백엔드를 설치하는 대신 Transformers 사용자는 표준 Python으로 -hf 체크포인트를 불러올 수 있습니다. 인식 기능을 바꾸지 않으면서 설정 부담을 낮춥니다.
사양은 모델 카드에 적힌 그대로입니다. 두 크기 모두 30개 언어에 대해 언어 식별과 음성 인식을 수행합니다. 영어, 중국어, 한국어, 일본어, 스페인어, 아랍어, 힌디어, 태국어, 베트남어, 폴란드어를 포함해 스무 개가 더 있고, 여기에 중국어 방언 22종이 더해져 "52개 언어와 방언"이라는 숫자가 나옵니다. 두 모델 모두 단일 모델로 스트리밍과 오프라인 추론을 함께 지원하는데, 이건 생각보다 드뭅니다. 많은 전사 모델이 둘 중 하나만 하거든요. 긴 오디오도 받고, 카드에는 노래와 배경음악이 깔린 곡까지 지원 오디오 유형으로 적혀 있습니다.
세 번째 모델은 잠깐 멈춰 볼 만합니다. Qwen3-ForcedAligner-0.6B는 강제 정렬을 합니다. 오디오와 전사문을 주면 각 단어가 어디서 시작하고 끝나는지 밀리초 단위로 표시하는데, 11개 언어에 대해 한 번에 최대 5분 분량까지 처리합니다. 클릭하면 그 지점으로 이동하는 전사문, 자막 타이밍, 누가 그 말을 한 순간으로 바로 건너뛰는 기능이 전부 이 기계장치 위에 있습니다. 이 글 맨 위 이미지가 정확히 그 모습이죠. 인식기와 함께 정렬기를 공개했다는 건 이 출시가 누구를 향하는지 보여주는 신호입니다. 데모를 돌려보는 사람이 아니라 제품을 만드는 사람입니다.
품질에 관해서는 누가 무엇을 주장하는지 구분해야 합니다. Qwen 자체 카드는 2026년 6월 26일 자 허깅페이스 Open ASR 리더보드 수치를 싣고 있습니다. 1.7B 모델의 평균 단어 오류율 5.59%, 0.6B는 6.31%이고, 회의 오디오인 AMI 항목은 각각 9.26%와 10.57%입니다. 단어 오류율은 모델이 틀린 단어의 비율이라 낮을수록 좋고, 실제 회의는 지저분하기 때문에 AMI가 그중 가장 어려운 숫자입니다. Qwen은 1.7B를 두고 "오픈소스 ASR 모델 중 최고 성능"이며 상용 API와 견줄 만하다고도 말하는데, 알리바바 바깥에서 누군가 측정하기 전까지는 공급사 주장으로 읽는 게 맞습니다. 그리고 이건 아래에서 볼 독립 리더보드와는 다른 벤치마크이고 다른 오디오를 씁니다. 두 숫자 묶음을 서로 비교해서는 안 됩니다.
시작은 위스퍼였고, 지금도 다들 위스퍼를 돌린다
지금의 모양새는 오픈AI 위스퍼 없이는 없었습니다. 저장소는 2022년 9월 16일에 MIT 라이선스로 공개됐고, 코드와 가중치가 함께였습니다. 제대로 된 음성 인식이라면 클라우드 업체와 계약해야 하던 시절이었죠. 그 뒤로 깃허브 스타 106,679개를 모았습니다.
위스퍼를 중요하게 만든 건 모델 자체보다 커뮤니티가 몇 달 만에 그 위에 쌓아 올린 것들이었습니다. whisper.cpp는 순수 C/C++로 다시 구현해 파이썬도 GPU도 없이 노트북과 휴대폰에서 돌아가게 만들었고, MIT 라이선스에 스타 52,591개입니다. faster-whisper는 CTranslate2 위에 다시 올려 속도와 메모리를 크게 줄였고, 역시 MIT에 스타 24,750개입니다. 모델이 씨앗이었다면 생태계가 나무였습니다.
4년이 지난 지금도 Whisper는 널리 사용됩니다. 2026년 8월 5일 전 30일 동안 whisper-large-v3-turbo는 Hugging Face에서 872만 회, whisper-large-v3는 550만 회 다운로드됐고, Qwen3-ASR-0.6B는 429만 회를 기록했습니다. Artificial Analysis 보드에서 Whisper Large v3의 AA-WER는 4.07%로, 해당 스냅샷의 선두 모델 1.73%보다 높습니다.

오픈 음성 계층은 3년 간격을 두고 두 번의 물결로 왔고, 그 사이는 거의 비어 있습니다. 출시 날짜는 깃허브와 허깅페이스 기준, 2026년 8월 5일 확인.
오픈 진영은 한 곳이 아니다
Qwen만 있는 게 아니고, 나머지도 잘하는 지점이 뚜렷하게 다릅니다.
엔비디아 패러키트 계열은 속도 쪽 승부수입니다. 2025년 8월에 CC BY 4.0으로 나온 parakeet-tdt-0.6b-v3는 파라미터 6억 개 규모로 유럽 25개 언어를 다루고, 언어 자동 감지와 문장부호, 대소문자, 단어 단위 타임스탬프가 기본으로 들어 있으며, 최대 24분 길이 오디오를 한 번에 처리합니다. 엔비디아 캐너리 계열인 canary-1b-v2와 canary-qwen-2.5b도 CC BY 4.0으로, 비슷한 영역을 다른 구조적 선택으로 커버합니다. 미스트랄 복스트랄 모델은 2025년 7월에 아파치 2.0으로 나왔는데, 잠시 뒤에 다룰 이유로 중요합니다.
오픈 진영을 한자리에 놓고 보겠습니다. 마지막 줄은 대조를 위한 호스팅 API입니다.
| 모델 | 내려받기 | 라이선스 | 언어 | 돌아가는 곳 | 가장 잘하는 것 |
|---|---|---|---|---|---|
| Whisper Large v3 | 3.09GB | MIT | 99개 | 노트북 또는 GPU 한 장 | 이미 모든 도구가 지원하는 기본값 |
| Qwen3-ASR-0.6B | 1.56GB | 아파치 2.0 | 방언 포함 52개 | 노트북 | 가장 작은 크기로 다국어 처리 |
| Qwen3-ASR-1.7B | 4.08GB | 아파치 2.0 | 방언 포함 52개 | 노트북 또는 GPU 한 장 | Qwen 계열 중 최고 정확도 |
| Parakeet TDT 0.6B v3 | 2.51GB | CC BY 4.0 | 유럽 25개 | 노트북 또는 GPU 한 장 | 속도와 단어 단위 타임스탬프 |
| Voxtral Small | — | 아파치 2.0 | — | 서버 GPU, 파라미터 240억 | 독립 보드에서 오픈 모델 최고 점수 |
| 호스팅 API | 불가 | 독점 | 제각각 | 공급사 클라우드 | 화자 분리, 스트리밍, 가동 보장 |
다운로드 크기는 각 Hugging Face 저장소의 기본 체크포인트 기준입니다. "—"는 비교에 사용한 자료에서 값을 제공하지 않았다는 뜻입니다. 2026년 8월 5일 스냅샷.
그리고 이 모델들을 실제 기기 위로 올리는 포장 작업이 있습니다. 노트북 티어가 말잔치에서 벗어나는 지점이죠. 애플 하드웨어용으로 컴파일한 위스퍼인 whisperkit-coreml은 지난 30일 동안 831만 회 내려받았습니다. 애플 실리콘용 패러키트 MLX 빌드가 187만 회, 일반 CPU에서 모델을 돌리는 양자화 형식인 GGUF 변환본 두 개가 합쳐서 204만 회와 187만 회였습니다. 매달 수백만 명이 자기 기기에서 돌리려고 특별히 포장된 음성 인식을 내려받고 있습니다. 연구용 호기심이 아닙니다. 유통 경로입니다.
1위는 여전히 내려받을 수 없는 프리뷰 엔드포인트다
이 비교는 인식 정확도와 모델을 직접 실행할 때 얻는 운영상 이점을 구분합니다.
2026년 8월 5일에 Artificial Analysis 음성-텍스트 보드를 확인했습니다. 오픈과 닫힌 모델을 같은 오디오로 재는 독립 벤치마크이고, 오픈 모델끼리 겨루는 허깅페이스 리더보드와는 다릅니다. AA-WER 지수 상위는 이렇습니다.
| 순위 | 모델 | AA-WER | 내려받기 가능? |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1.73% | 불가 — 프리뷰 엔드포인트 |
| 2 | Scribe v2, 일레븐랩스 | 2.18% | 불가 — 호스팅 API |
| 3 | MAI-Transcribe-1.5, 마이크로소프트 | 2.38% | 불가 — 호스팅 API |
| 4 | Smallest AI Pulse Pro | 2.43% | 불가 — 호스팅 API |
| 5 | Voxtral Small, 미스트랄 | 2.77% | 가능 — 아파치 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2.82% | 불가 — 호스팅 API |
| 11 | Whisper Large v3 | 4.07% | 가능 — MIT |
출처: Artificial Analysis 음성-텍스트 리더보드, AA-WER v2, 2026년 8월 5일 확인. 내려받기 가능 여부는 각 모델이 공개한 라이선스를 기준으로 판단했습니다.
상위 네 행을 보면 이 스냅샷에서 점수가 가장 높은 모델은 모두 호스팅 방식이며, 선두 모델은 다운로드 가능한 모델이 아니라 프리뷰 엔드포인트입니다.
그다음 다섯 번째 줄을 읽으시죠. 이번엔 그 반박에 대한 반박입니다. 복스트랄 스몰은 아파치 2.0입니다. 내려받아 내 하드웨어에서 돌리고 상업적으로 팔 수 있는데, 독립 보드에서 2.77%로 5위에 있습니다. 닫힌 프리뷰 모델과의 격차가 단어 오류율로 약 1퍼센트포인트죠. 6,300단어짜리 한 시간 회의로 환산하면 약 66단어 차이입니다. 실재하는 차이지만, 흔히 그려지는 심연은 아닙니다.
많은 작업에서 오픈 음성 모델은 이미 사용할 만한 수준입니다. 남은 결정은 자체 호스팅의 통제력을 위해 작은 정확도 격차를 감수할지, 아니면 호스팅 서비스의 부가 기능이 비용을 정당화하는지입니다.
직접 돌리면 무엇을 얻고 무엇을 치르나
직접 호스팅으로 팀을 밀어붙이는 이유는 세 가지인데, 정확도는 그중에 없습니다.
첫째는 프라이버시이고 보통 결정적입니다. 진료 상담, 법률 인터뷰, 인사 면담을 전사한다면 "오디오가 우리 하드웨어를 벗어나지 않는다"는 선호가 아니라 조달 요건입니다. 직접 호스팅하는 모델만이 이 조건을 깔끔하게 만족합니다. 둘째는 오프라인 동작입니다. 기기 안의 모델은 비행기에서도, 지하실에서도, 공장 바닥에서도, 신호가 없는 현장에서도 돌아갑니다. whisper.cpp와 GGUF 빌드의 다운로드 수가 그만큼 나오는 이유가 정확히 이것입니다.
셋째는 비용이고, 숫자가 노골적입니다. 같은 Artificial Analysis 스냅숏 기준 오디오 1,000분당 가격을 보면, fal.ai에서 호스팅하는 Whisper Large v3가 0.50달러, Replicate의 엔비디아 Canary Qwen 2.5B가 0.74달러, Together AI의 Parakeet TDT 0.6B V3가 1.50달러입니다. 닫힌 쪽은 딥그램 Nova-3가 4.30달러, MAI-Transcribe-1.5가 6.00달러, Gemini 3.1 Pro Preview가 18.15달러입니다. 남의 서버에서 오픈 모델을 돌리는 것만으로 마이크로소프트 대비 4배, 구글 대비 12배 차이입니다. 내 서버에서 직접 돌리는 경우는 아직 계산에 넣지도 않았고, 그쪽은 천 번째 한 시간의 한계비용이 전기요금입니다.
같은 스냅샷의 속도 수치는 Together AI에서 제공되는 Parakeet TDT 0.6B V3가 실시간의 885배로 가장 빠르다고 보여줍니다. 한 시간 분량 오디오를 약 4초 만에 처리하는 속도입니다. Deepgram Nova-3는 512배, Together의 Whisper Large v3는 478배, MAI-Transcribe-1.5는 189배입니다. 목록상 가장 빠른 것은 오픈 웨이트 모델이지만, 이 결과는 로컬 하드웨어가 아니라 Together AI 호스팅을 측정합니다.

애초에 정확도 대 정확도의 싸움이 아니었습니다. 통제권과 비용 대 인식을 감싼 기능들의 싸움입니다.
그럼 호스팅 API는 무엇을 파는 걸까요. 인식이 아닌 전부입니다. 딥그램 문서가 그 목록을 정직하게 보여줍니다. 화자 분리, 실시간 스트리밍, 서식 정리, 사용자 어휘, 개체 마스킹, 언어 감지, 그리고 여러분이 자는 동안에도 서비스가 살아 있다는 보장입니다. Qwen3-ASR을 내려받으면 단어와 타임스탬프를 얻습니다. 화자 라벨은 없고, SLA도 없으며, GPU 요금과 확장과 새벽 3시 호출은 여러분 몫입니다.
이 분야에서 가장 많이 내려받는 모델은 전사 모델이 아니다
다운로드 양상은 전사와 함께 화자 식별에도 수요가 있음을 보여줍니다.
허깅페이스의 자동 음성 인식 분야 전체를 다운로드 순으로 정렬하면 맨 위에 있는 건 위스퍼도, Qwen도, 패러키트도 아닙니다. 지난 30일 891만 회를 기록한 pyannote/speaker-diarization-3.1이고, 또 다른 pyannote 화자 분리 모델이 526만 회로 5위입니다. 화자 분리는 누가 언제 말했는지 알아내는 기계장치, 즉 전사 바로 위의 계층입니다.

오픈 웨이트는 이제 아래 두 계층을 덮습니다. 노트가 쓸 만한지를 결정하는 층은 그 위에 있습니다.
음성 인식 범주에서 가장 많이 다운로드된 모델은 음성을 인식하지 않습니다. 누가 언제 말했는지를 식별합니다. 이런 수요는 화자 라벨이 인식된 단어를 유용한 회의 기록으로 바꾸는 전사 위의 계층을 가리킵니다. 이는 폐쇄형 시장 분석에서 설명한 제품 공백과도 맞닿아 있습니다.
결론
오픈 웨이트 음성 인식에서 흥미로운 질문은 애초에 "닫힌 모델만큼 좋은가"가 아니었습니다. 단어 오류율로 1퍼센트포인트 안쪽까지 왔고, 더 빠르고, 4배에서 12배 저렴하며, 노트북에 들어갑니다. 흥미로운 질문은 전사가 빌려 쓰는 비용 항목이기를 그만둘 때 열리는 공간에 무엇을 지을 것인가입니다. 52개 언어를 알아듣는 1.56GB 파일은 제품이 아니니까요. 방금 공짜가 된 부품입니다.
모델이 아니라 회의 노트 도구를 고르는 팀이라면 읽을 것은 짧습니다. 어떤 제품이 오픈 모델을 쓰는지 닫힌 API를 쓰는지는 이제 대체로 구현 세부사항이고, 점점 둘 다가 될 겁니다. 분량이 많은 일은 오픈 웨이트로, 화자 분리와 스트리밍과 규모가 값을 하는 자리는 호스팅 API로 가겠죠. Telli.sh는 이미 요약 계층에 오픈 모델을 쓰고 있어서, 오픈 진영의 개선이 전사와 번역과 회의 노트로 가격 변동 없이 그대로 흘러 들어옵니다. 도구는 마지막에 나오는 결과물로 판단하세요. 그 노트가 누가 무엇을 하기로 했는지 알려주는지로요.
출처
- Qwen3-ASR-0.6B-hf 모델 카드 (Hugging Face) — 라이선스, 지원 언어, 2026년 6월 26일 자 리더보드 수치
- Qwen3-ASR-1.7B-hf 모델 카드 (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (2026년 1월 29일 제출)
- OpenAI Whisper 저장소 (MIT, 2022년 9월 16일 공개)
- whisper.cpp / faster-whisper
- NVIDIA parakeet-tdt-0.6b-v3 모델 카드 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Artificial Analysis 음성-텍스트 리더보드 — AA-WER v2, 속도·가격 수치는 2026년 8월 5일 확인
- Hugging Face Open ASR Leaderboard
- Deepgram 화자 분리 문서
- Wikimedia Commons 이미지 페이지
