El reconocimiento de voz se volvió open weight en silencio — y cabe en 1,56 GB
Los modelos Qwen3-ASR de Alibaba son Apache 2.0, cubren 52 idiomas y dialectos y pesan menos de dos gigabytes. Una guía en lenguaje llano de la capa de transcripción open weight: qué existe, qué te da realmente ejecutar un modelo en tu propio portátil y dónde siguen ganando las API cerradas.
Ya puedes ejecutar reconocimiento de voz de pesos abiertos en un portátil: el equipo Qwen de Alibaba publica Qwen3-ASR-0.6B, Qwen3-ASR-1.7B y el modelo complementario Qwen3-ForcedAligner-0.6B bajo Apache 2.0. La descarga más pequeña ocupa 1,56 GB, admite 52 idiomas y dialectos y, desde el 26 de junio, puede ejecutarse con tres líneas de Python estándar. Al hacerlo en tu propio equipo, evitas pagar por cada solicitud de transcripción.
El cambio resultará familiar a quienes siguieron los modelos de lenguaje abiertos: alojarlos por cuenta propia ofrece más control sobre el coste, la privacidad y el uso sin conexión, mientras que las API alojadas son más sencillas de operar. El reconocimiento de voz está desarrollando esa misma alternativa, con modelos lo bastante pequeños para ejecutarse localmente.
Esta guía explica qué hace el reconocimiento de voz de pesos abiertos, en qué se diferencian los modelos disponibles y sus licencias, qué puede ejecutar un modelo pequeño y en qué aspectos las API alojadas aún llevan ventaja.
TL;DR:
- La transcripción open weight ya es utilizable: Qwen3-ASR con Apache 2.0 y 52 idiomas y dialectos, Whisper con MIT, Parakeet y Canary de NVIDIA con CC BY 4.0, Voxtral de Mistral con Apache 2.0.
- Autoalojarlo aporta privacidad, funcionamiento sin conexión y control de costes. En la tabla independiente de Artificial Analysis, alojar un modelo abierto cuesta 1,50 dólares por cada 1.000 minutos, frente a 6,00 de MAI-Transcribe-1.5 de Microsoft y 18,15 de Gemini 3.1 Pro Preview.
- El primer puesto en precisión sigue siendo un endpoint cerrado en vista previa. Pero un modelo abierto con Apache 2.0, Voxtral Small, ya ocupa el quinto lugar, a alrededor de un punto de tasa de error de palabra.
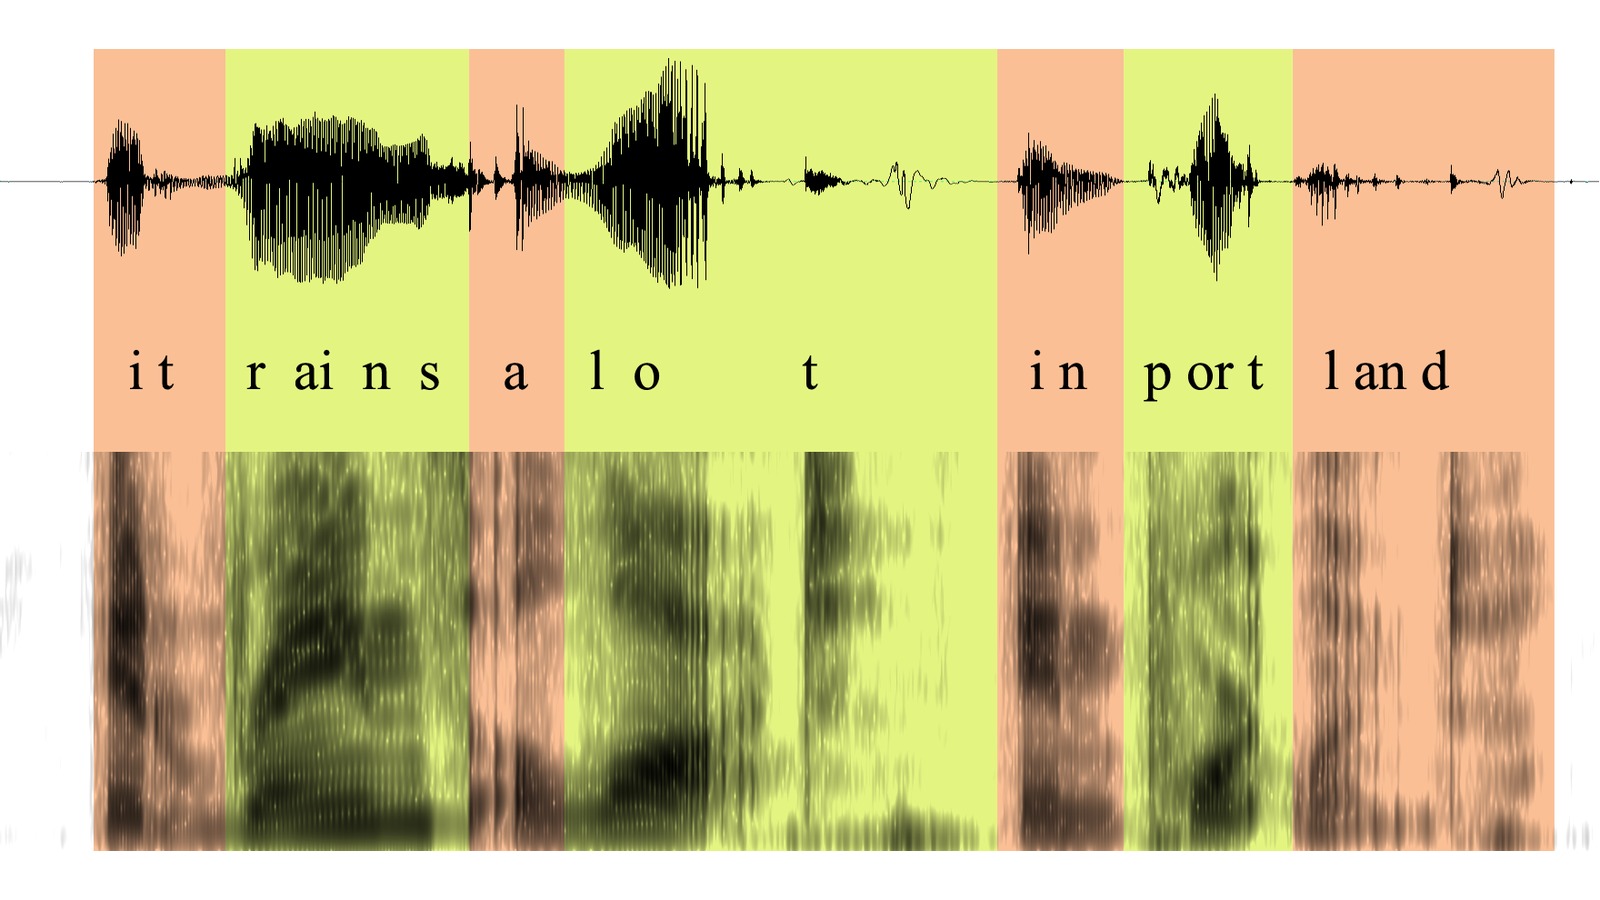
Imagen: Aaron Parecki, Wikimedia Commons, CC BY 2.0. Forma de onda y espectrograma de la frase «it rains a lot in Portland», con las letras colocadas sobre el audio al que corresponden: esta es exactamente la materia prima con la que trabaja todo modelo de reconocimiento de voz.
Qué descargas en realidad cuando descargas un transcriptor
Un modelo ASR —reconocimiento automático del habla, que se usa indistintamente con STT, voz a texto— es un programa que recibe audio y produce texto. Ese es todo su trabajo. No decide quién habló, no resume, no sabe de qué iba tu reunión. Oye palabras y las escribe.
«Open weights» significa que el laboratorio publicó el archivo del modelo terminado. Los pesos de un modelo son la enorme rejilla de números que aprendió durante el entrenamiento, y publicarlos significa que puedes descargar ese archivo, ejecutarlo en tu propio hardware y construir sobre él sin pedir permiso ni pagar por petición. La alternativa es un modelo cerrado: los pesos se quedan en los servidores del proveedor y tú alquilas el acceso mediante una API —el audio sube, el texto vuelve y se factura por minutos.
El número del nombre es el recuento de parámetros y, en los modelos de voz, resulta inusualmente tangible. «0.6B» significa unos 600 millones de parámetros, lo que en la práctica convierte a Qwen3-ASR-0.6B en un archivo de 1,56 GB y a Qwen3-ASR-1.7B en uno de 4,08 GB: ambos lo bastante pequeños como para vivir en el SSD de un portátil sin que nadie se entere. Compáralo con los modelos de lenguaje abiertos de nuestro repaso a China, donde el lanzamiento estrella eran 1,56 terabytes repartidos en 96 fragmentos y hacía falta un clúster solo para cargarlo. Los modelos de voz son unas mil veces más pequeños que los modelos de texto de frontera, y ese solo hecho explica por qué este cambio golpea más fuerte aquí que allí.
Llamemos a este rango de tamaño la categoría portátil: modelos tan pequeños que probarlos implica una descarga, no decidir un presupuesto de hardware. La mayoría de los modelos de texto de frontera quedan fuera; muchos modelos de voz caben en ella.
Comprueba la licencia antes de adoptar un modelo. Apache 2.0 y MIT permiten usarlo, modificarlo y distribuirlo comercialmente; CC BY 4.0, que usan los modelos de NVIDIA, también permite el uso comercial, pero exige atribución.
Qwen publicó la familia en enero; en junio fue cuando se volvió fácil
Qwen3-ASR apareció por primera vez el 28 de enero de 2026 y su informe técnico se publicó en arXiv al día siguiente. El 26 de junio, Qwen publicó las versiones -hf de los tres modelos, compatibles con Hugging Face Transformers desde la versión 5.13.0.
El cambio de empaquetado hace más familiar la configuración: en vez de instalar el paquete qwen-asr de Qwen o un backend de vLLM, quienes usan Transformers pueden cargar los puntos de control -hf con Python estándar. Reduce el coste de configuración sin cambiar lo que reconoce el modelo.
Las fichas de los modelos indican identificación de idioma y reconocimiento en 30 idiomas —entre ellos inglés, chino, coreano, japonés, español, árabe, hindi, tailandés, vietnamita y polaco—, además de 22 dialectos chinos: 52 idiomas y dialectos en total. Ambos tamaños admiten inferencia en streaming y sin conexión con un mismo modelo, aceptan audio largo e incluyen el canto y las canciones con música de fondo entre los tipos de audio compatibles.
Qwen3-ForcedAligner-0.6B añade alineamiento forzado: recibe audio y una transcripción, y marca el inicio y el final de cada palabra con precisión de milisegundos en 11 idiomas, para clips de hasta cinco minutos. Esto permite crear transcripciones interactivas, sincronizar subtítulos y saltar al instante en que se pronunció una palabra. Publicar un alineador junto al reconocedor hace que la familia sea útil para crear productos de transcripción, no solo para ejecutar una demostración.
Las fichas de Qwen publican resultados del Hugging Face Open ASR Leaderboard fechados el 26 de junio de 2026: una tasa media de error de palabra del 5,59 % para el modelo 1.7B y del 6,31 % para el 0.6B; en el subconjunto de audio de reuniones AMI, las cifras son 9,26 % y 10,57 %. Una tasa menor significa menos palabras incorrectas. Qwen describe el modelo 1.7B como el mejor entre los modelos ASR abiertos y competitivo con las API comerciales; son resultados comunicados por el proveedor. El ranking independiente de abajo usa otro audio, así que sus puntuaciones no son directamente comparables.
Whisper empezó todo esto y sigue siendo el modelo que todos ejecutan
Nada de esto existiría con esta forma sin Whisper, de OpenAI. El repositorio se hizo público el 16 de septiembre de 2022 bajo licencia MIT —código y pesos juntos—, en un momento en que el reconocimiento de voz serio significaba un contrato con un proveedor de nube. Desde entonces ha acumulado 106.679 estrellas en GitHub.
Lo que hizo importante a Whisper fue menos el modelo que lo que la comunidad construyó encima en cuestión de meses. whisper.cpp lo reimplementó en C y C++ puros, con licencia MIT, 52.591 estrellas, y consiguió que funcionara en portátiles y teléfonos sin Python y sin GPU. faster-whisper lo reconstruyó sobre CTranslate2 con una gran mejora de velocidad y memoria, MIT también, 24.750 estrellas. El modelo era la semilla; el ecosistema, el árbol.
Cuatro años después, Whisper sigue teniendo un uso extendido. En los 30 días anteriores al 5 de agosto de 2026, whisper-large-v3-turbo se descargó 8,72 millones de veces desde Hugging Face y whisper-large-v3, 5,50 millones; Qwen3-ASR-0.6B alcanzó 4,29 millones. En el ranking de Artificial Analysis, Whisper Large v3 obtuvo un AA-WER del 4,07 %, frente al 1,73 % del líder de esa instantánea.

La capa de voz abierta llegó en dos oleadas separadas por tres años, con casi nada en medio. Fechas de publicación de GitHub y Hugging Face, consultadas el 5 de agosto de 2026.
El lado abierto es más que un laboratorio
Qwen no está solo, y los demás destacan en cosas claramente distintas.
La línea Parakeet de NVIDIA se centra en la velocidad. parakeet-tdt-0.6b-v3, publicado en agosto de 2025 con CC BY 4.0, tiene 600 millones de parámetros, cubre 25 idiomas europeos y admite detección automática del idioma, puntuación, uso de mayúsculas y marcas de tiempo por palabra para audios de hasta 24 minutos por pasada. La familia Canary de NVIDIA —canary-1b-v2 y canary-qwen-2.5b, también con CC BY 4.0— ofrece funciones similares. Los modelos Voxtral de Mistral, publicados en julio de 2025 bajo Apache 2.0, están entre los primeros de la comparación independiente de abajo.
Este es el lado abierto en paralelo, con una API alojada en la última fila a modo de contraste.
| Modelo | Descarga | Licencia | Idiomas | Corre en | Mejor para |
|---|---|---|---|---|---|
| Whisper Large v3 | 3,09 GB | MIT | 99 | Portátil o una GPU | Ser el valor por defecto que ya soporta todo |
| Qwen3-ASR-0.6B | 1,56 GB | Apache 2.0 | 52 con dialectos | Portátil | Multilingüe en el tamaño más pequeño |
| Qwen3-ASR-1.7B | 4,08 GB | Apache 2.0 | 52 con dialectos | Portátil o una GPU | La mejor precisión de la familia Qwen |
| Parakeet TDT 0.6B v3 | 2,51 GB | CC BY 4.0 | 25 europeos | Portátil o una GPU | Velocidad y marcas de tiempo por palabra |
| Voxtral Small | — | Apache 2.0 | — | GPU de servidor, 24.000 M de parámetros | La mejor puntuación abierta de la tabla independiente |
| API alojada | No descargable | Propietario | Variable | La nube del proveedor | Diarización, streaming, disponibilidad |
El tamaño de descarga corresponde al punto de control predeterminado de cada repositorio de Hugging Face. «—» indica que el material utilizado para esta comparación no incluía ese dato. Instantánea consultada el 5 de agosto de 2026.
Luego está el trabajo de empaquetado que lleva estos modelos a dispositivos reales, el punto donde la categoría portátil deja de ser teórica. whisperkit-coreml —Whisper compilado para hardware de Apple— se descargó 8,31 millones de veces en los últimos 30 días. Una compilación MLX de Parakeet para Apple Silicon sumó 1,87 millones, y dos conversiones GGUF —el formato cuantizado que permite ejecutar modelos en CPU corrientes— 2,04 y 1,87 millones. Millones de personas al mes descargan reconocimiento de voz empaquetado específicamente para funcionar en su propia máquina. No es una curiosidad de investigación. Es un canal de distribución.
El primer puesto sigue siendo un endpoint en vista previa que no puedes descargar
La comparación distingue la precisión del reconocimiento de las ventajas operativas de ejecutar un modelo por cuenta propia.
La tabla de voz a texto de Artificial Analysis, consultada el 5 de agosto de 2026, mide modelos abiertos y cerrados sobre el mismo audio. Sus resultados AA-WER v2 incluyen:
| Puesto | Modelo | AA-WER | ¿Descargable? |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1,73 % | No — endpoint en vista previa |
| 2 | Scribe v2, ElevenLabs | 2,18 % | No — API alojada |
| 3 | MAI-Transcribe-1.5, Microsoft | 2,38 % | No — API alojada |
| 4 | Smallest AI Pulse Pro | 2,43 % | No — API alojada |
| 5 | Voxtral Small, Mistral | 2,77 % | Sí — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2,82 % | No — API alojada |
| 11 | Whisper Large v3 | 4,07 % | Sí — MIT |
Fuente: ranking de voz a texto de Artificial Analysis, AA-WER v2, consultado el 5 de agosto de 2026. La disponibilidad para descarga se deduce de la licencia publicada de cada modelo.
Las cuatro primeras filas muestran que los modelos con mejor puntuación de esta instantánea son alojados y que el líder es un endpoint en vista previa, no un modelo descargable.
Voxtral Small tiene licencia Apache 2.0 y ocupa el quinto puesto con un 2,77 %, aproximadamente un punto porcentual por detrás del modelo cerrado en vista previa que lidera la tabla. En una reunión de una hora con 6.300 palabras, esa diferencia equivale a unas 66 palabras. Es una diferencia real, pero no insuperable para los equipos que valoran la ejecución local.
Para muchos usos, los modelos de voz abiertos ya son suficientemente buenos; la decisión restante es si una modesta diferencia de precisión compensa el control del autoalojamiento o si las funciones adicionales de un servicio alojado justifican su coste.
Qué te da ejecutarlo tú y qué te cuesta
Hay tres cosas que empujan a los equipos al autoalojamiento, y ninguna es la precisión.
La privacidad es la primera y suele ser la decisiva. Si transcribes consultas médicas, entrevistas jurídicas o conversaciones de recursos humanos, «el audio no sale de nuestro hardware» no es una preferencia, es un requisito de compra, y un modelo alojado por ti es la única arquitectura que lo cumple limpiamente. El funcionamiento sin conexión es la segunda: un modelo en el dispositivo funciona en un avión, en un sótano, en una nave industrial, en un emplazamiento sin cobertura. Por eso exactamente whisper.cpp y las compilaciones GGUF tienen las cifras de descarga que tienen.
El coste es la tercera, y aquí los números son descarnados. De la misma instantánea de Artificial Analysis, precio por cada 1.000 minutos de audio: Whisper Large v3 alojado en fal.ai cuesta 0,50 dólares, Canary Qwen 2.5B de NVIDIA en Replicate 0,74, y Parakeet TDT 0.6B V3 en Together AI 1,50. En el lado cerrado, Nova-3 de Deepgram está en 4,30, MAI-Transcribe-1.5 en 6,00 y Gemini 3.1 Pro Preview en 18,15. Eso es un factor de 4 frente a Microsoft y de 12 frente a Google solo por alojar un modelo abierto en servidores ajenos, antes de plantearte ejecutarlo en los tuyos, donde el coste marginal de la milésima hora es electricidad.
Las cifras de velocidad de la misma instantánea favorecen a Parakeet TDT 0.6B V3 servido en Together AI, a 885 veces el tiempo real: procesa una hora de audio en unos cuatro segundos. Nova-3 de Deepgram alcanza 512x, Whisper Large v3 en Together llega a 478x y MAI-Transcribe-1.5, a 189x. La opción más rápida de la lista es un modelo de pesos abiertos, aunque este resultado mide el servicio de Together AI, no la ejecución en hardware local.

El dilema nunca fue precisión contra precisión. Es control y coste contra las funciones que envuelven al reconocimiento.
Entonces, ¿qué venden las API alojadas? Todo lo que no es reconocimiento. La documentación de Deepgram es un inventario honesto: diarización de hablantes, streaming en tiempo real, formateo, vocabulario personalizado, ocultación de entidades, detección de idioma y la garantía operativa de que sigue en pie mientras duermes. Si descargas Qwen3-ASR obtienes palabras y marcas de tiempo. Sin etiquetas de hablante, sin SLA, y tuyos son la factura de GPU, el escalado y la llamada de las tres de la madrugada.
El modelo más descargado de la categoría no es un transcriptor
Las descargas también muestran que hay demanda de identificación de hablantes además de transcripción.
Cuando ordenas por descargas toda la categoría de reconocimiento automático del habla de Hugging Face, el modelo que encabeza la lista no es Whisper, ni Qwen, ni Parakeet. Es pyannote/speaker-diarization-3.1, con 8,91 millones de descargas en los últimos 30 días, y un segundo modelo de diarización de pyannote ocupa el quinto puesto con 5,26 millones. La diarización es la maquinaria que averigua quién habló y cuándo: la capa justo por encima de la transcripción.

Los pesos abiertos ya cubren las dos primeras capas de la pila. Las que deciden si una nota sirve están por encima.
El modelo más descargado de la categoría de reconocimiento de voz no reconoce lo que se dice: identifica quién habló y cuándo. Esa demanda apunta a la capa que está por encima de la transcripción, donde las etiquetas de hablante ayudan a convertir las palabras reconocidas en un acta útil. Esto coincide con la brecha de producto descrita en nuestro análisis del mercado cerrado.
En resumen
La pregunta interesante sobre el reconocimiento de voz open weight nunca fue «¿es tan bueno como los modelos cerrados?». Está a alrededor de un punto de tasa de error de palabra, es más rápido, cuesta entre cuatro y doce veces menos y cabe en un portátil. La pregunta interesante es qué construyes en el espacio que se abre cuando la transcripción deja de ser una partida que se alquila, porque un archivo de 1,56 GB que oye 52 idiomas no es un producto. Es un componente que acaba de volverse gratis.
Para un equipo que elige una herramienta de notas de reunión y no un modelo, la lectura práctica es corta. Que un producto ejecute un modelo abierto o una API cerrada es hoy en gran medida un detalle de implementación, y cada vez será las dos cosas: pesos abiertos para el grueso del trabajo y API alojadas donde la diarización, el streaming y la escala se ganan su precio. Telli.sh ya ejecuta un modelo abierto en su capa de resumen, así que las mejoras del lado abierto llegan directas a la transcripción, la traducción y las notas de reunión sin cambio de precio. Juzga la herramienta por lo que sale al final: si la nota te dice quién se comprometió a qué.
Empezar una nota IA en directo
Fuentes
- Ficha del modelo Qwen3-ASR-0.6B-hf (Hugging Face) — licencia, lista de idiomas, cifras del ranking fechadas el 26 de junio de 2026
- Ficha del modelo Qwen3-ASR-1.7B-hf (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (enviado el 29 de enero de 2026)
- Repositorio OpenAI Whisper (MIT, publicado el 16 de septiembre de 2022)
- whisper.cpp y faster-whisper
- Ficha del modelo NVIDIA parakeet-tdt-0.6b-v3 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Ranking de voz a texto de Artificial Analysis — AA-WER v2, cifras de velocidad y precio consultadas el 5 de agosto de 2026
- Hugging Face Open ASR Leaderboard
- Documentación de Deepgram sobre diarización
- Página de la imagen en Wikimedia Commons
