Spracherkennung ist still und leise Open Weight geworden — und passt in 1,56 GB
Alibabas Qwen3-ASR-Modelle stehen unter Apache 2.0, decken 52 Sprachen und Dialekte ab und sind kleiner als zwei Gigabyte. Ein verständlicher Überblick über die Open-Weight-Transkriptionsschicht: was es gibt, was ein Modell auf dem eigenen Laptop wirklich bringt und wo die geschlossenen APIs weiterhin gewinnen.
Sie können Open-Weight-Spracherkennung inzwischen auf einem Laptop ausführen: Alibabas Qwen-Team veröffentlicht Qwen3-ASR-0.6B, Qwen3-ASR-1.7B und den ergänzenden Qwen3-ForcedAligner-0.6B unter Apache 2.0. Der kleinste Download ist 1,56 GB groß, unterstützt 52 Sprachen und Dialekte und lässt sich seit dem 26. Juni mit drei Zeilen Standard-Python ausführen. Wer das Modell auf dem eigenen Rechner betreibt, zahlt keine Transkriptionsgebühr pro Anfrage.
Wer die Entwicklung offener Sprachmodelle verfolgt hat, kennt diesen Wandel: Selbstbetrieb bietet mehr Kontrolle über Kosten und Datenschutz sowie Offline-Nutzung; gehostete APIs sind dafür einfacher zu betreiben. Bei der Spracherkennung entsteht nun dieselbe Wahl, mit Modellen, die klein genug für den lokalen Einsatz sind.
Dieser Leitfaden erklärt, was Open-Weight-Spracherkennung leistet, wie sich verfügbare Modelle und Lizenzen unterscheiden, welche Hardware für ein kleines Modell genügt und wo gehostete APIs weiterhin Vorteile haben.
TL;DR:
- Open-Weight-Transkription ist heute einsatzfähig: Qwen3-ASR unter Apache 2.0 mit 52 Sprachen und Dialekten, Whisper unter MIT, NVIDIAs Parakeet und Canary unter CC BY 4.0, Mistrals Voxtral unter Apache 2.0.
- Selbst hosten bringt Datenschutz, Offline-Betrieb und Kostenkontrolle. Auf dem unabhängigen Board von Artificial Analysis kostet das Hosten eines offenen Modells 1,50 US-Dollar pro 1.000 Minuten, Microsofts MAI-Transcribe-1.5 dagegen 6,00 und Gemini 3.1 Pro Preview 18,15 US-Dollar.
- Platz eins bei der Genauigkeit hält weiterhin ein geschlossener Preview-Endpunkt. Aber ein offenes Apache-2.0-Modell, Voxtral Small, steht inzwischen auf Platz fünf, rund einen Prozentpunkt Wortfehlerrate dahinter.
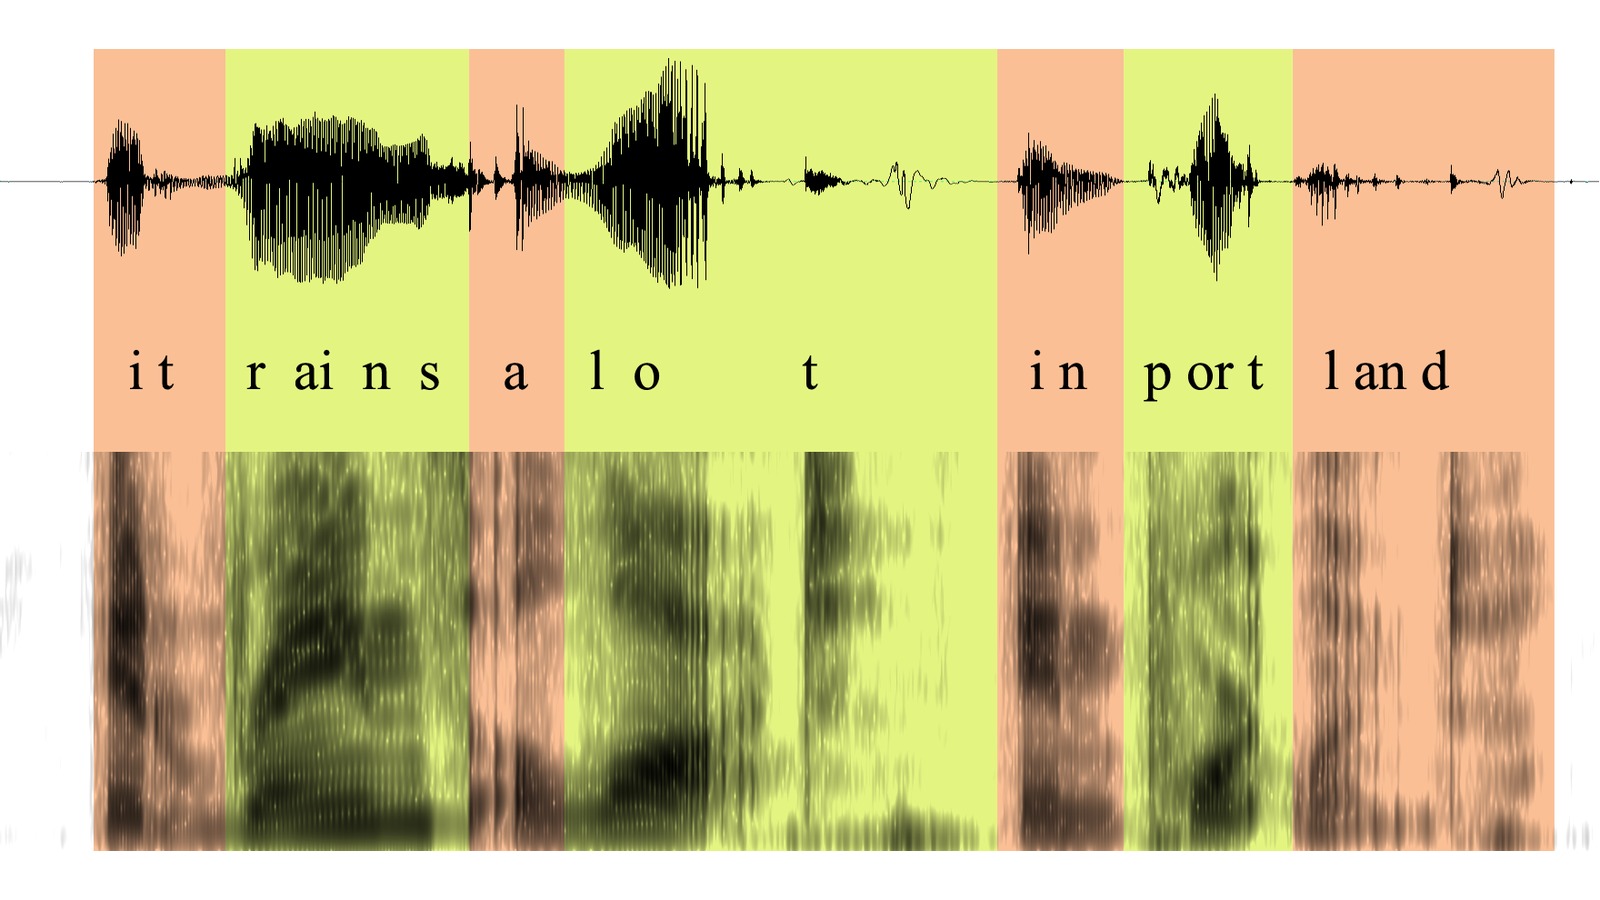
Bild: Aaron Parecki, Wikimedia Commons, CC BY 2.0. Wellenform und Spektrogramm des Satzes "it rains a lot in Portland", die Buchstaben stehen über dem Audio, zu dem sie gehören — genau dieses Rohmaterial verarbeitet jedes Spracherkennungsmodell.
Was Sie eigentlich herunterladen, wenn Sie ein Transkriptionsmodell herunterladen
Ein ASR-Modell — automatische Spracherkennung, gleichbedeutend mit STT, Speech-to-Text — ist ein Programm, das Audio hineinnimmt und Text herausgibt. Das ist die ganze Aufgabe. Es entscheidet nicht, wer gesprochen hat, es fasst nicht zusammen, es weiß nicht, worum es in Ihrer Besprechung ging. Es hört Wörter und schreibt sie auf.
"Open Weights" heißt, dass das Labor die fertige Modelldatei selbst veröffentlicht hat. Die Gewichte eines Modells sind das riesige Zahlenraster, das es beim Training gelernt hat; sie zu veröffentlichen bedeutet, dass Sie diese Datei herunterladen, auf eigener Hardware betreiben und darauf aufbauen können, ohne jemanden um Erlaubnis zu fragen oder pro Anfrage zu zahlen. Die Alternative ist ein geschlossenes Modell: Die Gewichte bleiben auf den Servern des Anbieters, und Sie mieten den Zugang über eine API — Audio geht hoch, Text kommt zurück, abgerechnet wird nach Minuten.
Die Zahl im Namen ist die Parameterzahl, und bei Sprachmodellen ist sie ungewöhnlich handfest. "0.6B" bedeutet rund 600 Millionen Parameter, was in der Praxis heißt: Qwen3-ASR-0.6B ist eine Datei von 1,56 GB, Qwen3-ASR-1.7B eine von 4,08 GB. Beide klein genug, um unbemerkt auf einer Laptop-SSD zu liegen. Vergleichen Sie das mit den offenen Sprachmodellen aus unserem China-Überblick: Dort war die Schlagzeile 1,56 Terabyte in 96 Shards, und schon zum Laden brauchte es einen Cluster. Sprachmodelle sind rund tausendmal kleiner als Text-Spitzenmodelle, und genau deshalb schlägt diese Verschiebung hier härter durch als dort.
Diese Größenklasse nennen wir Laptop-Klasse: Modelle, die klein genug sind, dass der erste Versuch einen Download statt einer Hardware-Budgetentscheidung erfordert. Die meisten führenden Textmodelle gehören nicht dazu; viele Sprachmodelle schon.
Prüfen Sie vor der Einführung eines Modells die Lizenz. Apache 2.0 und MIT erlauben Nutzung, Veränderung und kommerzielle Weitergabe. CC BY 4.0, unter der NVIDIAs Modelle stehen, erlaubt ebenfalls kommerzielle Nutzung, verlangt aber eine Namensnennung.
Qwen hat die Familie im Januar veröffentlicht, im Juni wurde sie einfach
Qwen3-ASR erschien erstmals am 28. Januar 2026; der technische Bericht folgte am nächsten Tag auf arXiv. Am 26. Juni veröffentlichte Qwen -hf-Versionen aller drei Modelle, die mit Hugging Face Transformers ab Version 5.13.0 kompatibel sind.
Die neue Paketierung macht die Einrichtung vertrauter: Statt Qwens Paket qwen-asr oder eines vLLM-Backends können Entwicklerinnen und Entwickler mit Transformers-Erfahrung die -hf-Checkpoints über Standard-Python laden. Das senkt den Einrichtungsaufwand, ändert aber nicht, was das Modell erkennt.
Die Modellkarten nennen Spracherkennung und Sprachauswahl für 30 Sprachen, darunter Englisch, Chinesisch, Koreanisch, Japanisch, Spanisch, Arabisch, Hindi, Thai, Vietnamesisch und Polnisch, sowie 22 chinesische Dialekte: insgesamt 52 Sprachen und Dialekte. Beide Größen unterstützen Streaming und Offline-Inferenz mit demselben Modell, verarbeiten lange Audiodateien und führen Gesang sowie Lieder mit Hintergrundmusik als unterstützte Audiotypen auf.
Qwen3-ForcedAligner-0.6B ergänzt die Familie um Forced Alignment: Aus Audio und Transkript ermittelt es für 11 Sprachen den Start und das Ende jedes Wortes auf die Millisekunde genau, bei Clips mit bis zu fünf Minuten Sprache. Das ermöglicht anklickbare Transkripte, passend getimte Untertitel und Sprünge zu der Stelle, an der ein Wort gesprochen wurde. Ein gemeinsam mit dem Erkenner veröffentlichtes Alignment-Modell macht die Familie auch für den Aufbau von Transkriptionsprodukten nützlich, nicht nur für Demos.
Qwens Modellkarten nennen Ergebnisse des Hugging Face Open ASR Leaderboard vom 26. Juni 2026: eine mittlere Wortfehlerrate von 5,59 % für das 1.7B-Modell und 6,31 % für das 0.6B-Modell; im AMI-Teil mit Besprechungsaufnahmen sind es 9,26 % beziehungsweise 10,57 %. Eine niedrigere Wortfehlerrate bedeutet weniger falsch erkannte Wörter. Qwen bezeichnet das 1.7B-Modell als führend unter den offenen ASR-Modellen und konkurrenzfähig mit kommerziellen APIs; dies sind vom Anbieter gemeldete Ergebnisse. Das unabhängige Board weiter unten nutzt andere Audiodaten, daher sind die Werte nicht direkt vergleichbar.
Whisper hat das angestoßen — und läuft noch immer überall
In dieser Form gäbe es all das ohne OpenAIs Whisper nicht. Das Repository ging am 16. September 2022 unter der MIT-Lizenz online, Code und Gewichte zusammen, zu einer Zeit, in der ernsthafte Spracherkennung einen Vertrag mit einem Cloud-Anbieter bedeutete. Seither hat es 106.679 GitHub-Sterne gesammelt.
Wichtig wurde Whisper weniger durch das Modell als durch das, was die Community binnen Monaten darauf baute. whisper.cpp hat es in schlichtem C und C++ neu implementiert, MIT-lizenziert, 52.591 Sterne, und ließ es ohne Python und ohne GPU auf Laptops und Telefonen laufen. faster-whisper setzte es auf CTranslate2 neu auf, mit deutlichem Gewinn bei Tempo und Speicher, ebenfalls MIT, 24.750 Sterne. Das Modell war der Samen, das Ökosystem der Baum.
Vier Jahre später ist Whisper weiterhin weit verbreitet. In den 30 Tagen vor dem 5. August 2026 wurde whisper-large-v3-turbo 8,72 Millionen Mal und whisper-large-v3 5,50 Millionen Mal von Hugging Face heruntergeladen; Qwen3-ASR-0.6B kam auf 4,29 Millionen Downloads. Auf dem Board von Artificial Analysis erreicht Whisper Large v3 eine AA-WER von 4,07 %, gegenüber 1,73 % für den Spitzenreiter in dieser Momentaufnahme.

Die offene Sprachschicht kam in zwei Schüben im Abstand von drei Jahren, dazwischen fast nichts. Veröffentlichungsdaten von GitHub und Hugging Face, abgerufen am 5. August 2026.
Die offene Seite ist mehr als ein Labor
Qwen ist nicht allein, und die anderen sind in deutlich unterschiedlichen Dingen gut.
NVIDIAs Parakeet-Reihe ist auf Geschwindigkeit ausgelegt. parakeet-tdt-0.6b-v3, veröffentlicht im August 2025 unter CC BY 4.0, hat 600 Millionen Parameter, unterstützt 25 europäische Sprachen und bietet automatische Spracherkennung, Zeichensetzung, Groß- und Kleinschreibung sowie Wortzeitstempel für Audiodateien von bis zu 24 Minuten pro Durchlauf. NVIDIAs Canary-Familie — canary-1b-v2 und canary-qwen-2.5b, ebenfalls unter CC BY 4.0 — bietet ähnliche Funktionen. Mistrals Voxtral-Modelle erschienen im Juli 2025 unter Apache 2.0 und gehören im unabhängigen Vergleich weiter unten zu den Spitzenreitern.
Die offene Seite nebeneinander, mit einer gehosteten API in der letzten Zeile als Kontrast.
| Modell | Download | Lizenz | Sprachen | Läuft auf | Am stärksten bei |
|---|---|---|---|---|---|
| Whisper Large v3 | 3,09 GB | MIT | 99 | Laptop oder eine GPU | Der Standard, den bereits alles unterstützt |
| Qwen3-ASR-0.6B | 1,56 GB | Apache 2.0 | 52 mit Dialekten | Laptop | Mehrsprachigkeit bei kleinster Größe |
| Qwen3-ASR-1.7B | 4,08 GB | Apache 2.0 | 52 mit Dialekten | Laptop oder eine GPU | Beste Genauigkeit der Qwen-Familie |
| Parakeet TDT 0.6B v3 | 2,51 GB | CC BY 4.0 | 25 europäische | Laptop oder eine GPU | Tempo und Zeitstempel je Wort |
| Voxtral Small | — | Apache 2.0 | — | Server-GPU, 24 Mrd. Parameter | Bester offener Wert auf dem unabhängigen Board |
| Gehostete API | Nicht herunterladbar | Proprietär | Unterschiedlich | Cloud des Anbieters | Diarisierung, Streaming, Verfügbarkeit |
Die Downloadgröße entspricht dem Standard-Checkpoint im jeweiligen Hugging-Face-Repository. „—" bedeutet, dass die für diesen Vergleich verwendeten Quellen keinen Wert nannten. Momentaufnahme vom 5. August 2026.
Dann gibt es die Verpackungsarbeit, die diese Modelle auf echte Geräte bringt — der Punkt, an dem die Laptop-Klasse aufhört, theoretisch zu sein. whisperkit-coreml, also Whisper kompiliert für Apple-Hardware, wurde in den letzten 30 Tagen 8,31 Millionen Mal heruntergeladen. Ein MLX-Build von Parakeet für Apple Silicon kam auf 1,87 Millionen, und zwei GGUF-Konvertierungen — jenes quantisierte Format, mit dem Modelle auf gewöhnlichen CPUs laufen — auf zusammen 2,04 und 1,87 Millionen. Millionen Menschen pro Monat laden Spracherkennung herunter, die eigens dafür verpackt wurde, auf ihrer eigenen Maschine zu laufen. Das ist keine Forschungskuriosität. Das ist ein Vertriebskanal.
Platz eins ist weiterhin ein Preview-Endpunkt, den Sie nicht herunterladen können
Der Vergleich trennt Erkennungsgenauigkeit von den betrieblichen Vorteilen, ein Modell selbst auszuführen.
Das Speech-to-Text-Board von Artificial Analysis, abgerufen am 5. August 2026, misst offene und geschlossene Modelle mit denselben Audiodaten. Die AA-WER-v2-Ergebnisse umfassen:
| Rang | Modell | AA-WER | Herunterladbar? |
|---|---|---|---|
| 1 | Fun-Realtime-ASR-preview | 1,73 % | Nein — Preview-Endpunkt |
| 2 | Scribe v2, ElevenLabs | 2,18 % | Nein — gehostete API |
| 3 | MAI-Transcribe-1.5, Microsoft | 2,38 % | Nein — gehostete API |
| 4 | Smallest AI Pulse Pro | 2,43 % | Nein — gehostete API |
| 5 | Voxtral Small, Mistral | 2,77 % | Ja — Apache 2.0 |
| 6 | Gemini 3.1 Pro Preview, High | 2,82 % | Nein — gehostete API |
| 11 | Whisper Large v3 | 4,07 % | Ja — MIT |
Quelle: Speech-to-Text-Leaderboard von Artificial Analysis, AA-WER v2, abgerufen am 5. August 2026. Die Verfügbarkeit zum Download ergibt sich aus der veröffentlichten Lizenz des jeweiligen Modells.
Die ersten vier Zeilen zeigen: Die bestbewerteten Modelle dieser Momentaufnahme werden gehostet, und der Spitzenreiter ist ein Preview-Endpunkt statt eines herunterladbaren Modells.
Voxtral Small steht unter Apache 2.0 und belegt mit 2,77 % den fünften Platz, rund einen Prozentpunkt hinter dem geschlossenen Preview-Modell an der Spitze. Bei einer einstündigen Besprechung mit 6.300 Wörtern entspricht dieser Abstand ungefähr 66 Wörtern. Das ist ein realer Unterschied, aber kein unüberwindbarer für Teams, denen der lokale Betrieb wichtig ist.
Für viele Aufgaben sind offene Sprachmodelle bereits gut nutzbar. Die verbleibende Entscheidung lautet, ob ein moderater Genauigkeitsabstand die Kontrolle durch Selbstbetrieb wert ist oder ob die zusätzlichen Funktionen eines gehosteten Dienstes dessen Kosten rechtfertigen.
Was Selbstbetrieb bringt und was er kostet
Drei Dinge treiben Teams zum Selbsthosten, und keines davon ist Genauigkeit.
Datenschutz ist das erste und meist ausschlaggebende. Wer ärztliche Gespräche, juristische Interviews oder Personalgespräche transkribiert, für den ist "das Audio verlässt unsere Hardware nicht" keine Vorliebe, sondern eine Beschaffungsvorgabe — und nur ein selbst betriebenes Modell erfüllt sie sauber. Offline-Betrieb ist das zweite: Ein Modell auf dem Gerät funktioniert im Flugzeug, im Keller, in der Werkshalle, an einem Einsatzort ohne Empfang. Genau deshalb haben whisper.cpp und die GGUF-Builds die Downloadzahlen, die sie haben.
Kosten sind das dritte, und hier sind die Zahlen deutlich. Aus derselben Momentaufnahme von Artificial Analysis, Preis je 1.000 Minuten Audio: Whisper Large v3 auf fal.ai kostet 0,50 US-Dollar, NVIDIAs Canary Qwen 2.5B auf Replicate 0,74, Parakeet TDT 0.6B V3 auf Together AI 1,50. Auf der geschlossenen Seite: Deepgrams Nova-3 4,30, MAI-Transcribe-1.5 6,00 und Gemini 3.1 Pro Preview 18,15 US-Dollar. Das ist der Faktor 4 gegenüber Microsoft und der Faktor 12 gegenüber Google — allein dafür, ein offenes Modell auf fremden Servern zu betreiben, bevor man den Eigenbetrieb überhaupt betrachtet, bei dem die Grenzkosten der tausendsten Stunde aus Strom bestehen.
Die Geschwindigkeitswerte derselben Momentaufnahme sprechen für Parakeet TDT 0.6B V3, gehostet auf Together AI: 885-fache Echtzeit, also etwa vier Sekunden für eine Stunde Audio. Deepgrams Nova-3 erreicht das 512-Fache, Whisper Large v3 auf Together das 478-Fache und MAI-Transcribe-1.5 das 189-Fache. Die schnellste aufgeführte Option ist ein offenes Modell, doch gemessen wurde der Betrieb auf Together AI, nicht auf lokaler Hardware.

Die Abwägung war nie Genauigkeit gegen Genauigkeit. Sie lautet Kontrolle und Kosten gegen die Funktionen rund um die Erkennung.
Was verkaufen die gehosteten APIs dann noch? Alles, was nicht Erkennung ist. Deepgrams Dokumentation ist eine faire Bestandsaufnahme: Sprecherdiarisierung, Echtzeit-Streaming, Formatierung, eigenes Vokabular, Schwärzung von Entitäten, Spracherkennung — und die betriebliche Zusage, dass der Dienst läuft, während Sie schlafen. Laden Sie Qwen3-ASR herunter, bekommen Sie Wörter und Zeitstempel. Keine Sprecherlabels, kein SLA, und Ihnen gehören die GPU-Rechnung, die Skalierung und der Anruf um drei Uhr nachts.
Das meistgeladene Modell der Kategorie ist gar kein Transkriptionsmodell
Auch die Downloadzahlen zeigen, dass neben Transkription Bedarf an Sprecheridentifikation besteht.
Sortiert man Hugging Faces gesamte Kategorie für automatische Spracherkennung nach Downloads, steht ganz oben weder Whisper noch Qwen noch Parakeet. Es ist pyannote/speaker-diarization-3.1 mit 8,91 Millionen Downloads in den letzten 30 Tagen, und ein zweites pyannote-Diarisierungsmodell belegt mit 5,26 Millionen Platz fünf. Diarisierung ist die Mechanik, die herausfindet, wer wann gesprochen hat — die Schicht direkt über der Transkription.

Offene Gewichte decken inzwischen die ersten beiden Schichten ab. Die Schichten, die über die Brauchbarkeit einer Notiz entscheiden, liegen darüber.
Das meistgeladene Modell der Spracherkennungskategorie erkennt keine Sprache, sondern identifiziert, wer wann gesprochen hat. Diese Nachfrage verweist auf die Ebene über der Transkription: Sprecherlabels helfen dabei, erkannte Wörter in ein nützliches Meeting-Protokoll zu verwandeln. Das deckt sich mit der Produktlücke, die unsere Analyse des geschlossenen Marktes beschreibt.
Das Fazit
Die interessante Frage zu Open-Weight-Spracherkennung war nie, ob sie so gut ist wie die geschlossenen Modelle. Sie liegt rund einen Prozentpunkt Wortfehlerrate dahinter, sie ist schneller, sie ist vier- bis zwölfmal günstiger, und sie passt auf einen Laptop. Die interessante Frage ist, was Sie in den Raum bauen, der sich auftut, wenn Transkription aufhört, ein gemieteter Kostenpunkt zu sein — denn eine 1,56-GB-Datei, die 52 Sprachen hört, ist kein Produkt. Sie ist ein Bauteil, das gerade kostenlos geworden ist.
Für ein Team, das ein Meeting-Notiz-Werkzeug statt eines Modells auswählt, fällt die praktische Lesart kurz aus. Ob ein Produkt ein offenes Modell oder eine geschlossene API betreibt, ist inzwischen weitgehend ein Implementierungsdetail, und zunehmend wird es beides sein: offene Gewichte für die Masse der Arbeit, gehostete APIs dort, wo Diarisierung, Streaming und Skalierung ihren Preis rechtfertigen. Telli.sh betreibt in seiner Zusammenfassungsschicht bereits ein offenes Modell, sodass Fortschritte auf der offenen Seite ohne Preisänderung direkt in Transkription, Übersetzung und Besprechungsnotizen einfließen. Beurteilen Sie das Werkzeug an dem, was am Ende herauskommt: ob die Notiz Ihnen sagt, wer was zugesagt hat.
Quellen
- Modellkarte Qwen3-ASR-0.6B-hf (Hugging Face) — Lizenz, Sprachliste, Leaderboard-Werte mit Stand 26. Juni 2026
- Modellkarte Qwen3-ASR-1.7B-hf (Hugging Face)
- Qwen3-ForcedAligner-0.6B (Hugging Face)
- Qwen3-ASR Technical Report, arXiv:2601.21337 (eingereicht am 29. Januar 2026)
- OpenAI-Whisper-Repository (MIT, veröffentlicht am 16. September 2022)
- whisper.cpp und faster-whisper
- Modellkarte NVIDIA parakeet-tdt-0.6b-v3 (CC BY 4.0)
- Mistral Voxtral-Small-24B-2507 (Apache 2.0)
- Speech-to-Text-Leaderboard von Artificial Analysis — AA-WER v2, Tempo- und Preiswerte abgerufen am 5. August 2026
- Hugging Face Open ASR Leaderboard
- Deepgram-Dokumentation zur Sprecherdiarisierung
- Bildseite bei Wikimedia Commons
