40+ языков в переводе вживую, удалённых при завершении звонка: многоязычная транскрипция — тот слой, который сохраняет встречу
16 апреля 2026 года DeepL выпустила Voice-to-Voice более чем для 40 языков, а в FAQ того же продукта сказано, что данные встречи «обрабатываются временно в памяти и удаляются после завершения звонка». 28 августа Open ASR Leaderboard добавил первый язык Глобального Юга и показал, что две модели, идущие вровень на 4,9 WER, различаются почти вчетверо в том, насколько их точность зависит от того, откуда родом говорящий. Перевод встреч в реальном времени становится массовым товаром. Запись — нет.
16 апреля 2026 года DeepL запустила из Кёльна Voice-to-Voice — набор продуктов для перевода речи в реальном времени, охватывающий четыре поверхности: виртуальные встречи, разговоры на мобильных устройствах и в вебе, групповые сценарии для сотрудников на местах и корпоративный API. Он работает более чем с 40 языками, включая все 24 официальных языка ЕС, а также вьетнамский, тайский, арабский, норвежский, иврит, бенгальский и тагальский. В слепых оценках, которые провела Slator по заказу DeepL, 96% лингвистов предпочли его встроенному переводу Google, Microsoft и Zoom; DeepL Voice для Zoom набрал 96,4 из 100 против 87–89 у конкурирующих платформ.
Это серьёзный продукт, и интересен здесь не запуск. Интересна одна фраза в FAQ на той же странице продукта, которую мы перечитали 31 августа 2026 года:
«DeepL не хранит данные транскрипции и перевода на постоянной основе. Данные встречи обрабатываются временно в памяти и удаляются после завершения звонка».
Прочитайте эти два факта рядом. Перевод превосходен — и этого перевода уже нет к ужину.
Коротко
- В 2026 году перевод встреч в реальном времени перешёл из разряда трудных задач в разряд поставленного массового товара: более 40 языков у DeepL, 58 отдельных языков в Nova-3 от Deepgram, живой перевод внутри Google Meet.
- То, что ничего не сохраняется, — обычно осознанное решение о приватности, а не дефект. Но это значит, что сама встреча не оставляет ни одного артефакта, который можно перечитать.
- Многоязычная транскрипция — это отдельный слой ниже. Он удерживает вместе, в одной проверяемой записи, транскрипт на языке оригинала, перевод, разметку говорящих и резюме. Эта статья о том, почему выжить должен именно язык оригинала и как вести встречу, чтобы он выжил.
Версию этого аргумента про Google мы написали в июне, когда Meet и Translate выталкивали живой перевод речи в массовый рынок: почему многоязычным встречам по-прежнему нужны проверяемые заметки. С тех пор рынок ответил на вопрос, который мы только ставили. Живой перевод теперь работает. Значит, интересный вопрос сместился: что у вас останется в понедельник?
Перевод встреч в реальном времени перестал быть трудной частью
Около десяти лет живая многоязычная речь была той демонстрацией, которая не выживала при столкновении с настоящей встречей. Задержка съедала очерёдность реплик, акценты ломали распознавание, а всё сколько-нибудь техническое выходило искажённым. Эта эпоха закончилась примерно за десять месяцев.
Nova-3 от Deepgram в примечании к релизу от 10 декабря 2025 года указывала 31 язык, а в документации за август 2026 года — 58: 39 задокументированных добавлений менее чем за девять месяцев, примерно один новый язык каждые семь дней. Мы разобрали это расширение и мелкий шрифт под ним в материале что на самом деле скрывает слово «поддерживается» в языковом покрытии распознавания речи. Google встроила живой перевод речи в Meet. DeepL в апреле выпустила голосовой набор из четырёх поверхностей.
Заявления о качестве теперь достаточно конкретны, чтобы с ними спорить, — и это само по себе признак зрелости. Заказанная DeepL оценка Slator сообщает о частоте ошибок 4% у DeepL Voice против средних 17% у конкурирующих платформ для встреч, а также о 96,4/100 для Zoom и 96,3/100 для Teams. Цифры, заказанные вендором, следует воспринимать как цифры, заказанные вендором. Но само направление сомнений не вызывает, и добросовестная пресса указывает туда же: The Next Web в материале от 17 апреля 2026 года описала живую демонстрацию в Сеуле с задержкой в одну-две фразы и привела признание директора по продукту DeepL, что различия в порядке слов между языками остаются фундаментальным ограничением скорости для перевода «речь в речь».
Задержки в одну-две фразы достаточно. Её недостаточно, чтобы заменить профессионального переводчика на переговорах по договору, и никто этого не утверждает. Её с запасом хватает для вторничной продуктовой синхронизации между Варшавой, Сеулом и Сан-Паулу — а именно такие встречи у большинства из нас и бывают.
Суть вот в чём: когда способность становится настолько хорошей настолько быстро, узкое место смещается. Оно уже сместилось. Теперь оно на слой ниже — в том, что встреча оставляет после себя.
По замыслу перевод не переживает звонок
Вернёмся к той фразе из FAQ, потому что это не небрежность. Это позиция по безопасности, и позиция хорошая. Формулировка DeepL продолжается: все данные шифруются при передаче, никогда не используются для обучения моделей и «сохраняются только на локальном устройстве участников встречи». Когда банк или больница закупает инструмент для встреч, ответ «мы ничего не храним» проходит юридическую проверку быстрее всего.
Та же позиция обычна для всей категории живых субтитров, потому что хранение аудио многоязычных встреч — ровно тот вид ответственности, который никто не хочет наследовать. Отраслевое значение по умолчанию стало таким: превосходное понимание в моменте и никакого артефакта после.
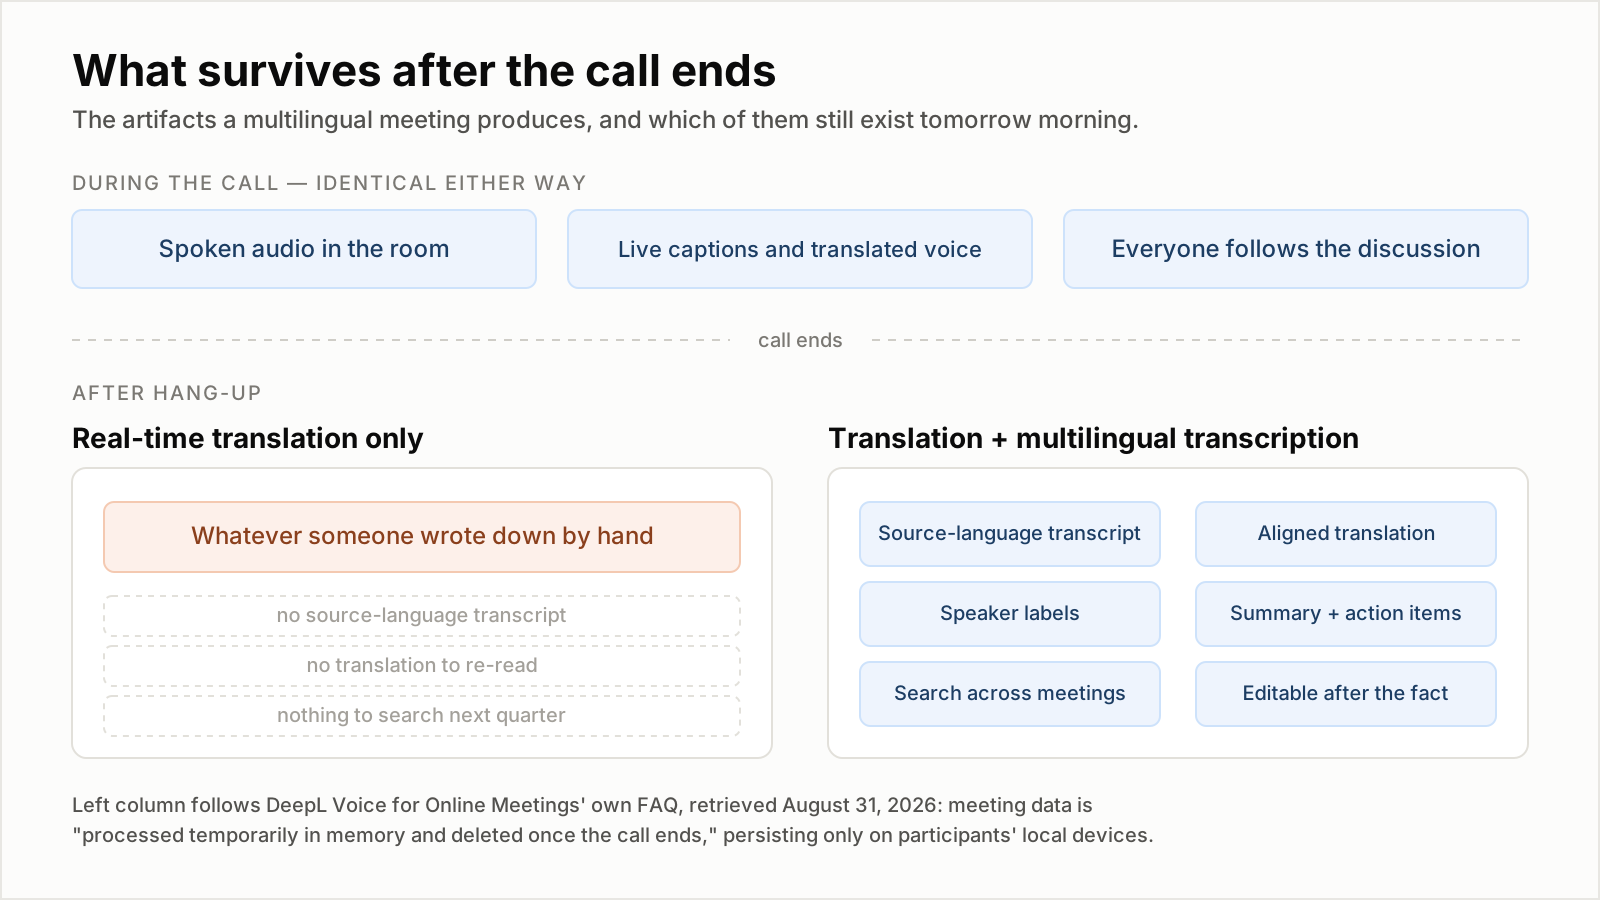
Во время звонка оба подхода неразличимы. Разница целиком на другой стороне от момента завершения. Левая колонка следует FAQ самого DeepL Voice for Online Meetings, просмотренному 31 августа 2026 года.
У возникающего здесь режима отказа есть форма, и ей нужно имя. Назовём это дрейфом решений: все прекрасно поняли встречу, а через три недели никто не может доказать, о чём договорились. Это не недопонимание — живой перевод сделал свою работу. Дело в том, что единственная уцелевшая копия решения, принятого на двух языках, живёт в пяти памятях, в пяти разных формулировках, минимум на двух языках, а память реконструирует, а не воспроизводит.
Дрейф решений обходится дорого способом, который никогда не появится в счёте за инструмент. Он проявляется как переделанная функция, как пересогласованный срок, как вопрос комплаенса, на который никто не может ответить, как новый сотрудник, у которого нет способа узнать, что команда решила в прошлом квартале.
28 августа: бенчмарк, объясняющий, зачем вам язык оригинала
Если бы транскрипция была решённым и однородным товаром, сохранение записи было бы вопросом дискового пространства, а этот текст — коротким. Это не так, и самое ясное свежее доказательство появилось три дня назад.
28 августа 2026 года Hugging Face и Voice Arena добавили первый язык Глобального Юга в Open ASR Leaderboard: хинди, на котором говорят более полумиллиарда человек, вошёл в многоязычную вкладку, до этого содержавшую только европейские языки. Они предоставили четыре оценочных набора — Monsoon en-IN и hi-IN, публичные и приватные версии — с 4888 непересекающимися дикторами, 12 записанными атрибутами на диктора, собранными в 428 округах и на сотнях реальных моделей телефонов, а не в студии.
Затем на этих данных прогнали модели с самой таблицы лидеров. Результат — самое полезное, что опубликовано в этом месяце про распознавание речи.
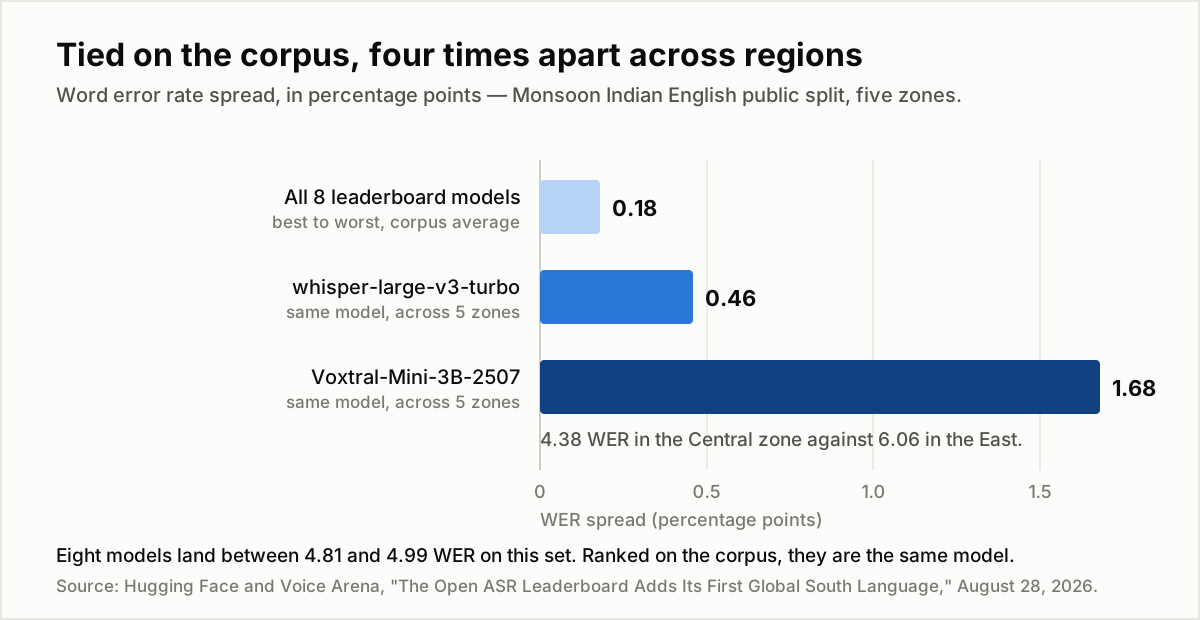
Одна ось, одна единица измерения: на сколько пунктов WER расходятся сравниваемые величины. Источник: Hugging Face и Voice Arena, 28 августа 2026 года.
Восемь моделей таблицы лидеров укладываются между 4,81 и 4,99 WER на публичном наборе индийского английского. Это 0,18 пункта от лучшей к худшей — внутри того, что пять часов аудио вообще способны различить. По корпусу, как говорится в публикации, это одна и та же модель.
Сгруппируйте дикторов по регионам — и они перестают быть одной моделью. Если поднять родной округ каждого диктора до его зонального совета, openai/whisper-large-v3-turbo меняется на 0,46 пункта между пятью зонами. mistralai/Voxtral-Mini-3B-2507, отстающая от неё по среднему по корпусу всего на 0,14 пункта, меняется на 1,68: 4,38 WER в Центральной зоне против 6,06 на Востоке. Две системы, неразличимые в таблице лидеров, различаются почти вчетверо в том, насколько их точность зависит от того, где вырос говорящий.
И дело не в том, что какой-то регион просто сложнее. ibm-granite/granite-speech-3.3-2b хуже всего работает на Севере, microsoft/VibeVoice-ASR-HF — на Юге, Voxtral — на Востоке. Если бы одна зона была объективно трудной, все модели упорядочили бы зоны одинаково. Они этого не делают, и это указывает на модели, а не на аудио.
Практическое прочтение для всех, кто ведёт многоязычные встречи: качество вашей транскрипции — не число, которое можно посмотреть. Это функция от того, кто находится в комнате. Коллега, чей акцент ваш поставщик выбрал в обучающую выборку меньше всего, — тот самый коллега, чьи фразы выйдут неверными, и ни таблица лидеров, ни страница вендора вас об этом не предупредят. Единственная защита — транскрипт, который человек может прочитать и исправить, а для этого транскрипт должен существовать.
В хинди у одной и той же фразы десять допустимых написаний. Перевод выбирает одно.
Второй результат той же публикации тоньше и ближе к тезису этой статьи.
Орфографическая вариативность английского ограничена: британское против американского, пунктуация, цифры против слов. Нормализатор сводит почти всё к одной форме. Хинди так не ограничен. Повседневная речь сильно смешана с английским, у слов английского происхождения нет устоявшегося написания на деванагари, а сложные формы пишутся слитно или раздельно по предпочтению. У одной фразы может быть десять и более допустимых письменных форм, и нет канонической стороны, к которой их можно свести.
Поэтому наборы на хинди поставляются с решёткой: для каждого отрезка транскрипта — множество написаний, принимаемых как правильные. И оцениваются они не обычным WER, а OIWER, орфографически информированной частотой ошибок в словах, предложенной AI4Bharat. Когда те же гипотезы переоценили относительно версии, сплющенной до единственного эталона, частота ошибок выросла у каждой системы, выросла неравномерно, и пары систем поменялись местами. При единственном эталоне модель частично вознаграждается за воспроизведение орфографии, которую выбрал разметчик; при решётке оценивается только распознавание.
Задержитесь на том, что отсюда следует. Даже на уровне «что именно было записано» часто нет одной правильной строки — есть множество допустимых, и выбор одной из них выбрасывает информацию.
Перевод — то же самое схлопывание, только уровнем выше и с гораздо большими потерями. Каждая переведённая строка — это выбор между прочтениями, который оригиналу делать не приходилось.
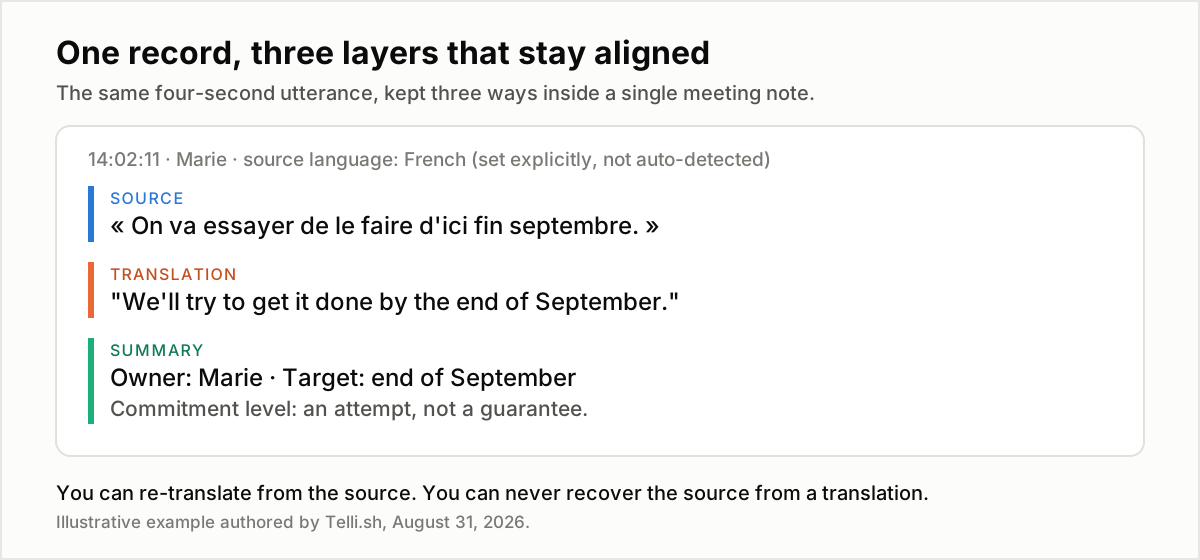
Строка на языке оригинала — единственная из трёх, которую нельзя восстановить из остальных.
Когда «On va essayer de le faire d'ici fin septembre» превращается в «Постараемся сделать это к концу сентября», меняется нечто реальное: французское essayer несёт особый смягчающий регистр, который «постараемся» уплощает. Это было обязательство или намерение? Переведённая строка не ответит. Исходная — ответит. Через шесть недель, когда срок сдвинется и две команды вспомнят фразу по-разному, исходная строка и есть весь аргумент.
Вот она, асимметрия в центре всей темы. Перевод односторонен. Из оригинала можно переводить сколько угодно раз, хоть в следующем году более сильной моделью. Из перевода оригинал не восстановить никогда.
Что остаётся после звонка: переводчик реального времени против переводчика встреч с заметками
Вот сравнение, сказанное прямо, по трём способам, которыми команды сегодня проводят многоязычную встречу.
| Что у вас есть на следующее утро | Слой перевода в реальном времени | Живой переводчик | Переводчик встреч с заметками |
|---|---|---|---|
| Понимание в комнате | Да | Да, наивысшее качество | Да |
| Аудио встречи | Только при отдельной записи | Только при отдельной записи | Да |
| Транскрипт на языке оригинала | Нет | Нет, если не расшифровывать отдельно | Да |
| Перевод, выровненный по оригиналу | Нет | Нет | Да |
| Кто произнёс какую строку | Нет | Нет | Да, с разметкой говорящих |
| Резюме и задачи | Нет | Заметки переводчика, если они есть | Да, генерируется из транскрипта |
| Поиск через три месяца | Нет | Нет | Да |
| Ошибочную строку можно исправить | Нет | Задним числом нет | Да, редактированием записи |
| Типичная стоимость за час | Подписка на ПО | 100–200 долларов США и выше, на длинных сессиях двое переводчиков | Подписка на ПО |
Поведение «исчезающей» колонки следует опубликованному FAQ DeepL Voice for Online Meetings, просмотренному 31 августа 2026 года; ставки перевода — широко публикуемый рыночный диапазон профессионального конференц-перевода, они меняются в зависимости от языковой пары и рынка. Третья колонка описывает категорию «переводчик встреч с заметками» в целом, а не конкретного поставщика.
Форма таблицы и есть аргумент. Первая и третья колонки одинаковы в единственной строке, которую покупатель обычно и оценивает, — понимание вживую, — и расходятся в каждой строке, которая имеет значение после встречи. Сравнения вендоров почти всегда проводятся по первой строке.
Живой переводчик — это окно. Переводчик встреч с заметками — это окно и одновременно бухгалтерская книга. Команды покупают окна, потому что именно эту часть они переживают, а потом ведут квартал по книге, которую никогда не покупали.
Как провести многоязычную встречу, чтобы запись осталась пригодной
Шесть шагов в том порядке, в котором они возникают. Ничего экзотического; сбой почти всегда в том, что никто не принял решения.
- Задайте язык оригинала явно. Не полагайтесь на автоопределение. Автоопределение обязано принять решение в первые секунды, на самом бесконтекстном аудио за всю сессию, и промах разом ухудшает все последующие этапы. Явный выбор к тому же позволяет движку направить вас на выделенную одноязычную модель, которая обычно сильнее многоязычной: та же Nova-3 документирует 58 языков по отдельности, но переключение кодов — ровно в 10.
- Разделите языки, на которых будут говорить, и языки, на которых будут читать. Это два разных списка, и объединять их — самая частая ошибка настройки в этой категории. Справочный центр DeepL разделяет их именно так: «разговорные языки» — то, что принимает распознавание, «языки перевода» — то, на чём могут отображаться субтитры, и второй список заметно длиннее.
- До звонка решите, где будет жить запись, и убедитесь, что это не платформа для встреч. Если ваш поставщик перевода удаляет данные встречи при завершении звонка — а это поведение по умолчанию, и вполне защитимое, — то никакие настройки внутри этого инструмента записи не создадут. Захват должен быть отдельным осознанным выбором.
- Оставьте разметку говорящих включённой. Переведённая строка без атрибуции бесполезна для любого решения, которое она потом должна была бы подкрепить. «Сделаем к сентябрю» становится фактом только тогда, когда известно, кто это сказал.
- Исправляйте имена и отраслевые термины в первые пять минут, вживую. Имена собственные, кодовые названия продуктов и аббревиатуры — то место, где транскрипция стабильно ошибается, и одновременно то место, где неверная строка сильнее всего портит резюме, сгенерированное позже. Исправление по ходу встречи стоит секунд; исправление в документе, который никто не перечитывает, не стоит ничего — потому что его никто не перечитывает.
- Формируйте резюме из транскрипта на языке оригинала, а не из перевода, когда это возможно. Резюмировать перевод — значит поставить друг на друга два этапа с потерями. Это наша рекомендация, а не измеренный результат, но механизм прост: каждый этап отбрасывает информацию, а наложение отбрасывает больше.
И держите три артефакта в одной записи. Транскрипт в одном инструменте, перевод в переписке и резюме в документе — это три файла, которые в течение месяца начнут противоречить друг другу, а именно это противоречие вы и пытались предотвратить.
Итог: понимание было задачей пропускной способности, запись — задачей памяти
Перевод встреч в реальном времени решает задачу пропускной способности: доставить смысл через стол достаточно быстро, чтобы разговор всё ещё ощущался разговором. В 2026 году, с более чем 40 языками при задержке в одну-две фразы и 96% предпочтений в слепом тесте, эта задача в основном решена и дешевеет каждый квартал.
Многоязычная транскрипция решает задачу памяти, и решение по пропускной способности её вообще не касается. Другой артефакт, другая политика хранения, другой режим отказа. Команда, которая купила только первое и решила, что получила второе, будет и дальше проводить прекрасные встречи, за которые не может отчитаться.
Так что вопрос на следующую встречу с поставщиком — не «сколько языков он переводит». На него любой серьёзный вендор теперь отвечает числом больше 40. Вопрос такой: когда звонок закончится, что ещё существует — и на чьём языке?
Где здесь Telli.sh: всё сказанное выше — про слой под живым переводом, и именно этот слой мы и строим. Telli.sh делает живую транскрипцию с переводом на 44 целевых языка, а сам интерфейс доступен на 15, так что участник из Варшавы читает корейский стендап по-польски прямо во время встречи. На следующее утро важно вот что: все три артефакта остаются в одной заметке — текст на языке оригинала того, что было действительно сказано, выровненный по нему перевод и построенное поверх резюме. Их можно перечитать, исправить и найти поиском ещё долго после того, как звонок завершился.
Начать заметку встречи с живым переводом
Источники
- Hugging Face и Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 августа 2026 года — наборы Monsoon en-IN и hi-IN, 4888 дикторов, разброс WER по зонам, OIWER и решётка для хинди.
- DeepL, "DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice", PR Newswire, Кёльн, 16 апреля 2026 года — более 40 языков, четыре продуктовые поверхности и слепая оценка Slator по заказу DeepL.
- The Next Web, "DeepL launches real-time voice-to-voice translation in 40+ languages", 17 апреля 2026 года — задержка на демонстрации в Сеуле и ограничение по порядку слов.
- DeepL, страница продукта и FAQ DeepL Voice for Online Meetings, просмотрены 31 августа 2026 года — формулировка о хранении данных, оценки Slator и указание, что «речь в речь» для онлайн-встреч ещё разворачивается.
- Справочный центр DeepL, DeepL Voice languages, просмотрен 31 августа 2026 года — разделение разговорных языков и языков перевода.
- AI4Bharat, Orthographically-Informed Word Error Rate — метрика, использованная для наборов на хинди.
- Языковое покрытие Nova-3 от Deepgram по сводке из нашего материала анализ языкового расширения в распознавании речи, 31 августа 2026 года.