40+ idiomas traduzidos ao vivo e apagados ao desligar: a transcrição multilíngue é a camada que guarda a reunião
A DeepL lançou o Voice-to-Voice em 16 de abril de 2026 em mais de 40 idiomas, e o FAQ do próprio produto diz que os dados da reunião são «processados temporariamente na memória e excluídos quando a chamada termina». Em 28 de agosto, o Open ASR Leaderboard incluiu seu primeiro idioma do Sul Global e mostrou que dois modelos empatados em 4,9 de WER diferem em quase quatro vezes no quanto sua precisão depende de onde vem quem fala. A tradução de reuniões em tempo real está virando commodity. O registro, não.
Em 16 de abril de 2026, a DeepL lançou de Colônia o Voice-to-Voice: um conjunto de produtos de tradução de voz em tempo real que cobre quatro superfícies — reuniões virtuais, conversas em celular e web, situações em grupo para equipes de linha de frente e uma API corporativa. Ele lida com mais de 40 idiomas, incluindo os 24 oficiais da UE além de vietnamita, tailandês, árabe, norueguês, hebraico, bengali e tagalo. Em avaliações cegas conduzidas pela Slator a pedido da DeepL, 96% dos linguistas preferiram o produto à tradução nativa embutida no Google, na Microsoft e no Zoom; o DeepL Voice para Zoom marcou 96,4 de 100 contra 87 a 89 das plataformas concorrentes.
É um produto sério, e o interessante não é o lançamento. O interessante é uma frase no FAQ da mesma página de produto, que relemos em 31 de agosto de 2026:
«A DeepL não armazena permanentemente dados de transcrição ou de tradução. Os dados da reunião são processados temporariamente na memória e excluídos quando a chamada termina.»
Leia os dois fatos lado a lado. A tradução é excelente, e essa tradução já não existe na hora do jantar.
Resumo rápido
- Em 2026, a tradução de reuniões em tempo real saiu do território do problema difícil para o da commodity entregue: mais de 40 idiomas na DeepL, 58 idiomas monolíngues no Nova-3 da Deepgram, tradução ao vivo dentro do Google Meet.
- Não guardar nada costuma ser uma decisão deliberada de privacidade, não um defeito — mas significa que a própria reunião não deixa nenhum artefato revisável.
- A transcrição multilíngue é a camada separada que fica embaixo. Ela mantém juntos, em um único registro revisável, a transcrição no idioma de origem, a tradução, a identificação de quem falou e o resumo. Este texto explica por que é justamente o idioma de origem que precisa sobreviver, e como conduzir a reunião para que ele sobreviva.
A versão desse argumento centrada no Google nós escrevemos em junho, quando Meet e Translate empurravam tradução de voz ao vivo para o grande público: por que reuniões multilíngues ainda precisam de notas revisáveis. De lá para cá o mercado respondeu a uma pergunta que nós só levantávamos. Tradução ao vivo funciona agora. Então a pergunta interessante se deslocou: o que sobra na sua mão na segunda-feira?
Tradução de reuniões em tempo real deixou de ser a parte difícil
Por cerca de uma década, fala multilíngue ao vivo foi a demonstração que nunca sobrevivia ao contato com uma reunião de verdade. A latência comia os turnos de fala, os sotaques quebravam o reconhecedor e qualquer conteúdo minimamente técnico saía destroçado. Essa era acabou em uns dez meses.
O Nova-3 da Deepgram listava 31 idiomas numa nota de versão de 10 de dezembro de 2025 e 58 na documentação de agosto de 2026: 39 adições documentadas em menos de nove meses, algo como um idioma novo a cada sete dias. Percorremos essa expansão, e as letras miúdas que a sustentam, em o que a palavra «suportado» realmente esconde na cobertura de idiomas do reconhecimento de fala. O Google colocou tradução de voz ao vivo dentro do Meet. A DeepL entregou em abril um conjunto de voz com quatro superfícies.
As alegações de qualidade também já são concretas o bastante para serem contestadas, o que por si só é sinal de maturidade. A avaliação da Slator encomendada pela DeepL relata taxa de erro de 4% para o DeepL Voice contra média de 17% nas plataformas de reunião concorrentes, além de 96,4/100 no Zoom e 96,3/100 no Teams. Números encomendados pelo fornecedor devem ser tratados como números encomendados pelo fornecedor. Mas a direção não está em disputa, e a cobertura honesta do lançamento aponta para o mesmo lado: a The Next Web, no texto de 17 de abril de 2026, descreveu uma demonstração ao vivo em Seul rodando com atraso de uma a duas frases e registrou o diretor de produto da DeepL admitindo que diferenças de ordem das palavras entre idiomas seguem sendo uma restrição fundamental à velocidade que a tradução voz a voz pode alcançar.
Atraso de uma a duas frases é suficiente. Não é suficiente para substituir um intérprete profissional numa negociação de tratado, e ninguém afirma isso. É de sobra suficiente para o alinhamento de produto de terça entre Varsóvia, Seul e São Paulo — que é a reunião que a maioria de nós realmente tem.
O ponto é este: quando uma capacidade fica tão boa tão rápido, o gargalo se move. Ele já se moveu. Agora está uma camada abaixo, naquilo que a reunião deixa para trás.
Por projeto, a tradução não sobrevive à chamada
Voltemos àquela frase do FAQ, porque ela não é desleixo. É uma postura de segurança, e uma boa. O texto da própria DeepL continua: todos os dados são criptografados em trânsito, nunca são usados para treinar modelos e «só persistem no dispositivo local dos participantes da reunião». Quando um banco ou um hospital compra uma ferramenta de reuniões, «não guardamos nada» é a resposta que passa mais rápido pelo jurídico.
A mesma postura é comum em toda a categoria de legendas ao vivo, porque armazenar áudio de reuniões multilíngues é exatamente o tipo de responsabilidade que ninguém quer herdar. O padrão do setor virou, então: compreensão excelente no momento e nenhum artefato depois.
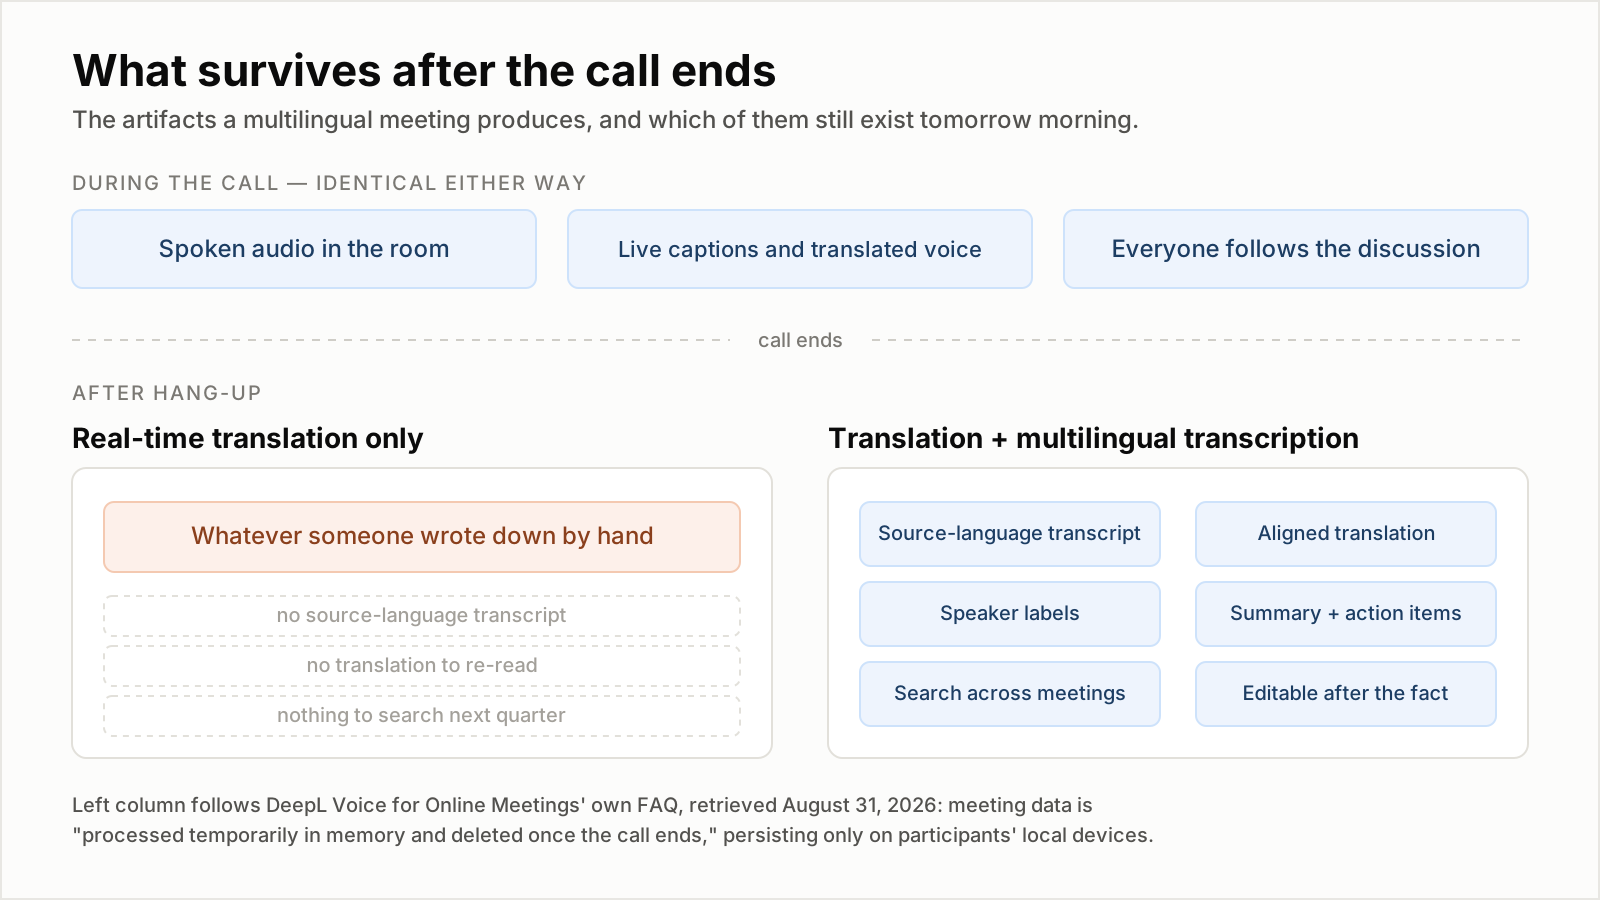
Durante a chamada, as duas abordagens são indistinguíveis. A diferença está inteiramente do outro lado do desligar. A coluna da esquerda segue o FAQ do DeepL Voice for Online Meetings, consultado em 31 de agosto de 2026.
O modo de falha que isso produz tem uma forma e precisa de um nome. Vamos chamá-lo de deriva de decisão: todo mundo entendeu a reunião perfeitamente e, três semanas depois, ninguém consegue provar o que foi acordado. Não é um mal-entendido — a tradução ao vivo fez o trabalho dela. É que a única cópia sobrevivente de uma decisão tomada em dois idiomas mora em cinco memórias, em cinco formulações diferentes, em pelo menos dois idiomas, e memória reconstrói em vez de reproduzir.
Deriva de decisão custa caro de um jeito que nunca aparece na fatura da ferramenta. Aparece como funcionalidade refeita, prazo renegociado, pergunta de conformidade que ninguém sabe responder, pessoa recém-contratada que não tem como aprender o que o time decidiu no trimestre passado.
28 de agosto: o benchmark que explica por que você precisa do idioma de origem
Se transcrição fosse uma commodity resolvida e uniforme, guardar o registro seria um problema de armazenamento e este texto seria curto. Não é, e a evidência recente mais nítida chegou há três dias.
Em 28 de agosto de 2026, Hugging Face e Voice Arena adicionaram o primeiro idioma do Sul Global ao Open ASR Leaderboard: o híndi, falado por mais de meio bilhão de pessoas, entrou numa aba multilíngue que até então só cobria idiomas europeus. Eles contribuíram com quatro conjuntos de avaliação — Monsoon en-IN e hi-IN, em versões pública e privada — com 4.888 falantes sem sobreposição, 12 atributos registrados por falante, coletados em 428 distritos e em centenas de modelos reais de celular, não num estúdio.
Depois rodaram sobre eles os modelos do próprio ranking. O resultado é a coisa mais útil publicada neste mês sobre reconhecimento de fala.
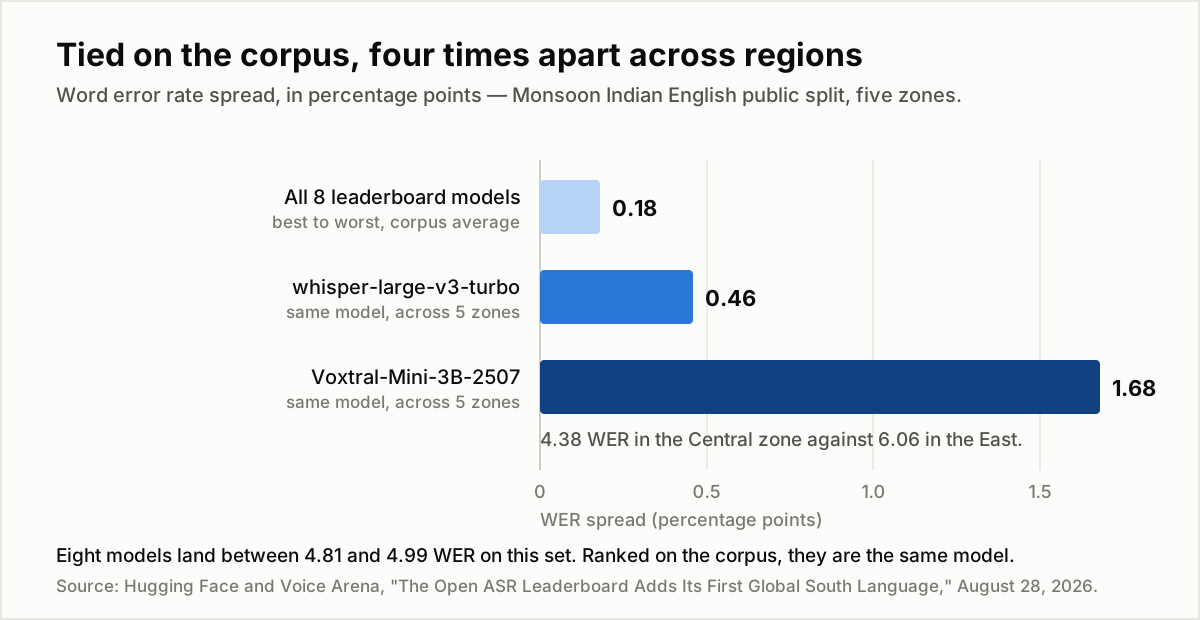
Um eixo só, uma unidade só: quantos pontos de WER separam os itens comparados. Fonte: Hugging Face e Voice Arena, 28 de agosto de 2026.
Oito modelos do ranking ficam entre 4,81 e 4,99 de WER no conjunto público de inglês indiano. São 0,18 ponto do melhor ao pior — dentro do que cinco horas de áudio sequer conseguem resolver. Ordenados pelo corpus, como diz a publicação, eles são o mesmo modelo.
Agrupe os falantes por região e eles deixam de ser. Ao elevar o distrito natal de cada falante ao respectivo conselho zonal, o openai/whisper-large-v3-turbo varia 0,46 ponto entre as cinco zonas. O mistralai/Voxtral-Mini-3B-2507, apenas 0,14 ponto atrás na média do corpus, varia 1,68: 4,38 de WER na zona Central contra 6,06 no Leste. Dois sistemas indistinguíveis no ranking diferem em quase quatro vezes no quanto sua precisão depende de onde a pessoa que fala cresceu.
E não é que uma região seja simplesmente mais difícil. O ibm-granite/granite-speech-3.3-2b é o pior no Norte, o microsoft/VibeVoice-ASR-HF no Sul, o Voxtral no Leste. Se alguma zona fosse intrinsecamente difícil, todos os modelos ordenariam as zonas do mesmo jeito. Não ordenam, e isso aponta para os modelos, não para o áudio.
A leitura operacional para quem conduz reuniões multilíngues: sua qualidade de transcrição não é um número que se consulta. É uma função de quem está na sala. O colega cujo sotaque o seu fornecedor amostrou menos é o colega cujas frases vão sair erradas, e nem o ranking nem a página do fornecedor vão avisar. A única defesa é uma transcrição que uma pessoa possa ler e corrigir — o que exige que exista uma transcrição.
O híndi escreve a mesma expressão de dez formas válidas. A tradução escolhe uma.
O segundo achado da mesma publicação é mais sutil e chega mais perto do argumento deste texto.
A variação ortográfica do inglês é limitada: britânico contra americano, pontuação, algarismos contra palavras. Um normalizador reduz quase tudo a uma forma. O híndi não é limitado assim. A fala cotidiana é fortemente misturada com inglês, palavras de origem inglesa não têm grafia devanágari estabelecida e compostos são escritos juntos ou separados conforme a preferência de cada um. Uma única expressão pode ter dez ou mais formas escritas válidas, e não existe um lado canônico para o qual reduzi-las.
Por isso os conjuntos de híndi trazem um reticulado: para cada trecho da transcrição, o conjunto de grafias aceitas como corretas. E a pontuação usa OIWER — taxa de erro de palavra informada pela ortografia, proposta pela AI4Bharat — em vez do WER comum. Quando as mesmas hipóteses foram repontuadas contra uma versão achatada em referência única, as taxas de erro subiram para todos os sistemas, subiram de forma desigual, e pares de sistemas inverteram posições. Sob referência única, um modelo é premiado em parte por reproduzir as escolhas de grafia de quem anotou; sob o reticulado, avalia-se só o reconhecimento.
Fique um instante com o que isso implica. Mesmo no nível de «o que foi escrito» muitas vezes não há uma única cadeia correta: há um conjunto de cadeias admissíveis, e escolher uma delas joga informação fora.
Tradução é exatamente esse colapso, um nível acima e bem mais destrutivo. Cada linha traduzida decide entre leituras que o original não precisava decidir.
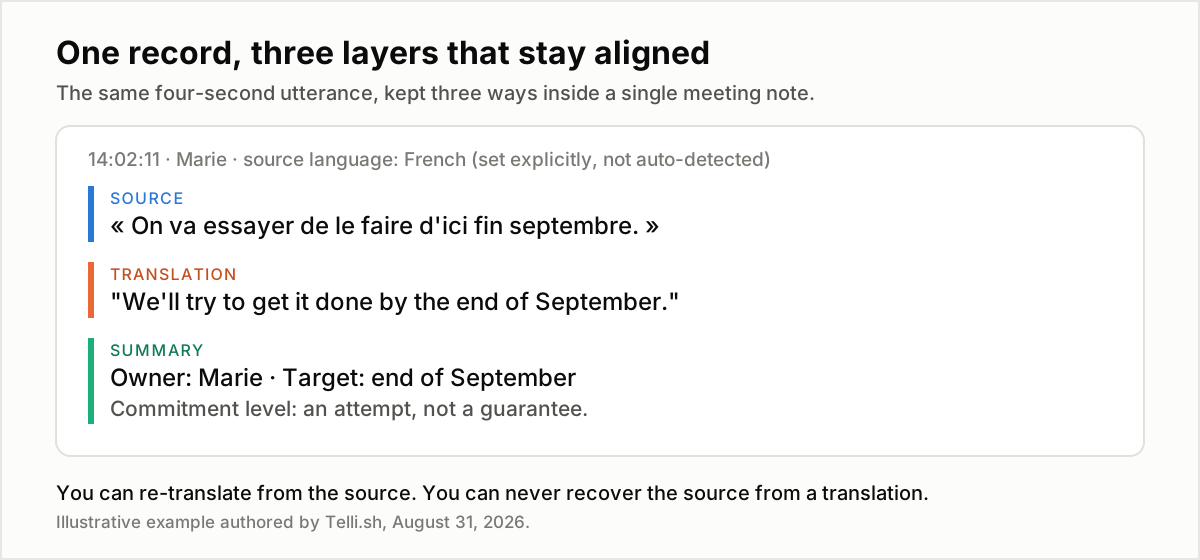
A linha no idioma de origem é a única das três que não dá para regenerar a partir das outras.
Quando «On va essayer de le faire d'ici fin septembre» vira «Vamos tentar entregar até o fim de setembro», algo real mudou: o essayer francês carrega um registro específico de atenuação que «tentar» achata. Aquilo era um compromisso ou uma intenção? A linha traduzida não sabe dizer. A linha de origem sabe. Seis semanas depois, quando a data escorrega e dois times lembram a frase de formas diferentes, a linha de origem é o argumento inteiro.
Está aí a assimetria no centro de todo o assunto. Tradução é de mão única. Você pode retraduzir a partir da origem quantas vezes quiser, no ano que vem com um modelo melhor. Você nunca vai recuperar a origem a partir da tradução.
O que sobra depois que a chamada acaba: tradutor em tempo real x tradutor de reuniões com notas
Aqui vai a comparação dita sem rodeios, entre os três jeitos como as equipes lidam hoje com uma reunião multilíngue.
| O que você tem na manhã seguinte | Camada de tradução em tempo real | Intérprete humano | Tradutor de reuniões com notas |
|---|---|---|---|
| Compreensão na sala | Sim | Sim, qualidade máxima | Sim |
| Áudio da reunião | Só se gravado à parte | Só se gravado à parte | Sim |
| Transcrição no idioma de origem | Não | Não, a menos que transcrita à parte | Sim |
| Tradução alinhada ao original | Não | Não | Sim |
| Quem disse cada linha | Não | Não | Sim, com identificação |
| Resumo e itens de ação | Não | As anotações do intérprete, se houver | Sim, gerado a partir da transcrição |
| Pesquisável três meses depois | Não | Não | Sim |
| Linha errada corrigível | Não | Não depois do fato | Sim, editando o registro |
| Custo típico por hora | Assinatura de software | US$ 100–200 ou mais, dois intérpretes em sessões longas | Assinatura de software |
O comportamento da coluna efêmera segue o FAQ publicado do DeepL Voice for Online Meetings, consultado em 31 de agosto de 2026; as tarifas de interpretação são a faixa de mercado amplamente divulgada para interpretação de conferência profissional e variam por par de idiomas e mercado. A terceira coluna descreve a categoria «tradutor de reuniões com notas» em geral, não um fornecedor específico.
O formato da tabela é o argumento. A coluna um e a coluna três são idênticas na única linha que um comprador costuma avaliar — compreensão ao vivo — e divergem em todas as linhas que importam depois da reunião. Comparações entre fornecedores quase sempre são feitas na primeira linha.
Um tradutor ao vivo é uma janela. Um tradutor de reuniões com notas é uma janela e um livro-razão. As equipes compram janelas porque é a parte que elas experimentam, e depois tocam o trimestre com um livro que nunca compraram.
Como conduzir uma reunião multilíngue para o registro continuar útil
Seis passos, na ordem em que acontecem. Nenhum é exótico; a falha quase sempre é que ninguém decidiu.
- Defina o idioma de origem explicitamente. Não confie na detecção automática. A detecção precisa se comprometer nos primeiros segundos, com o áudio menos contextual da sessão inteira, e um erro degrada todas as etapas seguintes de uma vez. A escolha explícita ainda permite que o motor te encaminhe para um modelo monolíngue dedicado, em geral mais forte que um multilíngue: o Nova-3, por exemplo, documenta 58 idiomas um a um, mas alternância de código em exatamente 10.
- Separe os idiomas que as pessoas vão falar dos idiomas que elas vão ler. São duas listas diferentes, e tratá-las como uma só é o erro de configuração mais comum da categoria. A própria central de ajuda da DeepL separa exatamente assim: «idiomas falados» é o que o reconhecedor aceita, «idiomas de tradução» é aquilo em que as legendas podem ser exibidas — e a segunda lista é bem mais longa.
- Decida antes da chamada onde o registro vai morar e confirme que não é a plataforma de reunião. Se o seu fornecedor de tradução apaga os dados ao desligar — que é o comportamento padrão, e defensável — então nenhuma configuração dentro daquela ferramenta vai produzir um registro. A captura precisa ser uma escolha deliberada e separada.
- Mantenha a identificação de quem fala ligada. Uma linha traduzida sem atribuição é inútil para qualquer decisão que ela venha a sustentar depois. «A gente entrega até setembro» só vira fato quando se sabe quem disse.
- Corrija nomes próprios e termos do domínio nos primeiros cinco minutos, ao vivo. Nomes próprios, codinomes de produto e siglas são o ponto em que a transcrição falha de forma confiável, e também o ponto em que uma linha errada mais estraga o resumo gerado depois. Corrigir enquanto a reunião corre custa segundos; corrigir num documento que ninguém relê não custa nada, porque ninguém relê.
- Gere o resumo a partir da transcrição no idioma de origem quando der, não a partir da tradução. Resumir uma tradução empilha duas etapas com perda. Esta é uma recomendação nossa, não um resultado medido, mas o mecanismo é direto: cada etapa descarta informação, e empilhá-las descarta mais.
E mantenha os três artefatos em um único registro. Uma transcrição numa ferramenta, uma tradução num histórico de chat e um resumo num documento são três arquivos que vão se contradizer em menos de um mês — e essa contradição é justamente o que você queria evitar.
No fundo: compreensão era o problema de banda, o registro é o problema de memória
Tradução de reuniões em tempo real resolve um problema de banda: levar o sentido para o outro lado da mesa rápido o bastante para a conversa continuar parecendo uma conversa. Em 2026, com mais de 40 idiomas a um atraso de uma a duas frases e 96% de preferência em teste cego, esse problema está substancialmente resolvido e fica mais barato a cada trimestre.
Transcrição multilíngue resolve um problema de memória, e nada da solução de banda encosta nele. Artefato diferente, política de retenção diferente, modo de falha diferente. Um time que compra só o primeiro e presume ter levado o segundo vai continuar tendo reuniões excelentes das quais não consegue prestar contas.
Então a pergunta que vale levar para a próxima conversa com fornecedor não é «quantos idiomas ele traduz». Hoje qualquer fornecedor sério responde com um número acima de 40. A pergunta é: quando a chamada acaba, o que ainda existe — e no idioma de quem?
Onde a Telli.sh entra: tudo acima é sobre a camada abaixo da tradução ao vivo, e é exatamente essa camada que construímos. A Telli.sh faz transcrição ao vivo com tradução para 44 idiomas de destino, com a interface disponível em 15, de modo que quem participa de Varsóvia lê em polonês uma daily em coreano enquanto ela acontece. O que importa na manhã seguinte é que os três artefatos ficam numa mesma nota: o texto no idioma de origem do que foi realmente dito, a tradução alinhada a ele e o resumo gerado por cima. Revisável, corrigível e pesquisável muito depois de a chamada terminar.
Começar uma nota de reunião com tradução ao vivo
Fontes
- Hugging Face e Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 de agosto de 2026 — conjuntos Monsoon en-IN e hi-IN, 4.888 falantes, variância do WER por zona, OIWER e o reticulado do híndi.
- DeepL, "DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice", PR Newswire, Colônia, 16 de abril de 2026 — mais de 40 idiomas, as quatro superfícies de produto e a avaliação cega da Slator encomendada pela DeepL.
- The Next Web, "DeepL launches real-time voice-to-voice translation in 40+ languages", 17 de abril de 2026 — latência da demonstração em Seul e a restrição de ordem das palavras.
- DeepL, página de produto e FAQ do DeepL Voice for Online Meetings, consultados em 31 de agosto de 2026 — texto sobre retenção de dados, notas da Slator e a informação de que voz a voz para reuniões online ainda está em implantação.
- Central de ajuda da DeepL, DeepL Voice languages, consultada em 31 de agosto de 2026 — a separação entre idiomas falados e idiomas de tradução.
- AI4Bharat, Orthographically-Informed Word Error Rate — a métrica usada nos conjuntos de híndi.
- A cobertura de idiomas do Nova-3 da Deepgram, compilada em nossa própria análise da expansão de idiomas no reconhecimento de fala, 31 de agosto de 2026.