40+ langues traduites en direct, effacées au raccrochage : la transcription multilingue est la couche qui garde la réunion
DeepL a lancé Voice-to-Voice le 16 avril 2026 dans plus de 40 langues, et la FAQ du même produit précise que les données de réunion sont « traitées temporairement en mémoire et supprimées une fois l'appel terminé ». Le 28 août, l'Open ASR Leaderboard a ajouté sa première langue du Sud global et montré que deux modèles à égalité à 4,9 de WER diffèrent de près du quadruple sur la dépendance de leur précision à l'origine du locuteur. La traduction de réunion en temps réel devient une commodité. Pas la trace écrite.
Le 16 avril 2026, DeepL a lancé depuis Cologne Voice-to-Voice : une suite de traduction vocale en temps réel couvrant quatre surfaces — réunions virtuelles, conversations sur mobile et web, situations de groupe pour les équipes de terrain, et une API destinée aux entreprises. Elle gère plus de 40 langues, dont les 24 langues officielles de l'UE, auxquelles s'ajoutent le vietnamien, le thaï, l'arabe, le norvégien, l'hébreu, le bengali et le tagalog. Lors d'évaluations en aveugle menées par Slator à la demande de DeepL, 96 % des linguistes l'ont préférée à la traduction native intégrée à Google, Microsoft et Zoom ; DeepL Voice pour Zoom obtient 96,4 sur 100 contre 87 à 89 pour les plateformes concurrentes.
C'est un produit sérieux, et l'intérêt n'est pas le lancement. L'intérêt tient à une phrase de la FAQ de cette même page produit, que nous avons relue le 31 août 2026 :
« DeepL ne conserve pas durablement les données de transcription ou de traduction. Les données de réunion sont traitées temporairement en mémoire et supprimées une fois l'appel terminé. »
Lisez ces deux faits côte à côte. La traduction est excellente, et cette traduction a disparu avant le dîner.
L'essentiel
- La traduction de réunion en temps réel est passée en 2026 du problème difficile à la commodité livrée : plus de 40 langues chez DeepL, 58 langues monolingues sur Nova-3 de Deepgram, traduction en direct à l'intérieur de Google Meet.
- Ne rien conserver relève le plus souvent d'un choix délibéré de confidentialité, pas d'un défaut — mais cela signifie que la réunion elle-même ne laisse aucun artefact consultable.
- La transcription multilingue est la couche distincte qui se trouve en dessous. Elle garde ensemble, dans un même enregistrement consultable, la transcription en langue source, la traduction, l'attribution des locuteurs et le résumé. Cet article explique pourquoi c'est précisément la langue source qui doit survivre, et comment mener la réunion pour qu'elle survive.
Nous avions écrit la version Google de cet argument en juin, quand Meet et Translate poussaient la traduction vocale en direct vers le grand public : pourquoi les réunions multilingues ont toujours besoin de notes consultables. Depuis, le marché a répondu à une question que nous ne faisions que poser. La traduction en direct fonctionne. La question intéressante s'est donc déplacée : que vous reste-t-il lundi matin ?
La traduction de réunion en temps réel n'est plus la partie difficile
Pendant une dizaine d'années, la parole multilingue en direct a été la démo qui ne survivait jamais au contact d'une vraie réunion. La latence dévorait les tours de parole, les accents cassaient le moteur de reconnaissance, et tout ce qui était un peu technique ressortait en bouillie. Cette époque a pris fin en une dizaine de mois.
Nova-3 de Deepgram annonçait 31 langues dans une note de version du 10 décembre 2025, et 58 dans sa documentation d'août 2026 : 39 ajouts documentés en moins de neuf mois, soit environ une langue nouvelle tous les sept jours. Nous avons détaillé cette expansion, et les réserves qui la sous-tendent, dans ce que « pris en charge » cache réellement dans la couverture linguistique de la reconnaissance vocale. Google a intégré la traduction vocale en direct à Meet. DeepL a livré une suite vocale à quatre surfaces en avril.
Les promesses de qualité sont désormais assez précises pour qu'on puisse les discuter, ce qui est en soi un signe de maturité. L'évaluation Slator commandée par DeepL rapporte un taux d'erreur de 4 % pour DeepL Voice contre 17 % en moyenne pour les plateformes de réunion concurrentes, et des scores de 96,4/100 pour Zoom et 96,3/100 pour Teams. Des chiffres commandés par un éditeur se traitent comme des chiffres commandés par un éditeur. Mais la direction ne fait pas débat, et la couverture sérieuse du lancement pointe dans le même sens : The Next Web, dans son article du 17 avril 2026, décrit une démonstration en direct à Séoul tournant avec un décalage d'une à deux phrases, et cite le directeur produit de DeepL reconnaissant que les différences d'ordre des mots entre langues restent une contrainte fondamentale sur la vitesse atteignable en voix-à-voix.
Un décalage d'une à deux phrases suffit. Il ne suffit pas à remplacer un interprète professionnel dans une négociation de traité, et personne ne le prétend. Il suffit largement pour le point produit du mardi entre Varsovie, Séoul et São Paulo — c'est-à-dire la réunion que la plupart d'entre nous ont réellement.
Voici le point : quand une capacité devient aussi bonne aussi vite, le goulot d'étranglement se déplace. Il s'est déplacé. Il se situe désormais un cran plus bas, dans ce que la réunion laisse derrière elle.
Par conception, la traduction ne survit pas à l'appel
Revenons à cette phrase de la FAQ, car ce n'est pas de la négligence. C'est une posture de sécurité, et une bonne. La formulation de DeepL poursuit : toutes les données sont chiffrées en transit, ne servent jamais à entraîner les modèles, et « ne persistent que sur l'appareil local des participants ». Quand une banque ou un hôpital achète un outil de réunion, « nous ne gardons rien » est la réponse qui passe le service juridique le plus vite.
La même posture est courante dans toute la catégorie du sous-titrage en direct, parce que stocker l'audio de réunions multilingues est exactement le type de responsabilité que personne ne veut hériter. Le réglage par défaut du secteur est donc devenu : compréhension superbe sur le moment, aucun artefact ensuite.
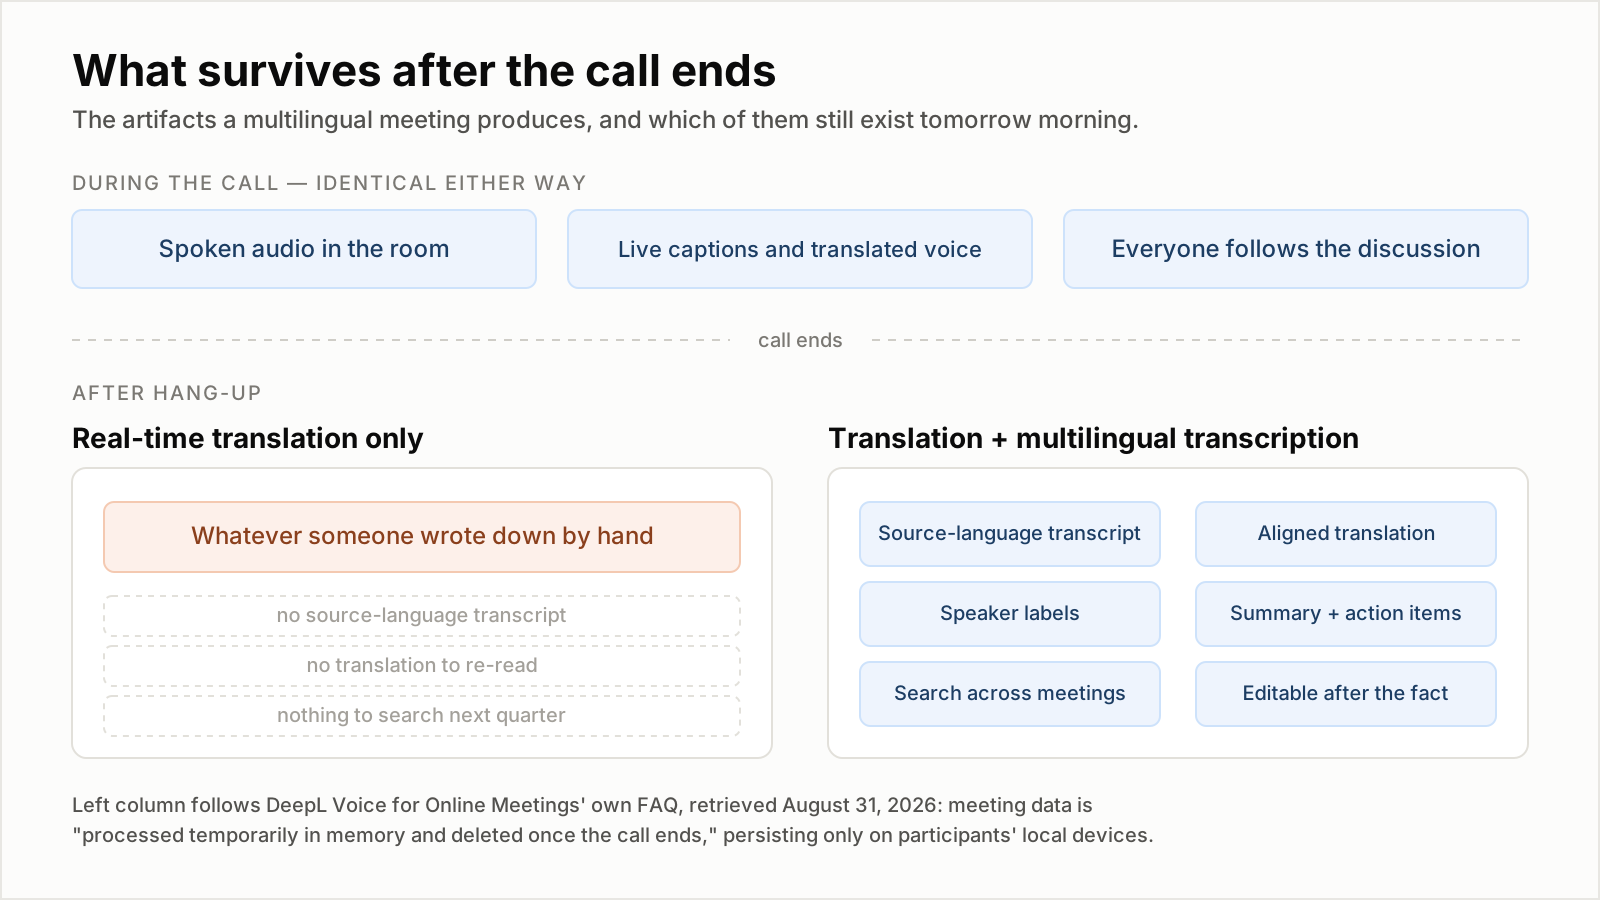
Pendant l'appel, les deux approches sont indiscernables. La différence se joue entièrement de l'autre côté du raccrochage. La colonne de gauche suit la FAQ de DeepL Voice for Online Meetings, consultée le 31 août 2026.
Le mode de défaillance ainsi produit a une forme, et il lui faut un nom. Appelons-le la dérive décisionnelle : tout le monde a parfaitement compris la réunion, et trois semaines plus tard plus personne ne peut prouver ce qui a été convenu. Ce n'est pas un malentendu — la traduction en direct a fait son travail. C'est que la seule copie survivante d'une décision prise en deux langues réside dans cinq mémoires, sous cinq formulations, dans au moins deux langues, et que la mémoire reconstruit au lieu de rejouer.
La dérive décisionnelle coûte cher d'une manière qui n'apparaît jamais sur la facture de l'outil. Elle apparaît sous forme de fonctionnalité refaite, d'échéance renégociée, de question de conformité à laquelle personne ne sait répondre, de nouvelle recrue qui n'a aucun moyen d'apprendre ce que l'équipe a décidé le trimestre dernier.
28 août : le benchmark qui explique pourquoi il vous faut la langue source
Si la transcription était une commodité résolue et uniforme, conserver la trace serait un problème de stockage et cet article serait court. Ce n'est pas le cas, et la preuve récente la plus nette est tombée il y a trois jours.
Le 28 août 2026, Hugging Face et Voice Arena ont ajouté la première langue du Sud global à l'Open ASR Leaderboard : le hindi, parlé par plus d'un demi-milliard de personnes, rejoint un onglet multilingue qui ne couvrait jusque-là que des langues européennes. Ils ont contribué quatre jeux d'évaluation — Monsoon en-IN et hi-IN, en versions publique et privée — totalisant 4 888 locuteurs sans recouvrement, avec 12 attributs enregistrés par locuteur, collectés dans 428 districts et sur des centaines de modèles de téléphones réels plutôt qu'en studio.
Puis ils ont fait tourner les modèles du classement dessus. Le résultat est la chose la plus utile publiée ce mois-ci sur la reconnaissance vocale.
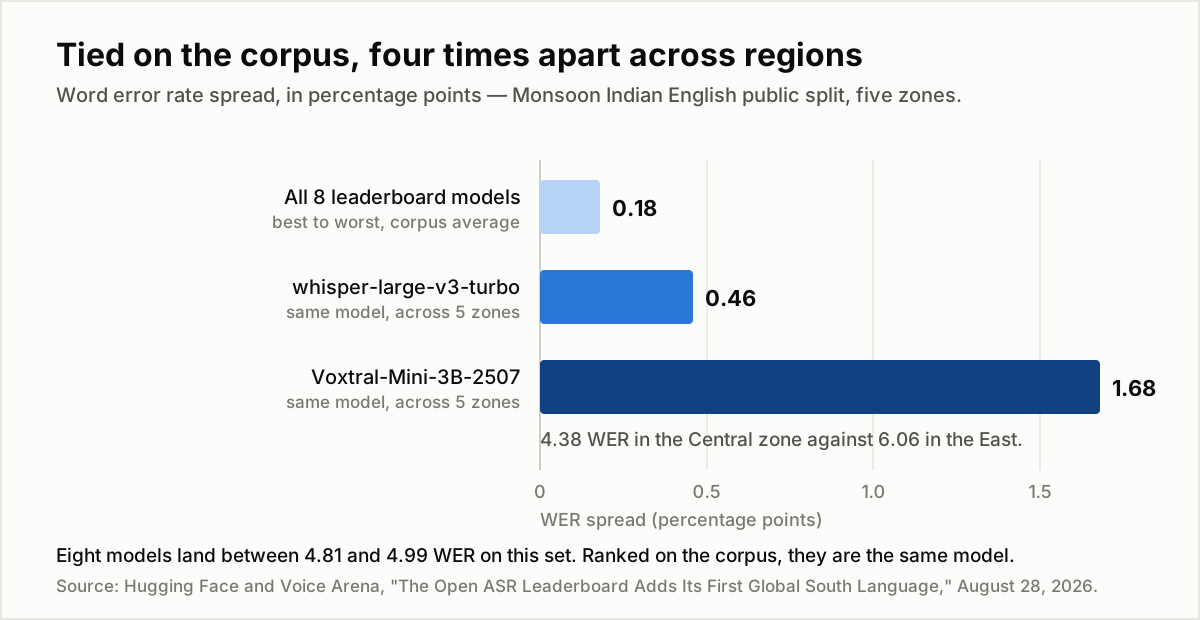
Un seul axe, une seule unité : combien de points de WER séparent les objets comparés. Source : Hugging Face et Voice Arena, 28 août 2026.
Huit modèles du classement se situent entre 4,81 et 4,99 de WER sur le jeu public d'anglais indien. Soit 0,18 point du meilleur au pire — à l'intérieur de ce que cinq heures d'audio peuvent même résoudre. Classés sur le corpus, comme le dit la publication, ce sont le même modèle.
Regroupez les locuteurs par région et ils cessent d'être le même modèle. En remontant le district d'origine de chaque locuteur à son conseil zonal, openai/whisper-large-v3-turbo varie de 0,46 point sur les cinq zones. mistralai/Voxtral-Mini-3B-2507, à seulement 0,14 point derrière sur la moyenne du corpus, varie de 1,68 : 4,38 de WER dans la zone centrale contre 6,06 dans l'Est. Deux systèmes indiscernables sur le classement diffèrent de près du quadruple quant à la dépendance de leur précision au lieu où le locuteur a grandi.
Et ce n'est pas qu'une région serait simplement plus difficile. ibm-granite/granite-speech-3.3-2b est le plus mauvais au Nord, microsoft/VibeVoice-ASR-HF au Sud, Voxtral à l'Est. Si une zone était intrinsèquement difficile, tous les modèles classeraient les zones de la même façon. Ils ne le font pas, ce qui désigne les modèles plutôt que l'audio.
La lecture opérationnelle, pour qui anime des réunions multilingues : votre qualité de transcription n'est pas un nombre que l'on consulte. C'est une fonction de qui se trouve dans la pièce. Le collègue dont l'accent a été le moins échantillonné par votre fournisseur est celui dont les phrases sortiront fausses, et ni le classement ni la page produit ne vous préviendront. La seule défense est une transcription qu'un humain peut lire et corriger — ce qui suppose qu'une transcription existe.
Le hindi écrit la même expression de dix façons valides. Une traduction en choisit une.
Le second résultat de cette publication est plus subtil et touche de plus près l'argument de cet article.
La variation orthographique de l'anglais est bornée : britannique contre américain, ponctuation, chiffres contre mots. Un normaliseur ramène l'essentiel à une forme unique. Le hindi n'est pas borné de la même manière. La langue courante est fortement mêlée d'anglais, les mots d'origine anglaise n'ont pas d'orthographe devanagari fixée, et les composés s'écrivent soudés ou séparés selon les préférences. Une seule expression peut avoir dix formes écrites valides ou plus, et il n'existe aucun côté canonique vers lequel les ramener.
Les jeux hindi livrent donc un treillis : pour chaque segment de la transcription, l'ensemble des graphies acceptées comme correctes. La notation utilise non pas le WER ordinaire mais l'OIWER, taux d'erreur de mots informé par l'orthographe, introduit par AI4Bharat. Lorsque les mêmes hypothèses ont été réévaluées contre une version aplatie en référence unique, les taux d'erreur ont augmenté pour tous les systèmes, de façon inégale, et des paires de systèmes ont inversé leur classement. Sous référence unique, un modèle est en partie récompensé pour reproduire les choix graphiques de l'annotateur ; sous le treillis, seule la reconnaissance est notée.
Prenez un instant pour mesurer ce que cela implique. Même au niveau de « ce qui a été écrit », il n'existe souvent pas une chaîne correcte unique — il existe un ensemble de chaînes admissibles, et en choisir une jette de l'information.
La traduction est exactement cet écrasement, un niveau au-dessus et bien plus destructeur. Chaque ligne traduite tranche entre des lectures que la source n'avait pas à trancher.
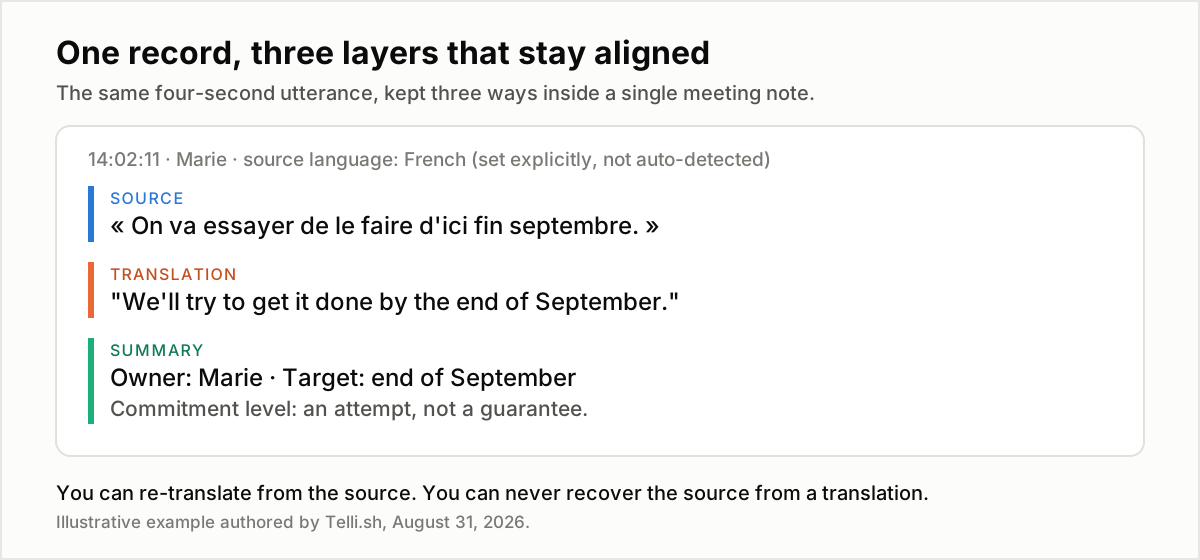
La ligne en langue source est la seule des trois que l'on ne peut pas régénérer à partir des autres.
Quand « On va essayer de le faire d'ici fin septembre » devient « We'll try to get it done by the end of September », quelque chose de réel a changé : essayer porte un registre d'atténuation propre au français que « try » aplatit. Était-ce un engagement ou une intention ? La ligne traduite ne peut pas le dire. La ligne source, si. Six semaines plus tard, quand la date glisse et que deux équipes se souviennent différemment de la phrase, la ligne source est l'argument tout entier.
C'est l'asymétrie au cœur du sujet. La traduction va dans un seul sens. Vous pouvez retraduire depuis la source autant de fois que vous voulez, avec un meilleur modèle l'an prochain. Vous ne récupérerez jamais la source depuis la traduction.
Ce qui reste après l'appel : traducteur en temps réel vs traducteur de réunion avec notes
Voici la comparaison énoncée franchement, sur les trois façons dont les équipes traitent aujourd'hui une réunion multilingue.
| Ce que vous avez le lendemain matin | Couche de traduction en temps réel | Interprète humain | Traducteur de réunion avec notes |
|---|---|---|---|
| Compréhension dans la salle | Oui | Oui, qualité maximale | Oui |
| Audio de la réunion | Seulement si enregistré à part | Seulement si enregistré à part | Oui |
| Transcription en langue source | Non | Non, sauf transcription séparée | Oui |
| Traduction alignée sur la source | Non | Non | Oui |
| Qui a dit quelle ligne | Non | Non | Oui, avec attribution |
| Résumé et actions à mener | Non | Notes de l'interprète, s'il y en a | Oui, généré depuis la transcription |
| Recherchable trois mois plus tard | Non | Non | Oui |
| Ligne erronée corrigeable | Non | Pas après coup | Oui, on édite l'enregistrement |
| Coût horaire typique | Abonnement logiciel | 100 à 200 USD et plus, deux interprètes pour les longues sessions | Abonnement logiciel |
Le comportement de la colonne éphémère suit la FAQ publiée de DeepL Voice for Online Meetings, consultée le 31 août 2026 ; les tarifs d'interprétation correspondent à la fourchette de marché largement publiée pour l'interprétation de conférence professionnelle et varient selon la paire de langues et le marché. La troisième colonne décrit la catégorie « traducteur de réunion avec notes » en général, pas un fournisseur particulier.
La forme du tableau est l'argument. La colonne un et la colonne trois sont identiques sur la seule ligne qu'un acheteur évalue d'ordinaire — la compréhension en direct — et diffèrent sur chaque ligne qui compte après la réunion. Les comparatifs fournisseurs se jouent presque toujours sur la première ligne.
Un traducteur en direct est une fenêtre. Un traducteur de réunion avec notes est une fenêtre et un registre. Les équipes achètent des fenêtres parce que c'est la partie qu'elles vivent, puis pilotent leur trimestre sur un registre qu'elles n'ont jamais acheté.
Comment mener une réunion multilingue pour que la trace reste utilisable
Six étapes, dans l'ordre où elles surviennent. Rien d'exotique ; l'échec vient presque toujours de ce que personne n'a tranché.
- Fixez explicitement la langue source. Ne vous reposez pas sur la détection automatique. La détection doit s'engager dès les premières secondes, sur l'audio le moins contextuel de toute la session, et une erreur dégrade d'un coup toutes les étapes suivantes. Un choix explicite permet aussi au moteur de vous router vers un modèle monolingue dédié, généralement plus solide qu'un modèle multilingue — Nova-3, par exemple, documente 58 langues une à une, mais l'alternance codique dans exactement 10.
- Séparez les langues que les gens vont parler de celles qu'ils vont lire. Ce sont deux listes distinctes, et les confondre est l'erreur de configuration la plus fréquente de la catégorie. Le centre d'aide de DeepL fait exactement cette distinction : les « langues parlées » sont celles que la reconnaissance accepte, les « langues de traduction » celles dans lesquelles les sous-titres peuvent s'afficher — et la seconde liste est bien plus longue.
- Décidez avant l'appel où vivra la trace, et vérifiez que ce n'est pas la plateforme de réunion. Si votre fournisseur de traduction supprime les données au raccrochage — ce qui est le comportement par défaut, et défendable — alors aucun réglage dans cet outil ne produira de trace. La capture doit être un choix délibéré et séparé.
- Gardez l'attribution des locuteurs activée. Une ligne traduite sans attribution est inutilisable pour toute décision qu'elle pourrait plus tard étayer. « On le fera d'ici septembre » ne devient un fait qu'une fois qu'on sait qui l'a dit.
- Corrigez les noms propres et les termes métier dans les cinq premières minutes, en direct. Noms propres, noms de code produit et acronymes sont les points où la transcription échoue de façon fiable, et aussi ceux où une ligne fausse nuit le plus au résumé généré ensuite. Corriger pendant la réunion coûte quelques secondes ; corriger dans un document que personne ne relit ne coûte rien, parce que personne ne le relit.
- Générez le résumé depuis la transcription en langue source quand c'est possible, pas depuis la traduction. Résumer une traduction empile deux étapes avec perte. C'est une recommandation de notre part plutôt qu'un résultat mesuré, mais le mécanisme est simple : chaque étape jette de l'information, et les empiler en jette davantage.
Puis gardez les trois artefacts dans un même enregistrement. Une transcription dans un outil, une traduction dans un fil de discussion et un résumé dans un document sont trois fichiers qui se contrediront en moins d'un mois — et cette contradiction est précisément ce que vous cherchiez à éviter.
Le fond de l'affaire : la compréhension était un problème de bande passante, la trace est un problème de mémoire
La traduction de réunion en temps réel résout un problème de bande passante : faire passer le sens de l'autre côté de la table assez vite pour que la conversation reste une conversation. En 2026, avec plus de 40 langues à une ou deux phrases de décalage et 96 % de préférence en test à l'aveugle, ce problème est largement résolu et devient moins cher chaque trimestre.
La transcription multilingue résout un problème de mémoire, et rien dans la solution de bande passante n'y touche. Autre artefact, autre politique de conservation, autre mode de défaillance. Une équipe qui n'achète que la première en croyant avoir obtenu la seconde continuera d'avoir d'excellentes réunions dont elle ne peut rendre compte.
La question à emporter à votre prochain rendez-vous fournisseur n'est donc pas « combien de langues traduisez-vous ». Tout fournisseur sérieux répond désormais par un nombre supérieur à 40. La question est : quand l'appel se termine, que reste-t-il — et dans la langue de qui ?
Où se situe Telli.sh : tout ce qui précède porte sur la couche située sous la traduction en direct, et c'est précisément celle que nous construisons. Telli.sh assure la transcription en direct avec traduction vers 44 langues cibles, dans une interface elle-même disponible en 15 langues : une personne à Varsovie lit en polonais un point quotidien tenu en coréen, pendant qu'il se déroule. Ce qui compte le lendemain matin, c'est que les trois artefacts restent dans une même note — le texte en langue source de ce qui a réellement été dit, la traduction alignée dessus, et le résumé produit par-dessus. Consultable, corrigeable et recherchable longtemps après la fin de l'appel.
Démarrer une note de réunion traduite en direct
Sources
- Hugging Face et Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 août 2026 — jeux Monsoon en-IN et hi-IN, 4 888 locuteurs, variance du WER par zone, OIWER et le treillis hindi.
- DeepL, "DeepL unveils real-time spoken translation, breaking the next language barrier with Voice-to-Voice", PR Newswire, Cologne, 16 avril 2026 — plus de 40 langues, les quatre surfaces produit, et l'évaluation en aveugle Slator commandée par DeepL.
- The Next Web, "DeepL launches real-time voice-to-voice translation in 40+ languages", 17 avril 2026 — latence de la démo de Séoul et contrainte d'ordre des mots.
- DeepL, page produit et FAQ DeepL Voice for Online Meetings, consultées le 31 août 2026 — formulation sur la conservation des données, scores Slator, et mention que le voix-à-voix pour les réunions en ligne est encore en cours de déploiement.
- Centre d'aide DeepL, DeepL Voice languages, consulté le 31 août 2026 — la distinction entre langues parlées et langues de traduction.
- AI4Bharat, Orthographically-Informed Word Error Rate — la métrique utilisée pour les jeux hindi.
- La couverture linguistique de Nova-3 de Deepgram, telle que compilée dans notre analyse de l'expansion linguistique en reconnaissance vocale, 31 août 2026.