Четыре фронтирные модели за три дня, и никто не скажет, какая была нужна именно вам
С 1 по 3 сентября 2026 года Anthropic, Meta, Google и OpenAI выпустили фронтирные модели, а CNBC дала возникшему истощению имя: модельная усталость. Число релизов — скучная часть. Интересная в том, что каждый релиз создаёт оценку, которую кто-то ниже по цепочке обязан провести, и у компаний, выпускающих модели, нет ни одной причины помогать вам её пропустить. Разбираем, во что на самом деле обходится смена модели, почему дешевле за токен не значит дешевле за задачу и почему полностью управляемое ПО, созданное под одну узкую работу, — единственная схема, в которой решение может принять кто-то другой.
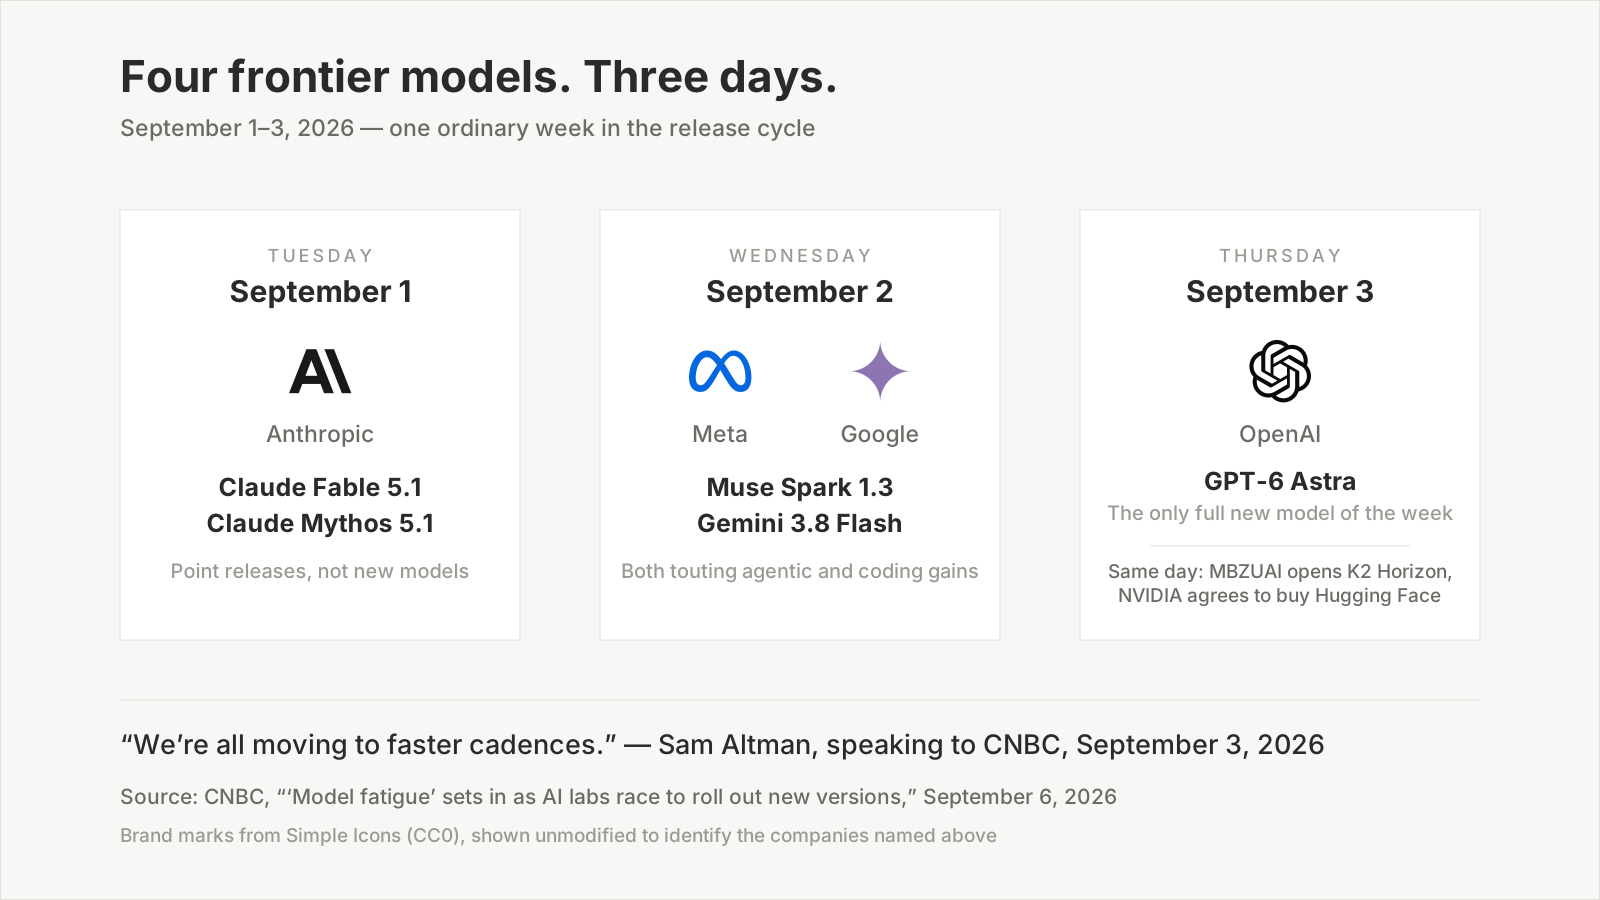
Логотипы взяты из Simple Icons (CC0) и показаны без изменений — для идентификации упомянутых компаний. Даты релизов и цитата Альтмана — по материалу CNBC от 6 сентября 2026 года.
Со вторника по четверг первой недели сентября 2026 года Anthropic выпустила Claude Fable 5.1 и Claude Mythos 5.1, Meta — Muse Spark 1.3, Google — Gemini 3.8 Flash, а OpenAI — GPT-6 Astra. В тот же четверг Университет искусственного интеллекта имени Мохаммеда бин Заида в Абу-Даби открыл миру семейство K2 Horizon, а NVIDIA договорилась купить Hugging Face за 12 930 300 000 долларов.
Шесть анонсов. Три дня. CNBC выпустила материал в воскресенье, 6 сентября, под формулировкой, которая уже несколько недель ходила среди практиков: модельная усталость.
Очевидное прочтение: отрасль движется быстрее, чем кто-либо способен за ней следить. Это прочтение верное и по большей части неинтересное. Вот часть, которая заслуживает вашего внимания: каждый релиз перекладывает издержку, и перекладывание идёт ровно в одну сторону. Любая модель, которую выпускает лаборатория, превращается в оценку, которую кто-то ниже по цепочке обязан провести, — и ни у кого выше по цепочке нет ни малейшей причины помочь вам её пропустить.
TL;DR
- Четыре фронтирных релиза за три дня (1–3 сентября 2026 года); 6 сентября CNBC назвала возникшее истощение «модельной усталостью».
- Настоящая издержка — не внимание, а труд по оценке. Один гендиректор корпоративной AI-компании рассказал CNBC, что, когда его команда хочет оценить 10 моделей под задачу, она тестирует около 5.
- Цена за токен — плохой заменитель стоимости задачи: более сильная и дорогая модель может закончить более трудную работу дешевле, потому что делает меньше шагов.
- Поставщикам моделей структурно неинтересно сообщать вам, когда хватило бы модели подешевле. Именно этот пробел и есть вся причина существования управляемого ПО, сделанного под конкретную задачу.
6 сентября у модельной усталости появилось имя
«Мне кажется, модельная усталость — вещь вполне реальная», — сказал CNBC Чжэнь Лу, гендиректор Runpod, стартапа AI-инфраструктуры. «Не поймите меня неправильно, я в полном восторге от всех происходящих инноваций, но я действительно думаю, что мы в среде, где пены столько, что приходится шуметь».
На той же неделе Сэм Альтман предложил CNBC более мягкую формулировку: «мы все переходим к более быстрым каденциям», — сказал он, отнеся часть ускорения на счёт того, что все «вернулись из летних отпусков».
Верно может быть и то и другое. Каденция действительно ускоряется, и ускорение действительно отчасти театр. Ахмед Аббаси, профессор Школы бизнеса Мендоса Университета Нотр-Дам с 25 годами в ИИ, изложил коммерческую логику прямо: лаборатории «все играют в игру за долю кошелька». Anthropic и OpenAI давят сильнее всех, двигаясь к публичным рынкам, и частные инвесторы оценивают каждую уже почти в 1 трлн долларов.
Кошелёк, о котором речь, огромен. В мае 2026 года Gartner прогнозировала, что мировые расходы на ИИ достигнут 2,59 трлн долларов в этом году, что на 47 % больше, чем в 2025-м. Наибольшая доля приходится на инфраструктуру, но заметно больше 1 трлн долларов уходит на услуги, ПО, безопасность, модели и инструменты — то есть на решения, которые кто-то должен принимать.
Вот в чём суть: рынок такого размера, растущий с такой скоростью, вознаграждает громкость. Он не вознаграждает тех, кто говорит клиенту, что тому хватило бы и меньшего.
Издержка — не внимание. Это оценка, которую вы не можете доделать
Спросите практика, как модельная усталость ощущается на деле, и вы не услышите «я читаю слишком много анонсов». Вы услышите арифметику.
Суреш Васудеван, гендиректор корпоративного AI-стартапа Clockwork Systems, дал CNBC самое полезное число во всём материале. Если его компания хочет оценить 10 моделей ИИ под конкретную задачу, сказал он, она может просто взять пять. «По-настоящему тяжело идти и оценивать каждую из тех, что выходят прямо сейчас».
Задержитесь на этом соотношении, потому что это несущий факт всей темы. Компания, чей бизнес и есть корпоративный ИИ, укомплектованная людьми, которые занимаются этим профессионально, с вычислительным бюджетом, выделенным ровно под это, оценивает половину кандидатов, которых сама же считает достойными оценки.
Назовём вторую половину непроверенной пятёркой. Их не отклонили. Никто не нашёл в них изъяна. Их просто ни разу не запустили — и потому вопрос, не оказалась ли какая-то из них быстрее, дешевле или точнее на вашей конкретной нагрузке, остаётся открытым навсегда. Каждая релизная неделя добавляет к этой куче.
А разбирать кучу дорого, потому что смена модели — это не поднятие версии. Это переквалификация. Вот что на самом деле должно произойти, прежде чем новая модель дойдёт до продакшена:
| Что нужно перепроверить | Почему новая модель это ломает |
|---|---|
| Промпты и системные инструкции | Они подогнаны под повадки старой модели; формулировка, надёжно управлявшая одной, может увести другую в сторону |
| Стабильность формата вывода | Нижестоящие парсеры зависят от формы — JSON, заголовки, разделители, — а привычки форматирования у моделей разные |
| Точность на ваших реальных данных | Разница в бенчмарках измерена на публичных наборах, а не на ваших встречах, ваших тикетах, вашей кодовой базе |
| Поведение инструментов и API | Агентные модели различаются тем, когда вызывают, как часто повторяют попытку и что делают при сбое вызова |
| Задержка и пропускная способность под нагрузкой | Модель, которая быстрее на одиночном запросе, может оказаться медленнее за вашими лимитами частоты |
| Полная стоимость на вашем объёме | Цена за токен, умноженная на потраченные токены и на число попыток, — см. ниже |
| Безопасность и поведение при отказах | Границы смещаются между версиями в обе стороны |
| Регрессионные случаи | Ровно те сбои, которые вы уже починили и о которых не знает ни один чужой бенчмарк |
Восемь категорий, и каждой нужны реальные примеры, сравнительный прогон и чьё-то суждение. Это проект, а не правка конфига. Умножьте на число фронтирных релизов в любом месяце — и причина соотношения 10 к 5 становится очевидной.
Мы написали отдельный материал о том, как измерять это на собственной нагрузке, а не доверять лидерборду, и честное резюме таково: если делать нормально, уходят дни, а не часы.
Дешевле за токен — не дешевле за задачу
Самая контринтуитивная находка всей этой истории пришла не из лаборатории, а от инженера, который пытался автоматизировать выбор.
Мо Халил, продуктовый инженер опенсорсного AI-шлюза LiteLLM, 4 сентября опубликовал пост под названием «Model Fatigue is Real». Он работает над автороутером LiteLLM — программой, вся работа которой в том, чтобы выбирать модель за вас, — и раскрыл эту аффилиацию с самого начала, чего не делает большинство пишущих на эту тему.
Исходное допущение его команды было интуитивным. Возьмите две модели, каждая из которых способна решить задачу; та, что по карточке стоит вдвое дешевле за токен, должна решить её примерно за половину цены.
Тесты показали не это. Более сильная и более дорогая модель решала более трудные задачи за долю стоимости дешёвой. Объяснение Халила: «Поскольку она была умнее, она выбирала более умный подход и добиралась до готового результата гораздо быстрее».
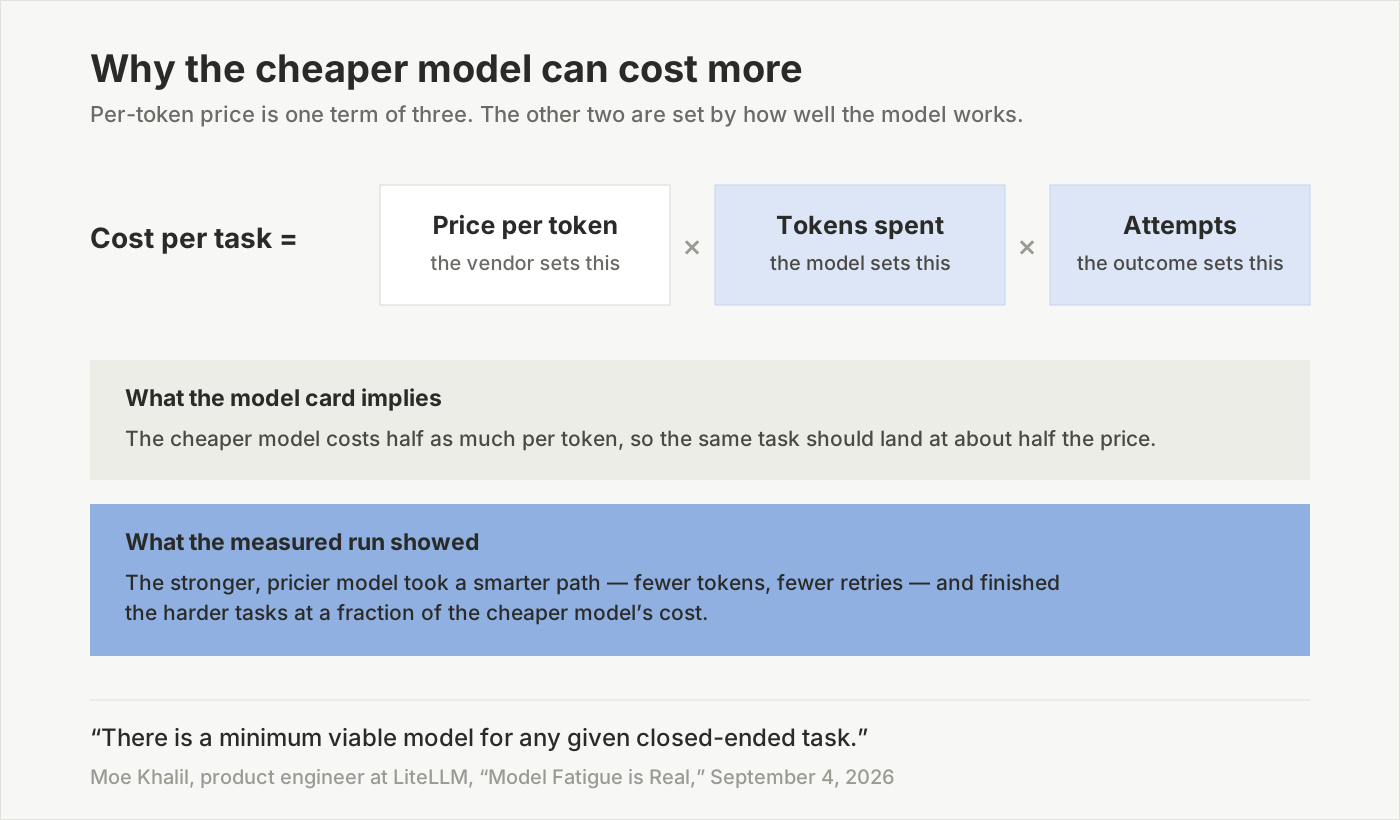
Из трёх сомножителей на странице тарифов есть только цена за токен. Два других — свойства компетентности модели, и проявляются они лишь тогда, когда вы прогоняете реальную работу.
Это полностью переосмысляет страницу тарифов. Число, которое рекламирует поставщик, — один сомножитель из трёх: цена за токен, потраченные токены и число попыток до фактического успеха. Первый задаёт поставщик. Второй и третий задаёт сама модель, и ни один из них непознаваем, пока вы не прогоните через неё собственную работу.
А значит, сравнение, которому вас учили, — пробежать глазами колонку цен и взять дешёвое — не просто неполное. На реальных задачах оно может указывать в противоположную сторону.
Выше по цепочке никому не выгодно вам об этом говорить
Дальше Халил произносит то, о чём обычно молчат, и это самая острая фраза, написанная по теме за год:
«Для модельных компаний эта лень — фича, а не баг. Им предпочтительнее, чтобы я использовал [топовую модель] для пересказа своей почты, и у них нет стимула сообщать мне, когда более дешёвая модель справилась бы ровно так же. Их работа — продолжать двигать фронтир. Разбираться, когда фронтир использовать не надо, оставлено мне».
Перечитайте это, держа в голове цифру Gartner. Рынок в 2,59 трлн долларов, растущий на 47 % в год, где поставщики выигрывают от того, что каждый клиент по умолчанию тянется вверх, и ничего не теряют, когда клиенты переплачивают.
Это не заговор, и он не требует, чтобы кто-то вёл себя дурно. Просто так выглядит градиент стимулов. Работа фронтирной лаборатории — двигать фронтир. Сказать вам, что прошлогодняя модель среднего уровня закрывает 80 % вашей нагрузки, — работа кого-то другого, и до недавнего времени это не было ничьей работой вообще.
Второе наблюдение Аббаси тоже сюда. Он предположил, что это «не совпадение», что все крупные разработчики объявили на одной неделе, и Ноа Фаро, технический руководитель AI-финансового стартапа Farsight, согласился, отметив, что конкуренты отчасти читают планы друг друга по доступности облачных вычислений: все они борются за мощности у одной и той же горстки поставщиков. Фаро добавил и отрезвляющее замечание: в отличие от GPT-6 Astra, релизы Anthropic, Meta и Google на той неделе были точечными обновлениями, апгрейдами существующих моделей, а не новыми моделями. По его оценке, последние два релиза, действительно сдвинувшие стрелку, — Fable 5 от Anthropic в июне и Kimi K3 от Moonshot AI в июле.
Итого: шесть анонсов, одна по-настоящему новая фронтирная модель и целый цикл оценки работы, сгенерированный для всех, кто ниже по цепочке.
Два способа, которыми отрасль это поглощает, и они не одинаковы
Если лаборатории не принимают решение, его должен принять кто-то. Появились два ответа, и они структурно разные.
Горизонтальный ответ — маршрутизация. Шлюзы вроде LiteLLM ставят все модели за один API-ключ и пытаются выбирать под каждый запрос. Халил описывает техническую проблему точно: для любой закрытой задачи существует минимально пригодная модель — самая дешёвая из тех, что ещё справляются, — и трудность в том, чтобы предсказать, какая это, до запуска задачи. Лучший на сегодня подход его команды выводит это из публичных бенчмарков плюс эвристик в промпте; они пробовали также классификацию через LLM и гибриды. Его собственный вердикт: «Всё пока несовершенно, но на ступень лучше, чем ничего».
Маршрутизация — настоящая инженерия, и она помогает. Но заметьте, что она сдвигает, а что нет. Она поглощает сантехнику: один ключ, один интерфейс, автоматический доступ к новым моделям. Она не поглощает ответственность. Когда роутер выбирает неверно, плохой вывод всё равно ваш, в вашем продукте, перед вашим пользователем. Оценивать, был ли ответ хорош, по-прежнему вам.
Вертикальный ответ — полностью управляемое ПО, созданное под одну работу. Здесь поставщик не маршрутизирует между моделями от вашего имени; он забирает задачу целиком и выдаёт готовый результат. Вы не видите названия модели. Вы видите транскрипт, резюме, перевод, поданный авансовый отчёт.
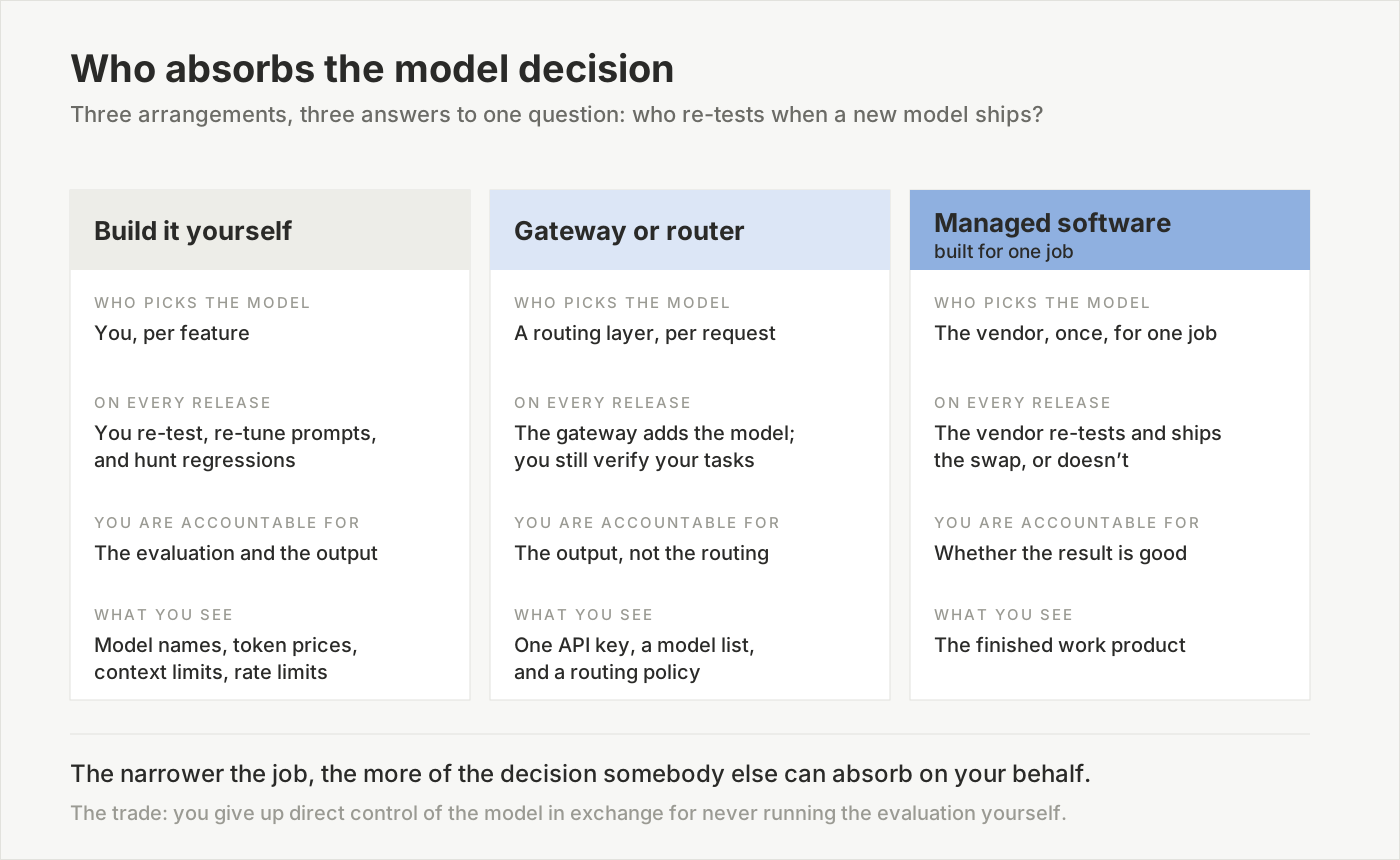
Чем правее, тем меньше решения остаётся у вас — и тем сильнее вы зависите от того, честно ли поставщик провёл оценку.
Сообщество локального ИИ пришло к похожему выводу с противоположной стороны. Опубликованный в этом году разбор описывал сцену малых моделей как беговую дорожку: скачал, настроил, прогнал пару промптов, оценил вполсилы, побежал к следующему релизу. Рекомендация была — прекратить: стандартизироваться на одной проверенной повседневной сборке и брать новую модель только после того, как протестировали её достаточно долго на реальных, репрезентативных задачах и убедились, что она действительно лучше именно для вашей нагрузки. Один и тот же вывод, к которому пришли и любитель с двумя GPU, и гендиректор с вычислительным бюджетом: выбрать один раз, как следует, и перестать пересматривать это каждый четверг.
Почему именно узость работы делает решение поглощаемым
Вот наша позиция, и именно в ней причина существования этой категории.
Решение о модели может принять только тот, кто знает задачу. Звучит банально. Это не так, потому что этим отсекаются почти все.
Универсальный чат-интерфейс не может решить за вас, потому что любым утром его могут попросить написать сонет, отладить состояние гонки или пересказать договор аренды. Для «чего угодно, что пользователь напечатает следующим» минимально пригодной модели не существует. Единственная безопасная настройка по умолчанию — сильнейшая доступная модель, ровно та настройка, что отвечает интересам поставщика, и ровно та, отговаривать от которой, по словам Халила, ни у кого нет стимула.
Шлюз может угадать лучше, потому что видит промпт. Но он видит промпт, не зная, как выглядит хороший ответ в вашей области, и не неся последствий, если ошибётся.
Специализированное управляемое ПО занимает совершенно иную позицию. Когда работа зафиксирована — расшифровать 60-минутную встречу с четырьмя говорящими, переключающимися между русским и английским, и затем составить список задач, — задача закрыта ровно в том смысле, что имел в виду Халил. Для неё существует минимально пригодная модель. И, что решающе, это одна и та же минимально пригодная модель для каждого клиента с такой работой: значит, оценку нужно провести один раз, а её стоимость распределяется на всех.
В этом весь экономический аргумент категории, и его стоит записать как правило: чем уже работа, тем большую часть решения о модели кто-то другой может взять на себя. Поставщик, обслуживающий одну нагрузку, может позволить себе протестировать все 10 кандидатов, потому что тестирует их один раз, для тысяч клиентов, против фиксированного определения хорошего результата. А вы, тестируя пять, для себя одного, против определения, которое ещё предстоит придумать, идёте дорогим путём к худшему ответу.
Обмен здесь реальный, и его стоит назвать честно. Вы отдаёте прямой контроль над тем, какая модель выполняет вашу работу. Взамен вы перестаёте гонять оценку, перестаёте следить за релизными календарями, и предметом суждения становится результат — то единственное, что вас изначально и волновало.
Как понять, какую схему вы покупаете
Перед следующей покупкой ИИ — четыре вопроса по порядку:
- Задача закрытая? Можете ли вы одним предложением сказать, как выглядит правильный вывод? Если да, управляемый вертикальный инструмент может взять решение на себя. Если ответ «зависит от того, что мы спросим», вы покупаете универсальную модель, и оценка остаётся вашей.
- Кто перетестирует, когда выходит новая модель? Спросите поставщика напрямую. Управляемый поставщик должен уметь описать свой оценочный набор и процесс замены. Если ответ в том, что вы получите «доступ к новейшим моделям», вы купили сантехнику, а не суждение.
- Что вам показывают — модель или результат? Если продукт выводит названия моделей, окна контекста и цены за токен, он возвращает решение вам. Это законный продукт, но и оценивайте его соответственно.
- Какова полная стоимость на вашем объёме? Цена за токен, умноженная на реально потраченные на вашей работе токены и на число попыток до верного результата. Прогоните собственные задачи. Страница тарифов на это не ответит.
Итог: фронтир — это значение по умолчанию, а не решение
Модельную усталость обычно описывают как проблему внимания: слишком много новостей, слишком быстро. Это не так. Это издержка, которую самый быстрорастущий рынок технологий тихо переложил на своих клиентов, где она и лежит — без цены и почти без измерения.
Лаборатории будут выпускать дальше, потому что выпускать — их работа, и рынок за это платит. Нагрузка по оценке будет расти дальше, потому что растёт механически с каждым релизом. А большинство команд будет решать это единственным доступным занятой команде способом: тянуться к самой новой, самой большой и самой дорогой модели — единственному варианту, который никому не нужно защищать на совещании.
Любая программа, которая забирает у вас работу целиком и никогда не показывает названия модели, — это ставка на то, что вести бизнес так плохо. С каждой релизной неделей ставка выглядит всё лучше.
Где здесь Telli.sh: это и есть категория, в которой мы строим. Telli.sh записывает встречи, разделяет говорящих, переводит в реальном времени между 15 языками и делает резюме и списки задач — и никогда не спрашивает, какую модель использовать, потому что это наша работа, а не ваша. Наше браузерное расширение действительно предлагает девять движков перевода, включая полностью локальный вариант, для тех, кому такой контроль по-настоящему нужен; продукт для встреч намеренно этого не делает, потому что «хорошо расшифровать эту встречу» — закрытая задача, и нам предпочтительнее, чтобы судили по транскрипту, а не по модели за ним.
Запишите следующую встречу — а модель пусть выбирает кто-то другой
Источники
- CNBC, «'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace», 6 сентября 2026 — хронология релизов 1–3 сентября 2026 года; цитата Чжэнь Лу о том, что «модельная усталость — вещь вполне реальная»; замечание Сэма Альтмана о «более быстрых каденциях»; Ахмед Аббаси об «игре за долю кошелька» и частных оценках почти в 1 трлн долларов; Ноа Фаро о точечных обновлениях и о Fable 5 и Kimi K3 как двух последних, сдвинувших стрелку; и цифра Суреша Васудевана: пять моделей из десяти. Материал подготовлен при участии Кейт Руни и Маккензи Сигалос; получено 8 сентября 2026 года
- Moe Khalil, «Model Fatigue is Real», 4 сентября 2026 — аргумент «нет стимула сообщать мне, когда хватило бы модели подешевле»; рамка минимально пригодной модели для закрытых задач; и измеренный вывод, что более сильная и дорогая модель решала более трудные задачи за долю стоимости дешёвой. Халил раскрыл в посте, что он продуктовый инженер LiteLLM, которая делает автороутер; получено 8 сентября 2026 года
- Gartner, «Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026», 19 мая 2026 — мировые расходы на ИИ 2,59 трлн долларов в 2026 году, рост на 47 % год к году, крупнейший сегмент — AI-инфраструктура
- MindStudio, «Local AI Model Fatigue: Why One Setup Beats Chasing Every Release» — описание цикла релизов локальных малых моделей как беговой дорожки и доводы в пользу стандартизации на одной проверенной повседневной сборке
- AI타임스, «[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'», 7 сентября 2026 — публикация на корейском, разнёсшая материал CNBC и окружающие комментарии разработчиков
- Наше прочтение покупки Hugging Face компанией NVIDIA — другой анонс той же недели и слой дистрибуции под каждой названной здесь моделью
- Как измерять точность расшифровки на собственной нагрузке — во что обходится настоящая оценка, когда её проводят как следует