Quatro modelos de fronteira em três dias, e ninguém vai dizer de qual você precisava
Entre 1º e 3 de setembro de 2026, Anthropic, Meta, Google e OpenAI lançaram modelos de fronteira, e a CNBC deu um nome ao esgotamento resultante: fadiga de modelos. O número de lançamentos é a parte chata. A parte interessante é que cada lançamento cria uma avaliação que alguém, lá embaixo, terá de rodar, e as empresas que os publicam não têm motivo algum para ajudar você a pular essa etapa. Quanto custa de fato trocar de modelo, por que mais barato por token não é mais barato por tarefa, e por que um software totalmente gerenciado, feito para um único trabalho específico, é o único arranjo em que outra pessoa pode decidir por você.
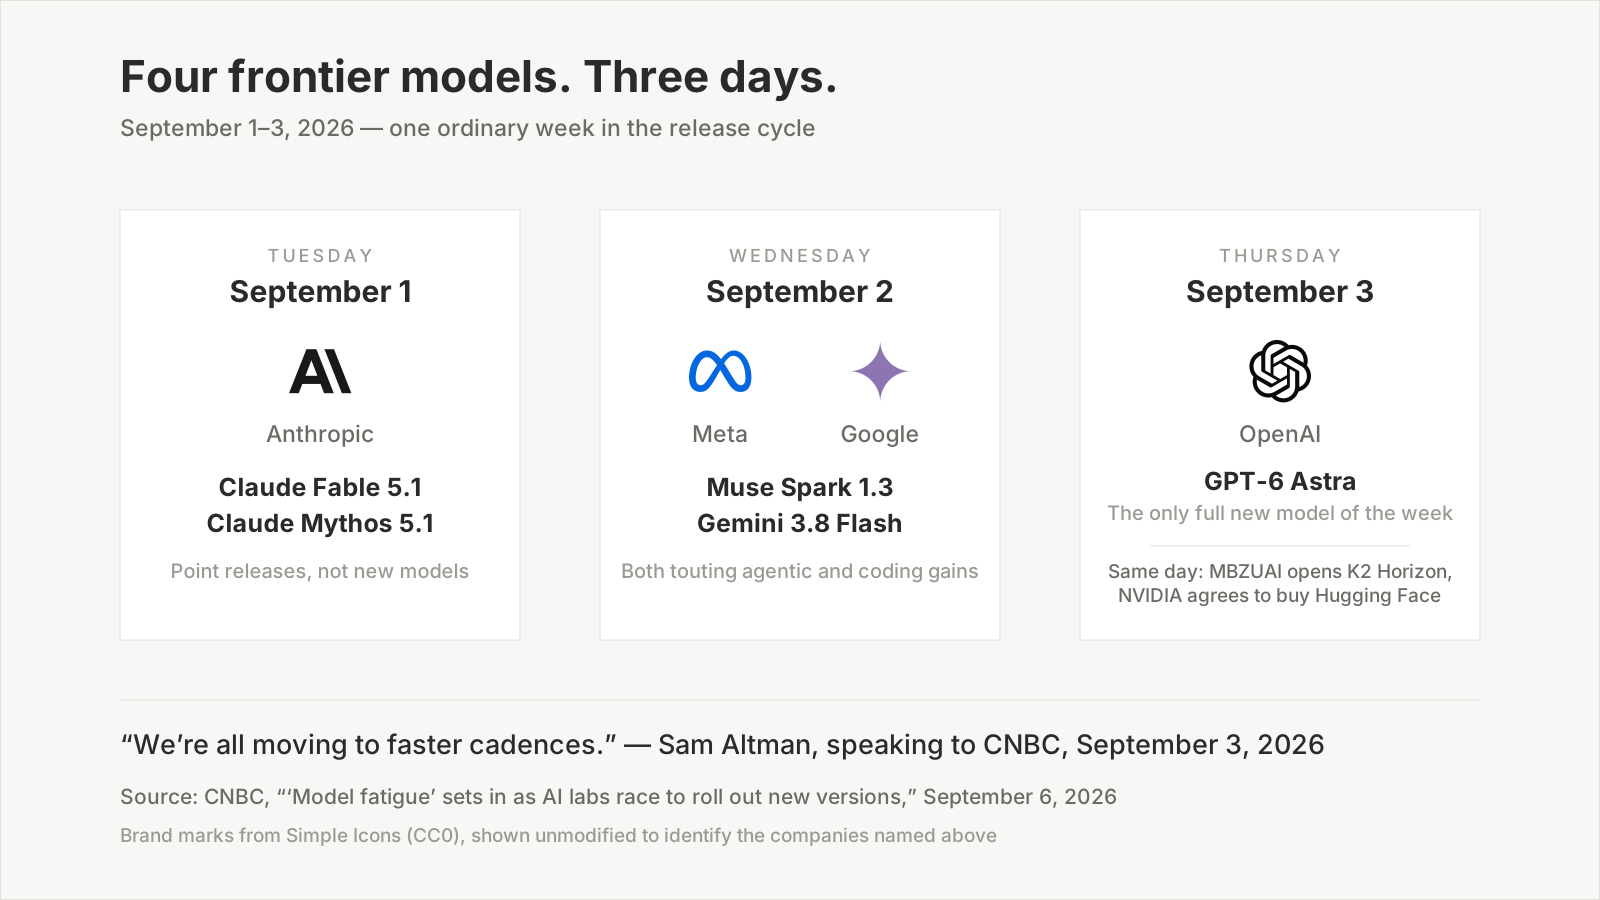
Marcas de Simple Icons (CC0), exibidas sem modificação para identificar as empresas citadas. Datas de lançamento e citação de Altman conforme a CNBC, 6 de setembro de 2026.
Entre terça e quinta da primeira semana de setembro de 2026, a Anthropic lançou Claude Fable 5.1 e Claude Mythos 5.1, a Meta lançou Muse Spark 1.3, o Google lançou Gemini 3.8 Flash e a OpenAI lançou GPT-6 Astra. Nessa mesma quinta-feira, a Mohamed bin Zayed University of Artificial Intelligence, em Abu Dhabi, abriu ao mundo sua família K2 Horizon, e a NVIDIA concordou em comprar a Hugging Face por US$ 12.930.300.000.
Seis anúncios. Três dias. A CNBC publicou a reportagem no domingo, 6 de setembro, sob uma expressão que circulava havia semanas entre profissionais da área: fadiga de modelos.
A leitura óbvia é que a indústria está andando mais rápido do que qualquer um consegue acompanhar. Essa leitura é verdadeira e, em grande parte, sem graça. A parte que merece sua atenção é outra: cada lançamento transfere um custo, e a transferência corre em uma única direção. Todo modelo que um laboratório lança vira uma avaliação que alguém, lá embaixo, precisa rodar — e ninguém lá em cima tem o menor motivo para ajudar você a pular isso.
TL;DR
- Quatro lançamentos de fronteira em três dias (1º a 3 de setembro de 2026); a CNBC batizou o esgotamento resultante de "fadiga de modelos" em 6 de setembro.
- O custo real não é atenção, é trabalho de avaliação. Um CEO do setor contou à CNBC que, quando sua equipe quer avaliar 10 modelos para uma tarefa, testa cerca de 5.
- Preço por token é um péssimo indicador do custo por tarefa: um modelo mais forte e mais caro pode concluir trabalhos mais difíceis por menos, porque dá menos passos.
- Fornecedores de modelos não têm interesse estrutural em dizer quando um modelo mais barato daria conta. Essa lacuna é a razão inteira de existir do software gerenciado e feito sob medida.
A fadiga de modelos ganhou nome em 6 de setembro
"Eu sinto que a fadiga de modelos é uma coisa real", disse à CNBC Zhen Lu, CEO da Runpod, startup de infraestrutura de IA. "Não me entenda mal, estou extremamente empolgado com toda a inovação que está acontecendo, mas realmente acho que estamos num ambiente com tanta espuma que você precisa fazer barulho."
Sam Altman ofereceu à CNBC, na mesma semana, um enquadramento mais gentil: "estamos todos migrando para cadências mais rápidas", disse ele, atribuindo parte da aceleração ao fato de todo mundo estar "de volta das férias de verão".
As duas coisas podem ser verdade. A cadência está de fato acelerando, e a aceleração é de fato, em parte, encenação. Ahmed Abbasi, professor da Mendoza School of Business, de Notre Dame, com 25 anos de IA, expôs a lógica comercial sem rodeios: os laboratórios estão "todos jogando o jogo da fatia da carteira". Anthropic e OpenAI empurram com mais força enquanto caminham para os mercados públicos, e cada uma já é avaliada por investidores privados em algo perto de US$ 1 trilhão.
A carteira em questão é enorme. Em maio de 2026, o Gartner projetou que o gasto mundial com IA chegaria a US$ 2,59 trilhões neste ano, uma alta de 47% sobre 2025. A infraestrutura fica com a maior fatia, mas bem mais de US$ 1 trilhão cai em serviços, software, segurança, modelos e ferramentas — ou seja, em decisões que alguém precisa tomar.
Aqui está o ponto: um mercado desse tamanho, crescendo nessa velocidade, recompensa quem faz barulho. Não recompensa dizer ao cliente que ele se viraria com menos.
O custo não é atenção. É a avaliação que você não consegue terminar
Pergunte a quem trabalha na área como é a fadiga de modelos na prática e você não ouve "leio posts de lançamento demais". Você ouve aritmética.
Suresh Vasudevan, CEO da Clockwork Systems, startup de IA corporativa, deu à CNBC o número mais útil da reportagem inteira. Se a empresa dele quer avaliar 10 modelos de IA para uma tarefa específica, disse, talvez acabe escolhendo cinco. "É realmente difícil ir e avaliar cada um dos que estão saindo agora."
Fique um instante nessa proporção, porque ela é o fato que sustenta o assunto todo. Uma empresa cujo negócio é IA corporativa, com gente que faz isso profissionalmente e com orçamento de computação alocado exatamente para isso, avalia metade dos candidatos que ela própria considera dignos de avaliação.
Chame a outra metade de os cinco não testados. Eles não foram rejeitados. Ninguém os achou insuficientes. Simplesmente nunca foram rodados e, por isso, a pergunta sobre se algum deles teria sido mais rápido, mais barato ou mais preciso na sua carga de trabalho específica fica aberta para sempre. Toda semana de lançamentos engorda essa pilha.
E a pilha custa caro para ser vencida, porque trocar de modelo não é subir uma versão. É uma requalificação. Eis o que precisa acontecer de verdade antes que um modelo novo chegue à produção:
| O que precisa ser reverificado | Por que um modelo novo quebra isso |
|---|---|
| Prompts e instruções de sistema | Ajustados às manias do modelo antigo; uma formulação que conduzia um modelo com segurança pode conduzir outro para outro lugar |
| Estabilidade do formato de saída | Os parsers seguintes dependem da forma — JSON, títulos, delimitadores — e os hábitos de formatação mudam entre modelos |
| Precisão nos seus dados reais | Diferenças de benchmark são medidas em conjuntos públicos, não nas suas reuniões, nos seus tíquetes, no seu código |
| Comportamento de ferramentas e APIs | Modelos agênticos diferem em quando chamam, com que frequência tentam de novo e o que fazem quando uma chamada falha |
| Latência e vazão sob carga | Um modelo mais rápido numa requisição isolada pode ser mais lento atrás dos seus limites de taxa |
| Custo total no seu volume | Preço por token vezes tokens consumidos vezes tentativas — veja abaixo |
| Segurança e comportamento de recusa | Os limites se movem entre versões, nos dois sentidos |
| Casos de regressão | Exatamente as falhas que você já corrigiu, e que nenhum benchmark alheio conhece |
Oito categorias, cada uma exigindo exemplos reais, uma rodada comparativa e o julgamento de alguém. Isso é um projeto, não uma mudança de configuração. Multiplique pelo número de lançamentos de fronteira de um mês qualquer e a razão da proporção de 10 para 5 fica evidente.
Escrevemos um texto inteiro sobre como medir isso na sua própria carga de trabalho em vez de confiar num ranking, e o resumo honesto é que fazer direito leva dias, não horas.
Mais barato por token não é mais barato por tarefa
A constatação mais contraintuitiva de toda essa história não veio de um laboratório, mas de um engenheiro tentando automatizar a escolha.
Moe Khalil, engenheiro de produto do gateway de IA de código aberto LiteLLM, publicou em 4 de setembro um post intitulado "Model Fatigue is Real". Ele trabalha no auto router da LiteLLM — software cujo trabalho inteiro é escolher um modelo por você — e declarou essa filiação logo de saída, o que é mais do que a maioria de quem escreve sobre isso faz.
A suposição inicial da equipe dele era a intuitiva. Pegue dois modelos capazes de resolver a mesma tarefa; aquele que custa metade por token, segundo a ficha do modelo, deveria resolvê-la por cerca de metade do preço.
Não foi o que os testes mostraram. O modelo mais forte e mais caro estava resolvendo as tarefas mais difíceis por uma fração do custo do modelo barato. A explicação de Khalil: "Porque era mais inteligente, ele tomava um caminho mais inteligente e chegava ao produto final muito mais rápido."
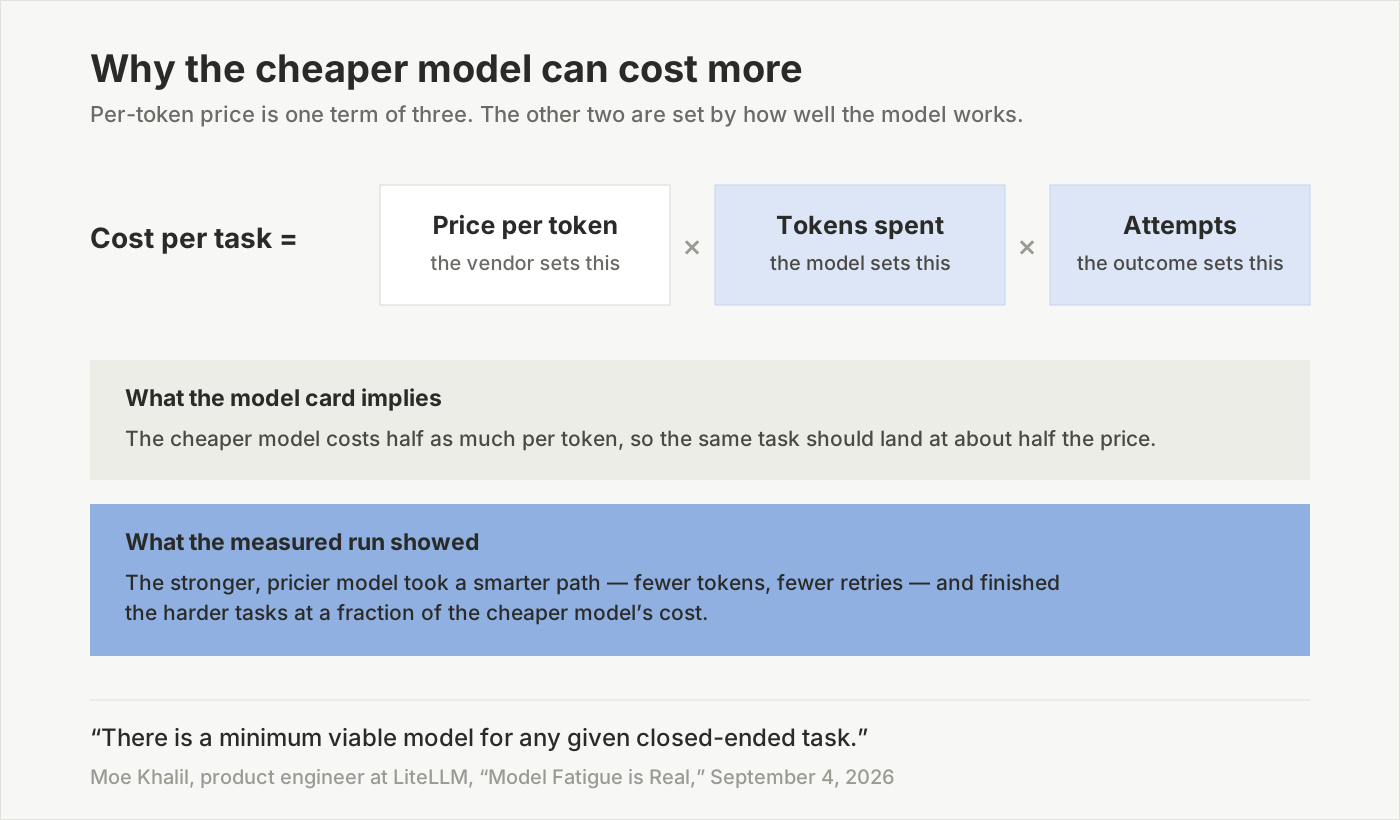
Dos três termos, o preço por token é o único que aparece numa página de preços. Os outros dois são propriedades da competência do modelo e só se revelam quando você roda o trabalho.
Isso reconfigura a página de preços por completo. O número que um fornecedor anuncia é um fator num produto de três: preço por token, tokens gastos e tentativas até a tarefa realmente dar certo. O primeiro é definido pelo fornecedor. O segundo e o terceiro são definidos pelo próprio modelo, e nenhum dos dois é conhecível antes de você passar o seu trabalho por ele.
O que significa que a comparação que ensinaram você a fazer — correr os olhos pela coluna de preços e pegar o barato — não é apenas incompleta. Em tarefas reais, ela pode apontar para o lado errado.
Lá em cima ninguém tem incentivo para avisar você
Khalil então diz a parte que costuma ficar em silêncio, e é a frase mais afiada escrita este ano sobre o assunto:
"Para as empresas de modelos, essa preguiça é um recurso — não um defeito. Elas preferem que eu use [o modelo de topo] para resumir meu e-mail, e não têm incentivo algum para me dizer quando um modelo mais barato funcionaria igualmente bem. O trabalho delas é continuar empurrando a fronteira. Descobrir quando não usar a fronteira é problema meu."
Leia isso de novo com o número do Gartner na cabeça. Um mercado de US$ 2,59 trilhões, crescendo 47% ao ano, no qual os fornecedores se beneficiam de cada cliente que sobe de faixa por padrão e não arcam com nada quando o cliente gasta demais.
Isso não é conspiração e não exige que ninguém se comporte mal. É simplesmente o formato do gradiente de incentivos. O trabalho de um laboratório de fronteira é mover a fronteira. Dizer que o modelo intermediário do ano passado dá conta de 80% da sua carga de trabalho é trabalho de outra pessoa e, até pouco tempo atrás, não era trabalho de ninguém.
A segunda observação de Abbasi também cabe aqui. Ele sugeriu que "não é coincidência" que todos os grandes desenvolvedores tenham anunciado na mesma semana, e Noah Faro, chefe de tecnologia da Farsight, startup de finanças com IA, concordou, notando que os rivais leem os planos uns dos outros em parte pela disponibilidade de computação em nuvem, já que todos disputam capacidade do mesmo punhado de fornecedores. Faro também fez a ressalva que esvazia o hype: diferentemente do GPT-6 Astra, os lançamentos de Anthropic, Meta e Google naquela semana foram versões intermediárias, upgrades de modelos existentes em vez de modelos novos. Na avaliação dele, os dois últimos lançamentos que realmente mexeram o ponteiro foram o Fable 5 da Anthropic, em junho, e o Kimi K3 da Moonshot AI, em julho.
Então: seis anúncios, um modelo de fronteira genuinamente novo e um ciclo inteiro de avaliação de trabalho gerado para todo mundo lá embaixo.
Dois modos como a indústria está absorvendo isso, e eles não são iguais
Se os laboratórios não tomam a decisão, alguém precisa tomar. Surgiram duas respostas, e elas são estruturalmente diferentes.
A resposta horizontal é o roteamento. Gateways como o LiteLLM colocam todos os modelos atrás de uma única chave de API e tentam escolher a cada requisição. Khalil descreve o problema técnico com precisão: para qualquer tarefa fechada existe um modelo mínimo viável — o mais barato que ainda dá certo — e o desafio é prever qual é ele antes de a tarefa rodar. A melhor abordagem atual da equipe dele infere isso a partir de dados de benchmarks públicos mais heurísticas no prompt; eles também tentaram classificação por LLM e híbridos. O veredito dele mesmo: "Tudo ainda imperfeito, mas um degrau acima de nada."
Roteamento é engenharia de verdade e ajuda. Mas repare no que ele move e no que não move. Ele absorve o encanamento: uma chave, uma interface, acesso automático a modelos novos. Ele não absorve a responsabilidade. Quando o roteador escolhe errado, a saída ruim continua sendo sua, dentro do seu produto, na frente do seu usuário. Avaliar se a resposta foi boa continua sendo com você.
A resposta vertical é software totalmente gerenciado feito para um único trabalho. Aqui o fornecedor não roteia entre modelos em seu nome; ele tira a tarefa inteira das suas mãos e entrega um resultado pronto. Você não vê nome de modelo. Você vê uma transcrição, um resumo, uma tradução, um relatório de despesas enviado.
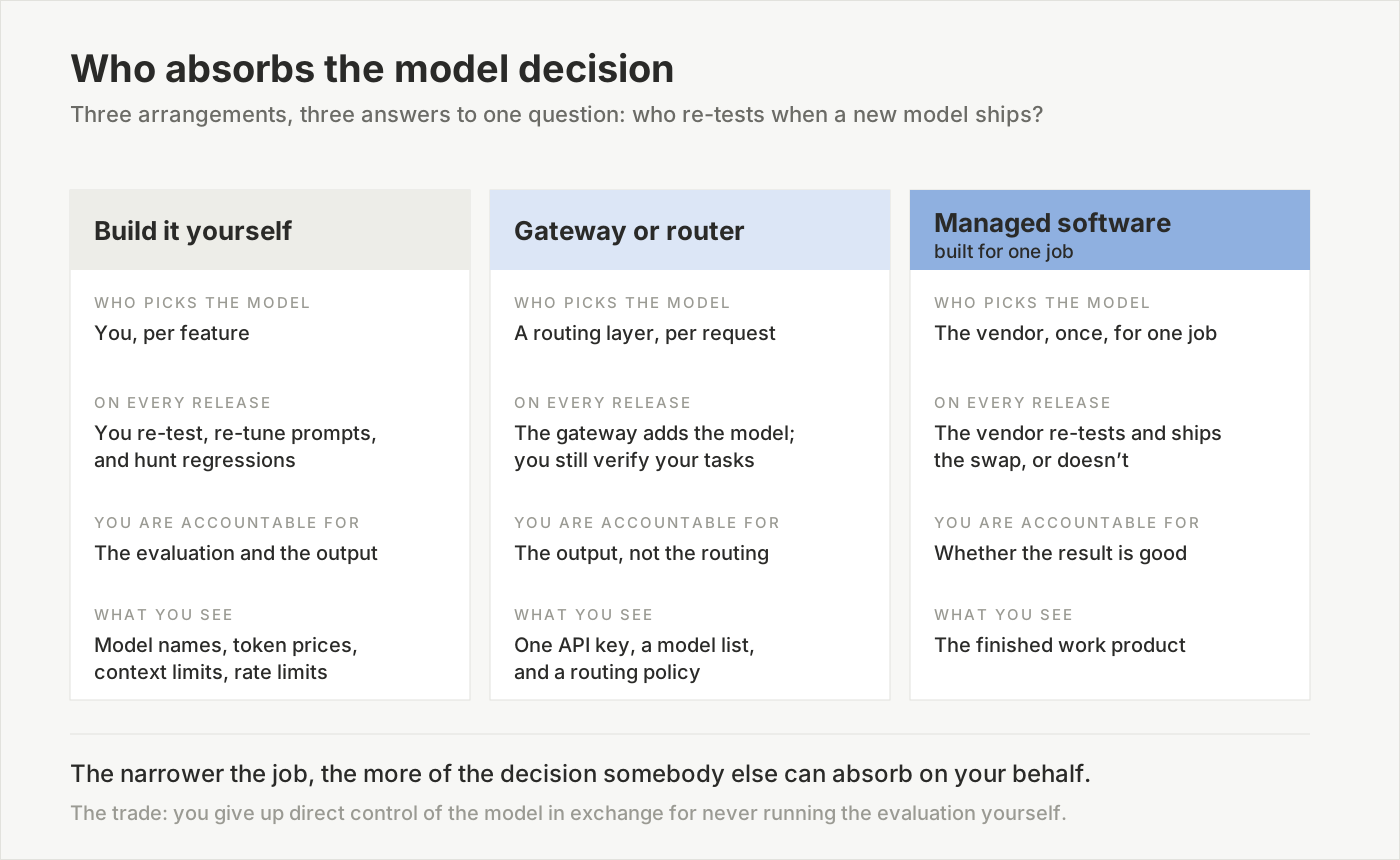
Quanto mais à direita, menos da decisão continua sendo sua — e mais você depende de o fornecedor ter feito a avaliação com honestidade.
A comunidade de IA local chegou a uma conclusão parecida pelo caminho oposto. Uma análise publicada neste ano descreveu a cena dos modelos pequenos como uma esteira: baixar, configurar, rodar alguns prompts, julgar pela metade, seguir para o próximo lançamento. A recomendação era parar — padronizar em uma configuração diária comprovada e adotar um modelo novo só depois de testá-lo tempo suficiente em tarefas reais e representativas para confirmar que ele é de fato melhor para a sua carga de trabalho específica. A mesma conclusão, alcançada por um entusiasta com duas GPUs e por um CEO com orçamento de computação: escolha uma vez, direito, e pare de rediscutir isso toda quinta-feira.
Por que é um trabalho estreito que torna a decisão absorvível
Esta é a nossa posição, e é a razão de essa categoria existir.
A decisão de modelo só pode ser tomada por quem conhece a tarefa. Parece trivial. Não é, porque isso exclui quase todo mundo.
Uma interface de chat de uso geral não consegue decidir por você, porque em qualquer manhã pode ser chamada a escrever um soneto, depurar uma condição de corrida ou resumir um contrato de aluguel. Não existe modelo mínimo viável para "o que quer que o usuário digite em seguida". O único padrão seguro é o modelo mais forte disponível — exatamente o padrão que serve aos interesses do fornecedor e exatamente o padrão do qual, segundo Khalil, ninguém tem incentivo para dissuadir você.
Um gateway consegue chutar melhor, porque enxerga o prompt. Mas enxerga o prompt sem saber como é uma boa resposta no seu domínio, e sem consequência se errar.
Software gerenciado feito sob medida ocupa uma posição inteiramente diferente. Quando o trabalho é fixo — transcrever uma reunião de 60 minutos com quatro participantes alternando entre português e inglês e depois produzir itens de ação — a tarefa é fechada exatamente no sentido de Khalil. Existe um modelo mínimo viável para ela. E, o que é decisivo, é o mesmo modelo mínimo viável para todo cliente que tem esse trabalho, o que significa que a avaliação precisa ser rodada uma vez só e seu custo é diluído entre todos.
Esse é o argumento econômico inteiro da categoria, e vale enunciá-lo como regra: quanto mais estreito o trabalho, maior a parte da decisão de modelo que outra pessoa pode absorver por você. Um fornecedor que atende uma única carga de trabalho pode se dar ao luxo de testar os 10 candidatos, porque testa uma vez, para milhares de clientes, contra uma definição fixa de bom resultado. Você testar cinco, sozinho, contra uma definição que ainda precisa inventar, é o jeito caro de chegar a uma resposta pior.
A troca é real e merece ser nomeada com honestidade. Você abre mão do controle direto sobre qual modelo roda o seu trabalho. Em troca, para de rodar a avaliação, para de acompanhar calendários de lançamento, e o que você julga é a saída — que sempre foi a única coisa com que você de fato se importava.
Como saber qual arranjo você está comprando
Antes da sua próxima compra de IA, quatro perguntas na ordem:
- O trabalho é fechado? Você consegue dizer em uma frase como é uma saída correta? Se sim, uma ferramenta vertical gerenciada pode assumir a decisão. Se a resposta for "depende do que a gente pedir", você está comprando um modelo geral e a avaliação continua sendo sua.
- Quem retesta quando sai um modelo novo? Pergunte diretamente ao fornecedor. Um fornecedor gerenciado deveria conseguir descrever seu conjunto de avaliação e seu processo de troca. Se a resposta for que você terá "acesso aos modelos mais recentes", você comprou encanamento, não julgamento.
- O que é mostrado a você — um modelo ou um resultado? Se o produto expõe nomes de modelos, janelas de contexto e preços por token, ele está devolvendo a decisão para você. É um produto legítimo, mas precifique-o de acordo.
- Como fica o custo total no seu volume? Preço por token, vezes os tokens realmente consumidos no seu trabalho, vezes as tentativas até acertar. Rode as suas próprias tarefas. A página de preços não responde a isso.
Conclusão: a fronteira é um padrão, não uma decisão
A fadiga de modelos costuma ser descrita como um problema de atenção — notícia demais, rápido demais. Não é. É um custo que o mercado que mais cresce na tecnologia empurrou discretamente para os clientes, onde ele fica sem preço e em boa medida sem medição.
Os laboratórios vão continuar lançando, porque lançar é o trabalho deles e o mercado paga por isso. A carga de avaliação vai continuar crescendo, porque cresce mecanicamente a cada lançamento. E a maioria dos times vai continuar resolvendo isso do único jeito que um time ocupado consegue: pegando o modelo mais novo, maior e mais caro — a única opção que ninguém precisa defender numa reunião.
Todo software que tira um trabalho inteiro das suas mãos, e nunca mostra um nome de modelo, é uma aposta de que aquele é um jeito ruim de tocar um negócio. A aposta parece melhor a cada semana de lançamentos.
Onde a Telli.sh entra: essa é a categoria em que construímos. A Telli.sh grava reuniões, separa os participantes, traduz em tempo real entre 15 idiomas e produz resumos e itens de ação — e nunca pergunta qual modelo usar, porque isso é trabalho nosso, não seu. Nossa extensão de navegador de fato oferece nove mecanismos de tradução, incluindo uma opção totalmente no dispositivo, para quem realmente quer esse controle; o produto de reuniões deliberadamente não oferece, porque "transcrever bem esta reunião" é uma tarefa fechada e preferimos ser julgados pela transcrição, não pelo modelo por trás dela.
Grave sua próxima reunião e deixe outra pessoa escolher o modelo
Fontes
- CNBC, "'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace", 6 de setembro de 2026 — a cronologia de lançamentos de 1º a 3 de setembro de 2026; a citação de Zhen Lu de que "a fadiga de modelos é uma coisa real"; a observação de Sam Altman sobre "cadências mais rápidas"; Ahmed Abbasi sobre o "jogo da fatia da carteira" e as avaliações privadas perto de US$ 1 trilhão; Noah Faro sobre versões intermediárias e sobre Fable 5 e Kimi K3 como os dois últimos que mexeram o ponteiro; e o número de Suresh Vasudevan, cinco modelos avaliados de dez. Com contribuição de Kate Rooney e MacKenzie Sigalos; consultado em 8 de setembro de 2026
- Moe Khalil, "Model Fatigue is Real", 4 de setembro de 2026 — o argumento do "nenhum incentivo para me dizer quando um modelo mais barato funcionaria"; o enquadramento do modelo mínimo viável para tarefas fechadas; e a constatação medida de que o modelo mais forte e mais caro resolvia tarefas mais difíceis por uma fração do custo do mais barato. Khalil informou no post que é engenheiro de produto da LiteLLM, que desenvolve um auto router; consultado em 8 de setembro de 2026
- Gartner, "Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026", 19 de maio de 2026 — gasto mundial com IA de US$ 2,59 trilhões em 2026, alta de 47% na comparação anual, com a infraestrutura de IA como maior segmento
- MindStudio, "Local AI Model Fatigue: Why One Setup Beats Chasing Every Release" — a descrição em esteira do ciclo de lançamentos de modelos pequenos locais e a defesa de padronizar em uma configuração diária comprovada
- AI타임스, "[9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감'", 7 de setembro de 2026 — a cobertura em coreano que repercutiu a reportagem da CNBC e os comentários de desenvolvedores em torno dela
- Nossa leitura da compra da Hugging Face pela NVIDIA — o outro anúncio da mesma semana, e a camada de distribuição por baixo de todos os modelos citados aqui
- Como medir a precisão de transcrição na sua própria carga de trabalho — quanto custa uma avaliação de verdade, quando você a faz direito