Quatre modèles de pointe en trois jours, et personne ne vous dira lequel il vous fallait
Entre le 1er et le 3 septembre 2026, Anthropic, Meta, Google et OpenAI ont tous livré des modèles de pointe, et CNBC a donné un nom à l'épuisement qui en résulte : la fatigue des modèles. Le nombre de sorties est la partie ennuyeuse. La partie intéressante, c'est que chaque sortie crée une évaluation que quelqu'un, en aval, devra mener — et que les entreprises qui les publient n'ont aucune raison de vous aider à l'éviter. Ce que coûte réellement un changement de modèle, pourquoi moins cher au token ne veut pas dire moins cher à la tâche, et pourquoi un logiciel entièrement géré, conçu pour une seule tâche précise, est le seul arrangement où quelqu'un d'autre peut décider à votre place.
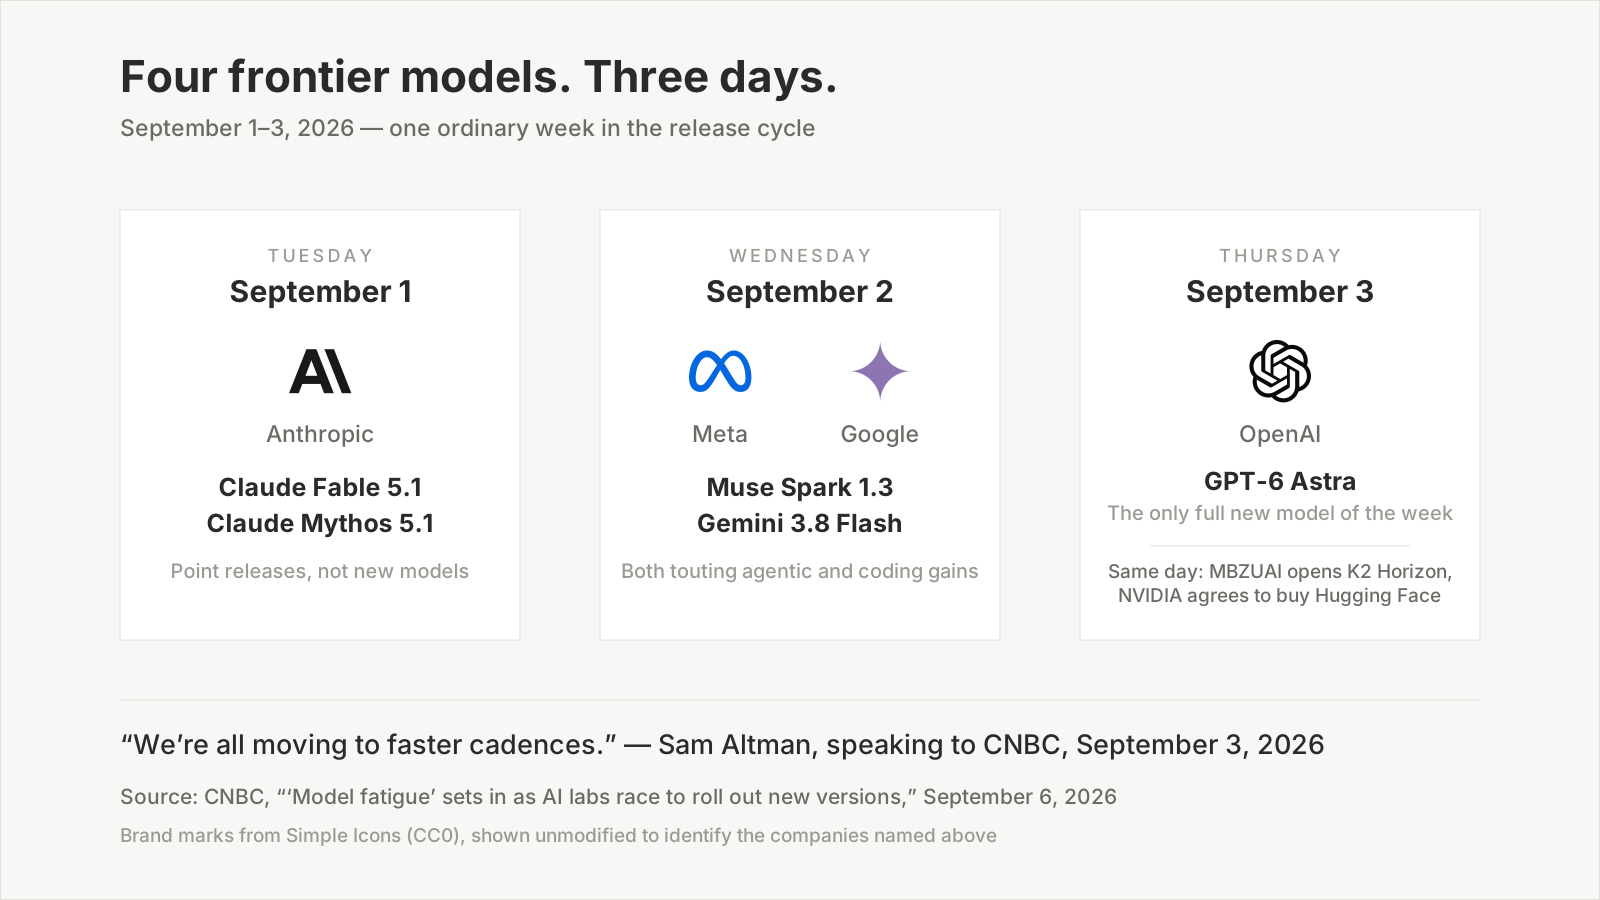
Marques déposées issues de Simple Icons (CC0), reproduites sans modification pour identifier les entreprises citées. Dates de sortie et citation d'Altman d'après CNBC, 6 septembre 2026.
Entre le mardi et le jeudi de la première semaine de septembre 2026, Anthropic a livré Claude Fable 5.1 et Claude Mythos 5.1, Meta a livré Muse Spark 1.3, Google a livré Gemini 3.8 Flash et OpenAI a livré GPT-6 Astra. Le même jeudi, la Mohamed bin Zayed University of Artificial Intelligence d'Abou Dabi a ouvert sa famille K2 Horizon au monde entier, et NVIDIA a accepté de racheter Hugging Face pour 12 930 300 000 dollars.
Six annonces. Trois jours. CNBC a publié son article le dimanche 6 septembre, sous une expression qui circulait depuis des semaines chez les praticiens : la fatigue des modèles.
La lecture évidente est que le secteur avance plus vite que quiconque ne peut suivre. Cette lecture est juste, et à peu près sans intérêt. Voici la partie qui mérite votre attention : chaque sortie transfère un coût, et le transfert va dans un seul sens. Chaque modèle publié par un laboratoire devient une évaluation que quelqu'un, en aval, doit mener — et personne, en amont, n'a la moindre raison de vous aider à l'éviter.
TL;DR
- Quatre sorties de pointe en trois jours (1er–3 septembre 2026) ; CNBC a baptisé l'épuisement qui en découle « fatigue des modèles » le 6 septembre.
- Le vrai coût n'est pas l'attention, c'est le travail d'évaluation. Un PDG d'une entreprise du secteur a confié à CNBC que, lorsque son équipe veut évaluer 10 modèles pour une tâche, elle en teste environ 5.
- Le prix au token est un mauvais indicateur du coût par tâche : un modèle plus puissant et plus cher peut terminer un travail plus difficile pour moins cher, en prenant moins d'étapes.
- Les fournisseurs de modèles n'ont structurellement aucun intérêt à vous dire quand un modèle moins cher suffirait. C'est précisément ce vide qui justifie l'existence des logiciels gérés et conçus pour un usage précis.
La fatigue des modèles a reçu un nom le 6 septembre
« J'ai le sentiment que la fatigue des modèles est bien réelle », a déclaré à CNBC Zhen Lu, PDG de Runpod, une start-up d'infrastructure d'IA. « Ne vous méprenez pas, toute l'innovation en cours m'enthousiasme énormément, mais je pense vraiment que nous sommes dans un environnement où il y a tellement d'écume qu'il faut faire du bruit. »
Sam Altman a proposé à CNBC, la même semaine, une formulation plus douce : « nous passons tous à des cadences plus rapides », a-t-il dit, attribuant une partie de l'accélération au fait que tout le monde rentre « des vacances d'été ».
Les deux peuvent être vrais. La cadence s'accélère réellement, et l'accélération relève réellement en partie de la mise en scène. Ahmed Abbasi, professeur à la Mendoza School of Business de Notre Dame et fort de 25 ans d'IA, a énoncé la logique commerciale sans détour : les laboratoires jouent « tous au jeu de la part du portefeuille ». Anthropic et OpenAI poussent le plus fort à l'approche des marchés publics, chacun déjà valorisé à près de 1 000 milliards de dollars par des investisseurs privés.
Le portefeuille en question est énorme. Gartner prévoyait en mai 2026 que les dépenses mondiales en IA atteindraient 2 590 milliards de dollars cette année, soit une hausse de 47 % par rapport à 2025. L'infrastructure en capte la plus grosse part, mais bien plus de 1 000 milliards de dollars vont aux services, aux logiciels, à la sécurité, aux modèles et aux outils — c'est-à-dire à des décisions que quelqu'un doit prendre.
Voici le point : un marché aussi grand, qui croît aussi vite, récompense le bruit. Il ne récompense pas le fait de dire aux clients qu'ils pourraient se contenter de moins.
Le coût n'est pas l'attention. C'est l'évaluation que vous n'arrivez pas à finir
Demandez à un praticien à quoi ressemble vraiment la fatigue des modèles et vous n'obtenez pas « je lis trop d'annonces ». Vous obtenez de l'arithmétique.
Suresh Vasudevan, PDG de Clockwork Systems, une start-up d'IA d'entreprise, a livré à CNBC le chiffre le plus utile de tout l'article. Si son entreprise veut évaluer 10 modèles d'IA pour une tâche donnée, dit-il, elle en retiendra peut-être simplement cinq. « C'est vraiment difficile d'aller évaluer chacun de ceux qui sortent en ce moment. »
Arrêtez-vous une seconde sur ce rapport, car c'est le fait porteur de tout le sujet. Une entreprise dont le métier est l'IA d'entreprise, dotée de gens dont c'est le métier, avec un budget de calcul alloué exactement à cet usage, évalue la moitié des candidats qu'elle juge elle-même dignes d'être évalués.
Appelons l'autre moitié les cinq jamais testés. Ils n'ont pas été rejetés. Personne ne les a trouvés insuffisants. Ils n'ont simplement jamais été exécutés, et la question de savoir si l'un d'eux aurait été plus rapide, moins cher ou plus précis sur votre charge de travail précise reste ouverte pour toujours. Chaque semaine de sorties ajoute à cette pile.
Et la pile est coûteuse à traiter, car un changement de modèle n'est pas une montée de version. C'est une requalification. Voici ce qui doit réellement se produire avant qu'un nouveau modèle n'atteigne la production :
| Ce qu'il faut revérifier | Pourquoi un nouveau modèle le casse |
|---|---|
| Prompts et instructions système | Réglés sur les manies de l'ancien modèle ; une formulation qui pilotait l'un de façon fiable peut piloter l'autre ailleurs |
| Stabilité du format de sortie | Les parseurs en aval dépendent de la forme — JSON, titres, délimiteurs — et les habitudes de mise en forme changent d'un modèle à l'autre |
| Précision sur vos données réelles | Les écarts de benchmark se mesurent sur des jeux publics, pas sur vos réunions, vos tickets, votre base de code |
| Comportement des outils et des API | Les modèles agentiques diffèrent sur le moment où ils appellent, la fréquence des reprises et ce qu'ils font quand un appel échoue |
| Latence et débit sous charge | Un modèle plus rapide sur une requête isolée peut être plus lent derrière vos limites de débit |
| Coût total à votre volume | Prix au token multiplié par les tokens consommés multiplié par les tentatives — voir plus bas |
| Sécurité et comportement de refus | Les frontières bougent d'une version à l'autre, dans les deux sens |
| Cas de régression | Les défaillances précises que vous avez déjà corrigées, et dont aucun benchmark extérieur n'a connaissance |
Huit catégories, chacune exigeant de vrais exemples, une exécution comparative et le jugement de quelqu'un. C'est un projet, pas un changement de configuration. Multipliez-le par le nombre de sorties de pointe d'un mois donné et la raison du rapport 10 pour 5 devient évidente.
Nous avons consacré un article entier à la façon de mesurer cela sur votre propre charge de travail plutôt que de faire confiance à un classement, et le résumé honnête est que le faire correctement prend des jours, pas des heures.
Moins cher au token ne veut pas dire moins cher à la tâche
Le constat le plus contre-intuitif de toute cette histoire ne vient pas d'un laboratoire mais d'un ingénieur qui cherchait à automatiser le choix.
Moe Khalil, ingénieur produit chez LiteLLM, la passerelle d'IA open source, a publié le 4 septembre un billet intitulé « Model Fatigue is Real ». Il travaille sur l'auto-routeur de LiteLLM — un logiciel dont le métier entier consiste à choisir un modèle à votre place — et il a divulgué cette affiliation d'entrée de jeu, ce que ne font pas la plupart des gens qui écrivent sur le sujet.
L'hypothèse de départ de son équipe était l'hypothèse intuitive. Prenez deux modèles capables de résoudre la même tâche ; celui qui coûte deux fois moins cher au token selon sa fiche technique devrait la résoudre pour à peu près la moitié du prix.
Ce n'est pas ce qu'ont montré les tests. Le modèle plus puissant et plus cher résolvait les tâches les plus difficiles pour une fraction du coût du modèle bon marché. L'explication de Khalil : « Parce qu'il était plus intelligent, il adoptait une approche plus intelligente et arrivait au produit fini bien plus vite. »
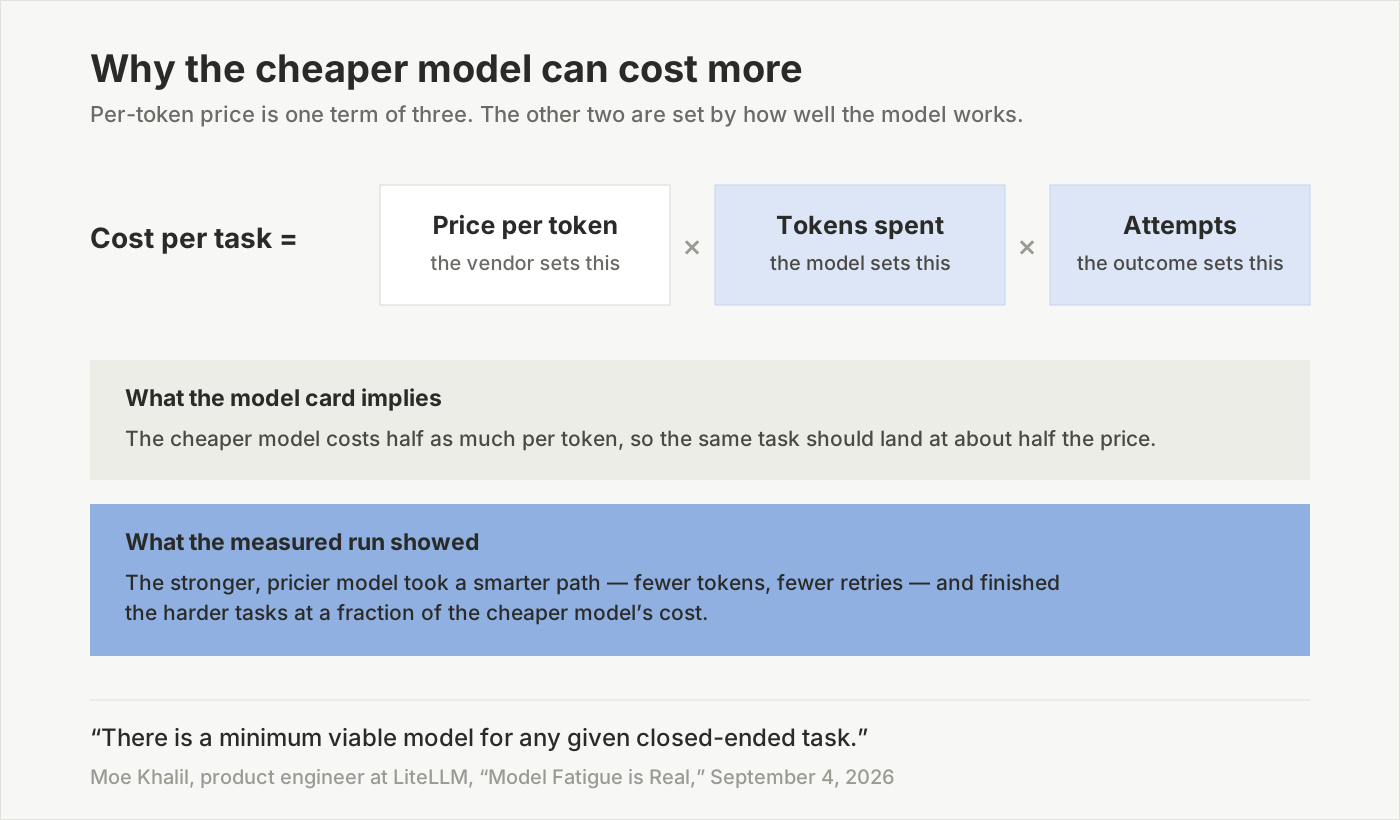
Des trois termes, le prix au token est le seul qui figure sur une page tarifaire. Les deux autres sont des propriétés de la compétence du modèle, et n'apparaissent que lorsque vous faites tourner le travail.
Cela reconfigure entièrement la page tarifaire. Le chiffre affiché par un fournisseur est un facteur dans un produit de trois : prix au token, tokens dépensés et tentatives jusqu'à ce que la tâche réussisse vraiment. Le fournisseur fixe le premier. Le modèle lui-même fixe le deuxième et le troisième, et aucun des deux n'est connaissable avant que vous n'y ayez passé votre propre travail.
Ce qui signifie que la comparaison qu'on vous a apprise — parcourir la colonne des prix, prendre le moins cher — n'est pas seulement incomplète. Sur des tâches réelles, elle peut pointer dans la mauvaise direction.
En amont, personne n'a intérêt à vous le dire
Khalil dit ensuite la partie tue, et c'est la phrase la plus tranchante écrite sur ce sujet cette année :
« Pour les entreprises de modèles, cette paresse est une fonctionnalité, pas un bug. Elles préfèrent que j'utilise [le modèle haut de gamme] pour résumer mes e-mails, et elles n'ont aucun intérêt à me dire quand un modèle moins cher ferait tout aussi bien l'affaire. Leur métier est de continuer à repousser la frontière. Déterminer quand ne pas utiliser la frontière, c'est à moi que ça revient. »
Relisez cela avec le chiffre de Gartner en tête. Un marché de 2 590 milliards de dollars, en croissance de 47 % par an, dans lequel les fournisseurs profitent de chaque client qui monte en gamme par défaut et ne supportent aucun coût quand les clients dépensent trop.
Ce n'est pas un complot et cela n'exige de personne un mauvais comportement. C'est simplement la forme que prend le gradient d'incitations. Le métier d'un laboratoire de pointe est de déplacer la frontière. Vous dire que le modèle de milieu de gamme de l'an dernier traite 80 % de votre charge de travail est le métier de quelqu'un d'autre, et jusqu'à récemment ce n'était le métier de personne.
La deuxième observation d'Abbasi a aussi sa place ici. Il a suggéré que ce n'était « pas une coïncidence » que tous les grands développeurs aient annoncé la même semaine, et Noah Faro, directeur technique de Farsight, une start-up de finance par l'IA, a acquiescé — en notant que les rivaux lisent en partie les plans des uns et des autres dans la disponibilité du calcul en nuage, puisqu'ils se disputent tous la capacité de la même poignée de fournisseurs. Faro a aussi apporté un bémol : contrairement à GPT-6 Astra, les lancements d'Anthropic, Meta et Google de cette semaine-là étaient des versions intermédiaires, des mises à niveau de modèles existants plutôt que de nouveaux modèles. Selon son évaluation, les deux dernières sorties qui ont réellement fait bouger les lignes sont Fable 5 d'Anthropic en juin et Kimi K3 de Moonshot AI en juillet.
Donc : six annonces, un seul modèle de pointe véritablement nouveau, et l'équivalent d'un cycle d'évaluation complet de travail généré pour tout le monde en aval.
Deux façons dont le secteur absorbe cela, et elles ne se valent pas
Si les laboratoires ne prennent pas la décision, quelqu'un doit la prendre. Deux réponses ont émergé, et elles sont structurellement différentes.
La réponse horizontale, c'est le routage. Des passerelles comme LiteLLM placent tous les modèles derrière une seule clé d'API et tentent de choisir requête par requête. Khalil décrit le problème technique avec précision : pour toute tâche fermée il existe un modèle minimal viable — le moins cher qui réussisse encore — et la difficulté est de prédire lequel c'est avant que la tâche ne s'exécute. La meilleure approche actuelle de son équipe le déduit de données de benchmarks publics et d'heuristiques dans le prompt ; ils ont aussi essayé la classification par LLM et des hybrides. Son propre verdict : « Tout cela reste imparfait, mais c'est déjà mieux que rien. »
Le routage est de la vraie ingénierie et il aide. Mais observez ce qu'il déplace et ce qu'il ne déplace pas. Il absorbe la plomberie — une clé, une interface, l'accès automatique aux nouveaux modèles. Il n'absorbe pas la responsabilité. Quand le routeur se trompe, la mauvaise sortie reste la vôtre, dans votre produit, devant votre utilisateur. C'est encore à vous d'évaluer si la réponse était bonne.
La réponse verticale, c'est le logiciel entièrement géré conçu pour une seule tâche. Ici, le fournisseur ne route pas entre les modèles pour vous ; il prend la tâche entière en charge et livre un résultat fini. Vous ne voyez pas de nom de modèle. Vous voyez une transcription, un résumé, une traduction, une note de frais déposée.
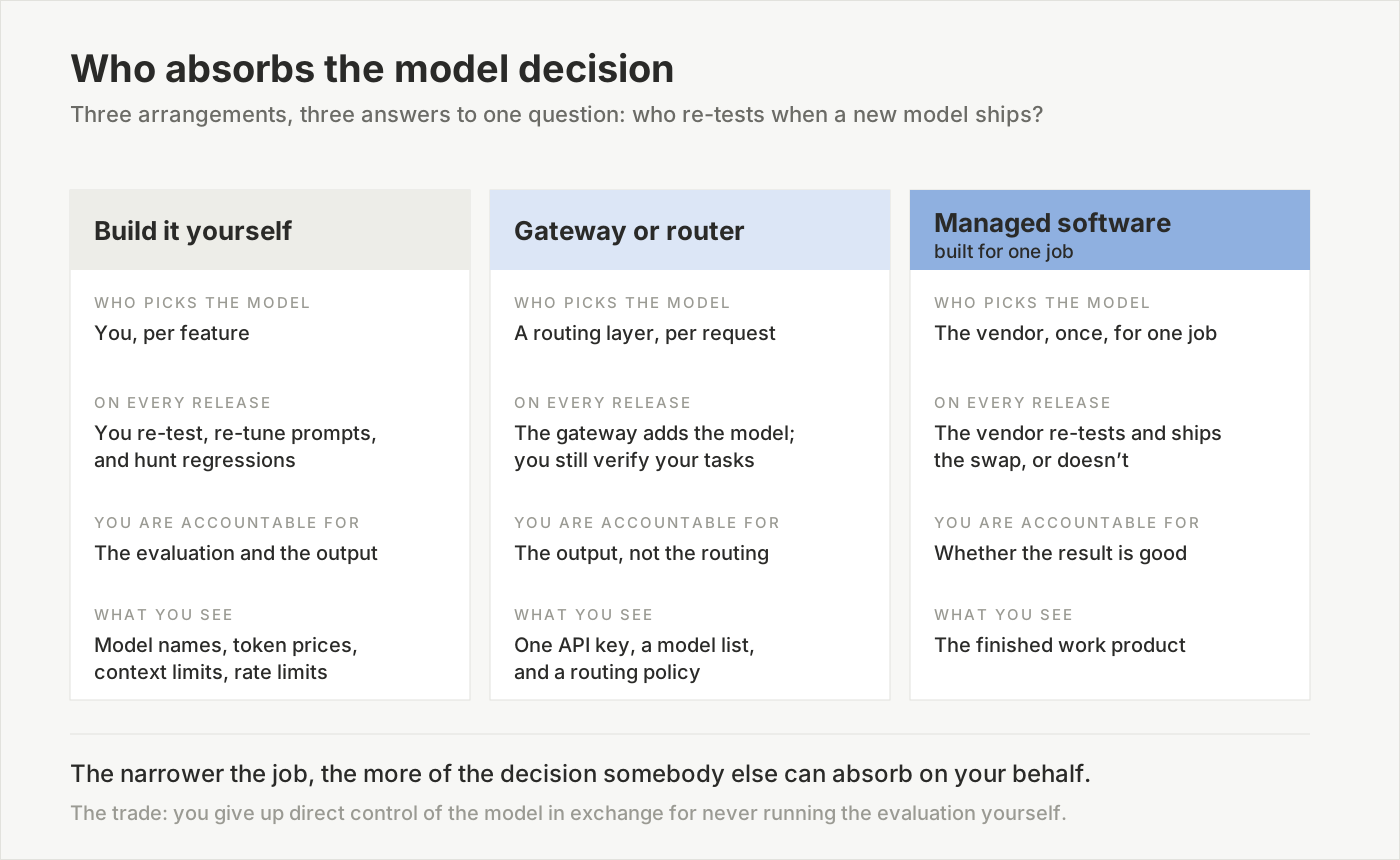
Plus vous allez vers la droite, moins la décision vous appartient — et plus vous dépendez du fait que le fournisseur ait mené l'évaluation honnêtement.
La communauté de l'IA locale est arrivée à une conclusion voisine par le chemin inverse. Une analyse publiée cette année décrivait la scène des petits modèles comme un tapis roulant : télécharger, configurer, lancer quelques prompts, juger à moitié, passer à la sortie suivante. La recommandation était d'arrêter — de se standardiser sur une configuration quotidienne éprouvée et de n'adopter un nouveau modèle qu'après l'avoir testé assez longtemps sur des tâches réelles et représentatives pour confirmer qu'il est réellement meilleur pour votre charge de travail précise. Même conclusion, atteinte par un amateur avec deux GPU et par un PDG avec un budget de calcul : choisir une fois, correctement, et cesser de remettre la question sur la table chaque jeudi.
Pourquoi c'est l'étroitesse de la tâche qui rend la décision absorbable
Voici notre position, et c'est la raison d'être de toute cette catégorie.
La décision de modèle ne peut être prise que par quelqu'un qui connaît la tâche. Cela paraît trivial. Ça ne l'est pas, car cela exclut presque tout le monde.
Une interface de conversation généraliste ne peut pas décider à votre place, car n'importe quel matin on peut lui demander d'écrire un sonnet, de déboguer une condition de concurrence ou de résumer un bail. Il n'existe pas de modèle minimal viable pour « ce que l'utilisateur tapera ensuite ». Le seul choix par défaut sûr est le modèle le plus puissant disponible — soit exactement le choix par défaut qui sert les intérêts du fournisseur, et exactement celui dont, selon Khalil, personne n'a intérêt à vous dissuader.
Une passerelle peut mieux deviner, parce qu'elle voit le prompt. Mais elle le voit sans savoir à quoi ressemble une bonne réponse dans votre domaine, et sans conséquence si elle se trompe.
Le logiciel géré et conçu pour un usage précis occupe une position entièrement différente. Quand la tâche est fixée — transcrire une réunion de 60 minutes avec quatre locuteurs qui alternent entre le français et l'anglais, puis produire des actions à mener — la tâche est fermée exactement au sens de Khalil. Il existe pour elle un modèle minimal viable. Et surtout, c'est le même modèle minimal viable pour chaque client ayant cette tâche, ce qui signifie que l'évaluation ne doit être menée qu'une fois et que son coût est amorti sur tout le monde.
C'est là tout l'argument économique de la catégorie, et il mérite d'être énoncé comme une règle : plus la tâche est étroite, plus quelqu'un d'autre peut absorber la décision de modèle à votre place. Un fournisseur qui sert une seule charge de travail peut se permettre de tester les 10 candidats, parce qu'il les teste une fois, pour des milliers de clients, face à une définition fixe du bon résultat. Que vous en testiez cinq, pour vous seul, face à une définition qu'il vous faut inventer, est la façon chère d'obtenir une moins bonne réponse.
L'échange est réel et mérite d'être nommé honnêtement. Vous abandonnez le contrôle direct du modèle qui exécute votre travail. En échange, vous cessez de mener l'évaluation, vous cessez de suivre les calendriers de sortie, et ce que vous jugez, c'est le résultat — la seule chose qui vous importait vraiment depuis le début.
Comment savoir quel arrangement vous achetez
Avant votre prochain achat d'IA, quatre questions dans l'ordre :
- La tâche est-elle fermée ? Pouvez-vous dire en une phrase à quoi ressemble une sortie correcte ? Si oui, un outil vertical géré peut prendre la décision en charge. Si la réponse est « ça dépend de ce qu'on lui demande », vous achetez un modèle généraliste et l'évaluation reste la vôtre.
- Qui reteste quand un nouveau modèle sort ? Posez la question directement au fournisseur. Un fournisseur géré doit pouvoir décrire son jeu d'évaluation et son processus de bascule. Si la réponse est que vous aurez « accès aux derniers modèles », vous avez acheté de la plomberie, pas du jugement.
- Qu'est-ce qu'on vous montre — un modèle ou un résultat ? Si le produit affiche des noms de modèles, des fenêtres de contexte et des prix au token, il vous renvoie la décision. C'est un produit légitime, mais tarifez-le en conséquence.
- À quoi ressemble le coût total à votre volume ? Prix au token, multiplié par les tokens réellement consommés sur votre travail, multiplié par les tentatives nécessaires pour aboutir. Faites tourner vos propres tâches. La page tarifaire ne peut pas répondre à cela.
En résumé : la frontière est un réglage par défaut, pas une décision
La fatigue des modèles est d'ordinaire décrite comme un problème d'attention — trop de nouvelles, trop vite. Ce n'en est pas un. C'est un coût que le marché à la croissance la plus rapide de la technologie a discrètement déplacé sur ses clients, où il reste sans prix et largement non mesuré.
Les laboratoires continueront de livrer, parce que livrer est leur métier et que le marché paie pour cela. La charge d'évaluation continuera de croître, parce qu'elle croît mécaniquement à chaque sortie. Et la plupart des équipes continueront de la résoudre de la seule façon possible pour une équipe débordée : en attrapant le modèle le plus récent, le plus gros, le plus cher — la seule option que personne n'a à défendre en réunion.
Tout logiciel qui vous décharge complètement d'une tâche — et ne vous montre jamais un nom de modèle — est un pari sur le fait que c'est une mauvaise manière de gérer une entreprise. Le pari paraît meilleur à chaque semaine de sorties.
Où Telli.sh se situe : c'est la catégorie dans laquelle nous construisons. Telli.sh enregistre les réunions, sépare les locuteurs, traduit en temps réel dans 15 langues et produit des résumés et des actions à mener — et il ne vous demande jamais quel modèle utiliser, parce que c'est notre métier, pas le vôtre. Notre extension de navigateur, elle, propose bien neuf moteurs de traduction dont une option entièrement embarquée, pour celles et ceux qui veulent vraiment ce contrôle ; le produit de réunion ne le fait délibérément pas, parce que « bien transcrire cette réunion » est une tâche fermée et que nous préférons être jugés sur la transcription plutôt que sur le modèle derrière.
Enregistrez votre prochaine réunion et laissez quelqu'un d'autre choisir le modèle
Sources
- CNBC, « 'Model fatigue' sets in as AI labs race to roll out new versions at dizzying pace », 6 septembre 2026 — la chronologie des sorties du 1er au 3 septembre 2026 ; la citation de Zhen Lu sur « la fatigue des modèles est bien réelle » ; la remarque de Sam Altman sur les « cadences plus rapides » ; Ahmed Abbasi sur le « jeu de la part du portefeuille » et les valorisations privées proches de 1 000 milliards de dollars ; Noah Faro sur les versions intermédiaires et sur Fable 5 et Kimi K3 comme les deux dernières à avoir fait bouger les lignes ; et le chiffre de Suresh Vasudevan, cinq modèles évalués sur dix. Contributions de Kate Rooney et MacKenzie Sigalos ; consulté le 8 septembre 2026
- Moe Khalil, « Model Fatigue is Real », 4 septembre 2026 — l'argument de l'« aucun intérêt à me dire quand un modèle moins cher ferait l'affaire » ; le cadre du modèle minimal viable pour les tâches fermées ; et le constat mesuré selon lequel le modèle plus puissant et plus cher résolvait les tâches difficiles pour une fraction du coût du moins cher. Khalil a précisé dans son billet qu'il est ingénieur produit chez LiteLLM, qui développe un auto-routeur ; consulté le 8 septembre 2026
- Gartner, « Gartner Forecasts Worldwide AI Spending to Grow 47% in 2026 », 19 mai 2026 — des dépenses mondiales en IA de 2 590 milliards de dollars en 2026, en hausse de 47 % sur un an, l'infrastructure d'IA constituant le plus gros segment
- MindStudio, « Local AI Model Fatigue: Why One Setup Beats Chasing Every Release » — la description en tapis roulant du cycle de sorties des petits modèles locaux et le plaidoyer pour se standardiser sur une configuration quotidienne éprouvée
- AI타임스, « [9월7일] '일주일에 4개나 출시'...커지는 '모델 피로감' », 7 septembre 2026 — la couverture en coréen qui a relayé l'article de CNBC et les commentaires de développeurs qui l'ont entouré
- Notre lecture du rachat de Hugging Face par NVIDIA — l'autre annonce de la même semaine, et la couche de distribution sous chacun des modèles cités ici
- Comment mesurer la précision de transcription sur votre propre charge de travail — ce que coûte une véritable évaluation menée correctement