Ten sam wskaźnik błędu 10,0%, przeciwna decyzja: jak mierzyć dokładność transkrypcji spotkań
Wskaźnik błędu słów wycenia słowo „nie” i słowo „ten” dokładnie tak samo — i właśnie dlatego dwie transkrypcje mogą obie wypaść na 10,0%, a użyteczna będzie tylko jedna z nich. Oto pełna procedura pomiaru: 12-minutowy klip testowy zbudowany pod specyfikację prawdziwego spotkania, transkrypcja referencyjna z zamrożonymi regułami normalizacji, dokładne komendy cpWER i DER oraz pięciowymiarowa karta wyników, która surowemu WER przyznaje 10 punktów na 100.
Oto dwie maszynowe transkrypcje tego samego dwudziestowyrazowego zdania z zebrania produktowego.
A — „Priya said Helios migration slips to Q3 and we should not sign the vendor contract before security review” (Priya powiedziała, że migracja Heliosa przesuwa się na Q3 i że nie powinniśmy podpisywać umowy z dostawcą przed przeglądem bezpieczeństwa).
B — „Priya said the Helios migration slips to Q2 and we should sign the vendor contract before the security review” (…przesuwa się na Q2 i że powinniśmy podpisać umowę z dostawcą przed przeglądem bezpieczeństwa).
Każda z nich zawiera dokładnie dwa błędy względem tego, co naprawdę padło. Każda uzyskuje wskaźnik błędu słów równy 10,0%. Transkrypcja A dwukrotnie zgubiła słowo „the”. Transkrypcja B przesunęła termin o kwartał do przodu i skasowała słowo „not” z podjętego zobowiązania.
Jeśli twój proces oceny stawia te dwa systemy na równi, to problemem jest proces — nie modele.
Ten tekst to procedura pomiarowa, którą podalibyśmy komuś, kto ma do piątku wybrać narzędzie do transkrypcji. Opisujemy w nim, co dokładnie liczy wskaźnik błędu słów; dlaczego ta liczba wprowadza w błąd akurat przy nagraniach ze spotkań; oraz pięciokrokowy protokół, który przeprowadzisz w jedno popołudnie z dwoma pakietami open source i 12-minutowym nagraniem. Osobno przekonywaliśmy już, że sama dokładność transkrypcji nigdy nie była produktem końcowym. To tekst towarzyszący — nie argument, lecz metoda.
W skrócie:
- WER to
(substitutions + deletions + insertions) ÷ reference words, a każde słowo waży tyle samo. Przeczenie „nie” i przedimek „the” kosztują dokładnie tyle samo.- Publikowane rankingi się skompresowały. W niezależnym zestawieniu Artificial Analysis, pobranym 31 sierpnia 2026 roku, pięć najlepszych modeli mieści się między 1,7% a 2,6% AA-WER — to zbyt wąski rozrzut, żeby wskazać z niego zwycięzcę.
- Zamiast tego oceniaj pięć wymiarów, ważonych: terminy nośne (30), przypisanie mówców (25), liczebniki i kwoty (20), segmentacja (15), surowy WER (10). Narzędzia do trudnych części już istnieją —
cpWERiDERsą w MeetEval, zestawie zbudowanym na potrzeby wyzwań CHiME.
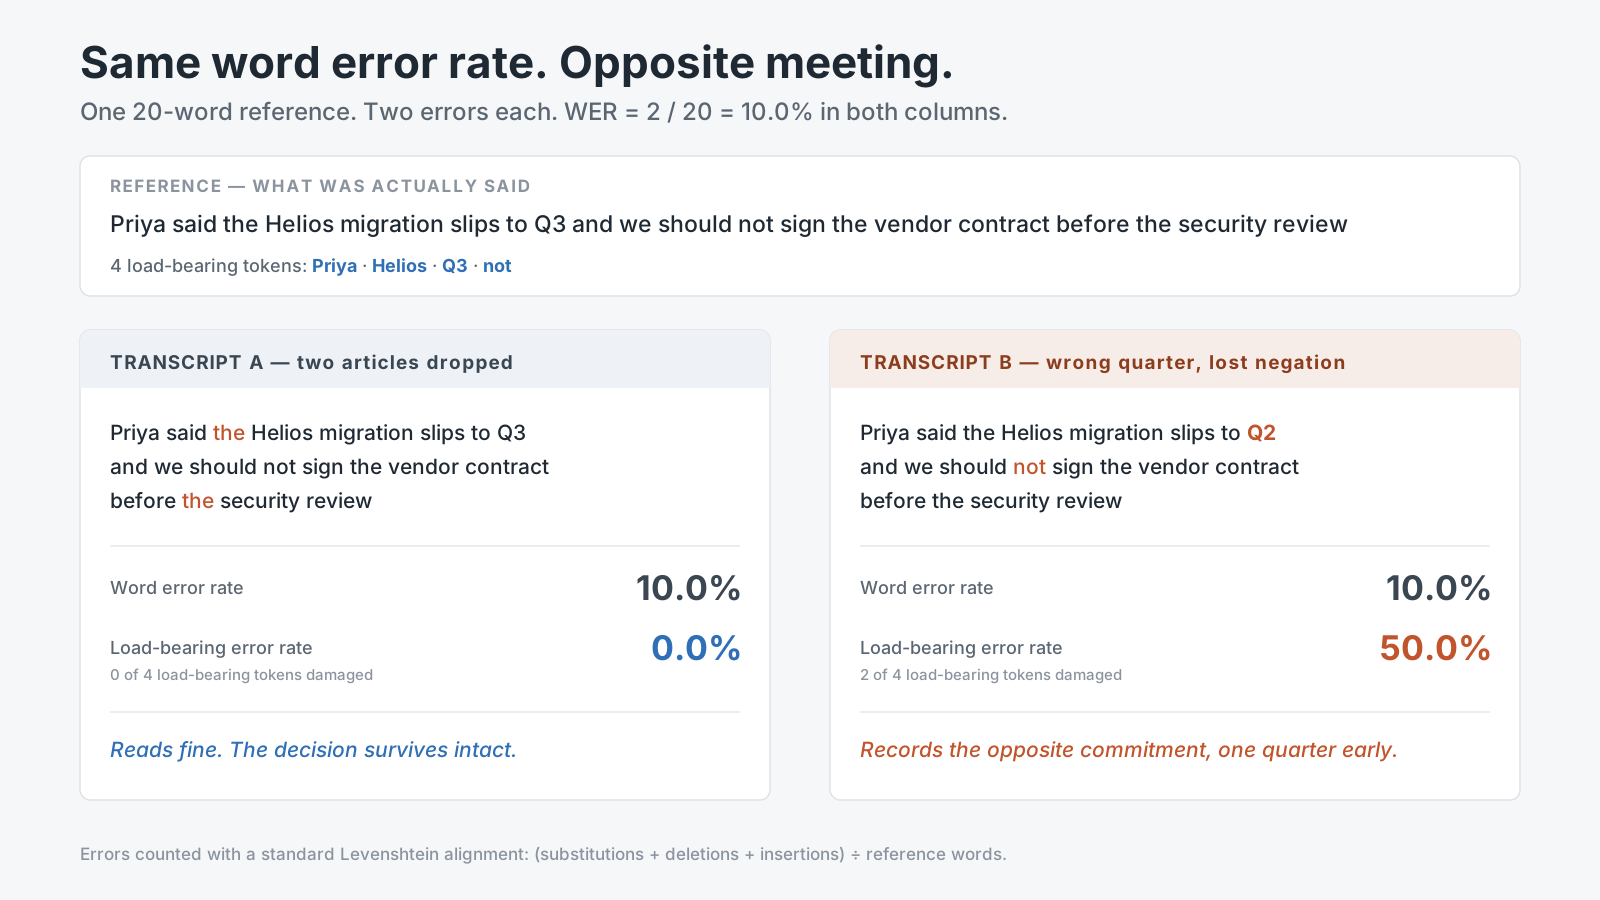
Obie kolumny zawierają dwa błędy wobec 20-wyrazowego odniesienia. Tylko jedna z nich nadal zapisuje decyzję, którą faktycznie podjęto w sali.
Co dokładnie liczy wskaźnik błędu słów
WER bierze się z jednego dopasowania. Weź transkrypcję referencyjną — to, co ludzie zgodnie uznali za wypowiedziane. Weź wyjście maszyny. Znajdź najtańszą sekwencję edycji, która zamienia jedno w drugie, korzystając z klasycznego dopasowania Levenshteina, i oznacz każdą edycję:
- substytucja, gdy model napisał inne słowo („deploy” usłyszane jako „delay”),
- usunięcie, gdy słowo z odniesienia nie ma odpowiednika na wyjściu,
- wstawienie, gdy model wyprodukował słowo, którego nikt nie powiedział.
Następnie:
WER = (substitutions + deletions + insertions) ÷ reference words
Mianownikiem jest długość odniesienia, a nie długość hipotezy — dlatego WER może całkiem legalnie przekroczyć 100%. Model, który swobodnie halucynuje, jest w stanie nazbierać więcej wstawień, niż było na początku słów.
Przykład rozpisany na liczbach, wzięty z dokumentacji samego MeetEval, żeby arytmetykę dało się sprawdzić wobec opublikowanego wyniku. Odniesienie: „The quick brown fox jumps over the lazy dog” — dziewięć słów. Hipoteza: „The kwick brown fox jump over lazy” — siedem słów. Dopasowanie znajduje dwie substytucje (quick→kwick, jumps→jump) i dwa usunięcia (the, dog), zero wstawień. To (2 + 2 + 0) ÷ 9 = 0,4444, czyli WER równy 44,4%, i MeetEval wypisuje dokładnie to: ErrorRate(error_rate=0.4444…, errors=4, length=9, insertions=0, deletions=2, substitutions=2).
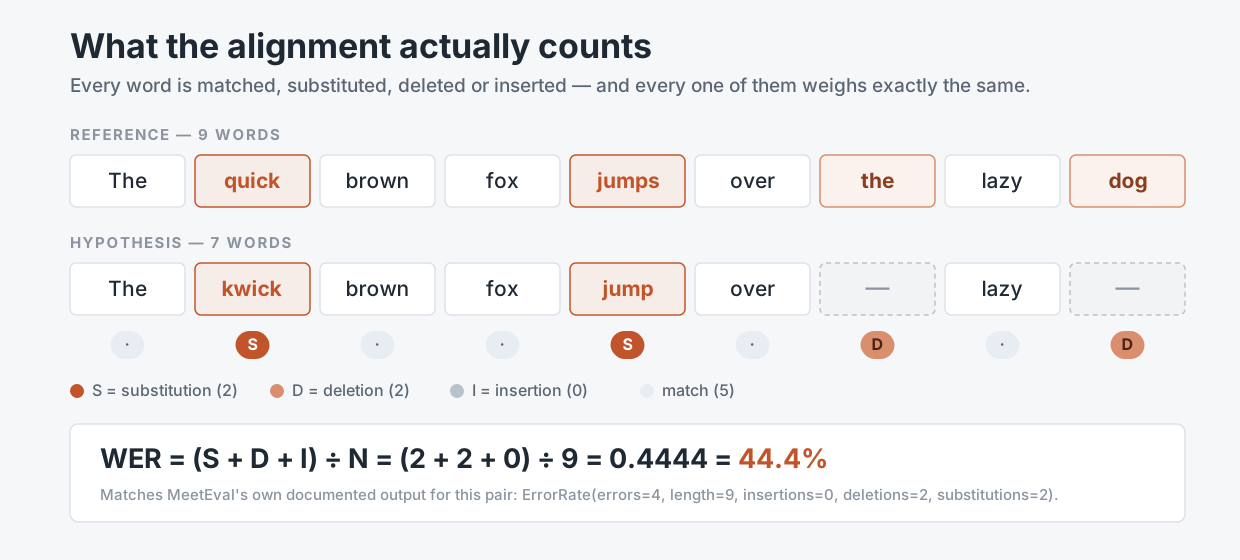
Dopasowanie jest mechaniczne i odtwarzalne. Czym nie jest — to ważone. Źródło: dokumentacja MeetEval, pobrana 31 sierpnia 2026 roku.
Dwie własności tego wzoru znaczą więcej niż cokolwiek na stronie sprzedażowej dostawcy. Po pierwsze, jest płaski: metryka nie ma pojęcia, że jedne słowa niosą całe spotkanie, a inne niosą gramatykę. Po drugie, jest ślepy na mówców: standardowy WER skleja wszystko w jeden strumień, więc system, który idealnie zapisuje każde słowo, ale połowę przypisuje niewłaściwej osobie, może wykręcić nieskazitelny wynik.
Dlaczego opublikowane liczby nie rozdzielą już twoich kandydatów
Wyciągnij rankingi, a problem sprowadzi się do arytmetyki. Artificial Analysis, która prowadzi własne ewaluacje zamiast przedrukowywać deklaracje dostawców, wymieniła 31 sierpnia 2026 roku swoją piątkę najlepszych modeli według AA-WER: Fun-Realtime-ASR-preview z 1,7%, ElevenLabs Scribe v2 z 2,2%, MAI-Transcribe-1.5 Microsoftu z 2,4%, Smallest AI Pulse Pro z 2,4% oraz Gemini 3.5 Transcribe z 2,6%. Najlepszy model o otwartych wagach, Voxtral Small od Mistrala, ma 2,8%.
Cała czołówka rynku mieści się w paśmie 1,1 punktu. Na 45-minutowym spotkaniu, w którym pada mniej więcej 6300 słów, różnica między pierwszym a piątym miejscem to około 57 słów — poniżej jednego słowa na ekran transkrypcji.
Jest jeszcze drugi problem: nagrania benchmarkowe to nie są twoje nagrania. AA-WER v2 to średnia ważona czasem trwania dźwięku po mniej więcej ośmiu godzinach z trzech źródeł: AA-AgentTalk w 50%, VoxPopuli-Cleaned-AA w 25% i Earnings22-Cleaned-AA w 25%. Przemówienia parlamentarne i telekonferencje wynikowe są dobrze nagrane, wygłaszane po kolei i w dużej mierze wolne od tego, co definiuje wewnętrzne spotkanie — czworga ludzi przerywających sobie nawzajem w sprawie projektu, o którym słyszeli tylko oni.
Badania nad naprawdę konwersacyjnym dźwiękiem od lat traktują to jako osobną dyscyplinę. Wyzwanie CHiME-6, opublikowane 20 kwietnia 2020 roku przez Watanabego, Mandela, Barkera i osiemnaścioro współautorów, zbudowało swoją ewaluację na nagraniach z kolacji właśnie dlatego, że naturalna rozmowa z nakładaniem się głosów i mikrofonami z oddali rozkłada systemy, które dobrze wypadają na mowie czytanej. Korpus AMI Meeting Corpus, 100 godzin nagrań zarejestrowanych jednocześnie zestawami nagłownymi i mikrofonami dalekiego pola, istnieje z tego samego powodu.
I tu jest sedno, powiemy to bez asekuracji: opublikowany WER mówi ci, że model dostawcy nie jest zepsuty. Nie powie ci, od którego dostawcy kupić.
Co WER wyłapuje, a czego strukturalnie nie może
| Rodzaj awarii | Wyłapany przez surowy WER? | Ile cię kosztuje | Co to naprawdę mierzy |
|---|---|---|---|
| Przesłyszane częste słowo („their”/„there”) | Tak, z pełną wagą | Prawie nic | WER |
| Wycięte wypełniacze i falstarty | Tak, liczone jako usunięcia | Nic — często to poprawa | WER, myląco |
| Przekręcona nazwa własna („Xochitl” → „Societal”) | Tak, ale z wagą 1 słowa | Nazwisko osoby odpowiedzialnej | Wskaźnik błędu na terminach nośnych |
| Zły liczebnik lub data („Q3” → „Q2”) | Tak, waga 1 słowa | Przekroczony termin | Dokładność liczebników, punktowana osobno |
| Skasowane przeczenie („should not” → „should”) | Tak, waga 1 słowa | Odwrócona decyzja | Wskaźnik błędu na terminach nośnych |
| Słowa poprawne, zły mówca | Nie — WER jest ślepy na mówców | Nikt nie wie, kto się zobowiązał | cpWER, DER |
| Tury mówców zlane w jeden blok | Nie | Nieczytelna ściana tekstu | tcpWER z collarem, przeczytanie przez człowieka |
| Brak granic zdań | Nie — interpunkcja jest normalizowana | Podsumowanie zgadujące strukturę | Ocena segmentacji, przeczytanie przez człowieka |
| Cały fragment zhalucynowany podczas ciszy | Częściowo — jako wstawienia | Zmyślona treść podana jako zapis | WER plus liczba wstawień czytana osobno |
Dolna połowa tej tabeli to ta połowa, która decyduje, czy transkrypcja stanie się użyteczną notatką — i standardowy WER nie widzi z niej nic. To nie jest wada metryki: WER odpowiada na pytanie, do którego zaprojektowano go w badaniach nad dyktowaniem w latach 90. To wada używania go samodzielnie w 2026 roku.
Krok 1: zbuduj 12-minutowy klip, który zachowuje się jak prawdziwe spotkanie
Nie oceniaj na pliku demonstracyjnym dostawcy i nie oceniaj na ośmiu godzinach własnego archiwum. Potrzebujesz jednego klipu — dość krótkiego, by przepisać go ręcznie, i dość gęstego, by coś w nim pękło.
Celuj w 12 minut. Przy normalnym tempie rozmowy około 140 słów na minutę i mniej więcej 75-procentowej gęstości mówienia daje to około 1260 słów referencyjnych — dość, by 2-punktowa różnica we wskaźniku błędu oznaczała 25 słów, a nie szum statystyczny, i wystarczająco mało, by dwie osoby starannie przepisały to w jedno popołudnie.
Buduj klip pod specyfikację, nie pod przeczucie. Nasza wygląda tak:
- Czterech lub więcej mówców, w tym co najmniej jedna osoba dołączająca zdalnie skompresowanym kanałem audio i co najmniej jeden akcent nierodzimy w języku roboczym.
- Dziewięćdziesiąt sekund albo więcej autentycznego nakładania się głosów — dwie osoby mówiące naraz, ktoś kończący cudze zdanie, kaszlnięcie w trakcie decyzji. Crosstalk to miejsce, w którym diaryzacja po cichu się rozpada, a klip bez niego nie mierzy niczego.
- Dwadzieścia pięć lub więcej terminów dziedzinowych: kryptonimy produktów, wewnętrzne akronimy, nazwy klientów, imiona uczestników. To słowa o najwyższej gęstości znaczenia na znak w sali i o najniższej częstości w jakimkolwiek korpusie treningowym.
- Piętnaście lub więcej liczebników: daty, kwartały, kwoty, numery wersji, procenty. Część z nich wypowiedz celowo dwuznacznie („fifteen” i „fifty” w tej samej minucie).
- Trzy lub więcej zanegowanych decyzji, wypowiedzianych naturalnie: „nie wypuszczamy tego w tym wydaniu”, „wstrzymajmy się z umową”.
- Dwa równoległe nagrania, jeśli dasz radę je zorganizować — mikrofon samego laptopa i ścieżka nagłowna dla każdego mówcy. To projekt korpusu AMI, a pozwala on oddzielić „model jest słaby” od „w sali jest głośno”.
Nagraj to raz. Zapisz plik WAV bez kompresji, w 16 kHz albo lepiej. Każde narzędzie, które od tej pory ocenisz, dostaje ten sam identyczny plik — na zawsze.
Krok 2: napisz odniesienie, a potem zamroź reguły normalizacji, zanim cokolwiek policzysz
Transkrypcja referencyjna jest przyrządem pomiarowym i ma swoje słupki błędu. Artificial Analysis utrzymuje „oczyszczone” wersje swoich publicznych zbiorów ewaluacyjnych właśnie dlatego, że oryginalne transkrypcje referencyjne zawierały własne błędy zapisu; ich notka mówi o tym wprost — oczyszczone wersje „usuwają błędy transkrypcji z tekstu referencyjnego, zapewniając dokładniejszą prawdę odniesienia do oceny modeli”. Jeśli operator benchmarku musi poprawiać opublikowaną prawdę odniesienia, twoja transkrypcja z pierwszego podejścia też nie jest świętością.
Zatem: dwie osoby przepisują niezależnie, a potem uzgadniają każdą różnicę. Zaplanuj pięcio- do ośmiokrotności czasu rzeczywistego dla pary, co daje dla 12-minutowego klipu mniej więcej jeden dzień roboczy łącznego wysiłku. To największy pojedynczy koszt w całej tej procedurze i nie da się go obejść.
Następnie spisz swoją politykę normalizacji zanim policzysz choć jeden wynik, bo same te wybory przesuwają końcową liczbę o kilka punktów:
- Liczby: czy „Q3” to ten sam token co „Q three”? Czy „czterdzieści tysięcy” równa się „40 000”?
- Formy ściągnięte: czy „we're” pasuje do „we are”?
- Wypełniacze: czy „um”, „uh” i falstarty w ogóle są w odniesieniu i czy są punktowane?
- Wielkość liter i interpunkcja: zwykle usuwane przed punktacją — co oznacza, że narzędzie, które pięknie interpunkcjuje, nie dostaje tu za to żadnego kredytu, więc musisz ocenić to osobno w kroku 3.
Wynik zapisz w SegLST, formacie JSON używanym w wyzwaniach CHiME i domyślnym dla MeetEval: jeden obiekt na segment z polami session_id, words, speaker, start_time i end_time. To pola mówcy i czasu umożliwiają metryki świadome mówców, a doszywanie ich później to udręka.
Krok 3: oceń pięć wymiarów i daj surowemu WER dziesięć punktów na sto
Zainstaluj narzędzia — pip install jiwer meeteval — i oceń każdy wymiar na tym samym klipie. JiWER liczy WER razem z match error rate, word information lost, word information preserved i character error rate, korzystając z implementacji minimalnej odległości edycyjnej na RapidFuzz. MeetEval liczy metryki specyficzne dla spotkań.
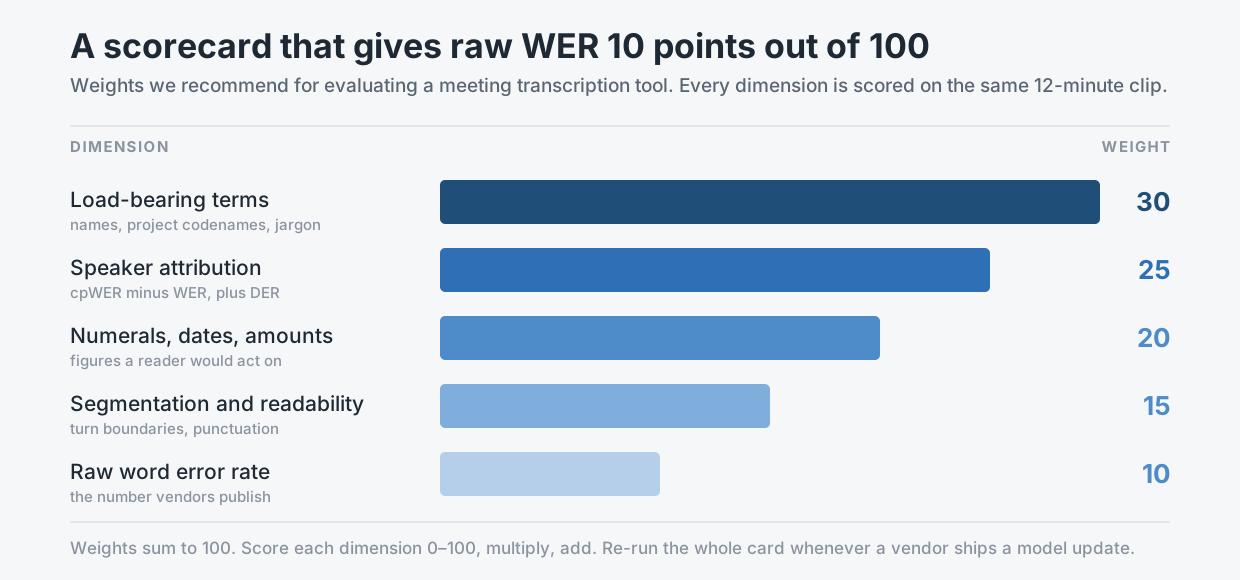
Nasze rekomendowane wagi. Wymiar, który reklamuje każdy dostawca, jest wart najmniej punktów.
Terminy nośne — 30 punktów. Zaznacz w odniesieniu każdą nazwę własną, każdy kryptonim i każdy element żargonu dziedzinowego. Potem policz ten sam wzór WER wyłącznie na tych tokenach. Wynik nazywamy wskaźnikiem błędu na terminach nośnych i jest to najbardziej predykcyjna pojedyncza liczba w całym ćwiczeniu. W parze transkrypcji z początku tego tekstu cztery tokeny nośne to Priya, Helios, Q3 i not. Transkrypcja A nie uszkadza żadnego z nich: 0,0%. Transkrypcja B uszkadza dwa: 50,0%. Ten sam ogólny WER równy 10,0% i pięćdziesiąt punktów rozrzutu na metryce, która ma znaczenie.
Przypisanie mówców — 25 punktów. Uruchom meeteval-wer cpwer -r ref.stm -h hyp.stm. Concatenated minimum-permutation WER znajduje najlepsze odwzorowanie między mówcami z odniesienia a mówcami z hipotezy, skleja słowa każdego mówcy i punktuje wynik — więc słowa przypisane niewłaściwej osobie stają się błędami. Potem odejmij: cpWER minus zwykły WER to luka przypisania, czyli ta część szkody, która bierze się wyłącznie z niewiedzy o tym, kto mówił. Dołóż diarization error rate dla widoku czasowego; DER to suma błędu mówcy, fałszywych alarmów mowy i mowy pominiętej, wyrażona jako procent punktowanego czasu, zdefiniowana w sekcji 6.1 planu ewaluacji NIST RT-09 i zaimplementowana w dscore, które MeetEval opakowuje i które czyta pliki RTTM. Jeśli twój kandydat obsługuje znaczniki czasu, użyj tcpwer --collar 5 zamiast cpwer, żeby poprawne słowo doczepione do złego momentu nie zostało po cichu wybaczone.
Liczebniki, daty i kwoty — 20 punktów. Wyciągnij z odniesienia każdy token liczbowy i oceń dokładność dopasowania dokładnego wobec hipotezy, po zastosowaniu spisanej polityki normalizacji. Podaj to jako zwykły ułamek — „13 z 15 poprawnych” — a nie jako procent, bo liczności są małe, a procent sugeruje precyzję, której nie masz.
Segmentacja i czytelność — 15 punktów. Ten wymiar jest ludzki. Poproś dwoje czytelników, którzy nie byli na spotkaniu, żeby przeczytali surowe wyjście i zaznaczyli, w przeliczeniu na minutę: granice zdań w złych miejscach, tury mówców zlane w jeden blok oraz akapity wymagające ponownego przeczytania. Interpunkcja została znormalizowana poza obliczenie WER, więc to jedyne miejsce, w którym w ogóle zostaje oceniona.
Surowy wskaźnik błędu słów — 10 punktów. Uruchom jiwer i zapisz liczbę. To uczciwe sprawdzenie podłogi: cokolwiek powyżej mniej więcej 12% na czystym dźwięku z bliskiego mikrofonu wskazuje na realny problem akustyczny wart zbadania. Powyżej tej podłogi metryka nie rozróżnia prawie niczego — i dokładnie dlatego jest warta dziesięć punktów, a nie osiemdziesiąt.
Oceń każdy wymiar w skali 0–100, przemnóż przez wagę, zsumuj. Wynik jest porównywalny między narzędziami i w czasie, o co w tym wszystkim chodzi.
Krok 4: puść każdego kandydata na identycznym pliku i zapisz, co znaczyło „identyczny”
To jest krok, który zespoły pomijają — i to on unieważnia wszystko, co powyżej.
Ten sam WAV, ta sama częstotliwość próbkowania, żadnego przekodowywania pomiędzy kandydatami. To samo odniesienie, ta sama polityka normalizacji zastosowana tym samym skryptem. Diaryzacja jawnie włączona albo jawnie wyłączona w każdym narzędziu i odnotowana w obu przypadkach — narzędzie ocenione z wyłączoną diaryzacją nie jest porównywalne z ocenionym przy włączonej. Biasowanie słowami kluczowymi lub encjami wyłączone w pierwszym przebiegu i włączone w drugim, oba odnotowane; Microsoft raportuje nawet 30-procentową redukcję WER po podaniu listy słów kluczowych do MAI-Transcribe-1.5, a to na tyle dużo, że porównanie mieszające przebiegi biasowane i niebiasowane traci sens.
Szczególnie pilnuj obsługi długiego dźwięku. Artificial Analysis musi ciąć swoje nagrania Earnings22 na kawałki po mniej więcej dziewięć minut dla modeli, które nie radzą sobie niezawodnie z pełną długością wejścia, i po mniej więcej 30 sekund dla modeli o ciaśniejszych limitach — ich własna opublikowana notka wymienia wśród dotkniętych systemów GPT-4o Mini Transcribe, Amazon Nova 2 Pro, NVIDIA Canary Qwen 2.5B oraz Qwen3 ASR Flash Alibaby. Cięcie zmienia wyniki, bo błędy skupiają się na granicach. Jeśli dostawca tnie twój plik, to jest własność produktu i należy do karty wyników, a nie artefakt do skorygowania.
Na koniec zapisz dokładny ciąg wersji modelu i datę każdego przebiegu. „Whisper large-v3” to nie jest wersja; whisper-large-v3, run 2026-08-31 — tak.
Krok 5: powtarzaj kartę, gdy dostawca coś wydaje, a nie gdy sobie przypomnisz
Hostowane modele mowy zmieniają się pod tobą. Nazwa endpointu zostaje ta sama, a wagi za nią — nie, i nikt nie wysyła ci maila, kiedy twoje notatki ze spotkań zaczynają nieco gorzej radzić sobie z nazwami własnymi.
Trzy wyzwalacze powinny uruchomić ponowne przejście całej karty, na tym samym klipie, który zbudowałeś w kroku 1:
- Dostawca publikuje wpis w changelogu, który dotyka modelu, diaryzatora albo warstwy interpunkcji i formatowania.
- Mija odstęp kalendarzowy — dla większości zespołów wystarczy kwartalnie, a miesięcznie, jeśli wyjście transkrypcji zasila cokolwiek zautomatyzowanego dalej w procesie.
- Twój wskaźnik błędu na terminach nośnych zmienia się o więcej niż 5 punktów między dowolnymi dwoma przebiegami — co powinno uruchomić dochodzenie, zanim uruchomi migrację.
Trzymaj każdy przebieg w jednej tabeli: data, ciąg wersji modelu, pięć ocen wymiarowych, ważona suma. Po trzech czy czterech przebiegach masz coś, czego nie da ci żaden ranking — szereg czasowy tego, jak konkretny produkt zachowuje się na dźwięku, który brzmi jak twoje prawdziwe spotkania.
Sedno sprawy: dokładność to pomiar twojej sali, a nie własność modelu
Wskaźnik błędu słów jest własnością modelu na korpusie. To, czego naprawdę potrzebujesz, to własność modelu na twoim dźwięku, dla twojego słownictwa, z twoimi ludźmi mówiącymi jedno przez drugie — a ta wielkość nie istnieje, dopóki jej nie zmierzysz. Nikt nie opublikuje jej za ciebie, bo nikt inny nie ma twoich kryptonimów w swojej transkrypcji referencyjnej.
Dobra wiadomość jest taka, że ten pomiar jest tani. Jedno 12-minutowe nagranie, jeden dzień roboczy starannej transkrypcji, dwie instalacje przez pip i karta wyników mieszcząca się na jednej stronie. Droga alternatywa to ta, którą większość zespołów wybiera domyślnie: decyzja na podstawie opublikowanego procentu i odkrycie różnicy pół roku później, w notatce mówiącej, że zespół zgodził się na coś, czego wyraźnie odmówił.
O co wolisz się pomylić — o miejsce po przecinku czy o decyzję?
Gdzie w tym wszystkim jest Telli.sh: budujemy dokładnie te warstwy, które ta karta wyników waży najmocniej. Telli.sh uruchamia rozdzielanie mówców, segmentację, dopracowanie i podsumowanie na wierzchu rozpoznawania mowy, z tłumaczeniem na 44 języki docelowe i interfejsem w 15 językach, bo te 90 punktów karty, które nie są surowym WER, to miejsce, w którym transkrypcja zmienia się w notatkę, z którą ktoś może coś zrobić. Jeśli chcesz prawdziwego punktu danych zamiast benchmarku, przepuść przez to własny 12-minutowy klip i oceń wynik powyższą procedurą.
Źródła
- MeetEval — zestaw narzędzi do ewaluacji transkrypcji spotkań — komendy cpWER, tcpWER, ORC-WER, MIMO-WER i DI-cpWER, format SegLST oraz rozpisany przykład
ErrorRate(errors=4, length=9, insertions=0, deletions=2, substitutions=2), pobrane 31 sierpnia 2026 roku - JiWER — pakiet do ewaluacji rozpoznawania mowy — WER, MER, WIL, WIP i CER przez minimalną odległość edycyjną RapidFuzz
- dscore — narzędzia do punktowania diaryzacji — DER jako błąd mówcy plus fałszywe alarmy mowy plus mowa pominięta, zgodnie z sekcją 6.1 planu ewaluacji NIST RT-09
- Ranking speech-to-text Artificial Analysis — metodologia AA-WER v2 (~8 godzin z AA-AgentTalk 50%, VoxPopuli-Cleaned-AA 25%, Earnings22-Cleaned-AA 25%), wyniki pięciu najlepszych modeli, notka o oczyszczonych odniesieniach i notka o cięciu Earnings22, wszystko pobrane 31 sierpnia 2026 roku
- CHiME-6 Challenge: Tackling Multispeaker Speech Recognition for Unsegmented Recordings (arXiv:2004.09249), 20 kwietnia 2020 — ścieżki segmentowana i niesegmentowana dla wielu mówców oraz projekt nagrań z kolacji
- The AMI Meeting Corpus — 100 godzin nagrań ze spotkań zarejestrowanych zsynchronizowanymi mikrofonami nagłownymi i dalekiego pola
- MAI-Transcribe w Azure Speech — Microsoft Learn — biasowanie słowami kluczowymi i udokumentowane ograniczenia
- Nasz wcześniejszy tekst o tym, dlaczego dokładność transkrypcji nigdy nie była produktem końcowym