Anthropic znakuje teksty Claude'a — a 1922 sprawy sądowe pokazują, czego to nie naprawi
Jak znak wodny Claude'a wskazuje prawdopodobny udział modelu, ale nie potwierdza prawdziwości tekstu: ograniczenia wykrywania, fałszywe oskarżenia i 1922 odnotowane przypadki halucynacji pokazują różnicę między pochodzeniem a prawdą.
14 sierpnia 2026 roku Anthropic wyjaśnił, jak znakowanie tekstu będzie działać w przyszłych modelach Claude. FAQ łączy wdrożenie z wymogami przejrzystości unijnego aktu o AI, które zaczęły obowiązywać 2 sierpnia. Modele udostępnione wcześniej będą aktualizowane w okresie przejściowym; ogłoszenie nie oznacza, że każda odpowiedź Claude'a jest już oznaczona.
Przydatny pomysł polega na zakodowaniu sygnału w wyborach słów dokonywanych przez model. W odpowiednich warunkach może on pomóc rozpoznać udział modelu, nie zmieniając wyglądu tekstu dla czytelnika.
To rozróżnienie ma znaczenie, gdy tekst wygenerowany przez model zawiera zmyślone dowody. Omawiana niżej migawka publicznej bazy odnotowała 1922 sprawy sądowe dotyczące treści zawierających halucynacje AI. Nie są to testy wykrywania znaku wodnego i nie dowodzą, czy jakikolwiek konkretny detektor rozpoznałby dany tekst. Pokazują inny problem: oznaczenie pochodzenia nie potwierdza, że cytowana sprawa, badanie lub fakt istnieją. Zrozumienie tej luki pomaga używać wyniku wykrywania sensownie i utrudnia jego nadużywanie.
W skrócie:
- Do tekstu nic nie jest dodawane. Tajny klucz zmienia losowość wyboru słów, a nie widoczny format. Anthropic planuje globalne wdrożenie, stopniowo obejmujące starsze modele.
- Trafienie to słaby dowód, a brak trafienia prawie żaden. Sam Anthropic pisze, że znak nie odróżnia "Claude to napisał" od "Claude to mocno przeredagował", jest słaby przy krótkich tekstach, kodzie i czysto faktograficznych fragmentach, a przepisanie go kasuje. W 2024 roku badacze pokazali, że za mniej niż 50 dolarów można takie znaki zarówno usunąć, jak i podrobić na tekście napisanym przez człowieka.
- Pochodzenie to nie weryfikacja. Wynik może wskazywać na prawdopodobny udział modelu, ale nie potwierdza istnienia wymienionej w tekście sprawy, cytowania ani książki.
Zdjęcie: Jon Rawlinson, Wikimedia Commons, CC BY 2.0. Strona pełna znaków autentyczności. Każdy dowodzi, że przekroczono granicę. Żaden nie mówi ani słowa o tym, czy podróżny mówił prawdę.
Co Anthropic naprawdę zmienił, a czego nie
Zacznijmy od mechanizmu, bo niemal każde późniejsze nieporozumienie bierze się z pomyłki właśnie tutaj.
Kiedy model językowy pisze, wypuszcza po jednym słowie, a w większości miejsc nie ma jednego poprawnego wyboru. "Spotkanie było produktywne" i "Spotkanie było przydatne" są równie dobre. Model trzyma listę dopuszczalnych następnych słów i wybiera jedno losowaniem. Dlatego to samo polecenie dwa razy daje nieco inne odpowiedzi.
Znak wodny w tekście zastępuje to losowanie pseudolosowaniem sterowanym tajnym kluczem. Model nadal wybiera wyłącznie spośród słów, które sam uznał za równie dobre, więc jakość pozostaje nietknięta. Ale na przestrzeni kilkuset słów wzór tego, które dopuszczalne słowo wygrywało za każdym razem, przestaje wyglądać na przypadek, a kto ma klucz, może go zmierzyć.
Nie ma ukrytych znaków ani usuwalnych metadanych tekstowych. Sygnał wynika z doboru słów, a Anthropic podaje, że nie dodaje tokenów i ma znikomy wpływ na szybkość. Polityka wdrażania jest globalna, a nie regionalna, ale objęcie modeli zależy od przebiegu wdrożenia. Sama polityka nie dowodzi, że konkretna odpowiedź ma znak wodny.
Nic z tego nie jest nową nauką. Scott Aaronson zaproponował to podejście w 2022 roku, Kirchenbauer i współpracownicy opublikowali działający schemat na ICML w 2023, a Google DeepMind opublikował SynthID-Text w Nature w październiku 2024 — wdrożenie Anthropic jest jego odmianą. Google prowadzi to w Gemini od 2024 roku, raportując około 20 milionów rzeczywistych odpowiedzi bez wykrywalnej różnicy w jakości, i deklaruje od tamtej pory ponad 10 miliardów oznaczonych treści.
Aktualizacja, 12 października 2026 r.: w aktualizacji FAQ z 1 września Anthropic opisuje API do wykrywania dostępne w prywatnym podglądzie dla kwalifikujących się organizacji; szerszy dostęp jest planowany. Zastępuje to status „wkrótce” z pierwotnego sierpniowego tekstu. Znak wodny szacuje udział Claude'a, ale nie sprawdza prawdziwości tekstu.
Znak przetrwa kopiuj-wklej. Nie przetrwa przepisania.
Sygnał żyje w tym, które słowa zostały wybrane. Wszystko, co zachowuje te wybory, zachowuje więc znak, a wszystko, co je zastępuje, znak niszczy. Anthropic stawia granicę bez ogródek: "całkowite przepisanie, w którym każde słowo zostaje zastąpione" go usunie. Dwa przypadki łamią ten schemat w sposób, który wielu zaskakuje.
Tekst krótki i faktograficzny prawie nic nie unosi. Znak wodny potrzebuje wyborów, w których może się ukryć. Jedno czy dwa zdania nie dają dość decyzji, by powstał wzór, a treść mocno faktograficzna może nie dawać żadnego realnego wyboru — przykład Anthropic jest wymowny: po "Principia Newtona" następnym słowem będzie "Mathematica", i żaden klucz nie ma tu głosu. Ta sama logika osłabia kod, gdzie składnia narzuca większość tokenów, oraz korektę, przy której model zmienia zbyt mało słów, by zostawić sygnał.
Tłumaczenie niesie pełny znak wodny. To idzie wbrew intuicji. Poproś Claude'a o przetłumaczenie dokumentu na japoński, a ten japoński tekst jest na nowo wygenerowany przez Claude'a, słowo po słowie, ze zwykłą swobodą wyboru — wychodzi więc w pełni oznaczony, choć myśli pochodziły z nieoznaczonego ludzkiego oryginału. To odwrotność tego, co badacze DeepMind opisują w Nature, gdzie przetłumaczenie oznaczonego tekstu na inny język mocno obniża pewność wykrycia. Oba twierdzenia są prawdziwe, bo to różne scenariusze: przetłumaczenie oznaczonego tekstu gdzie indziej wypłukuje znak, a kazanie tłumaczyć samemu modelowi odciska nowy.
| Co robisz z tekstem | Czy znak przetrwa? |
|---|---|
| Skopiowanie i wklejenie gdziekolwiek | Tak — nie ma tam nic osadzonego, co wklejenie mogłoby zdjąć |
| Lekka redakcja: literówki, nagłówki, skróty | Tak — większość wyborów słów pozostaje nietknięta |
| Poproszenie modelu o tłumaczenie | Tak — tłumaczenie powstaje na nowo, więc jest w pełni oznaczone |
| Głęboka parafraza własnymi słowami | Nie — zastępujesz właśnie te wybory, które niosły sygnał |
| Całkowite przepisanie, każde słowo zmienione | Nie — Anthropic podaje, że to go usuwa |
| Krótki fragment, jedno czy dwa zdania | Słabo albo wcale — za mało wyborów, by powstał wzór |
| Kod albo czysto faktograficzne fragmenty | Słabo — składnia i fakty nie zostawiają modelowi swobody |
| Korekta twojego szkicu przez model | Słabo albo wcale — zmienia się zbyt mało słów |
Zachowanie zgodnie z opisem Anthropic w FAQ z 14 sierpnia 2026 roku oraz autorów SynthID-Text w Nature, październik 2024.
Trafienie to słaby dowód. Brak trafienia prawie żaden.
Jeśli detektor zwróci wynik, jaki wniosek można z niego rozsądnie wyciągnąć?
Jeśli wynik jest pozytywny: że część tego tekstu przeszła przez model tego dostawcy. Tyle. Anthropic wprost stwierdza, że znak nie odróżnia "Claude to napisał" od "Claude to mocno przeredagował", nic nie mówi o prawdziwości żadnego twierdzenia w środku i nie rozpoznaje tekstu innej AI, bo zna tylko własny klucz.
Jeśli wynik jest negatywny, nie dowiedział się prawie niczego. Czysty odczyt to dokładnie to samo, co dostaniesz z głębokiej parafrazy, krótkiego fragmentu, bloku kodu, modelu konkurencji albo modelu o otwartych wagach działającego na czyimś laptopie zupełnie bez znakowania.
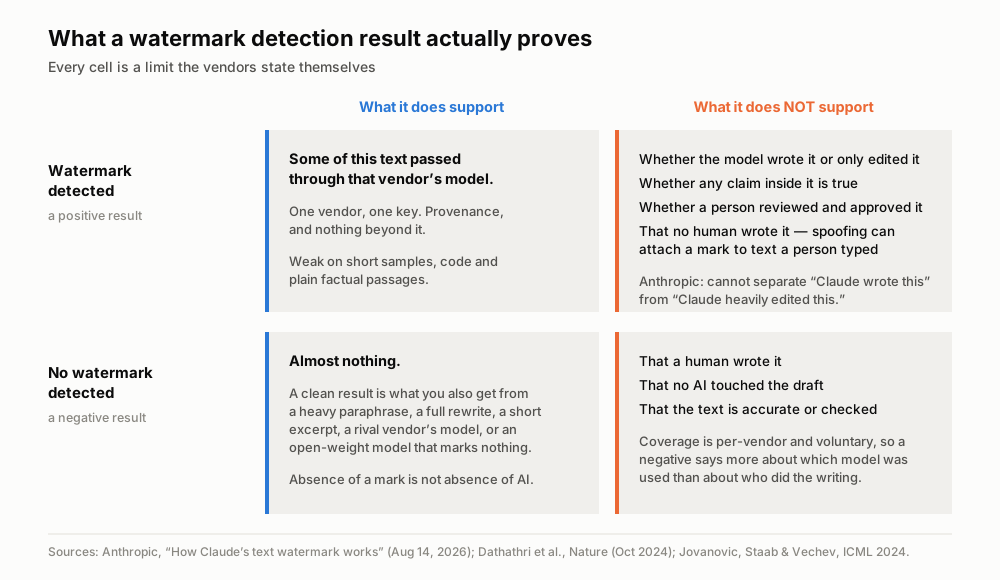
Każda komórka opisuje ograniczenie opublikowane przez samych dostawców. Źródła: FAQ Anthropic o znaku wodnym (14 sierpnia 2026 r., aktualizacja 1 września); Dathathri i in., Nature (październik 2024); Jovanović, Staab i Vechev, ICML 2024.
Atak, na który nikt nie planuje budżetu, biegnie w drugą stronę
Usuwanie to ryzyko, które wyobraża sobie każdy: ktoś pierze tekst AI, żeby ukryć pochodzenie. Zgoda. Ale istnieje drugi atak ze strzałką w odwrotną stronę i to on powinien niepokoić.
Podszywanie polega na sprawieniu, by tekst napisany przez człowieka niósł cudzy znak wodny. Nikt niczego nie ukrywa, tylko podrzuca. Celem jest osoba, która zostanie potem oskarżona o użycie AI, albo dostawca obwiniony o treści, których nigdy nie wyprodukował.
Na ICML w 2024 roku Jovanović, Staab i Vechev pokazali oba ataki przeciwko najnowocześniejszym schematom ze skutecznością powyżej 80% i za mniej niż 50 dolarów mocy obliczeniowej. Autorzy z DeepMind przyznają to samo we własnym artykule w Nature: znaki wodne "nie oferują pełnego rozwiązania", do samego istnienia wymagają współpracy dostawcy modelu, są niewyegzekwowalne wobec modeli o otwartych wagach, które każdy może uruchomić bez zmian, i są "podatne na ataki kradzieży, podszywania i usuwania". To ostatnie zdanie to cały argument, spisany przez zespół, który tę technologię zbudował.
Wczesne detektory AI oskarżały niewłaściwych studentów
Narzędzia wykrywające już istnieją i są inną technologią z udokumentowaną historią szkód. Znak wodny umieszcza właściciel modelu w chwili generowania, za pomocą klucza. Klasyfikator zgaduje po fakcie, na podstawie cech samego tekstu: jak przewidywalne są wybory słów, jak zróżnicowane jest słownictwo. Pierwszy coś wie. Drugi dopasowuje wzorce stylu. To różnica między mierzeniem a profilowaniem.
OpenAI uruchomiło AI Text Classifier 31 stycznia 2023 roku i wyłączyło go 20 lipca tego samego roku "z powodu niskiej trafności". Własne liczby: wychwycił 26% tekstu AI i błędnie oznaczył 9% tekstu ludzkiego.
Potem Liang ze współpracownikami opublikowali w Patterns w lipcu 2023 roku wynik, który powinien był zamknąć całą kategorię. Na siedmiu detektorach zastosowanych do esejów TOEFL pisanych przez osoby, dla których angielski nie jest językiem ojczystym, średni odsetek fałszywych trafień wyniósł 61,3%; jeden detektor oznaczył 97,8% z nich. Gdy poproszono o przeredagowanie tych samych esejów z bogatszym słownictwem, odsetek spadł do 11,6%. Detektory nigdy nie mierzyły autorstwa: mierzyły płynność i karały każdego, kto pisał prostszą angielszczyzną.
16 sierpnia 2023 roku Uniwersytet Vanderbilta wyłączył detektor AI w Turnitin. W uzasadnieniu przedstawił hipotetyczne wyliczenie: zastosowanie deklarowanego 1% fałszywych trafień do około 75 000 składanych prac mogłoby błędnie oznaczyć mniej więcej 750 prac. To szacunek ryzyka, a nie liczba studentów faktycznie oskarżonych. Ogłoszenie Uniwersytetu Vanderbilta.
Wykrywanie znaku wodnego sprawdza określony wzorzec generowania, zamiast wnioskować o autorstwie ze stylu tekstu. Wynik nadal ma charakter probabilistyczny, a krótkie lub mocno przeredagowane fragmenty mogą nie dać rozstrzygającej odpowiedzi. Wynik dotyczący udziału modelu nie powinien stawać się oskarżeniem konkretnej osoby; badania nad fałszowaniem pokazują też, dlaczego samo wykrywanie nie dowodzi autorstwa.
Regulacje przyszły przed narzędziami
To wszystko kumuluje się w dwa tygodnie, bo ustawodawcy ruszyli pierwsi.
Unijny akt o AI dzieli obowiązek na dwie części. Artykuł 50 ust. 2 wiąże dostawców: kto buduje system generatywny, musi oznaczać jego wyniki w formie czytelnej maszynowo, łącznie z tekstem. Artykuł 50 ust. 4 wiąże ciebie: podmiot stosujący, który publikuje tekst wygenerowany przez AI "informujący opinię publiczną o sprawach leżących w interesie publicznym", musi to ujawnić.
A ten drugi przepis niesie wyłączenie, które dla większości czytelników jest praktycznym sercem całego reżimu. Obowiązek nie ma zastosowania, gdy treść przeszła weryfikację przez człowieka lub kontrolę redakcyjną i istnieje osoba ponosząca za nią odpowiedzialność redakcyjną. Przeczytaj to dwa razy. Europejska odpowiedź na tekst generowany przez AI to nie detektor. To wskazany z nazwiska człowiek, który to przejrzał i za to odpowiada.
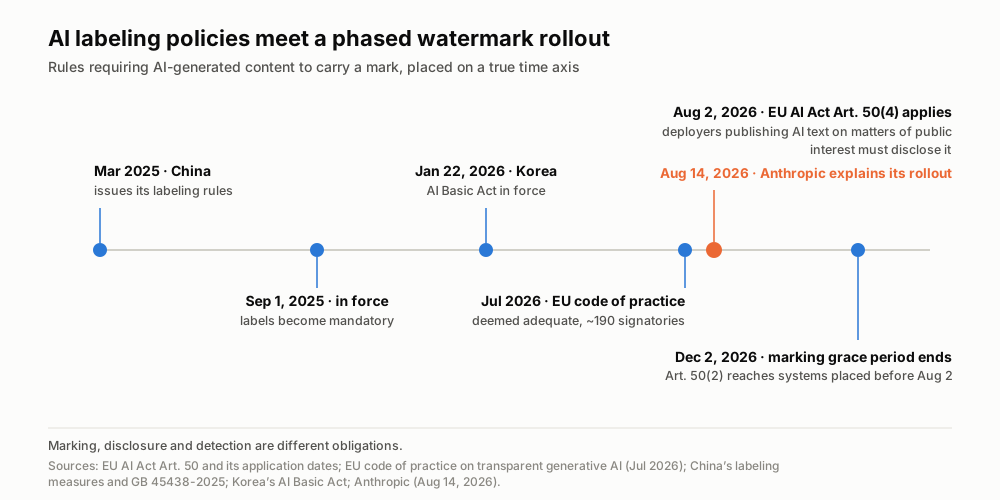
Obowiązki oznaczania przyszły zgodnie z harmonogramem, użyteczne wykrywanie nie. Źródła: unijny akt o AI i daty jego stosowania, europejski kodeks postępowania w sprawie przejrzystości (lipiec 2026), chińskie przepisy o oznaczaniu i norma GB 45438-2025, koreańska ustawa ramowa o AI oraz ogłoszenie Anthropic.
Komisja opisuje kodeks przejrzystości jako dobrowolne ramy zgodności, a nie zamiennik prawa; do końca lipca 2026 roku podpisało go około 190 organizacji. FAQ Komisji przewiduje okres przejściowy do 2 grudnia 2026 roku dla systemów wprowadzonych na rynek przed 2 sierpnia. To ważne rozróżnienie: harmonogram wdrożenia u sygnatariusza i obowiązek prawny to nie to samo. Przegląd Komisji, FAQ Komisji.
Inne jurysdykcje stosują inne zasady. Chińskie przepisy o oznaczaniu weszły w życie 1 września 2025 roku i przewidują widoczne oraz osadzone oznaczenia zgodnie z normą GB 45438-2025. Koreańska ustawa ramowa o AI weszła w życie 22 stycznia 2026 roku. Przy ocenie zgodności trzeba uwzględnić właściwą jurysdykcję i rodzaj treści, a nie zakładać istnienia jednej rzekomo globalnej zasady oznaczania.
Tu miejsce na jeszcze jedną nieobecność. Wall Street Journal doniósł w 2024 roku, że OpenAI zbudowało metodę znakowania tekstu opisywaną wewnętrznie jako trafną w około 99,9%. Traktuj to jako doniesienie, nie fakt: liczba nigdy nie została niezależnie zweryfikowana, a OpenAI nigdy nie wdrożyło znakowania tekstu. Jego własny wpis z 11 czerwca 2026 roku o zgodności z przepisami UE dokumentuje wyłącznie pochodzenie obrazów i przyznaje ogólne ograniczenie własnymi słowami: "metadane można usunąć, znaki wodne mogą ulegać degradacji".
Znak wodny nie potwierdza prawdziwości zmyślonego cytowania
Damien Charlotin prowadzi publiczną bazę orzeczeń sądowych z całego świata, w których sąd musiał zająć się treścią wygenerowaną przez AI zawierającą halucynacje. Pobrana 16 sierpnia 2026 roku wskazywała 1922 orzeczenia. Przebieg: około 200 w połowie 2025 roku, 719 w styczniu 2026, 1227 w kwietniu, 1598 na 9 czerwca i 1922 dzisiaj — 324 dołożone w samych ostatnich dziesięciu tygodniach.
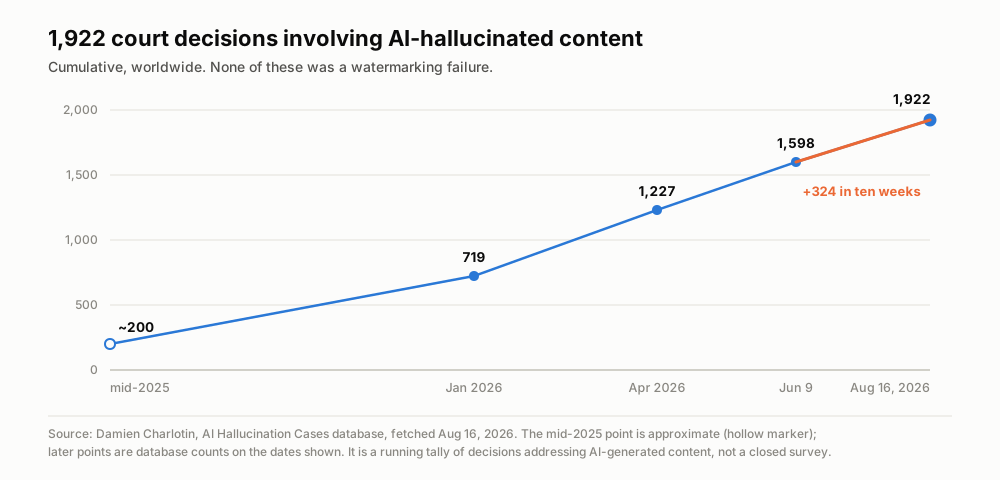
Te przypadki dokumentują halucynacje, a nie wyniki testów znaku wodnego. Oznaczenie pochodzenia nie potwierdza prawdziwości twierdzeń. Źródło: baza spraw halucynacji AI Damiena Charlotina, pobrana 16 sierpnia 2026 r.
Archetypem jest Mata v. Avianca, rozstrzygnięta w Południowym Dystrykcie Nowego Jorku 22 czerwca 2023 roku: pismo procesowe powołujące sześć nieistniejących orzeczeń i kara 5000 dolarów.
Najbardziej wymowny przykład dotyczy Anthropic. W maju 2025 roku w sprawie Concord Music v. Anthropic prawnicy firmy złożyli opinię biegłego z przypisem do badania zmyślonego przez Claude'a. Ręczna kontrola tego nie wykryła, a pełnomocnik przeprosił sąd. Firma wydająca znak wodny w tekście sama doświadczyła skutków bezkrytycznego cytowania wyniku własnego modelu we własnej sprawie, sprawdzonego przez własnych prawników. Nawet pozytywny wynik wykrywania nie dowiódłby, że cytowane badanie istnieje.
To wykracza poza sądy. Deloitte Australia zgodziło się w październiku 2025 roku częściowo zwrócić wynagrodzenie za rządowy raport wart 440 000 dolarów australijskich, zawierający nieistniejące odnośniki i zmyślony cytat z wyroku. 18 maja 2025 roku Chicago Sun-Times i Philadelphia Inquirer opublikowały rozsyłaną w syndykacie listę lektur na lato, w której z piętnastu książek istniało pięć. Liang ze współpracownikami, analizując 950 965 artykułów w arXiv:2404.01268, znaleźli treści zmodyfikowane przez LLM sięgające 17,5% abstraktów z informatyki wobec 6,3% lub mniej w matematyce i w portfolio Nature.
Kwestia skali też zasługuje na liczbę uczciwą, a nie alarmującą. Analiza Common Crawl wykonana przez Graphite i opublikowana w październiku 2025 roku wykazała, że około 51,7% badanych nowych artykułów było napisanych przez AI w maju 2025 roku — a Axios, relacjonując to, dodał istotne zastrzeżenie: udział ten wypłaszczył się blisko połowy, zamiast dalej rosnąć. To nie potop. To nowa normalność.
I tu sedno. Nic na tej liście nie jest porażką znaku wodnego. W każdej z tych spraw pochodzenie nigdy nie było sporne: wszyscy wiedzieli, że w grę wchodził model, albo przyjęliby to od razu. Zawiodło to, że nikt nie otworzył przypisu i nie sprawdził, czy ta sprawa, to badanie, ta książka istnieją.
Konkluzja: pochodzenie to nie weryfikacja
Nazwijmy to błędem stempla pocztowego. Stempel dowodzi, który urząd obsłużył list. Nigdy nie miał zdania o tym, czy list mówi prawdę. Właśnie włożyliśmy sporo inżynierii w zbudowanie bardzo dobrego stempla, a część debaty publicznej zaraz weźmie go za weryfikatora faktów.
Warto jednocześnie pamiętać o trzech kwestiach. Wynik pozytywny wskazuje na prawdopodobny udział modelu, ale nie dowodzi autorstwa ani prawdziwości tekstu. Wynik negatywny nie dowodzi, że tekst napisał człowiek. Zasięg zależy od dostawcy, jego klucza i modeli używających jego znaku wodnego; nie jest uniwersalny. Zaktualizowane API Anthropic pozostaje w prywatnym podglądzie dla kwalifikujących się organizacji, a nie w powszechnym dostępie.
To, co naprawdę wytrzymuje kontrolę, to nie znak na wyniku, lecz zapis, który da się wyprowadzić od źródła: nagranie, które wciąż istnieje, transkrypcja ze znacznikami czasu, do której można wrócić w konkretnym momencie, zdanie przypisane osobie, która je rzeczywiście wypowiedziała, twierdzenie prowadzące do dokumentu źródłowego, który można otworzyć. Pisaliśmy już o tym przy tłumaczeniu na żywo, gdzie sprawdzalna notatka waży więcej niż płynny wynik i przy transkrypcji przesłuchań policyjnych, gdzie zapis musi się obronić, gdy ktoś go podważa. Epoka znaków wodnych nie zmienia tego argumentu, lecz go zaostrza: gdy znakowanie stanie się powszechne, zdanie "brała w tym udział AI" przestanie cokolwiek rozróżniać.
Znaki wodne odpowiadają na pytanie, skąd wziął się tekst. Tego, co odpowiada, czy jest prawdziwy, nikt jeszcze nie zbudował, bo to nie jest detektor. To źródło, do którego można wrócić.
Gdzie w tym Telli.sh: budujemy właśnie to źródło, do którego można wrócić. Telli.sh nagrywa spotkanie, tworzy transkrypcję ze znacznikami czasu i przypisanymi mówcami, a podsumowanie trzyma zakotwiczone w nagraniu, z którego powstało — dzięki czemu każdą linijkę notatek da się po miesiącach prześledzić do sekundy, w której ktoś to powiedział. To nie jest obietnica wykrywania AI. To druga połowa problemu: gdy podsumowanie coś twierdzi, możesz to sprawdzić w nagraniu, zamiast wierzyć zdaniu.
Źródła
- Anthropic, "How Claude's text watermark works" (sierpień 2026)
- Dathathri et al., "Scalable watermarking for identifying large language model outputs," Nature (październik 2024)
- Kirchenbauer et al., "A Watermark for Large Language Models," ICML 2023
- Jovanović, Staab & Vechev, "Watermark Stealing in Large Language Models," ICML 2024
- Liang et al., "GPT detectors are biased against non-native English writers," Patterns (lipiec 2023)
- Liang et al., "Mapping the Increasing Use of LLMs in Scientific Papers," arXiv:2404.01268
- Damien Charlotin, baza spraw halucynacji AI
- Komisja Europejska, artykuł 50 aktu o AI: obowiązki w zakresie przejrzystości
- Strona zdjęcia w Wikimedia Commons
