Jev wybiera zamiast rozmawiać: trzy demonstracje i ich ograniczenia
Czym naprawdę zajmuje się Jev od TypeSafe: GIF i odtwarzalna demonstracja Browser Use, przypadek 1 500 e-maili z X oraz oficjalne prezentacje gier. Dowiedz się, gdzie pomagają decyzje o określonych typach, gdzie zawodzą i jak ocenić rzeczywisty proces pracy.
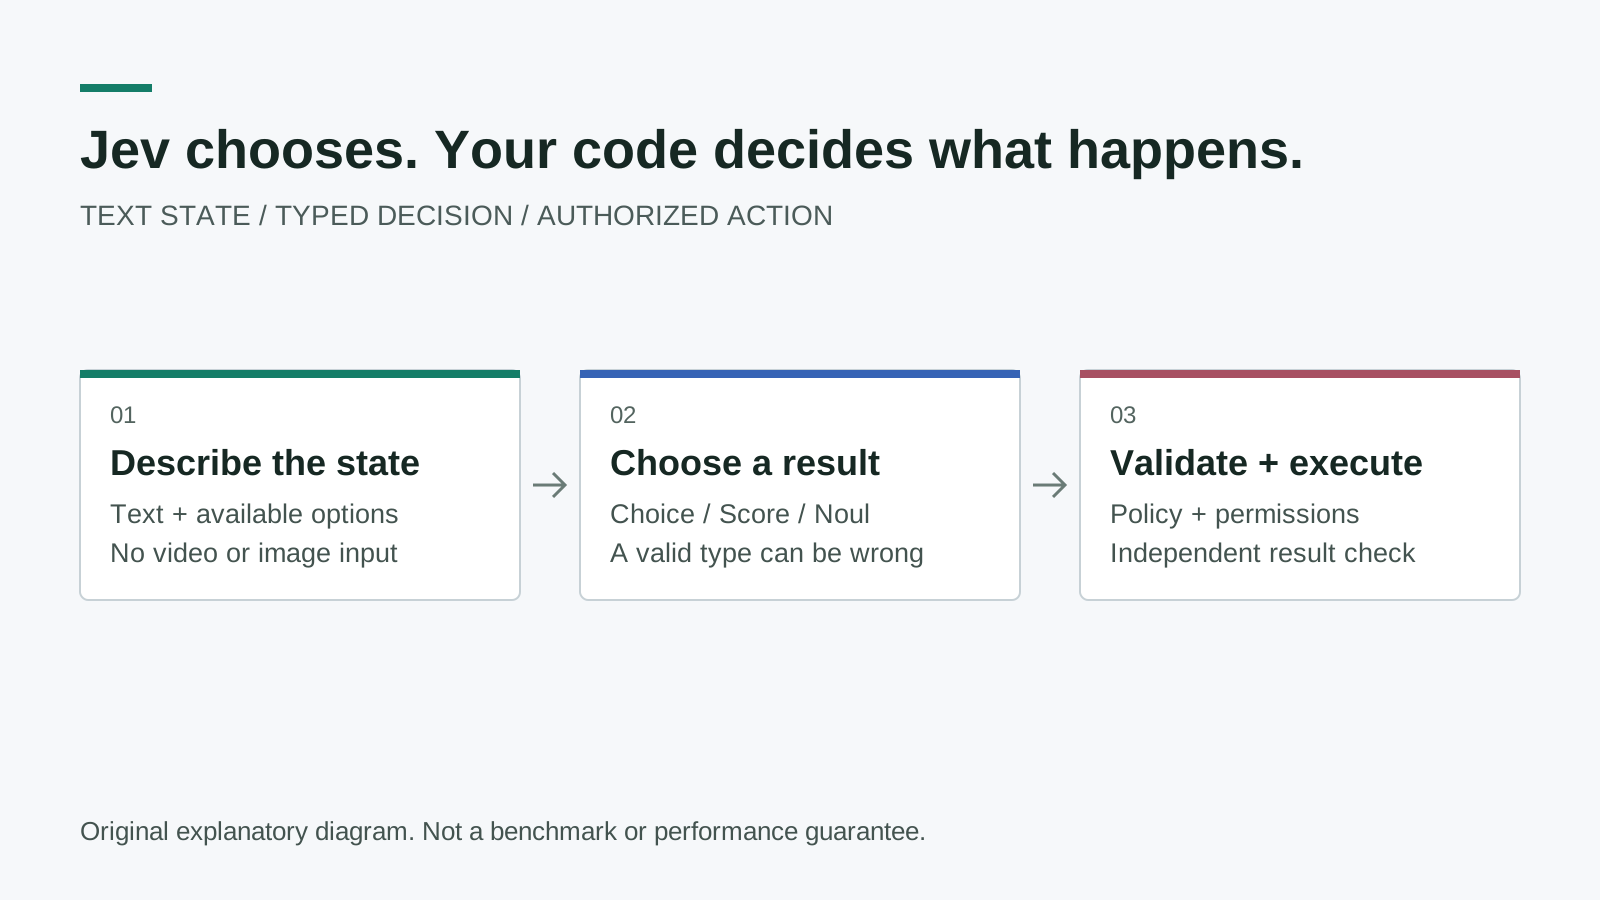
Oryginalny diagram objaśniający, nie benchmark dostawcy. Model wybiera z określonego zbioru; za uprawnienia, weryfikację i wykonanie nadal odpowiada kod aplikacji.
Klasyfikator skrzynki odbiorczej nie musi najpierw napisać eseju, by wybrać folder. Kontroler przeglądarki często musi wybrać jeden dostępny przycisk, a nie wymyślić nowe polecenie. To właśnie w takich niewielkich decyzjach Jev, pierwszy model TypeSafe AI z rodziny System One, prezentuje się najciekawiej.
TypeSafe przedstawiło Jev 15 września 2026 r. Istotna różnica nie polega po prostu na tym, że jest to kolejny szybki model: Jev zwraca ograniczone decyzje zamiast swobodnego tekstu. Zmienia to sposób budowania otaczającego programu, ale nie usuwa ryzyka błędnego wyboru. Perspektywę dostawcy przedstawia oficjalny komunikat o premierze.
Ten przewodnik omawia trzy publiczne demonstracje: zadanie w przeglądarce z pobieralnymi materiałami GIF i wideo, relację autora o klasyfikacji 1 500 e-maili oraz prezentacje gier TypeSafe. Przekształcamy też te przykłady w konkretny plan oceny. Artykuł o zastosowaniach na Tistory, opublikowany 18 września, był punktem wyjścia do badań; opisane w nim propozycje nie są tu przedstawiane jako niezależnie zweryfikowane wdrożenia u klientów.
W skrócie:
- Jev potrafi wybrać opcję, ocenić ją lub sprawdzić twierdzenie na podstawie tekstu; nie zastępuje modelu generującego dowolny tekst.
- Wynik o poprawnej strukturze nadal może być błędny semantycznie. Weryfikację i ostateczne uprawnienie pozostaw kodowi.
- Nagranie działania przeglądarki jest prawdziwe, ale pojedyncze zadanie nie jest ogólnym benchmarkiem. Przykład e-maili to relacja autora, a nie opublikowane badanie dokładności.
- Zacznij od odwracalnej klasyfikacji, mierz błędy na własnych danych i dopuść możliwość wstrzymania się od odpowiedzi.
Krótka odpowiedź wymaga bardzo precyzyjnego pytania
Trzy podstawowe prymitywy API to Choice, Score i Noul. Choice wybiera spośród nazwanych opcji. Score ocenia zgodność z uporządkowanymi, opisanymi poziomami. Noul zwraca prawdopodobieństwo dla twierdzenia typu tak/nie; wartość bliska środkowi oznacza niepewność co do tego twierdzenia, a nie średni poziom powagi. Kontrakty te opisuje dokumentacja prymitywów.
Praktyczna zmiana polega na określeniu możliwych wyników, zanim poprosisz model o decyzję. Zamiast żądać akapitu o nowej wiadomości do pomocy technicznej, możesz zapytać, czy dotyczy płatności, dostępu do konta, wady produktu czy nierozstrzygniętej kategorii. Aplikacja zdecyduje wtedy, którą kolejkę wyświetlić. To zwrotnica na torach, a nie cały pociąg: pomaga kierować pracą, ale nie zapewnia wszystkich możliwości potrzebnych do jej ukończenia.
| Prymityw | Przydatne pytanie | Odpowiedzialność aplikacji |
|---|---|---|
| Choice | Która z tych kolejek najlepiej pasuje do tej wiadomości? | Zdefiniować pełny zestaw opcji, w tym ścieżkę weryfikacji |
| Score | Jak dobrze wiadomość pasuje do opisanych poziomów pilności? | Określić poziomy i sprawdzić zgodność oceniających |
| Noul | Czy nadawca wyraźnie prosi o anulowanie? | Ustalić, jakie prawdopodobieństwo uzasadnia weryfikację lub odwracalne działanie |
Tworzenie dobrych opcji jest częścią pracy inżynierskiej. Jeśli dwie etykiety się pokrywają, pozornie pewny wybór może ukrywać problem w taksonomii. Jeśli żadna nie pasuje, wymuszony wybór maskuje brak kategorii jako pewność. Opcja weryfikacji bywa cenniejsza niż kolejna wąsko nazwana kategoria, bo pokazuje, gdzie należy ulepszyć kontrakt decyzyjny.
Według stanu na 30 września 2026 r. karta modeli wymienia jev-1.13.0, wejście wyłącznie tekstowe i cenę $0.042 za milion tokenów wejściowych; tokeny wyjściowe są bezpłatne. To cena tokenów modelu, a nie całkowity koszt uruchomienia agenta. W budżecie operacyjnym trzeba uwzględnić także przeglądarki, ekstrakcję, modele pomocnicze, ponowienia i weryfikację przez człowieka.
GIF z przeglądarki pokazuje rzeczywiste wyszukiwanie, a nie rezerwację lotu
Publiczne repozytorium jev-ultrafast Browser Use zawiera nagranie wyszukiwania lotu z Zurychu do Londynu w Google Flights. Jev wybiera operację i element docelowy na podstawie bieżącego obrazu strony. Gdy wybrana operacja wymaga wpisania tekstu, dostarcza go osobny model generatywny. To złożony system, a nie dowód, że sama Jev generuje każdy tekst lub interpretuje klatki wideo.
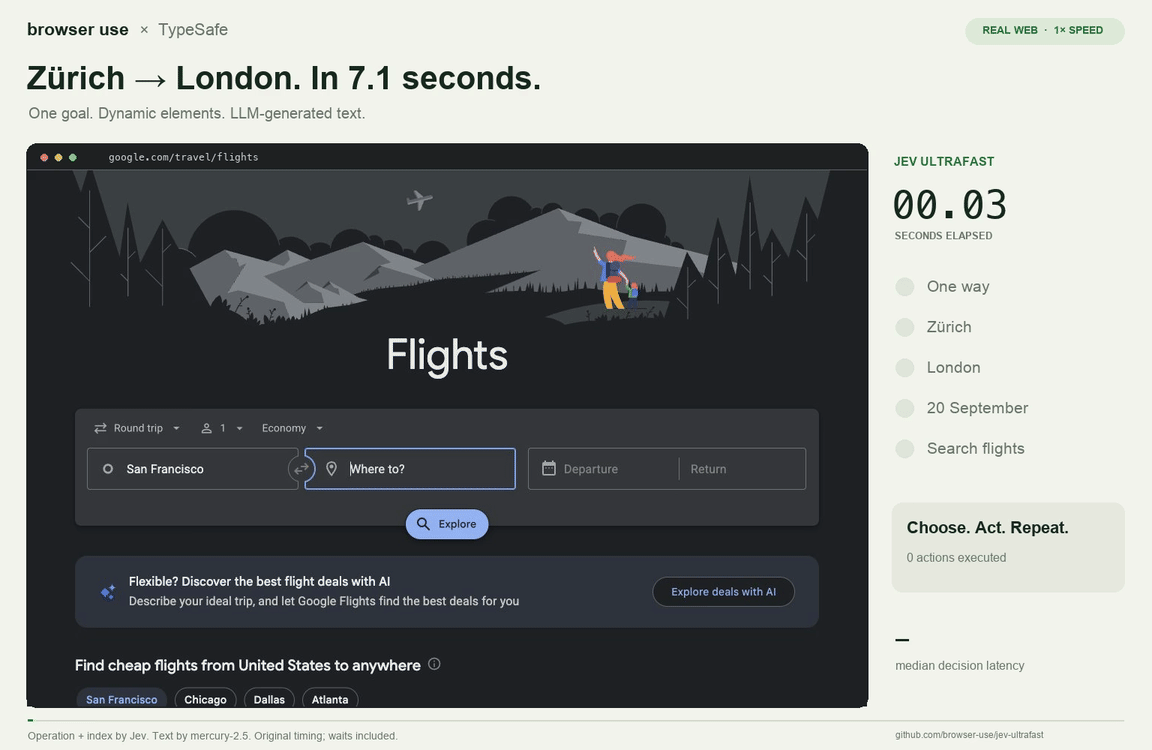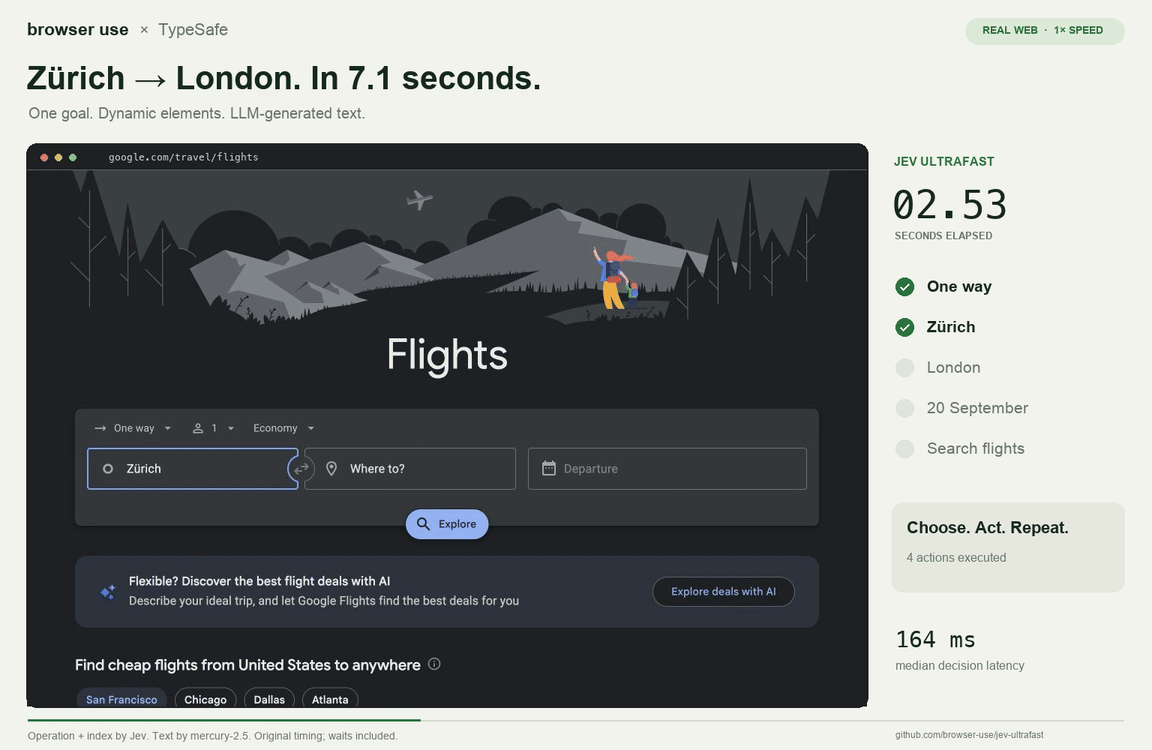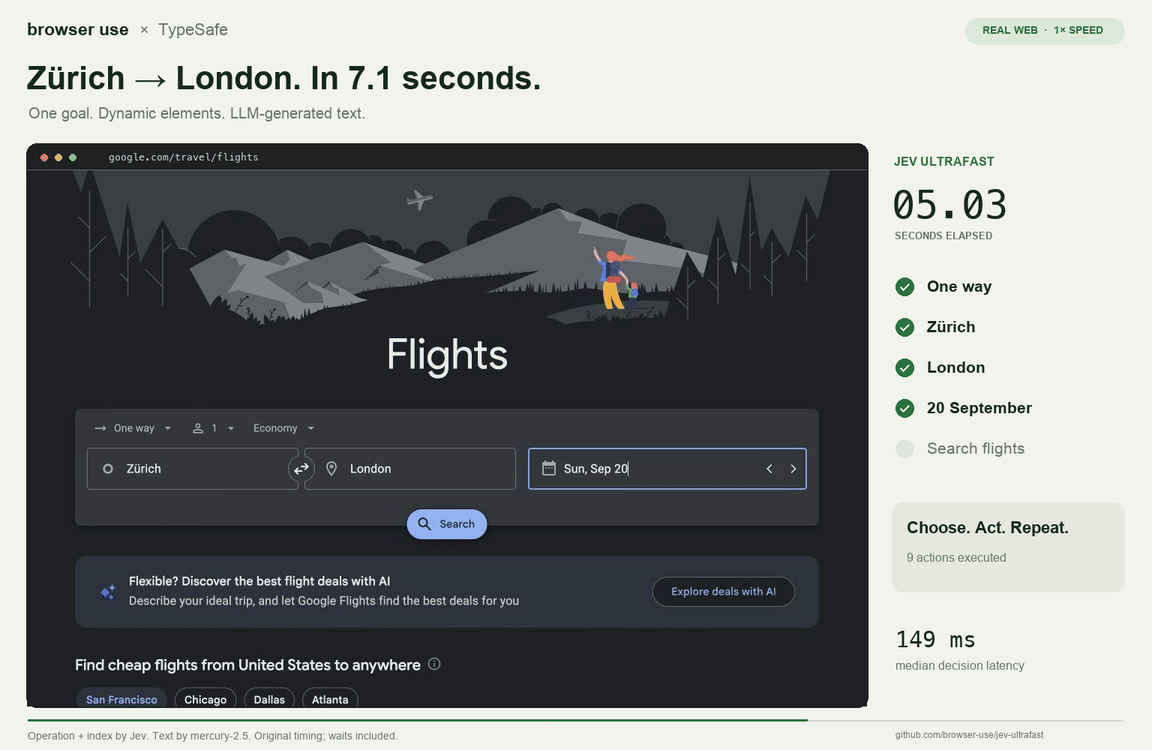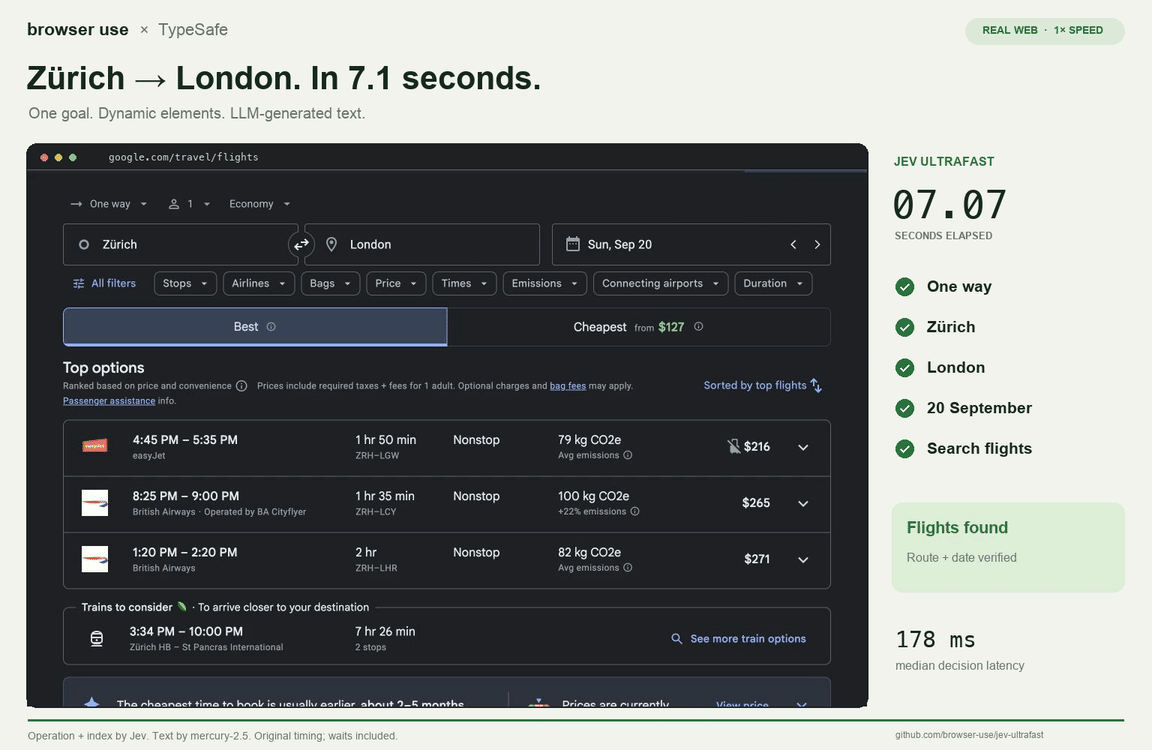
Rzeczywisty GIF nagrany przez autora z Browser Use, przypięty do commitu 1231850a0bf1a0c0341fe408ef1668dbbfdfac46. Copyright 2026 Browser Use, licencja MIT. Pokazuje wyszukiwanie, nie zakup. To samo nagranie można odtworzyć poniżej.
Wideo MP4 autora pokazane z oryginalną prędkością i elementami sterowania przeglądarki. Oryginalne nagranie i notatki z pomiarów; zachowana licencja MIT. Sprawdziliśmy publiczne materiały, ale nie powtórzyliśmy tego benchmarku.
Zmierzony przez autora czas ukończenia nagranego zadania to 7.073 sekundy. Pomiar zaczyna się od pierwszej predykcji po wstępnej obserwacji strony głównej, a nie od uruchomienia świeżej przeglądarki. Konfiguracja, początkowa nawigacja i nowa, niezależna weryfikacja po zadaniu nie wchodzą w ten przedział czasowy. Wyniki wyszukiwania są sprawdzane; żaden bilet nie zostaje wybrany ani kupiony. Te granice są kluczowe dla zrozumienia znaczenia tej liczby.
Ten sam raport porównuje sześć naprzemiennych uruchomień, po trzy dla każdego środowiska wykonawczego. Mediana czasu zadania spada z 9.450 sekundy do 7.092 sekundy, a mediana liczby wywołań protokołu przeglądarki zmniejsza się z 1,092 do 101. Oba warianty korzystają z Jev i tego samego pomocniczego modelu tekstowego, więc jest to przede wszystkim porównanie środowisk wykonawczych, a nie dwóch rodzin modeli. Autor wyraźnie zaznacza małą próbę i zmienność aktywnego internetu w raporcie wydajności.
Naszym zdaniem otaczająca pętla przeglądarki zasługuje na tyle samo uwagi co model. Wielokrotne zbieranie informacji o stronie, lokalizowanie elementów docelowych i unieważnianie decyzji mogą kosztować więcej, niż sugerowałaby prostota kliknięcia. Szybszy silnik decyzyjny nie zrekompensuje niewiarygodnego opisu przycisku, który ma wybrać. Repozytorium przeprowadza niezależną weryfikację wyniku, bo stwierdzenie modelu, że skończył, nie dowodzi ukończenia zadania.
Właśnie tutaj ograniczenia demonstracji stają się przydatne. Udokumentowana implementacja nie obejmuje każdej klatki, elementów canvas, przesyłania plików ani dowolnych widżetów obsługiwanych klawiaturą. Zespół oceniający system powinien odtworzyć reprezentatywne dla siebie zadanie i ścieżki błędów, a nie wywnioskować ogólną sprawność przeglądarkową z udanego wyszukiwania lotu. Traktuj nagranie jako możliwy do sprawdzenia dowód jednego działającego zestawienia komponentów.
Wpis o 1 500 e-mailach zapowiada się obiecująco, ale brakuje mu mianowników
16 września 2026 r. vogel (@ryanvogel) napisał na X, że wypróbował Jev na 1 500 własnych e-mailach i zrobiły na nim wrażenie wyniki klasyfikacji. Oryginalny wpis zawiera wideo. To przydatny przykład rzeczywistego użycia, bo skala zadania jest konkretna, a źródłem jest osoba relacjonująca eksperyment, nie anonimowa lista hipotetycznych zastosowań.
Nie jest to jednak raport dokładności. Wpis nie określa publicznego, oznaczonego zbioru testowego, zmierzonego odsetka błędów, zgodności osób oceniających ani kosztu pomyłek. Liczba przetworzonych wiadomości mówi o skali eksperymentu, nie o poprawności wyników. Obejrzyj oryginalną demonstrację na X, pamiętając o tym rozróżnieniu; do filmu prowadzi link, ponieważ nie ma licencji na jego redystrybucję.
Klasyfikacja e-maili to mimo wszystko rozsądny punkt wyjścia do oceny, bo można ją uczynić odwracalną. Wyświetlaj sugerowane etykiety obok obecnej skrzynki odbiorczej, nie zmieniaj oryginalnej wiadomości i zapisuj poprawki. Porównuj łatwe do pomylenia pary, takie jak faktura i przypomnienie o płatności albo prośba o anulowanie i skarga, w której anulowanie jest tylko wspomniane. Takie przypadki pokazują, czy kategorie odpowiadają rzeczywistemu procesowi pracy.
Pierwsze wdrożenie nie powinno automatycznie usuwać poczty, wysyłać odpowiedzi ani zatwierdzać transakcji tylko dlatego, że klasyfikacja wydaje się pewna. Takie działania wymagają innych uprawnień i mają inne konsekwencje. Zacznij od sugestii lub kolejki weryfikacyjnej; wprowadź wąsko określone działanie dopiero po zmierzeniu wzorca błędów. To proponowana przez nas procedura oceny, nie twierdzenie o implementacji autora wpisu na X.
Doom i Wikiracing uwidaczniają pętlę decyzyjną
Premiera TypeSafe obejmuje demonstrację Doom i demonstrację Wikiracing, do których odsyła oficjalny artykuł premierowy. To przydatne wizualne objaśnienia powtarzanych decyzji. Nie dowodzą, że Jev jest uniwersalnym modelem wizualnym ani że potrafi rozwiązywać dowolne problemy planowania.
W przykładzie z Doom model otrzymuje ustrukturyzowany tekstowy opis stanu, a nie zrzuty ekranu. W Wikiracing wybiera spośród dostępnych linków, zamiast wymyślać docelowy URL. Interesujący mechanizm to powtarzany cykl obserwacji, ograniczonego wyboru i działania. Demonstracje gier ułatwiają dostrzeżenie tego cyklu, ale nie przesądzają, jak dobrze przeniesie się on do innego środowiska.
Ten sam podział widać w dokumentacji demonstracji inteligentnego domu TypeSafe. Różne pytania mogą klasyfikować aspekty prośby, podczas gdy inny komponent obsługuje swobodną rozmowę lub dzieli złożone żądanie. Nie należy opisywać tej architektury jako jednego modelu, który jednocześnie generuje język i wykonuje każdą decyzję. Nazwy takie jak asystent czy agent często ukrywają te granice, jeśli implementacja nie przedstawia ich jasno.
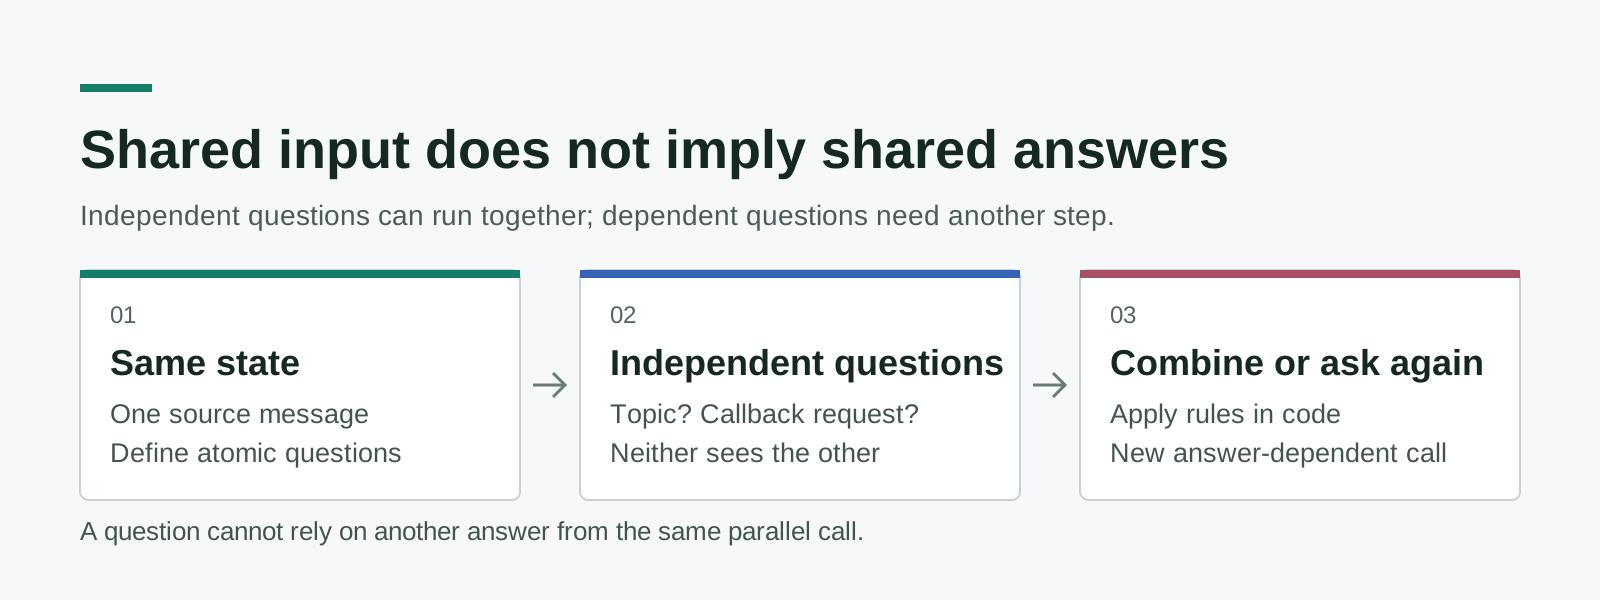
Oryginalny diagram oparty na udokumentowanym kontrakcie fan-out. Równoczesne pytania korzystają ze wspólnego stanu, ale nie odczytują potajemnie swoich odpowiedzi.
Wzorzec fan-out może skrócić czas oczekiwania przy sekwencyjnym przetwarzaniu, gdy kilka pytań zależy od tego samego źródła. Na przykład temat wiadomości i to, czy wyraźnie prosi ona o telefon zwrotny, można ocenić niezależnie. Pytanie zależne od nowo wybranego tematu nie może zakładać, że odpowiedź już istnieje w tym samym wywołaniu. Przenieś tę zależność do późniejszego kroku albo deterministycznie połącz niezależne wyniki w kodzie.
Odpowiedź o określonym typie nie musi być poprawna
Najgroźniejsza interpretacja modelu o ograniczonym wyjściu zakłada, że odpowiedź o poprawnej strukturze nie może być błędna. Może. Klasyfikator może wybrać dozwoloną, lecz nieodpowiednią etykietę, a selektor działań może wskazać prawidłowy przycisk, ale w niewłaściwym formularzu. Usunięcie niepoprawnej prozy z interfejsu jest wartościowe, ale dotyczy innej klasy awarii niż niezrozumienie zadania.
Notatki TypeSafe o nierównomierności Jev 1.13, ostatnio sprawdzone 17 września, opisują słabości w arytmetyce, liczeniu, porównywaniu dat, radzeniu sobie z rozpraszającym kontekstem i danymi wejściowymi stworzonymi w celu wprowadzenia modelu w błąd. W dokładnych porównaniach parsuj daty i obliczaj wartości zwykłym kodem. Nie zamieniaj deterministycznej reguły w osąd semantyczny tylko dlatego, że model potrafi odpowiedzieć na takie pytanie.
Znaczenie ma również dokumentacja pewności: Choice i Score udostępniają rozkłady prawdopodobieństwa oraz wyprowadzoną wartość pewności; Noul nie ma osobnego pola pewności. Ta liczba nie jest uniwersalnym prawdopodobieństwem poprawności odpowiedzi. Progi trzeba sprawdzić dla własnego zadania, zwłaszcza gdy konsekwencje fałszywie dodatniego i fałszywie ujemnego wyniku są różne.
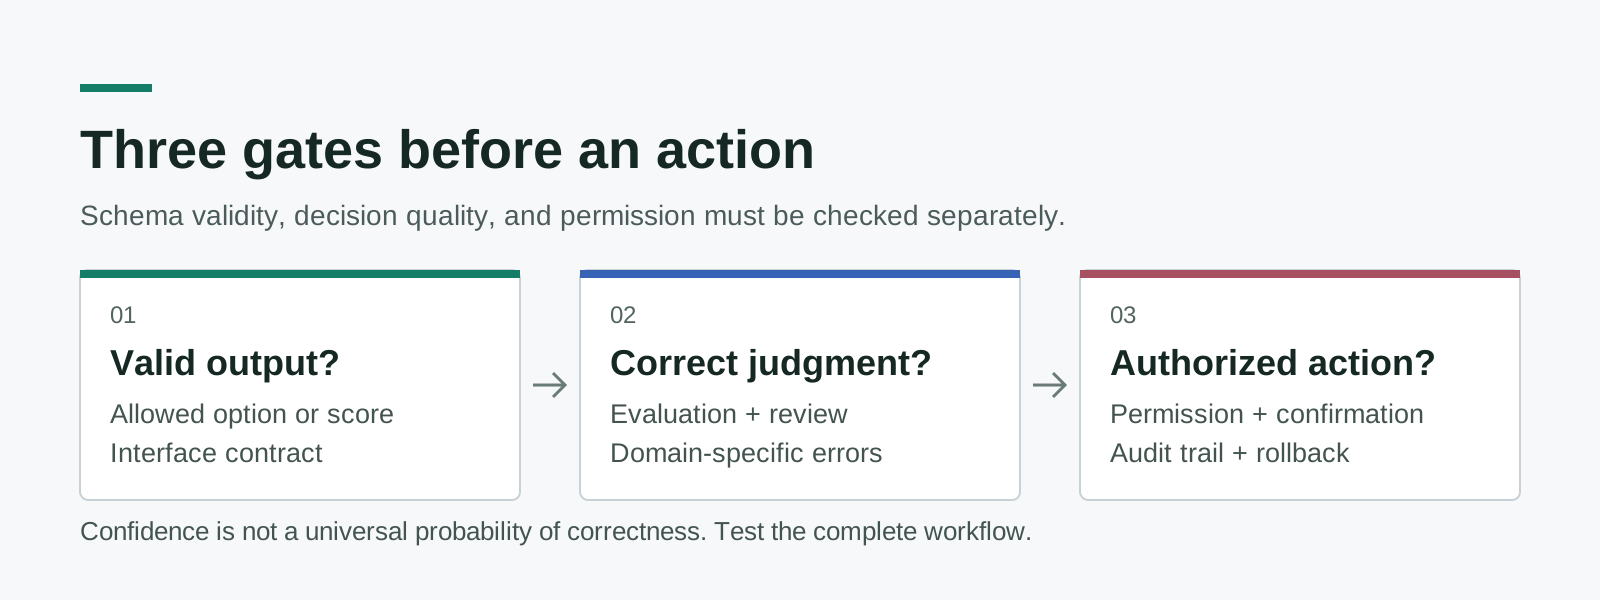
Oryginalny diagram oceny. Przejście jednej bramki nie oznacza przejścia kolejnej; dozwolony wynik nadal wymaga poprawnej interpretacji i autoryzowanego działania.
W pracy wielojęzycznej testuj każdy obsługiwany język. Dokumentacja modelu podaje, że podstawowym językiem treningowym jest angielski, a jakość nie jest jednakowa w innych językach, również tych używających pism CJK. Kolejka pomocy po koreańsku albo wielojęzyczne archiwum newsletterów powinny więc stanowić osobną część oceny, a nie zakładane rozszerzenie wyniku angielskiego. Tłumaczenie może też zmienić materiał dowodowy, dlatego przy ocenie przetłumaczonej reprezentacji zachowaj oryginał.
Zaplanuj próbę, która może uczciwie zakończyć się niepowodzeniem
Przydatny pilotaż zaczyna się od decyzji, którą zespół potrafi spójnie oznaczać. Wybierz odwracalne zadanie, takie jak sugerowanie kolejki pomocy, wskazanie możliwego duplikatu lub oznaczenie dokumentu do późniejszej weryfikacji. Nie definiuj sukcesu jako płynnego przebiegu demonstracji. Określ błędne wyniki, które zauważysz, te, które możesz przeoczyć, oraz koszt każdego z nich dla użytkownika.
- Zapisz kontrakt decyzji. Wymień możliwe wyniki, potrzebne pola źródłowe i opcję weryfikacji. Oddziel interpretację semantyczną od obliczeń i uprawnień.
- Przygotuj zbiór oceny. Korzystaj z materiałów, które wolno Ci przetwarzać. Uwzględnij typowe przypadki, niejednoznaczne granice, różne języki, puste pola i złośliwe instrukcje w tekście źródłowym.
- Zachowaj próbę odłożoną. Dostosuj kryteria na jednym zbiorze, a następnie zmierz wyniki na materiałach, które nie wpłynęły na ich sformułowanie. Zapisuj rozbieżności zamiast po cichu zmieniać oczekiwaną odpowiedź.
- Mierz cały proces. Śledź błędy dla każdej kategorii, odsetek weryfikacji, opóźnienie od początku do końca, ponowienia i całkowity koszt. Szybkie wywołanie modelu wewnątrz powolnej pętli pobierania danych nadal oznacza powolny produkt.
- Uruchom tryb sugestii. Rejestruj wybraną opcję, odpowiednie prawdopodobieństwa, wersję modelu i korektę człowieka, nie wykonując automatycznie działań o poważnych konsekwencjach.
- Wprowadź jedno ograniczone działanie. W razie potrzeby wymagaj jawnego upoważnienia, zachowaj ślad audytowy i zapewnij możliwość wycofania zmian po modyfikacji źródła lub wersji modelu.
Ta procedura jest celowo bardziej rygorystyczna niż obejrzenie nagrania. Sprawdza, czy model pomaga w rozkładzie przypadków właściwym dla Twojej organizacji, również tych kłopotliwych. Wysoki odsetek weryfikacji może być lepszy niż kilka cichych, kosztownych pomyłek. Ustal ten kompromis przed wyborem progu, a nie po wykryciu incydentu.
Aby zapewnić powtarzalność oceny, przypnij wersję i zapisuj wersję zwracaną przy każdym wyniku. Zmienne aliasy są wygodne podczas eksperymentów, ale mogą zmienić zachowanie bez zmian w kodzie aplikacji. Materiał z oceny powinien pozwolić innej osobie odtworzyć kryteria, dane wejściowe, oczekiwane wyniki i granice wykonania. Tak obiecujący eksperyment zmienia się w możliwą do utrzymania funkcję, a nie tylko zbiór efektownych klipów.
Sedno: zamknij ocenę w ograniczonym kontrakcie
Jev jest najciekawsza, gdy podejmuje niewielką, możliwą do sprawdzenia decyzję wewnątrz programu, który zna już swoje zasady. Nagranie przeglądarki pokazuje działający układ komponentów, wpis o e-mailach dostarcza konkretnego eksperymentu wartego sprawdzenia, a oficjalne demonstracje ukazują samą pętlę. Następne pytanie nie brzmi, czy model potrafi wybrać odpowiedź, lecz czy system rozpozna zły wybór, zanim ten zacznie mieć znaczenie.
Źródła i informacje o mediach
- TypeSafe: Introducing System One Models and Jev, 15 września 2026 r.; oficjalna premiera i kontekst filmów z gier.
- Browser Use: jev-ultrafast, przypięte źródło sprawdzone 30 września 2026 r. GIF i MP4: copyright 2026 Browser Use, licencja MIT; nie sugerujemy powiązań.
- Browser Use: nagranie i pomiary porównywalnych uruchomień, sprawdzono 30 września 2026 r.; pomiary autora, nie nasza replikacja.
- vogel na X: eksperyment klasyfikacji 1 500 e-maili, 16 września 2026 r.; przypadek użycia opisany przez autora z oryginalnym wideo.
- Prymitywy TypeSafe, modele, pewność, wzorzec fan-out i demonstracja inteligentnego domu, sprawdzone 30 września 2026 r.
- Nierównomierność Jev 1.13, ostatnio sprawdzono 17 września 2026 r.; weryfikacja 30 września.
- Artykuł o zastosowaniach Jev na Tistory, 18 września 2026 r.; punkt wyjścia do badań, nie potwierdzenie wdrożenia.
Zachowuj źródła obok notatek
Badając nowy model, zachowuj źródło, datę i informację, co faktycznie potwierdza demonstracja. Utwórz konto Telli.sh, aby uporządkować własne materiały badawcze i notatki pochodne, nie myląc podsumowania z oryginalnym materiałem dowodowym.