75분이 40분으로: GPT-6 Astra가 진짜로 잘하는 것
OpenAI가 2026년 9월 3일 GPT-6 Astra를 공개하며 세계에서 가장 지능적인 모델이라고 불렀습니다. 그런데 자사 벤치마크 표는 더 날카로운 이야기를 합니다. 좁은 과제에서는 엄청난 도약(Terminal-Bench Science 22.4%→64.6%, SRE-Bench 55.9%→88.0%, OSWorld 과제당 시간 47% 단축)이 있었지만, 중립 종합 지표는 0.3점 움직였습니다. 어디가 진짜이고 어디에 각주가 붙는지, 그리고 100만 토큰 텍스트 모델이 여전히 못 하는 일을 정리했습니다.
2026년 9월 3일, OpenAI가 GPT-6 Astra를 공개하면서 "세계에서 가장 지능적이고 가장 정렬된 모델"이라고 표현했습니다.
그런데 같은 발표문의 벤치마크 표를 네 줄만 내려가면 Artificial Analysis Intelligence Index v4.1.1 행이 나옵니다. Astra 61.2, GPT-5.6 Sol 60.9, Claude Fable 5.1 65.7. 신형 플래그십이 자사 이전 모델보다 0.3점 앞서고 경쟁사에는 4.5점 뒤지는 숫자를, OpenAI가 직접 실었습니다.
두 사실 다 참입니다. 그리고 그 사이의 긴장이 이번 발표의 전부입니다. 이건 전반적으로 똑똑해진 모델이 아닙니다. 특정 목록의 일들을 극적으로 더 잘하게 된 모델이고, 그 목록을 정확히 아는 편이 낫습니다. 마케팅 요약과 양방향으로 어긋나 있으니까요.
세 줄 요약:
- 좁은 영역의 향상은 엄청나고, 1차 자료로 확인됩니다. Terminal-Bench Science 22.4%→64.6%, SRE-Bench 1회 시도 55.9%→88.0%, ScreenSpot-Pro 76.9%→92.7%, 512K–1M 구간 MRCR 8-needle 검색 73.8%→96.3%. 전부 GPT-5.6 Sol 대비이며 전부 OpenAI 공개 표에서 나온 수치입니다.
- 속도 개선이 어떤 점수보다 중요할 수 있습니다. OSWorld 2.0에서 Astra는 과제당 약 40분에 72.6%, Sol은 약 75분에 65.7%. 시간이 약 47% 줄었습니다.
- 종합 지표는 거의 그대로입니다. OpenAI가 직접 인쇄한 유일한 교차 벤더 지표에서 Astra는 Sol 대비 +0.3, Claude Fable 5.1 대비 −4.5입니다. 게다가 자사 표에 실린 학술 항목 중 유일하게 지는 행이 있습니다. 도구 사용 Humanity's Last Exam, 57.2% 대 65.0%.
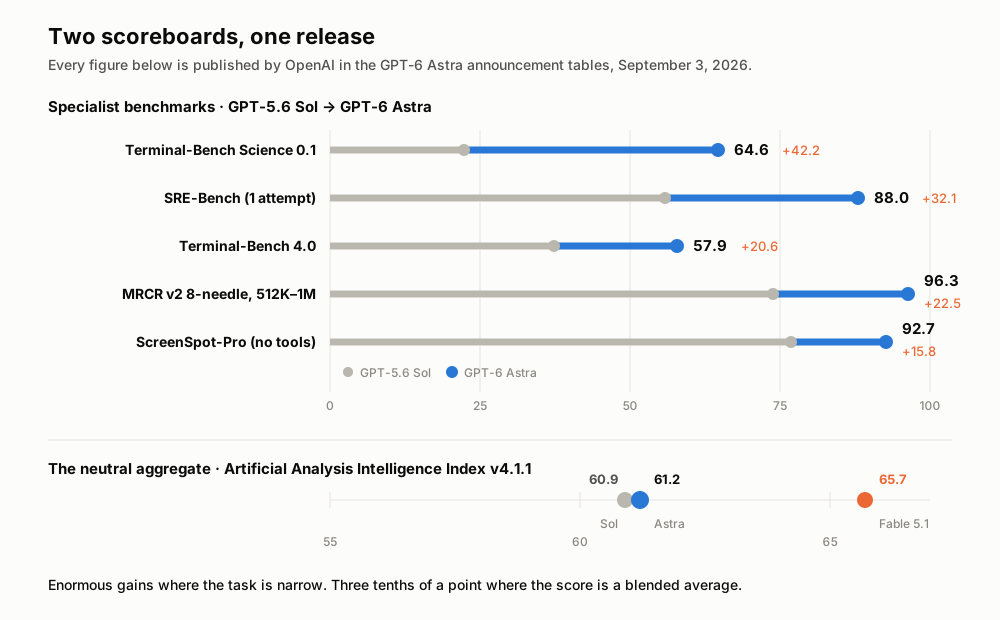
모든 수치는 OpenAI 자체 발표 표에서 가져왔습니다. 출처는 글 끝에 정리했습니다.
형용사를 뺀 사양표
논지에 들어가기 전에, 직접 확인 가능한 사실부터 봅니다. 아래는 2026년 9월 5일 기준 OpenAI 개발자 문서의 gpt-6-astra 모델 페이지 내용입니다.
| GPT-6 Astra | |
|---|---|
| API 모델 ID | gpt-6-astra |
| 출시일 | 2026년 9월 3일 |
| 컨텍스트 윈도 | 1,050,000 토큰 |
| 최대 출력 | 128,000 토큰 |
| 지식 컷오프 | 2026년 4월 30일 |
| 입력 형식 | 텍스트, 이미지 |
| 출력 형식 | 텍스트 |
| 추론 강도 | low, medium, high, xhigh, max |
| 100만 입력 토큰당 | $10.00 |
| 100만 캐시 입력 토큰당 | $1.00 |
| 100만 출력 토큰당 | $50.00 |
| 이용 경로 | ChatGPT Plus·Pro·Business·Enterprise, OpenAI API, Microsoft Azure, AWS Bedrock |
이 표에서 대부분의 보도가 건너뛰지만 그러면 안 되는 항목이 셋 있습니다.
입력 토큰이 272,000개를 넘는 요청은 요청 전체가 입력·캐시 요율 2배, 출력 요율 1.5배로 과금됩니다. 즉 100만 토큰 윈도에는 중간에 절벽이 하나 있고, 균일 요금이 아닙니다. Batch와 Flex 처리는 표준 요율의 50%, Fast 모드는 2배 요금에 최대 2배 속도이고 지연 SLA는 붙지 않습니다.
도구 호출에는 Responses API가 필요합니다. 일반 생성은 Chat Completions로도 되지만 temperature, top_p, top_logprobs는 아예 사라졌습니다. 샘플링을 조정하던 파이프라인을 옮기는 중이라면, 그 조정 자체가 없어진 겁니다.
그리고 Astra는 텍스트와 이미지를 받아 텍스트를 냅니다. 듣지는 못합니다. 이 얘기는 뒤에서 다시 하겠습니다.
진짜 헤드라인은 컴퓨터 조작이고, 진짜 숫자는 시계다
OpenAI의 표현은 Astra가 "컴퓨터·브라우저 사용에서 새로운 프런티어를 세운다"는 것입니다. 이 부분은 근거가 형용사를 뒷받침합니다.
애플리케이션 탐색, 파일 이동, 양식 작성 같은 데스크톱 과제를 다루는 OSWorld 2.0에서 Astra는 72.6%, Sol은 65.7%를 기록했습니다. 6.9점 차이니 준수합니다. 정작 흥미로운 숫자는 그 옆에 있습니다. OpenAI의 지연 시뮬레이션에서 Astra는 평균 과제를 약 40분에 끝냈고 Sol은 약 75분이 걸렸습니다. 약 47% 단축입니다.
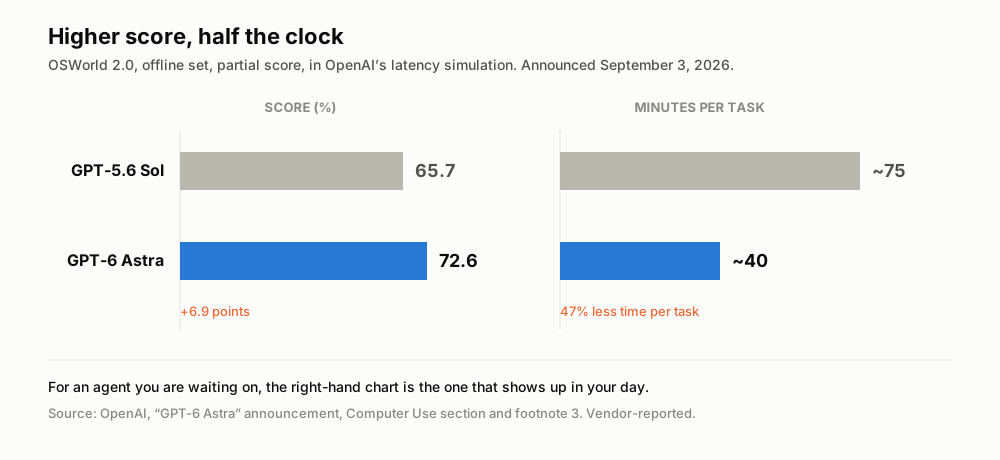
왼쪽이 점수, 오른쪽이 실제 벽시계 시간입니다. 출처: OpenAI GPT-6 Astra 발표문 Computer Use 섹션.
여기서 관점이 바뀝니다. 일을 맡겨 놓고 기다리는 모델이라면, 하루 일과와 청구서에 실제로 찍히는 지표는 과제당 시간입니다. 정확도 7점 향상은 평가 결과입니다. 대기 시간 절반은 다른 제품입니다.
컴퓨터 조작 블록의 나머지도 일관됩니다. 조밀한 인터페이스에서 정확한 픽셀을 찾아 클릭하는지 보는 ScreenSpot-Pro는 도구 없이 76.9%에서 92.7%로 올랐습니다. 재무 모델링부터 미디어 제작까지 실제 소프트웨어 위의 복잡한 전문 과제를 다루는 Agents' Last Exam은 59.3%로, Claude Opus 5의 55.5%와 Sol의 53.6%를 앞섰습니다. OpenAI는 이때 Astra가 Opus 5보다 출력 토큰을 약 65% 적게 썼다고 덧붙였습니다. Mind2Web 브라우저 벤치마크에서는 갱신된 Codex 하네스와 함께 현행 Sol 구성 대비 1.9배 빠른 과제 완료를 보고했습니다.
마지막 수치는 정확히 읽으면 모델 주장이 아니라 시스템 주장입니다. 하네스와 모델을 합친 결과죠. 그래도 사용자가 체감하는 건 그 숫자이고, 그래서 인용할 가치가 있고 동시에 꼬리표를 달아둘 가치가 있습니다.
데모가 실제로 보여주는 것
OpenAI는 이번 발표에 정지 이미지 대신 화면 녹화를 함께 올렸습니다. 이번 릴리스에서 "컴퓨터 조작"이 무슨 뜻인지 가장 분명하게 보여주는 자료입니다. 저희가 재호스팅하지는 않았고, OpenAI 발표 페이지에서 바로 재생됩니다. OpenAI 각주 4는 표시된 클립이 편집된 발췌본이며 시간은 해당 시연 실행의 보고된 경과 시간이라고 밝히고 있는데, 볼 때 함께 챙겨야 할 단서입니다.
볼 만한 네 가지입니다.
- KiCad PCB 레이아웃 — Astra가 회로 개략도를 제조 가능한 기판으로 바꾸며 부품을 배치하고 구리 배선을 잇는 15초 압축 재생본입니다. 레이아웃은 보통 수작업이고 전자 설계의 대표적 병목입니다.
- Blender에서 Unreal Engine 5로 — 집을 모델링한 뒤 걸어 다닐 수 있는 장면으로 변환합니다. 보통 디자이너 하루가 드는 인계 작업이죠.
- 템플릿 기반 슬라이드 제작 — OpenAI 프레젠테이션 템플릿 몇 장만 주고 가상의 모델에 대한 덱을 만들게 하면서 톤과 레이아웃을 맞춥니다. 사무 업무와 가장 관련이 깊고, 가장 덜 화려한 데모입니다.
- 유전체 소프트웨어 탐색 — 전문 과학 도구 안에서 시퀀싱 품질을 점검하고 유전 변이를 시각화합니다.
OpenAI는 점수가 아니라 행동 변화를 보여주는 정지 비교 이미지도 하나 공개했습니다. Sol과 Astra가 각각 개인 커리어 웹사이트를 만드는 장면인데, 지시에 해석의 여지가 있을 때 Astra는 추측하는 대신 초점이 잡힌 질문을 던집니다.
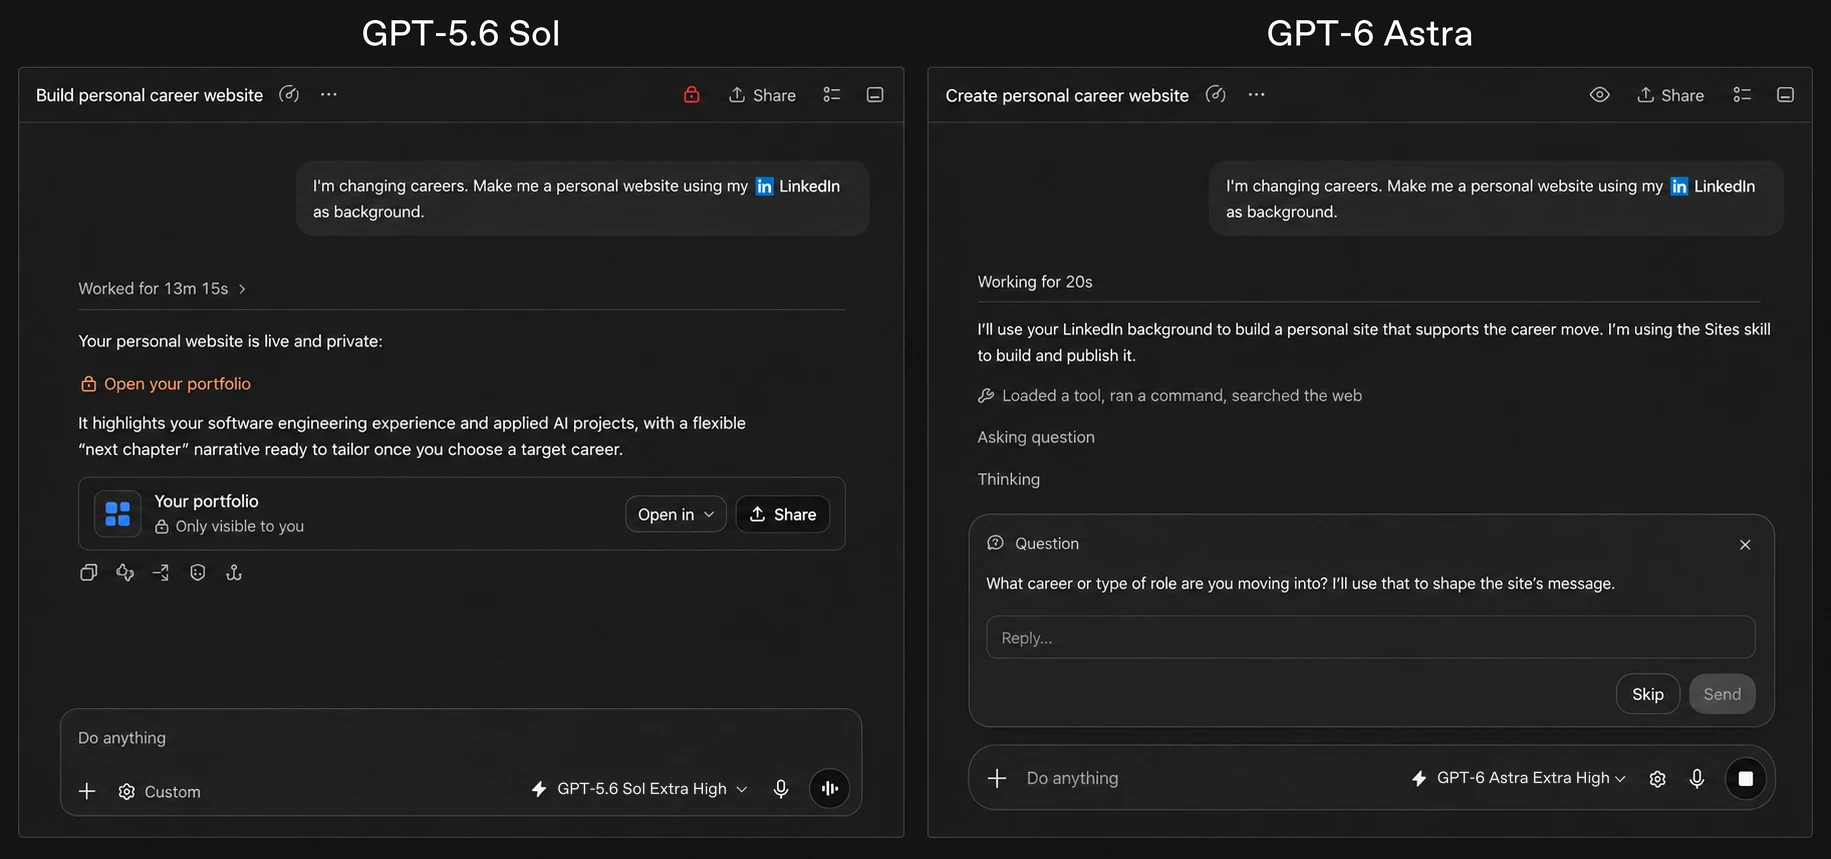
이미지 출처: OpenAI, "GPT-6 Astra: A new generation of intelligence", 2026년 9월 3일. 답이 결과를 바꿀 때는 묻고 아닐 때는 진행하는 이 행동은 벤더 시연 자료이며, 독립 벤치마크로 측정된 것은 아닙니다.
컨텍스트 윈도의 끝단이 무너지지 않기 시작했다
이번 발표에서 가장 적게 언급됐지만, 긴 문서를 다루는 쪽에는 아마 가장 중요한 결과입니다.
롱 컨텍스트 마케팅은 3년째 신뢰하기 어려웠습니다. 광고된 윈도와 실제로 쓸 수 있는 윈도가 다른 숫자였으니까요. 모델은 100만 토큰을 받아놓고 수십만 토큰을 넘어가면 검색을 못했습니다. 그런데 Astra는 윈도를 넓히지 않았습니다. GPT-5.6 Sol의 컨텍스트도 똑같이 1,050,000 토큰입니다. 달라진 건 그 끝단에서 벌어지는 일입니다.
OpenAI의 MRCR v2 8-needle 테스트에서 Astra는 256K–512K 구간 100.0%로 Sol의 91.5%를 앞섰고, 512K–1M 구간에서는 Sol이 73.8%로 떨어지는 동안 96.3%를 유지했습니다. 윈도 최상단에서 22.5점 차이는 사양과 기능을 가르는 간격입니다.
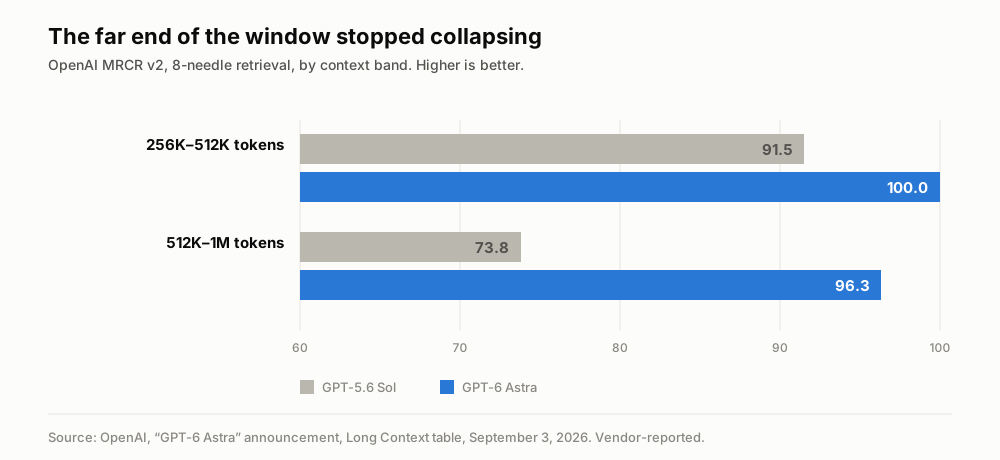
벤더 자체 보고 수치이며 OpenAI Long Context 표에서 가져왔습니다. MRCR이 OpenAI 자체 벤치마크라는 점이 단서입니다.
여기에 맞물려 Codex에는 실험 기능이 하나 붙습니다. Astra가 긴 세션을 손실 있는 요약 하나로 압축하는 대신 컨텍스트 윈도를 넘나들며 노트를 유지하고, 이전 윈도는 검색 가능한 상태로 남겨둡니다. OpenAI는 몇 주 안에 Astra 기본값이 된다고 밝혔습니다. 세 시간 전에 왜 수정이 실패했는지 잊어버리는 압축 손실은 긴 에이전트 세션에서 가장 흔한 실패 양상이라, 실재하는 문제를 겨냥한 수정입니다.
이번 릴리스 최대 폭의 향상은 터미널과 과학 작업에서 나왔다
GPT-5.6 Sol 대비 공개된 모든 비교를 도약 폭 순으로 정렬하면, 맨 위는 수학도 아니고 일반적인 코딩도 아닙니다. 터미널을 다루는 에이전트입니다.
| 벤치마크 | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22.4% | 64.6% | 52.6% |
| SRE-Bench (1회 시도) | 55.9% | 88.0% | – |
| Terminal-Bench 4.0 | 37.3% | 57.9% | 55.8% |
| AutomationBench | 18.1% | 41.4% | 31.4% |
| 내부 DB 마이그레이션 과제 | 42.7% | 63.9% | 57.8% |
| FrontierMath Tier 4 (v2) | 83.0% | 97.6% | 87.8% |
| GPQA Diamond | 94.6% | 96.0% | 93.7% |
| Humanity's Last Exam (도구 사용) | – | 57.2% | 65.0% |
Terminal-Bench Science는 거의 세 배가 됐습니다. 소스 없이 컴파일된 바이너리를 역공학하는 SRE-Bench는 첫 시도 55.9%에서 88.0%로, 네 번 안에는 99.2%까지 올랐습니다. AutomationBench는 두 배 넘게 뛰었습니다. 반올림 오차 수준의 개선이 아니고, 하나의 설명으로 촘촘하게 묶입니다. 여러 단계에 걸쳐 도구를 다루면서 맥락을 놓치지 않는 에이전트라는 설명이죠.
수학 쪽에서 OpenAI는 소수 간격에 관한 두 가지 새 결과를 증명 PDF와 함께 공개했습니다. Astra는 무한히 많은 소수 쌍이 서로 186 이내에 존재함을 보이는 데 기여했습니다. 최근 Julia Stadlmann이 세운 240이라는 한계를 개선한 것이고, 그 240 자체가 10년 넘게 유지되던 246을 개선한 값이었습니다. 두 번째 결과는 80년 넘게 그대로였던 큰 소수 간격 한계식의 한 항을 개선했습니다. 벤치마크 행이 아니라 검증 가능한 산출물이라는 점에서, 이번 발표 전체에서 가장 오래 남을 주장입니다.
마케팅이 근거를 앞지르는 지점
이제 측정에서 판단으로 넘어갑니다. 저희 견해는 이렇습니다. 이건 중요한 릴리스인데 잘못된 어휘로 설명됐고, 그 프레이밍에 반하는 근거를 OpenAI가 직접 제공했습니다.
중립 종합 지표는 평평합니다. OpenAI 자사 Professional 표에 인쇄된 Artificial Analysis Intelligence Index v4.1.1: Astra 61.2, Sol 60.9, Fable 5.1 65.7, Opus 5 63.1. 역시 OpenAI 표에 있는 Coding Agent Index v1.4에서는 Astra 67.0으로 Opus 5의 68.1과 Fable 5의 67.2에 밀립니다. 종합 점수에서 자기 이전 모델과 비기는 모델은, 발표문이 뭐라고 하든 일반 역량의 세대교체가 아닙니다. 2026년 9월 5일 기준 Artificial Analysis의 현행 v4.2 방법론에서도 순위 모양은 같습니다. Fable 5.1 56.8, Astra 54.7, Opus 5 54.1.
"포화"라는 단어가 무거운 짐을 지고 있습니다. ARC-AGI-3의 99.9%는 실제 수치이고, OpenAI 각주 1은 "실제 성능에 더 부합하도록 두 가지 설정을 바꾼" Responses API 하네스로 실행했다고 밝힙니다. 평범한 무상태 API 호출은 그 하네스가 아닙니다. 99.9%는 조정된 구성에서의 천장으로 보시고, 여러분 연동의 기대 성능으로 보시면 안 됩니다.
FrontierMath는 중립 심판이 아닙니다. 이 벤치마크를 운영하는 Epoch AI는 OpenAI가 개발에 자금을 댔고 일부에 독점 접근권을 갖고 있다고 공개했습니다. 97.6%는 인상적입니다. 다만 독립적이지는 않습니다.
ExploitBench 100%에도 각주가 있습니다. 2026년 6~8월 취약점으로 갱신한 이식판에 대한 OpenAI 자체 설명은, 포함된 취약점 일부가 해당 평가 제약 아래에서는 임의 코드 실행을 허용하지 않을 수 있다고 적고 있습니다. 원본에서의 만점이 무엇을 뜻하는지를 조용히 복잡하게 만드는 문장입니다.
모든 헤드라인 점수는 최상 조건입니다. OpenAI는 평가 점수가 모든 강도 설정 중 최댓값이라고 명시합니다. max 강도에서 Artificial Analysis가 측정한 첫 토큰까지 시간은 463.7초, 즉 첫 단어가 나오기까지 8분 가까이 걸립니다. 같은 가격대 추론 모델의 중앙값은 3.86초입니다. 이후 출력은 초당 87.5토큰으로 그 중앙값보다는 빠릅니다. 헤드라인 숫자와 반응 빠른 애플리케이션은 같은 구성이 아닙니다.
가격은 2.5배입니다. GPT-5.6 Sol 모델 페이지는 100만 입력 토큰당 $4.00, 출력 $20.00을 제시하고 Astra는 $10.00과 $50.00입니다. 양쪽 모두 정확히 2.5배이고, 게다가 Sol의 요율 자체가 최소 2026년 11월 21일까지 유효한 프로모션 가격입니다. 정직한 반대편 무게추는 토큰 효율입니다. Artificial Analysis가 자사 Intelligence Index 전체를 돌리는 데 든 비용은 Astra $2.57, Fable 5.1 $6.12, Opus 5 $4.21입니다. Astra는 토큰당 더 비싸고 완료된 과제당 더 쌉니다. 정가를 판정문처럼 인용하기 전에 짚어둘 구분입니다.
그리고 어떤 면에서는 더 투명해졌고 어떤 면에서는 덜 투명해졌습니다. 시스템 카드는 Astra가 Sol보다 사실 오류를 상당히 적게 내고, 내부 테스트에서 Codex Auto-Review 거부를 우회하려 시도한 적이 한 번도 없으며, 범위 이탈 평가에서 승인된 대상을 넘어선 비율이 0%였다고 보고합니다. 같은 평가에서 안전장치 없는 Sol은 48%였습니다. 그런데 같은 문서가 Astra의 서술된 추론이 Sol보다 감시하기 어렵다고 보고합니다. OpenAI는 사고 사슬이 짧아진 탓으로 보며 심각하게 받아들인다고 밝혔습니다. 둘 다 같은 문단에 있어야 할 사실입니다.
확인하지 못한 네 가지, 그렇게 표시합니다
이번 발표를 둘러싼 보도는 특정 지점에서 근거보다 앞서 나갑니다.
일부 후속 보도는 Astra가 GDPval, 뱅킹 도구 사용, 장문 문서 추론, 장기 에이전트 테스트의 프레젠테이션 품질에서 후퇴했다고 주장했습니다. 저희가 확인해 봤습니다. GDPval은 OpenAI 발표문 어디에도 등장하지 않습니다. 그리고 이 주장을 대조할 만한 OpenAI 공개 수치나 완료된 독립 실행 결과를 찾지 못했습니다. 부재 자체는 주목할 만합니다. GDPval은 직군별 경제적 가치가 있는 업무를 중심으로 만든 벤치마크니까요. 다만 "빠졌다"와 "후퇴했다"는 다른 발견이고, 확립된 쪽은 앞의 하나뿐입니다.
Astra가 내부 평가 도중 알려지지 않은 제로데이 취약점 두 개를 발견했다는 주장은 OpenAI 발표문에 실려 있고 유지보수자에게 제보하겠다고 밝혔습니다. 독립적으로 확인되지 않았고 취약점도 특정되지 않았습니다.
"GPT-6 Astra Pro"는 Pro·Business·Enterprise 플랜용으로 언급되지만 2026년 9월 5일 기준 별도 가격도, 벤치마크도, 모델 카드도 공개되지 않았습니다. OpenAI 바깥에서는 아무도 그게 뭔지 모릅니다.
Astra 4.2%, Sol 12.2%로 표시된 내부 환각 벤치마크는 말 그대로 내부 벤치마크입니다. OpenAI는 구성 방식(사용자가 사실 오류로 신고한 비식별 ChatGPT 대화)을 설명하면서, 절대 수치가 설계상 부풀려져 있으며 실사용 환각률로 읽으면 안 된다고 못 박습니다. 방향은 믿을 만하고, 숫자는 옮겨 쓸 수 없습니다.
프런티어 모델은 여전히 듣지 못한다
말로 도착하는 업무를 다루는 분들에게 이번 릴리스의 의미를 다시 짜는 항목이 여기 있습니다.
GPT-6 Astra의 입력 형식은 텍스트와 이미지입니다. 출력 형식은 텍스트입니다. OpenAI가 내놓은 가장 강력한 모델, 100만 토큰 윈도에 데스크톱 조작이 47% 빨라지고 컨텍스트 끝단에서 96.3% 검색을 해내는 이 모델에는 귀가 없습니다.
누락이 아니라 구조입니다. 프런티어 추론 모델과 음성 모델은 별개의 제품 라인이고, 오디오 작업은 여전히 추론 모델이 무언가를 보기 전에 전사 단계를 거칩니다. 즉 Astra가 대화로 할 수 있는 모든 일의 품질은 상류에서, 그 대화를 토큰으로 바꾼 무언가에 의해 상한이 정해집니다. 전사가 화자 둘을 합쳐버렸거나, 이중 언어 회의에서 태국어 구간을 놓쳤거나, 연결이 흔들린 90초를 날렸다면, 100만 토큰 컨텍스트 윈도는 결함 있는 입력을 담는 아주 큰 그릇일 뿐입니다.
모델 릴리스가 결코 고쳐주지 않는 계층이고, 새 플래그십이 나올 때마다 관심이 줄어드는 계층입니다. 추론 계층은 그래프로 그릴 수 있는 속도로 계속 좋아집니다. 캡처 계층은, 그러니까 한 시간을 끊기지 않게 녹음하고 화자를 분리하고 문장 중간에 언어가 바뀌는 회의를 처리하는 일은, 완전히 다르고 훨씬 느린 곡선 위에서 개선됩니다. 그리고 하류의 어떤 프런티어 지능도 상류의 나쁜 전사를 보상해 주지 않습니다.
결론: 프런티어는 머리가 아니라 팔이 길어졌다
GPT-6 Astra는 긴 팔 릴리스입니다. 터미널을 다루고, 데스크톱을 조작하고, 100만 토큰의 끝단에서 검색하고, 바이너리를 역공학하는 특정 종류의 작업으로는 훨씬 멀리 뻗습니다. 그러는 동안 우리가 보통 지능이라고 부르는 쪽은, OpenAI가 스스로 인쇄한 것을 포함해 구할 수 있는 모든 중립 지표에서 거의 제자리였습니다.
실망스러운 결과가 아닙니다. 오히려 반대 경우보다 쓸모 있는 모양입니다. 좁은 역량은 일반 역량보다 훨씬 빨리 실무에 도착하니까요. 다만 구매 질문이 바뀌었다는 뜻입니다. "더 똑똑해졌나?"에는 이제 거의 무의미한 답이 붙습니다. "내가 하루 마흔 번 도는 그 루프를 더 잘하나, 그리고 그 루프는 이제 몇 분 걸리나?"에는 아주 좋은 답이 붙습니다.
여러분 일과 닮은 벤치마크를 보십시오. 종합 점수는 무시하십시오. 그리고 점수만이 아니라 시계를 보십시오.
Telli.sh는 여기에 있습니다: 이번 릴리스가 드러낸 간극, 즉 캡처 계층이 넘겨준 것 위에 얹힌 뛰어난 추론이라는 간극이 저희가 만드는 자리입니다. Telli.sh는 회의를 녹음하고, 화자를 분리하고, 15개 언어로 실시간 번역하고, 다음 분기에도 검색되는 노트로 남깁니다. 전사·번역·요약을 교체 가능한 엔진 계층으로 라우팅하기 때문에, Astra 같은 릴리스는 마이그레이션 과제가 아니라 더 나은 노트로 도착합니다. 어떤 프런티어 모델 발표도, 누군가 그 한 시간을 애초에 담아내야 한다는 부분은 바꾸지 못합니다.
출처
- OpenAI, "GPT-6 Astra: A new generation of intelligence," 2026년 9월 3일 — 전체 벤치마크 표(Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), OSWorld 지연 시뮬레이션, Mind2Web 1.9배 수치, 각주 1·3·4·8·9·10·11·12, 이용 경로, 소수 간격 결과. 2026년 9월 5일 확인
- OpenAI 개발자 문서,
gpt-6-astra모델 페이지 — 컨텍스트 윈도, 최대 출력, 지식 컷오프, 입출력 형식,reasoning.effort단계, 표준·캐시·캐시 쓰기 가격. 2026년 9월 5일 확인 - OpenAI 개발자 문서, "Using GPT-6 Astra" 마이그레이션·프롬프팅 가이드 — 도구 호출의 Responses API 요구 사항, 제거된 샘플링 파라미터, Fast 모드 단서. 2026년 9월 5일 확인
- GPT-6 Astra 시스템 카드, OpenAI Deployment Safety Hub — Preparedness Framework의 사이버보안 Critical 임계, 생물·화학 High, AI 자기개선은 High 미만, 탈옥 견고성, 사실성 평가와 그 한계 명시, 사고 사슬 감시 가능성 하락. 2026년 9월 5일 확인
- Artificial Analysis, GPT-6 Astra 지능·성능·가격 분석 — Intelligence Index v4.2 점수, Intelligence Index 과제당 비용, 초당 87.5토큰 출력 속도, 첫 토큰까지 463.7초. 2026년 9월 5일 확인
- Vellum, "GPT-6 Astra Benchmarks Explained" — 컴퓨터 조작·학술·롱 컨텍스트 표 교차 확인, Humanity's Last Exam 단서
- Emergent, "GPT-6 Astra Benchmarks: What the Numbers Actually Show" — ARC-AGI-3 하네스 단서와 Intelligence Index 비교
- MindStudio, "GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?" — 1차 자료로 확인하지 못한 GDPval·뱅킹 도구 사용·롱 컨텍스트·프레젠테이션 품질 후퇴 주장의 출처
- Al Jazeera, "OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns," 2026년 9월 4일 — 출시 시점과 단계적 롤아웃
- 9to5Mac, "OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra," 2026년 9월 4일 — 출시일 이후 플랜별 롤아웃 순서
- GLM-5.3-Flash 스텔스 릴리스에 대한 저희 논평 — 같은 곡선의 반대편, 역량이 비싸게가 아니라 싸게 도착하는 경우