40 minutos en lugar de 75: en qué es realmente bueno GPT-6 Astra
OpenAI lanzó GPT-6 Astra el 3 de septiembre de 2026 y lo llamó el modelo más inteligente del mundo. Sus propias tablas de benchmarks cuentan una historia más afilada: saltos enormes en tareas estrechas — Terminal-Bench Science del 22,4 % al 64,6 %, SRE-Bench del 55,9 % al 88,0 %, OSWorld con un 47 % menos de tiempo por tarea — apoyados sobre un índice general neutral que se movió tres décimas. Dónde las mejoras son reales, dónde están los asteriscos y qué sigue sin poder hacer un modelo de texto de un millón de tokens.
El 3 de septiembre de 2026, OpenAI lanzó GPT-6 Astra y lo llamó «el modelo más inteligente y mejor alineado del mundo».
Cuatro filas más abajo, en su propia tabla de benchmarks, está el Artificial Analysis Intelligence Index v4.1.1: Astra 61,2, GPT-5.6 Sol 60,9, Claude Fable 5.1 65,7. OpenAI publicó ella misma la cifra en la que su nuevo buque insignia gana tres décimas a su propio predecesor y pierde 4,5 puntos frente a un competidor.
Ambos hechos son ciertos, y la tensión entre ellos es toda la historia. Este no es un modelo que se haya vuelto más inteligente en general. Es un modelo que ha mejorado de forma espectacular en una lista concreta de cosas, y conviene conocer esa lista con precisión, porque no coincide con el resumen de marketing en ninguna de las dos direcciones.
En resumen:
- Las mejoras especializadas son enormes y verificables en fuente primaria. Terminal-Bench Science del 22,4 % al 64,6 %, SRE-Bench en el primer intento del 55,9 % al 88,0 %, ScreenSpot-Pro del 76,9 % al 92,7 %, recuperación MRCR de 8 agujas en el tramo 512K–1M del 73,8 % al 96,3 %: todo frente a GPT-5.6 Sol y todo procedente de las tablas publicadas por OpenAI.
- La ganancia de velocidad puede importar más que cualquier puntuación. En OSWorld 2.0, Astra logra un 72,6 % en unos 40 minutos por tarea, frente al 65,7 % en unos 75 de Sol: alrededor de un 47 % menos de tiempo.
- El agregado general apenas se movió. En el único índice comparativo entre proveedores que la propia OpenAI imprimió, Astra está +0,3 sobre Sol y −4,5 frente a Claude Fable 5.1. Y pierde la única fila académica que reporta frente a los tres Claude: Humanity's Last Exam con herramientas, 57,2 % frente a 65,0 %.
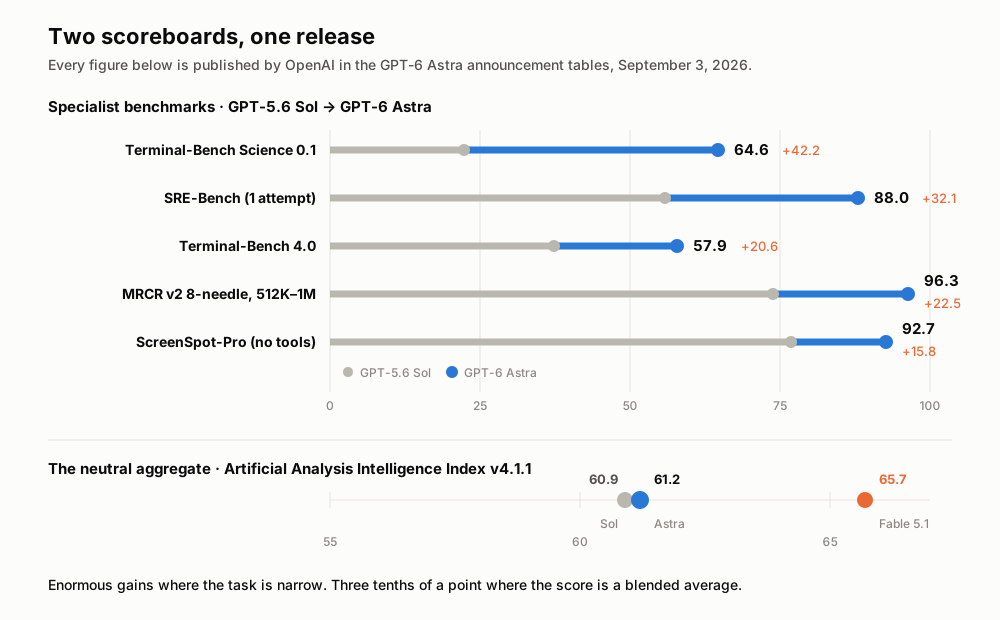
Todas las cifras proceden de las propias tablas de anuncio de OpenAI. Fuentes al final.
La ficha técnica, sin adjetivos
Las especificaciones del modelo que siguen proceden de la página para desarrolladores de OpenAI para gpt-6-astra, consultada el 5 de septiembre de 2026.
| GPT-6 Astra | |
|---|---|
| ID del modelo en la API | gpt-6-astra |
| Lanzamiento | 3 de septiembre de 2026 |
| Ventana de contexto | 1.050.000 tokens |
| Salida máxima | 128.000 tokens |
| Corte de conocimiento | 30 de abril de 2026 |
| Modalidades de entrada | Texto, imagen |
| Modalidades de salida | Texto |
| Niveles de razonamiento | low, medium, high, xhigh, max |
| Precio por millón de tokens de entrada | 10,00 $ |
| Precio por millón de tokens de entrada en caché | 1,00 $ |
| Precio por millón de tokens de salida | 50,00 $ |
| Disponibilidad | ChatGPT Plus, Pro, Business, Enterprise; API de OpenAI; Microsoft Azure; AWS Bedrock |
Tres detalles determinan las decisiones prácticas sobre costes e integración.
Las peticiones por encima de 272.000 tokens de entrada se facturan al doble de las tarifas de entrada y caché y a 1,5 veces la de salida, para la petición completa. Es decir, la ventana de un millón de tokens tiene un acantilado en medio, no una tarifa plana. El procesamiento Batch y Flex cuesta el 50 % del estándar; el modo Fast cuesta el doble por hasta el doble de velocidad, sin SLA de latencia.
Las llamadas a herramientas requieren la API de Responses. Chat Completions sigue funcionando para generación simple, pero temperature, top_p y top_logprobs han desaparecido por completo. Si está migrando un pipeline que ajusta el muestreo, ese ajuste ya no existe.
Astra acepta texto e imágenes y genera texto; no acepta audio.
El titular real es el uso del ordenador, y la cifra real es el reloj
El encuadre de OpenAI es que Astra «marca una nueva frontera en el uso del ordenador y del navegador». Aquí la evidencia sostiene el adjetivo.
En OSWorld 2.0 —tareas de escritorio como navegar por aplicaciones, mover archivos o rellenar formularios— Astra obtiene un 72,6 % frente al 65,7 % de Sol. Son 6,9 puntos respetables. La cifra interesante está al lado: en la simulación de latencia de OpenAI, Astra terminó la tarea media en unos 40 minutos donde Sol tardaba unos 75, una reducción de alrededor del 47 %.
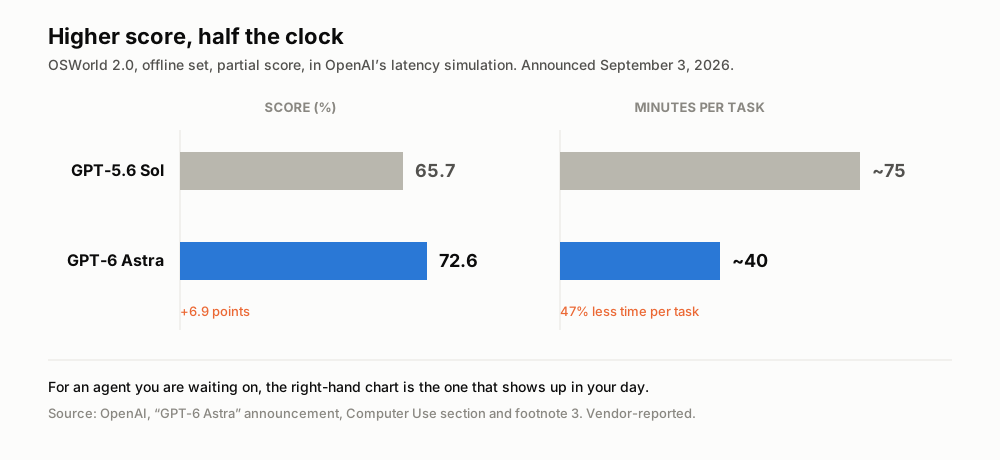
La puntuación a la izquierda, el reloj a la derecha. Fuente: anuncio de GPT-6 Astra de OpenAI, sección Computer Use.
Aquí está la clave: para un modelo al que delegas trabajo y luego esperas, el tiempo por tarea es la métrica que aparece en tu jornada y en tu factura. Siete puntos más de precisión son un resultado de evaluación. Reducir la espera a la mitad es otro producto.
El resto del bloque es coherente. ScreenSpot-Pro, que evalúa si un modelo encuentra y pulsa el píxel correcto en una interfaz densa, pasa del 76,9 % al 92,7 % sin herramientas. Agents' Last Exam —tareas profesionales complejas en software real, desde modelización financiera hasta producción audiovisual— alcanza el 59,3 %, frente al 55,5 % de Claude Opus 5 y el 53,6 % de Sol, y OpenAI señala que Astra usó para ello alrededor de un 65 % menos de tokens de salida que Opus 5. En el benchmark de navegador Mind2Web, con un harness de Codex actualizado, OpenAI reporta una finalización de tareas 1,9 veces más rápida que la configuración actual de Sol.
El resultado de 1,9x en Mind2Web mide el harness actualizado de Codex junto con Astra, no el modelo por sí solo. Describe la velocidad de esa configuración combinada.
Qué muestran realmente las demos
La página de anuncio de OpenAI incluye grabaciones de pantalla que muestran qué significa «uso del ordenador» en la práctica. Los clips mostrados son extractos editados; sus tiempos corresponden a las ejecuciones de demostración, según indica OpenAI en la nota al pie 4.
Las demostraciones abarcan cuatro tipos de trabajo:
- Trazado de PCB en KiCad: una reproducción condensada de 15 segundos en la que Astra convierte un esquema electrónico en una placa fabricable, colocando componentes y trazando las pistas de cobre. El trazado es normalmente trabajo manual y un cuello de botella habitual en el diseño electrónico.
- De Blender a Unreal Engine 5: modelar una casa y convertirla en una escena transitable, un traspaso que suele costar un día de diseño.
- Una presentación a partir de una plantilla: se le dan a Astra unas pocas diapositivas de la plantilla de presentaciones de OpenAI y se le pide un deck sobre un modelo ficticio, respetando tono y maquetación. La demo más relevante para el trabajo de oficina y la menos vistosa.
- Navegación en software de genómica: inspeccionar la calidad de secuenciación y visualizar la variación genética dentro de herramientas científicas especializadas.
OpenAI publicó además una comparación estática que ilustra un cambio de comportamiento y no una puntuación: cuando las instrucciones dejan margen de interpretación, Astra hace una pregunta concreta en lugar de adivinar.
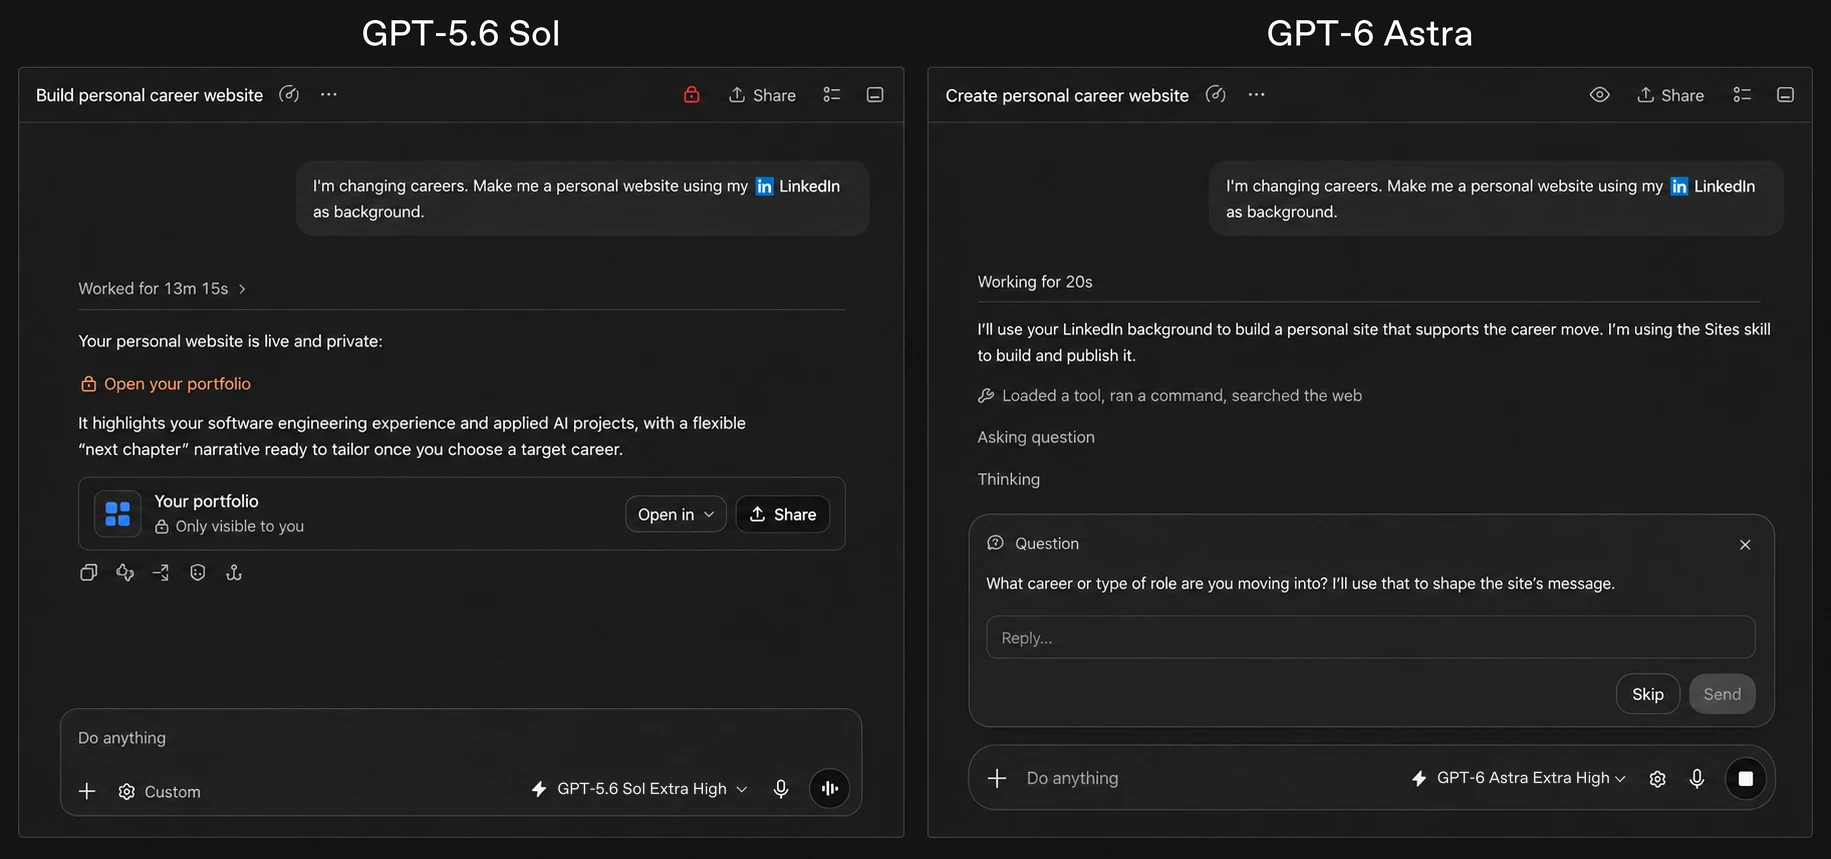
Crédito de imagen: OpenAI, «GPT-6 Astra: A new generation of intelligence», 3 de septiembre de 2026. Este ejemplo del proveedor muestra a Astra preguntando cuando una respuesta podría cambiar el resultado y continuando cuando no.
El extremo lejano de la ventana de contexto dejó de derrumbarse
Para trabajar con documentos largos, el resultado clave es la recuperación de información cerca del extremo de la ventana de contexto.
GPT-5.6 Sol y Astra tienen una ventana de contexto de 1.050.000 tokens. La mejora que OpenAI atribuye a Astra es la calidad de recuperación en las partes más profundas de esa ventana, no un límite anunciado mayor.
En la prueba MRCR v2 de 8 agujas de OpenAI, Astra obtiene un 100,0 % en el tramo 256K–512K frente al 91,5 % de Sol, y mantiene un 96,3 % en el tramo 512K–1M donde Sol cae al 73,8 %. Una diferencia de 22,5 puntos en la parte alta de la ventana es la distancia entre una especificación y una función.
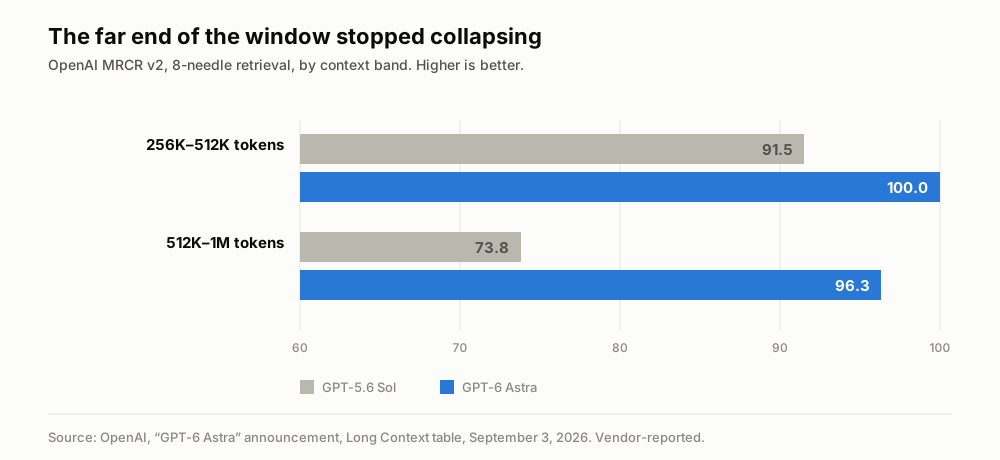
Cifras declaradas por el proveedor, de la tabla Long Context de OpenAI. La salvedad: MRCR es un benchmark propio de OpenAI.
En paralelo, Codex incorpora un mecanismo experimental en el que Astra mantiene notas entre ventanas de contexto en lugar de comprimir una sesión larga en un único resumen con pérdidas, dejando además las ventanas anteriores consultables. OpenAI afirma que será el comportamiento por defecto de Astra en cuestión de semanas. La pérdida por compactación —olvidar por qué falló una corrección hace tres horas— es el modo de fallo más común en sesiones largas de agente, así que es una corrección dirigida a un problema real.
Los mayores saltos del lanzamiento se dieron en terminal y trabajo científico
Entre las comparaciones con GPT-5.6 Sol, las mayores mejoras se concentran en agentes que operan un terminal.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22,4 % | 64,6 % | 52,6 % |
| SRE-Bench (1 intento) | 55,9 % | 88,0 % | – |
| Terminal-Bench 4.0 | 37,3 % | 57,9 % | 55,8 % |
| AutomationBench | 18,1 % | 41,4 % | 31,4 % |
| Tareas internas de migración de bases de datos | 42,7 % | 63,9 % | 57,8 % |
| FrontierMath Tier 4 (v2) | 83,0 % | 97,6 % | 87,8 % |
| GPQA Diamond | 94,6 % | 96,0 % | 93,7 % |
| Humanity's Last Exam (con herramientas) | – | 57,2 % | 65,0 % |
Terminal-Bench Science casi se triplicó. SRE-Bench —ingeniería inversa de binarios compilados sin acceso al código fuente— pasó del 55,9 % al 88,0 % en el primer intento, y al 99,2 % en cuatro. AutomationBench se ha más que duplicado. No son mejoras del orden del redondeo, y se agrupan estrechamente en torno a una sola descripción: un agente que maneja herramientas a lo largo de muchos pasos sin perder el hilo.
En matemáticas, OpenAI reporta dos resultados nuevos sobre huecos entre números primos, con demostraciones publicadas en PDF. Astra ayudó a establecer que existen infinitos pares de primos separados como máximo por 186, mejorando una cota de 240 fijada recientemente por Julia Stadlmann, que a su vez mejoraba el 246 vigente durante más de una década. Un segundo resultado mejoró un término de una cota sobre huecos grandes entre primos que llevaba más de 80 años inalterado. Son artefactos comprobables y no filas de una tabla, lo que los convierte en las afirmaciones más duraderas de todo el anuncio.
Dónde el marketing se adelanta a la evidencia
Los resultados apuntan a un lanzamiento importante cuyas mejoras se concentran en flujos de trabajo específicos, no en el rendimiento general de los benchmarks.
El agregado neutral está plano. Artificial Analysis Intelligence Index v4.1.1, impreso en la propia tabla Professional de OpenAI: Astra 61,2, Sol 60,9, Fable 5.1 65,7, Opus 5 63,1. En el Coding Agent Index v1.4, también en la tabla de OpenAI, Astra saca 67,0 frente al 68,1 de Opus 5 y el 67,2 de Fable 5. Un modelo que empata con su predecesor en el compuesto no es un salto generacional de capacidad general, diga lo que diga el anuncio. Con la metodología v4.2 actual de Artificial Analysis, consultada el 5 de septiembre de 2026, la forma del ranking no cambia: Fable 5.1 en 56,8, Astra en 54,7, Opus 5 en 54,1.
«Satura» está haciendo mucho trabajo. El 99,9 % en ARC-AGI-3 es real, y la nota 1 de OpenAI indica que se ejecutó con un harness de la API de Responses «que cambia dos ajustes para acercarse mejor al rendimiento del mundo real». Una llamada normal y sin estado a la API no es ese harness. Trate el 99,9 % como un techo en una configuración afinada, no como el comportamiento de su integración.
FrontierMath no es un árbitro neutral. Epoch AI, que lo opera, ha revelado que OpenAI financió su desarrollo y tiene acceso exclusivo a una parte. El 97,6 % es impresionante; independiente no lo es.
El 100 % de ExploitBench también lleva nota. La propia observación de OpenAI sobre la versión actualizada de junio a agosto de 2026 dice que algunas vulnerabilidades incluidas podrían no permitir ejecución de código arbitrario bajo las restricciones de la evaluación, una frase que complica en voz baja lo que significa una puntuación perfecta en el original.
Cada puntuación de titular es el mejor caso. OpenAI declara con claridad que las puntuaciones de evaluación son el máximo en cualquier nivel de esfuerzo. Con esfuerzo max, Artificial Analysis mide un tiempo hasta el primer token de 463,7 segundos —casi ocho minutos antes de la primera palabra— frente a una mediana de 3,86 segundos entre modelos de razonamiento de la misma franja de precio. Después, la salida corre a 87,5 tokens por segundo, por encima de esa mediana. Las cifras de titular y una aplicación con buena capacidad de respuesta no son la misma configuración.
Según las tarifas publicadas el 5 de septiembre, Astra costaba 2,5 veces más por token. La página del modelo GPT-5.6 Sol indicaba 4,00 $ por millón de tokens de entrada y 20,00 $ por millón de salida; Astra indicaba 10,00 $ y 50,00 $. La tarifa de Sol era promocional y se anunciaba como disponible al menos hasta el 21 de noviembre de 2026. El precio por token no equivale al coste por tarea: Artificial Analysis midió 2,57 $ para ejecutar su Intelligence Index completo con Astra, frente a 6,12 $ con Fable 5.1 y 4,21 $ con Opus 5. Antes de decidir una compra, conviene comprobar estas tarifas y costes de benchmark fechados frente a los precios actuales.
Y es más transparente en algunos aspectos y menos en otros. La system card reporta que Astra comete bastantes menos errores factuales que Sol, que nunca intentó eludir una denegación del Auto-Review de Codex en pruebas internas y que se salió del objetivo autorizado en el 0 % de los casos de una evaluación de exceso de alcance, donde Sol sin salvaguardas lo hacía en el 48 %. El mismo documento reporta que el razonamiento escrito de Astra es más difícil de supervisar que el de Sol, algo que OpenAI atribuye a cadenas de pensamiento más cortas y dice tomarse en serio. Ambas cosas pertenecen al mismo párrafo.
Cómo leer las afirmaciones sin un resultado público comparable
Varias afirmaciones de la cobertura no cuentan con un resultado publicado de Astra que los lectores puedan comparar directamente.
Algunas publicaciones secundarias afirman que Astra retrocedió en GDPval, el uso de herramientas bancarias, el razonamiento con documentos largos o la calidad de presentaciones en pruebas de agentes de largo plazo. El anuncio de OpenAI no incluye un resultado de GDPval, y aquí no se cita ninguna cifra publicada de Astra ni una ejecución independiente completada. Por tanto, el resultado no está disponible para compararlo; que falte una puntuación no demuestra un retroceso. GDPval está diseñado en torno al trabajo de valor económico en distintas ocupaciones.
OpenAI afirma que Astra descubrió dos vulnerabilidades de día cero hasta entonces desconocidas durante una evaluación interna y que las está comunicando a sus responsables de mantenimiento. El anuncio no identifica las vulnerabilidades ni ofrece confirmación independiente.
Al 5 de septiembre de 2026, OpenAI mencionaba «GPT-6 Astra Pro» para los planes Pro, Business y Enterprise, pero no había publicado precios, benchmarks ni una ficha de modelo por separado. Por tanto, sus especificaciones no podían compararse de forma independiente en esa fecha.
El benchmark interno de alucinaciones registra un 4,2 % para Astra y un 12,2 % para Sol. OpenAI explica que utiliza conversaciones de ChatGPT desidentificadas que los usuarios señalaron por contener errores factuales y que las tasas absolutas están infladas por diseño; estas cifras no deben interpretarse como tasas de alucinación en producción ni trasladarse a otras cargas de trabajo.
El modelo de frontera sigue sin poder oír
Para los equipos cuyo trabajo empieza con voz, una especificación marca el límite de lo que Astra puede hacer directamente.
Las modalidades de entrada de GPT-6 Astra son texto e imagen. Su modalidad de salida es texto. El modelo más capaz que OpenAI ha lanzado nunca —una ventana de un millón de tokens, un 47 % más rápido conduciendo un escritorio, un 96,3 % de recuperación en la parte alta de su contexto— no tiene oídos.
No es un descuido, es arquitectura. Los modelos de razonamiento de frontera y los modelos de voz son líneas de producto separadas, y el trabajo con audio sigue pasando por una etapa de transcripción antes de que un modelo de razonamiento vea nada. Lo que significa que la calidad de todo lo que Astra puede hacer con una conversación está limitada aguas arriba, por lo que haya convertido esa conversación en tokens. Si la transcripción fundió a dos hablantes, o perdió el tramo en tailandés de una reunión bilingüe, o se dejó noventa segundos cuando la conexión falló, entonces una ventana de contexto de un millón de tokens es un recipiente muy grande para una entrada defectuosa.
Es la capa que los lanzamientos de modelos nunca arreglan y que recibe menos atención con cada nuevo buque insignia. La capa de razonamiento sigue mejorando a un ritmo que se puede dibujar. La capa de captura —grabar una hora sin perder nada, separar hablantes, aguantar una reunión que cambia de idioma a mitad de frase— mejora en una curva completamente distinta y mucho más lenta, y ninguna cantidad de inteligencia de frontera aguas abajo compensa una mala transcripción aguas arriba.
En conclusión: a la frontera le creció un brazo, no una cabeza
GPT-6 Astra es un lanzamiento de brazo largo. Llega mucho más lejos en ciertos tipos de trabajo —manejar un terminal, conducir un escritorio, recuperar en el extremo de un millón de tokens, hacer ingeniería inversa de un binario— mientras que aquello que solemos llamar inteligencia se quedó casi quieto en todas las medidas neutrales disponibles, incluida la que la propia OpenAI imprimió.
No es una decepción. Es incluso una forma más útil que la alternativa, porque la capacidad estrecha llega a producción mucho antes que la general. Pero significa que la pregunta de compra ha cambiado. «¿Es más inteligente?» tiene ahora una respuesta casi carente de sentido. «¿Es mejor en el bucle concreto que ejecuto cuarenta veces al día, y cuánto tarda ese bucle ahora?» tiene una respuesta excelente.
Mire el benchmark que se parezca a su trabajo. Ignore el compuesto. Y mire el reloj, no solo la puntuación.
Dónde encaja Telli.sh: la brecha que este lanzamiento hace visible —un razonamiento brillante apoyado sobre lo que la capa de captura le entregó— es exactamente la brecha en la que construimos. Telli.sh graba la reunión, separa a los hablantes, traduce en directo a 15 idiomas y deja notas que seguirán siendo buscables el trimestre que viene. Enruta transcripción, traducción y resumen a través de una capa de motores intercambiables, de modo que un lanzamiento como Astra llega en forma de mejores notas y no de proyecto de migración. Ningún lanzamiento de modelo de frontera cambia la parte en la que alguien tiene que capturar esa hora en primer lugar.
Empezar una nota traducida en directo
Fuentes
- OpenAI, «GPT-6 Astra: A new generation of intelligence», 3 de septiembre de 2026 — todas las tablas de benchmarks (Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), la simulación de latencia de OSWorld, la cifra de 1,9× en Mind2Web, las notas 1, 3, 4, 8, 9, 10, 11 y 12, la disponibilidad y los resultados sobre huecos entre primos; consultado el 5 de septiembre de 2026
- Documentación para desarrolladores de OpenAI, página del modelo
gpt-6-astra— ventana de contexto, salida máxima, corte de conocimiento, modalidades, niveles dereasoning.efforty precios estándar, de caché y de escritura en caché; consultado el 5 de septiembre de 2026 - Documentación para desarrolladores de OpenAI, guía de migración y prompting «Using GPT-6 Astra» — requisito de la API de Responses para llamadas a herramientas, parámetros de muestreo eliminados y salvedades del modo Fast; consultado el 5 de septiembre de 2026
- System card de GPT-6 Astra, OpenAI Deployment Safety Hub — umbral Critical en ciberseguridad dentro del Preparedness Framework, nivel High en biología y química, por debajo de High en automejora de IA, robustez ante jailbreaks, la evaluación de factualidad y sus límites declarados, y el descenso de supervisabilidad de las cadenas de pensamiento; consultado el 5 de septiembre de 2026
- Artificial Analysis, análisis de inteligencia, rendimiento y precio de GPT-6 Astra — puntuaciones del Intelligence Index v4.2, coste por tarea del Intelligence Index, velocidad de salida de 87,5 tokens por segundo y tiempo hasta el primer token de 463,7 segundos; consultado el 5 de septiembre de 2026
- Vellum, «GPT-6 Astra Benchmarks Explained» — contraste de las tablas de uso del ordenador, académicas y de contexto largo, y el asterisco de Humanity's Last Exam
- Emergent, «GPT-6 Astra Benchmarks: What the Numbers Actually Show» — la salvedad sobre el harness de ARC-AGI-3 y la comparación en el Intelligence Index
- MindStudio, «GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?» — el origen de los retrocesos reportados en GDPval, uso de herramientas bancarias, contexto largo y calidad de presentaciones, que no pudimos verificar en fuente primaria
- Al Jazeera, «OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns», 4 de septiembre de 2026 — fecha del lanzamiento y despliegue por fases
- 9to5Mac, «OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra», 4 de septiembre de 2026 — el orden de despliegue por plan tras el día del lanzamiento
- Nuestro comentario sobre el lanzamiento sigiloso de GLM-5.3-Flash — el otro extremo de la misma curva, donde la capacidad llega barata en lugar de cara