40 Minuten statt 75: Worin GPT-6 Astra wirklich gut ist
OpenAI hat GPT-6 Astra am 3. September 2026 veröffentlicht und es das intelligenteste Modell der Welt genannt. Die eigenen Benchmark-Tabellen erzählen eine präzisere Geschichte: enorme Sprünge bei engen Aufgaben — Terminal-Bench Science von 22,4 % auf 64,6 %, SRE-Bench von 55,9 % auf 88,0 %, OSWorld mit 47 % weniger Zeit pro Aufgabe — auf einem neutralen Gesamtindex, der sich um drei Zehntel bewegt hat. Wo die Gewinne real sind, wo die Fußnoten stehen, und was ein Textmodell mit einer Million Token weiterhin nicht kann.
Am 3. September 2026 hat OpenAI GPT-6 Astra veröffentlicht und es „das intelligenteste und am besten ausgerichtete Modell der Welt" genannt.
Vier Zeilen weiter unten in der eigenen Benchmark-Tabelle steht der Artificial Analysis Intelligence Index v4.1.1: Astra 61,2, GPT-5.6 Sol 60,9, Claude Fable 5.1 65,7. OpenAI hat also selbst die Zahl abgedruckt, bei der das neue Flaggschiff drei Zehntel auf den eigenen Vorgänger gewinnt und 4,5 Punkte auf einen Wettbewerber verliert.
Beides stimmt, und die Spannung zwischen beidem ist die ganze Geschichte. Das ist kein Modell, das allgemein klüger geworden ist. Es ist ein Modell, das bei einer bestimmten Liste von Dingen dramatisch besser geworden ist, und diese Liste lohnt sich genau zu kennen, denn sie deckt sich in beide Richtungen nicht mit der Marketing-Zusammenfassung.
Kurzfassung:
- Die Spezialgewinne sind enorm und aus erster Hand belegbar. Terminal-Bench Science von 22,4 % auf 64,6 %, SRE-Bench im ersten Versuch von 55,9 % auf 88,0 %, ScreenSpot-Pro von 76,9 % auf 92,7 %, MRCR-8-Needle-Abruf im Bereich 512K–1M von 73,8 % auf 96,3 % — alles gegen GPT-5.6 Sol, alles aus OpenAIs veröffentlichten Tabellen.
- Der Geschwindigkeitsgewinn dürfte wichtiger sein als jeder Punktwert. Auf OSWorld 2.0 erreicht Astra 72,6 % in rund 40 Minuten pro Aufgabe, Sol 65,7 % in rund 75 — etwa 47 % weniger Zeit.
- Der allgemeine Gesamtwert hat sich kaum bewegt. Auf dem einzigen herstellerübergreifenden Index, den OpenAI selbst abgedruckt hat, liegt Astra 0,3 über Sol und 4,5 unter Claude Fable 5.1. Und es verliert die einzige akademische Zeile, die es gegen alle drei Claudes berichtet: Humanity's Last Exam mit Werkzeugen, 57,2 % gegen 65,0 %.
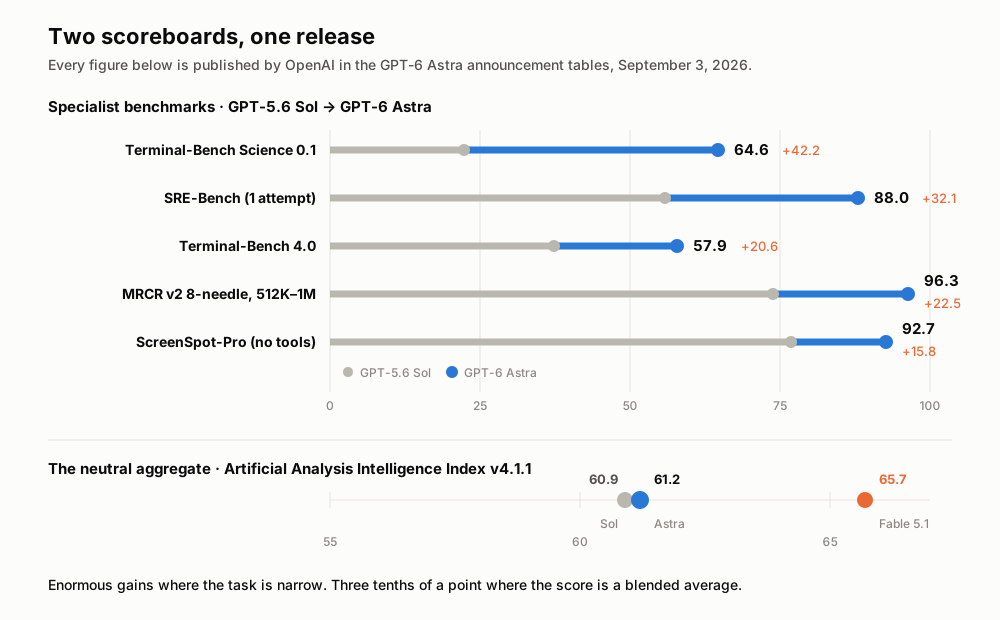
Alle Zahlen stammen aus OpenAIs eigenen Ankündigungstabellen. Quellen am Ende.
Das Datenblatt, ohne Adjektive
Die folgenden Modellspezifikationen stammen von OpenAIs Entwicklerseite zu gpt-6-astra, abgerufen am 5. September 2026.
| GPT-6 Astra | |
|---|---|
| API-Modell-ID | gpt-6-astra |
| Veröffentlicht | 3. September 2026 |
| Kontextfenster | 1.050.000 Token |
| Maximale Ausgabe | 128.000 Token |
| Wissensstand | 30. April 2026 |
| Eingabemodalitäten | Text, Bild |
| Ausgabemodalitäten | Text |
| Reasoning-Stufen | low, medium, high, xhigh, max |
| Preis pro 1 Mio. Eingabe-Token | 10,00 $ |
| Preis pro 1 Mio. zwischengespeicherte Eingabe-Token | 1,00 $ |
| Preis pro 1 Mio. Ausgabe-Token | 50,00 $ |
| Verfügbarkeit | ChatGPT Plus, Pro, Business, Enterprise; OpenAI API; Microsoft Azure; AWS Bedrock |
Drei Details prägen die praktischen Kosten- und Integrationsentscheidungen.
Anfragen mit mehr als 272.000 Eingabe-Token werden für die gesamte Anfrage mit dem doppelten Eingabe- und Cache-Satz und dem 1,5-fachen Ausgabesatz abgerechnet. Das Millionen-Token-Fenster hat also mittendrin eine Kante und keinen einheitlichen Preis. Batch- und Flex-Verarbeitung laufen zu 50 % des Standardtarifs; der Fast-Modus kostet das Doppelte für bis zu doppelte Geschwindigkeit, ohne Latenz-SLA.
Tool-Aufrufe erfordern die Responses API. Für reine Generierung funktioniert Chat Completions weiterhin, aber temperature, top_p und top_logprobs sind vollständig entfallen. Wer eine Pipeline migriert, die Sampling justiert, stellt fest: diese Justierung existiert nicht mehr.
Astra nimmt Text und Bilder entgegen und gibt Text aus; Audio kann es nicht entgegennehmen.
Die eigentliche Schlagzeile ist Computerbedienung, und die eigentliche Zahl ist die Uhr
OpenAIs Formulierung lautet, Astra setze „eine neue Grenze bei der Computer- und Browsernutzung". Hier trägt die Evidenz das Adjektiv.
Auf OSWorld 2.0 — Desktop-Aufgaben wie das Navigieren in Anwendungen, das Verschieben von Dateien, das Ausfüllen von Formularen — erreicht Astra 72,6 % gegenüber 65,7 % für Sol. Das sind respektable 6,9 Punkte. Interessant ist die Zahl daneben: In OpenAIs Latenzsimulation brauchte Astra für die durchschnittliche Aufgabe etwa 40 Minuten, Sol etwa 75 — rund 47 % weniger.
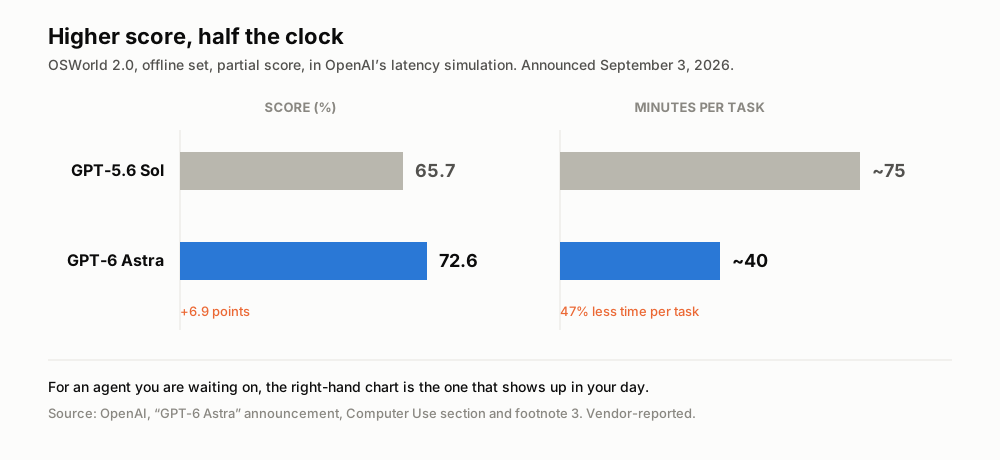
Links der Punktwert, rechts die tatsächliche Uhrzeit. Quelle: OpenAIs GPT-6-Astra-Ankündigung, Abschnitt Computer Use.
Der Punkt ist dieser: Bei einem Modell, dem man Arbeit übergibt und auf das man dann wartet, ist die Zeit pro Aufgabe die Kennzahl, die im Arbeitstag und auf der Rechnung auftaucht. Sieben Punkte mehr Genauigkeit sind ein Evaluationsergebnis. Halbierte Wartezeit ist ein anderes Produkt.
Der Rest des Blocks ist konsistent. ScreenSpot-Pro, das prüft, ob ein Modell in einer dichten Oberfläche das richtige Pixel findet und anklickt, steigt ohne Werkzeuge von 76,9 % auf 92,7 %. Agents' Last Exam — komplexe berufliche Aufgaben in echter Software, von Finanzmodellierung bis Medienproduktion — landet bei 59,3 % gegenüber 55,5 % für Claude Opus 5 und 53,6 % für Sol, wobei OpenAI anmerkt, dass Astra dafür rund 65 % weniger Ausgabe-Token benötigte als Opus 5. Das Mind2Web-Ergebnis von 1,9-mal schneller misst das aktualisierte Codex-Harness zusammen mit Astra, nicht das Modell allein. Es beschreibt die Geschwindigkeit dieser kombinierten Konfiguration.
Genau gelesen ist diese letzte Zahl eine Systemaussage, keine Modellaussage: Harness plus Modell. Es ist trotzdem die Zahl, die Nutzerinnen und Nutzer erleben — deshalb ist sie zitierenswert und deshalb gehört sie beschriftet.
Was die Demos tatsächlich zeigen
OpenAIs Ankündigungsseite enthält Bildschirmaufnahmen, die zeigen, was „Computerbedienung" in der Praxis bedeutet. Die gezeigten Clips sind bearbeitete Ausschnitte; ihre Laufzeiten entsprechen den gemeldeten Zeiten der jeweiligen Demoläufe, wie OpenAI in Fußnote 4 festhält.
Die Demonstrationen zeigen vier unterschiedliche Arten von Arbeit:
- Leiterplatten-Layout in KiCad — eine auf 15 Sekunden verdichtete Wiedergabe, in der Astra einen Schaltplan in eine fertigungsfähige Platine überführt, Bauteile platziert und Kupferbahnen routet. Layout ist normalerweise Handarbeit und ein klassischer Engpass im Elektronikdesign.
- Blender nach Unreal Engine 5 — ein Haus modellieren und in eine begehbare Szene überführen, eine Übergabe, die sonst einen Designtag kostet.
- Eine Präsentation aus einer Vorlage — Astra bekommt einige Folien aus OpenAIs Präsentationsvorlage und soll ein Deck über ein fiktives Modell erstellen, das Ton und Layout trifft. Die für Büroarbeit relevanteste und zugleich unspektakulärste Demo.
- Navigation in Genomik-Software — Sequenzierqualität prüfen und genetische Variation in spezialisierten wissenschaftlichen Werkzeugen visualisieren.
OpenAI hat außerdem einen statischen Direktvergleich veröffentlicht, der eine Verhaltensänderung statt eines Punktwerts zeigt: Wenn Anweisungen Interpretationsspielraum lassen, stellt Astra eine gezielte Rückfrage, statt zu raten.
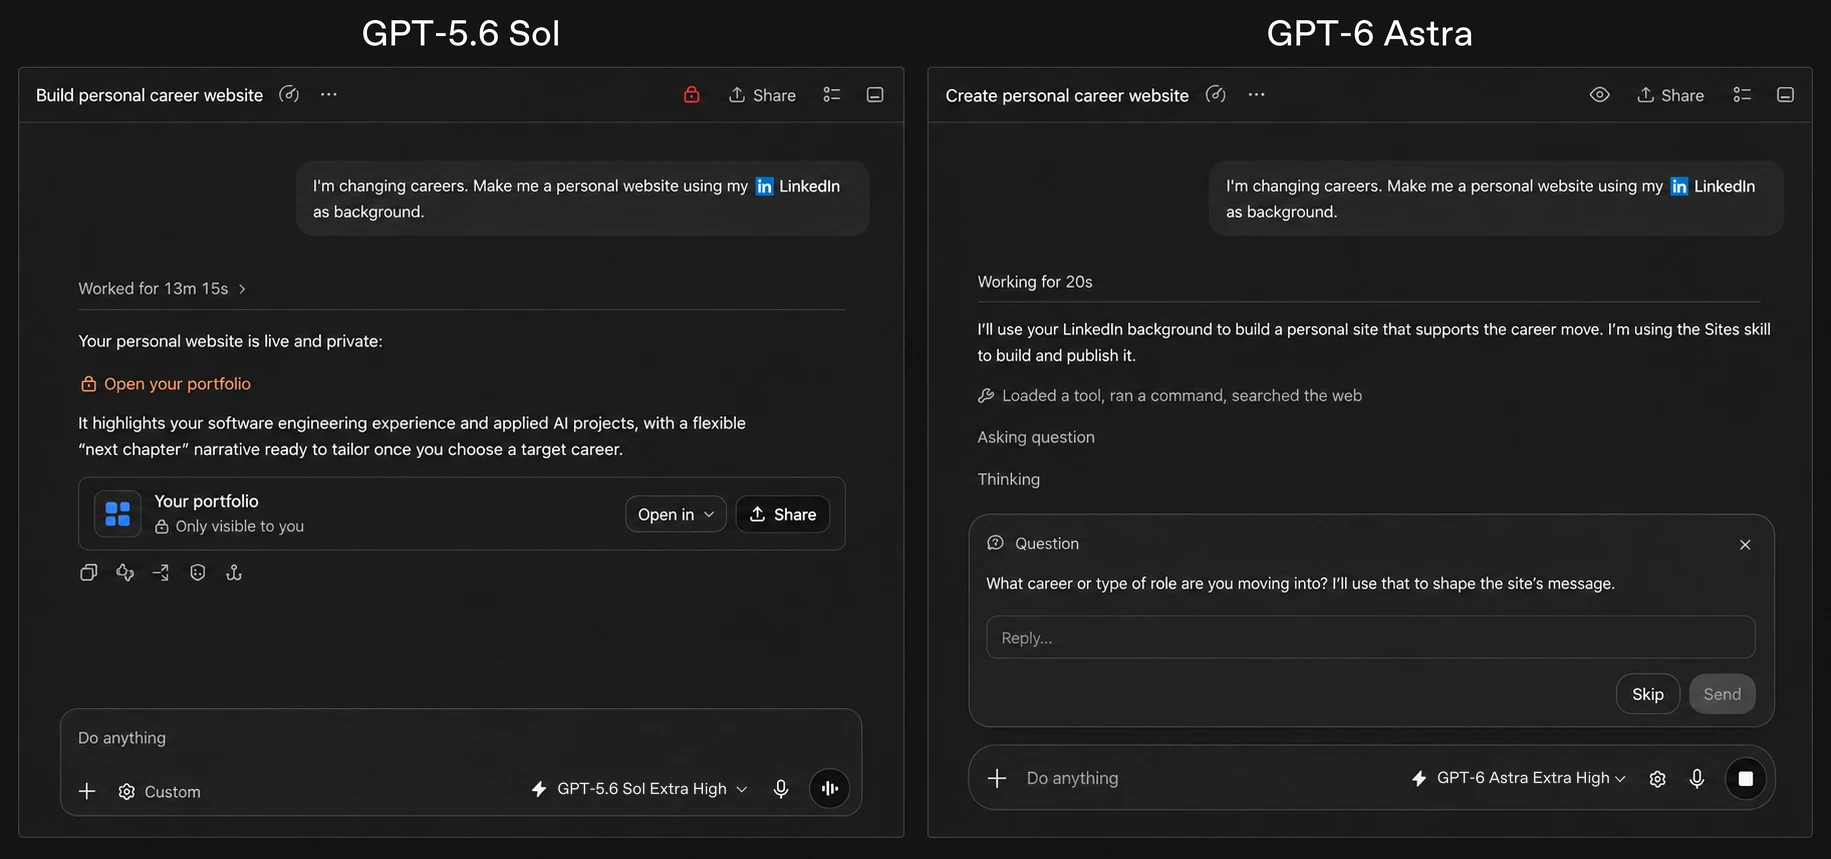
Bildnachweis: OpenAI, "GPT-6 Astra: A new generation of intelligence", 3. September 2026. Dieses Herstellerbeispiel zeigt Astra beim Nachfragen, wenn eine Antwort das Ergebnis ändern könnte, und beim Fortfahren, wenn nicht.
Der Abruf am äußersten Ende des Kontextfensters hat sich verbessert
Für die Arbeit mit langen Dokumenten ist der entscheidende Befund die Qualität des Abrufs nahe dem äußersten Ende des Kontextfensters.
GPT-5.6 Sol und Astra haben beide ein Kontextfenster von 1.050.000 Token. Astras gemeldete Verbesserung betrifft den Abruf weit hinten in diesem Fenster, nicht eine größere beworbene Grenze.
In OpenAIs MRCR-v2-8-Needle-Test erreicht Astra 100,0 % im Bereich 256K–512K gegenüber 91,5 % für Sol und hält 96,3 % im Bereich 512K–1M, wo Sol auf 73,8 % fällt. 22,5 Punkte Abstand am oberen Ende des Fensters sind der Unterschied zwischen einer Spezifikation und einer Funktion.
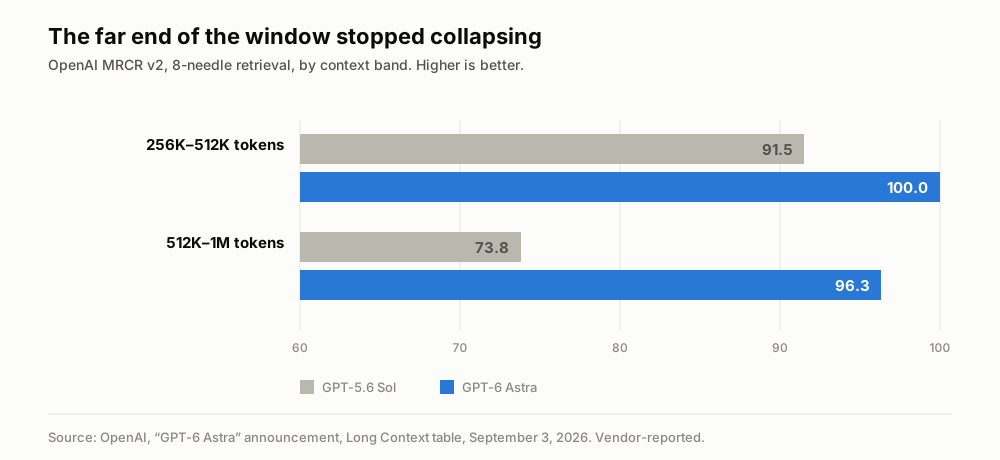
Herstellerangaben aus OpenAIs Long-Context-Tabelle. Der Vorbehalt: MRCR ist OpenAIs eigener Benchmark.
Dazu passend erhält Codex einen experimentellen Mechanismus, bei dem Astra Notizen über Kontextfenster hinweg führt, statt eine lange Sitzung in eine verlustbehaftete Zusammenfassung zu pressen; frühere Fenster bleiben durchsuchbar. OpenAI kündigt an, dass dies binnen Wochen der Standard für Astra wird. Kompaktierungsverlust — vergessen, warum ein Fix vor drei Stunden fehlschlug — ist der häufigste Fehlermodus in langen Agentensitzungen. Das ist also eine gezielte Korrektur eines realen Problems.
Die größten Sprünge dieser Veröffentlichung liegen bei Terminal- und Wissenschaftsarbeit
Unter den Vergleichen mit GPT-5.6 Sol häufen sich die größten Zugewinne bei Agenten, die ein Terminal bedienen.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22,4 % | 64,6 % | 52,6 % |
| SRE-Bench (1 Versuch) | 55,9 % | 88,0 % | – |
| Terminal-Bench 4.0 | 37,3 % | 57,9 % | 55,8 % |
| AutomationBench | 18,1 % | 41,4 % | 31,4 % |
| Interne Datenbankmigrationsaufgaben | 42,7 % | 63,9 % | 57,8 % |
| FrontierMath Tier 4 (v2) | 83,0 % | 97,6 % | 87,8 % |
| GPQA Diamond | 94,6 % | 96,0 % | 93,7 % |
| Humanity's Last Exam (mit Werkzeugen) | – | 57,2 % | 65,0 % |
Terminal-Bench Science hat sich nahezu verdreifacht. SRE-Bench — kompilierte Binärdateien ohne Quellcode rückentwickeln — stieg im ersten Versuch von 55,9 % auf 88,0 % und auf 99,2 % innerhalb von vier Versuchen. AutomationBench hat sich mehr als verdoppelt. Das sind keine Verbesserungen im Rundungsbereich, und sie gruppieren sich eng um eine einzige Beschreibung: ein Agent, der Werkzeuge über viele Schritte bedient, ohne den Faden zu verlieren.
In der Mathematik meldet OpenAI zwei neue Ergebnisse zu Primzahllücken, mit Beweisen als PDF. Astra half zu zeigen, dass unendlich viele Primzahlpaare höchstens 186 auseinanderliegen — eine Verbesserung gegenüber der Schranke 240, die Julia Stadlmann kürzlich aufgestellt hatte und die ihrerseits die über ein Jahrzehnt gültige 246 verbessert hatte. Ein zweites Ergebnis verbesserte einen Term in einer Schranke für große Primzahllücken, der seit über 80 Jahren unverändert war. Das sind überprüfbare Artefakte statt Benchmark-Zeilen, was sie zu den haltbarsten Aussagen der gesamten Ankündigung macht.
Wo das Marketing der Evidenz davonläuft
Die Ergebnisse deuten auf ein wichtiges Release hin, dessen Zugewinne sich auf bestimmte Arbeitsabläufe statt auf allgemeine Benchmark-Leistung konzentrieren.
Der neutrale Gesamtwert ist flach. Artificial Analysis Intelligence Index v4.1.1, abgedruckt in OpenAIs eigener Professional-Tabelle: Astra 61,2, Sol 60,9, Fable 5.1 65,7, Opus 5 63,1. Beim Coding Agent Index v1.4, ebenfalls in OpenAIs Tabelle, erreicht Astra 67,0 gegenüber 68,1 für Opus 5 und 67,2 für Fable 5. Ein Modell, das beim Gesamtwert mit seinem Vorgänger gleichzieht, ist kein Generationssprung in allgemeiner Fähigkeit, was auch immer der Blogbeitrag sagt. Nach der aktuellen v4.2-Methodik von Artificial Analysis, abgerufen am 5. September 2026, ist die Form der Rangliste unverändert: Fable 5.1 bei 56,8, Astra bei 54,7, Opus 5 bei 54,1.
„Sättigt" trägt hier viel Gewicht. Die 99,9 % auf ARC-AGI-3 sind echt, und OpenAIs Fußnote 1 hält fest, dass der Lauf mit einem Responses-API-Harness erfolgte, „das zwei Einstellungen ändert, um der realen Leistung besser zu entsprechen". Ein einfacher zustandsloser API-Aufruf ist dieses Harness nicht. Behandeln Sie 99,9 % als Obergrenze unter optimierter Konfiguration, nicht als Verhalten Ihrer Integration.
FrontierMath ist kein neutraler Schiedsrichter. Epoch AI, das den Benchmark betreibt, hat offengelegt, dass OpenAI seine Entwicklung finanziert hat und exklusiven Zugang zu einem Teil davon besitzt. Die 97,6 % sind beeindruckend; unabhängig sind sie nicht.
Auch die 100 % auf ExploitBench haben eine Fußnote. OpenAIs eigene Anmerkung zur aufgefrischten Portierung von Juni bis August 2026 hält fest, dass einige der enthaltenen Schwachstellen unter den Bedingungen der Evaluation möglicherweise keine beliebige Codeausführung zulassen — ein Satz, der stillschweigend verkompliziert, was ein perfekter Wert im Original bedeutet.
Jeder Schlagzeilenwert ist ein Bestfall. OpenAI stellt ausdrücklich fest, dass die Evaluationswerte das Maximum über alle Reasoning-Stufen sind. Bei max misst Artificial Analysis eine Zeit bis zum ersten Token von 463,7 Sekunden — knapp acht Minuten bis zum ersten Wort — gegenüber einem Median von 3,86 Sekunden bei Reasoning-Modellen derselben Preisklasse. Danach läuft die Ausgabe mit 87,5 Token pro Sekunde und liegt damit über diesem Median. Die Schlagzeilenzahlen und eine reaktionsschnelle Anwendung sind nicht dieselbe Konfiguration.
Zu den am 5. September veröffentlichten Preisen kostete Astra pro Token das 2,5-Fache. Die Modellseite von GPT-5.6 Sol nannte 4,00 $ pro Million Eingabe- und 20,00 $ pro Million Ausgabe-Token; für Astra waren es 10,00 $ und 50,00 $. Sols Tarif war ein Aktionspreis, der laut Angabe mindestens bis zum 21. November 2026 gelten sollte. Der Tokenpreis ist nicht mit den Kosten pro Aufgabe gleichzusetzen: Artificial Analysis maß für den vollständigen Intelligence Index 2,57 $ bei Astra gegenüber 6,12 $ bei Fable 5.1 und 4,21 $ bei Opus 5. Diese datierten Tarife und Benchmark-Kosten sollten vor einer Kaufentscheidung mit den aktuellen Preisen abgeglichen werden.
Und in mancher Hinsicht ist es transparenter, in anderer weniger. Die System Card berichtet, dass Astra deutlich weniger Faktenfehler macht als Sol, in internen Tests nie versucht hat, eine Ablehnung des Codex Auto-Review zu umgehen, und in einer Evaluation zur Kompetenzüberschreitung in 0 % der Fälle über das autorisierte Ziel hinausging, wo Sol ohne Schutzmaßnahmen dies in 48 % der Fälle tat. Dasselbe Dokument berichtet, dass Astras aufgeschriebenes Reasoning schwerer zu überwachen ist als das von Sol; OpenAI führt das auf kürzere Gedankenketten zurück und nimmt es nach eigener Aussage ernst. Beides gehört in denselben Absatz.
So sind Aussagen ohne vergleichbares öffentliches Ergebnis einzuordnen
Für mehrere in der Berichterstattung erhobene Behauptungen gibt es kein veröffentlichtes Astra-Ergebnis, das Leser direkt vergleichen könnten.
Einige Sekundärberichte behaupten, Astra habe bei GDPval, der Nutzung von Bankwerkzeugen, beim Schlussfolgern über lange Dokumente oder bei der Qualität von Präsentationen in langlaufenden Agententests Rückschritte gemacht. OpenAIs Ankündigung enthält kein GDPval-Ergebnis, und hier wird weder ein veröffentlichter Astra-GDPval-Wert noch ein abgeschlossener unabhängiger Lauf angeführt. Damit steht kein Ergebnis zum Vergleich bereit; ein fehlender Wert belegt keinen Rückgang. GDPval ist auf wirtschaftlich wertvolle Arbeit über verschiedene Berufe hinweg ausgelegt.
OpenAI zufolge entdeckte Astra während interner Evaluationen zwei zuvor unbekannte Zero-Day-Schwachstellen; das Unternehmen sagt, es lege sie den zuständigen Maintainer-Teams offen. Die Ankündigung benennt die Schwachstellen nicht und enthält keine unabhängige Bestätigung.
Zum 5. September 2026 erwähnte OpenAI „GPT-6 Astra Pro" für Pro-, Business- und Enterprise-Pläne, hatte aber weder separate Preise noch Benchmarks oder eine Model Card veröffentlicht. Seine Spezifikationen ließen sich daher zu diesem Zeitpunkt nicht unabhängig vergleichen.
Der interne Halluzinations-Benchmark weist 4,2 % für Astra und 12,2 % für Sol aus. OpenAI zufolge basiert er auf anonymisierten ChatGPT-Konversationen, die Nutzer wegen sachlicher Fehler markiert hatten; die absoluten Raten seien methodisch bedingt überhöht. Diese Werte sollten weder als Halluzinationsraten im Produktivbetrieb gelesen noch auf andere Arbeitslasten übertragen werden.
Das Frontier-Modell kann immer noch nicht hören
Für Teams, deren Arbeit mit Sprache beginnt, setzt eine Spezifikation die Grenze dessen, was Astra direkt leisten kann.
Die Eingabemodalitäten von GPT-6 Astra sind Text und Bild. Die Ausgabemodalität ist Text. Das leistungsfähigste Modell, das OpenAI je ausgeliefert hat — ein Fenster von einer Million Token, 47 % schneller beim Bedienen eines Desktops, 96,3 % Abruf am oberen Ende seines Kontexts — hat keine Ohren.
Das ist kein Versehen, sondern Architektur. Frontier-Reasoning-Modelle und Sprachmodelle sind getrennte Produktlinien, und Audioarbeit läuft weiterhin durch eine Transkriptionsstufe, bevor ein Reasoning-Modell überhaupt etwas sieht. Damit ist die Qualität von allem, was Astra mit einem Gespräch anstellen kann, stromaufwärts gedeckelt — durch das, was dieses Gespräch in Token verwandelt hat. Wenn das Transkript zwei Sprecher verschmolzen, den thailändischen Abschnitt einer zweisprachigen Besprechung verloren oder neunzig Sekunden bei schwankender Verbindung verschluckt hat, dann ist ein Kontextfenster von einer Million Token ein sehr großer Behälter für eine fehlerhafte Eingabe.
Das ist die Ebene, die Modellveröffentlichungen nie reparieren und die mit jedem neuen Flaggschiff weniger Aufmerksamkeit bekommt. Die Reasoning-Ebene wird weiter besser, in einem Tempo, das sich zeichnen lässt. Die Aufnahmeebene — eine Stunde aufzeichnen, ohne etwas zu verlieren, Sprecher auseinanderhalten, eine Besprechung bewältigen, die mitten im Satz die Sprache wechselt — verbessert sich auf einer völlig anderen und deutlich flacheren Kurve, und keine noch so hohe Intelligenz stromabwärts gleicht ein schlechtes Transkript stromaufwärts aus.
Fazit: Die Grenze hat einen Arm bekommen, keinen Kopf
GPT-6 Astra ist eine Veröffentlichung mit langem Arm. Sie greift deutlich weiter in bestimmte Arten von Arbeit hinein — ein Terminal bedienen, einen Desktop steuern, am äußeren Ende von einer Million Token abrufen, eine Binärdatei rückentwickeln — während das, was wir gemeinhin Intelligenz nennen, auf jedem verfügbaren neutralen Maß nahezu stillstand, einschließlich desjenigen, das OpenAI selbst abgedruckt hat.
Das ist keine Enttäuschung. Es ist sogar die nützlichere Form, denn enge Fähigkeit kommt schneller in der Produktion an als allgemeine. Aber es bedeutet, dass sich die Kauffrage geändert hat. „Ist es klüger?" hat jetzt eine nahezu bedeutungslose Antwort. „Ist es besser in genau der Schleife, die ich vierzigmal am Tag durchlaufe, und wie lange dauert diese Schleife jetzt?" hat eine sehr gute.
Prüfen Sie den Benchmark, der Ihrer Arbeit ähnelt. Ignorieren Sie den Gesamtwert. Und schauen Sie auf die Uhr, nicht nur auf den Punktwert.
Wo Telli.sh hineinpasst: Die Lücke, die diese Veröffentlichung sichtbar macht — brillantes Reasoning, das auf dem sitzt, was die Aufnahmeebene ihm gereicht hat — ist genau die Lücke, in der wir bauen. Telli.sh zeichnet die Besprechung auf, hält Sprecher auseinander, übersetzt live in 15 Sprachen und macht daraus Notizen, die im nächsten Quartal noch durchsuchbar sind. Transkription, Übersetzung und Zusammenfassung laufen über eine austauschbare Engine-Schicht, sodass eine Veröffentlichung wie Astra als bessere Notizen ankommt und nicht als Migrationsprojekt. Keine Frontier-Modellveröffentlichung ändert den Teil, in dem jemand diese Stunde überhaupt erst einfangen muss.
Quellen
- OpenAI, „GPT-6 Astra: A new generation of intelligence", 3. September 2026 — sämtliche Benchmark-Tabellen (Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), die OSWorld-Latenzsimulation, die Mind2Web-1,9-fach-Angabe, die Fußnoten 1, 3, 4, 8, 9, 10, 11 und 12, Verfügbarkeit sowie die Ergebnisse zu Primzahllücken; abgerufen am 5. September 2026
- OpenAI Entwicklerdokumentation, Modellseite
gpt-6-astra— Kontextfenster, maximale Ausgabe, Wissensstand, Modalitäten,reasoning.effort-Stufen sowie Standard-, Cache- und Cache-Write-Preise; abgerufen am 5. September 2026 - OpenAI Entwicklerdokumentation, „Using GPT-6 Astra" Migrations- und Prompting-Leitfaden — Responses-API-Pflicht für Tool-Aufrufe, entfallene Sampling-Parameter, Vorbehalte zum Fast-Modus; abgerufen am 5. September 2026
- GPT-6 Astra System Card, OpenAI Deployment Safety Hub — kritische Cybersicherheitsschwelle im Preparedness Framework, Stufe High bei Biologie und Chemie, unterhalb von High bei KI-Selbstverbesserung, Jailbreak-Robustheit, die Faktizitätsevaluation und ihre erklärten Grenzen sowie der Rückgang der Überwachbarkeit von Gedankenketten; abgerufen am 5. September 2026
- Artificial Analysis, Analyse zu Intelligenz, Leistung und Preis von GPT-6 Astra — Werte des Intelligence Index v4.2, Kosten pro Intelligence-Index-Aufgabe, Ausgabegeschwindigkeit von 87,5 Token pro Sekunde und Zeit bis zum ersten Token von 463,7 Sekunden; abgerufen am 5. September 2026
- Vellum, „GPT-6 Astra Benchmarks Explained" — Gegenprüfung der Tabellen zu Computerbedienung, Akademik und Long Context sowie der Vorbehalt zu Humanity's Last Exam
- Emergent, „GPT-6 Astra Benchmarks: What the Numbers Actually Show" — der Vorbehalt zum ARC-AGI-3-Harness und der Vergleich beim Intelligence Index
- MindStudio, „GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?" — Ursprung der von uns nicht anhand einer Primärquelle verifizierbaren Behauptungen zu Rückschritten bei GDPval, Bank-Werkzeugnutzung, Long Context und Präsentationsqualität
- Al Jazeera, „OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns", 4. September 2026 — Veröffentlichungszeitpunkt und gestaffelter Rollout
- 9to5Mac, „OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra", 4. September 2026 — die Rollout-Reihenfolge nach Tarif nach dem Starttag
- Unser Kommentar zur Stealth-Veröffentlichung von GLM-5.3-Flash — das andere Ende derselben Kurve, wo Fähigkeit billig statt teuer ankommt