Google rozwija tłumaczenie na żywo, OpenAI udostępnia głos full-duplex. Co zostaje po rozmowie?
GPT-Live-1 trafia do API w cenie 0,05 USD za minutę głosu, trzy miesiące po premierze tłumaczenia mowy na żywo Google w 70 językach. Co mierzą opublikowane ceny i benchmarki, czego nie mierzą i dlaczego protokoły spotkań, wspólne pomysły oraz zapisane źródła zyskują na znaczeniu, gdy rozmowa staje się łatwiejsza.
Oryginalna ilustracja koncepcyjna. Bardziej naturalna rozmowa i użyteczny zapis tej rozmowy to uzupełniające się cele projektowe, a nie mierzone etapy wypuszczenia produktu.
W ostatnich zapowiedziach głosowej AI najbardziej cieszy mnie zwyczajna możliwość: dokończyć myśl we własnym języku, doprecyzować ją w trakcie i swobodnie uczestniczyć w rozmowie. Mniej czekania na tłumaczenie, mniej układania zdania w głowie przed zabraniem głosu. Więcej uwagi można poświęcić temu, co druga osoba rzeczywiście chce powiedzieć.
Google wprowadził Gemini 3.5 Live Translate 9 czerwca 2026 r. OpenAI wprowadził swoje modele GPT-Live w trybie pełnego dupleksu w ChatGPT 8 lipca, a następnie wypuścił GPT-Live-1 w API 10 września. Są to różne produkty służące różnym celom, ale kolejność wskazuje na więcej ciągła interakcja słowna. Najnowsza zapowiedź OpenAI rozszerza dostęp dla programistów; nie jest to pierwsze pojawienie się GPT-Live. Ogłoszenie Google z czerwca, Wprowadzenie OpenAI z lipca, Wrześniowe wydanie API OpenAI.
Moim zdaniem te zmiany przybliżają codzienność z mniejszymi barierami językowymi. Wyostrzają też kolejne pytanie: gdy rozmowa staje się łatwiejsza, jak zachować to, co nadało jej wartość? Protokoły, dzielenie się pomysłami i zapisywanie źródeł są częścią odpowiedzi.
Głos full-duplex zmienia czekanie podczas rozmowy
Pełny dupleks oznacza, że system może jednocześnie słuchać i mówić. OpenAI opisuje GPT-Live-1 w ten sposób w swojej aktualnej dokumentacji modelu, wraz z możliwością delegowania rozumowania i użycia narzędzi agentowi zaplecza. To stwierdzenie o symultanicznej interakcji, a nie poświadczenie doskonałego tłumaczenia. Dokumentacja modelu GPT-Live-1, sprawdzona 11 września 2026 r..
Wyobraź sobie, że poprawiasz asystenta, który wyjaśnia plan: „Właściwie klient jest w Madrycie, a nie w Meksyku”. Przydatny interfejs mówiony musi zauważyć tę poprawkę, zanim przyjmie błędne założenie. Należy także odróżnić korektę od krótkiego potwierdzenia lub przerwę na przemyślenie od zaproszenia do przejęcia kontroli. Jakość wymiany zależy od tych drobnych ocen.
W starszych interfejsach głosowych często widoczna była struktura tur. Mówiłeś, czekałeś na przetworzenie, słuchałeś, a następnie próbowałeś ponownie. Szybsze przetwarzanie pomaga, ale interakcja może nadal wydawać się niezręczna, gdy system zgadnie, że skończyłeś zbyt wcześnie. Konstrukcja w trybie pełnego dupleksu uwzględnia samo nakładanie się sygnałów, zamiast traktować każdą chwilę wypowiedzi jako starannie zamkniętą wiadomość.
Istnieje już konkretny, choć ograniczony, sygnał wyjaśniający, dlaczego ma to znaczenie. OpenAI donosi, że firma Speak zajmująca się nauką języków odnotowała prawie 80% mniej przerw podczas przerw na myślenie uczniów we wczesnych ocenach w porównaniu z poprzednimi systemami turowymi. Jest to wynik partnera zgłoszony przez dostawcę, a nie niezależne ustalenie dla każdego języka lub ustawienia. Mierzy zachowanie związane z przerwami, a nie poprawę dokładności tłumaczenia o 80%. Raport o uruchomieniu interfejsu API OpenAI, 10 września 2026 r..
Szersze dane OpenAI wskazują ten sam kierunek i mają to samo ograniczenie. Według firmy GPT-Live-1 uzyskuje o 30 punktów procentowych więcej niż GPT-Realtime-2.1 w Full Duplex Bench, teście pauz, zmiany tur, przerywania i krótkich sygnałów potwierdzenia ze strony słuchacza. W połączeniu z GPT-6 Astra przy średnim poziomie rozumowania zajmuje pierwsze miejsce w Tau3, który ocenia według Pass@1 mówione zadania z obsługi klienta i bankowości, w tym 97 zadań z wiedzy bankowej. Obie oceny przeprowadziło samo OpenAI i dotyczą one zachowania w rozmowie oraz wykonywania zadań; żadna z nich nie mierzy dokładności tłumaczenia. Podsumowanie ocen OpenAI, 10 września 2026 r..
Dla osoby mówiącej w drugim języku przerwa na myślenie może wystąpić dokładnie wtedy, gdy uczestnictwo staje się trudne. Asystent, który odpowiednio czeka, zostawia miejsce na znalezienie słowa. Asystent, który akceptuje korektę, sprawia, że próba jest tańsza. Są to praktyczne powody, dla których warto ekscytować się naturalną interakcją głosową, wykraczającą poza wrażenie, jakie wywiera demonstracja.
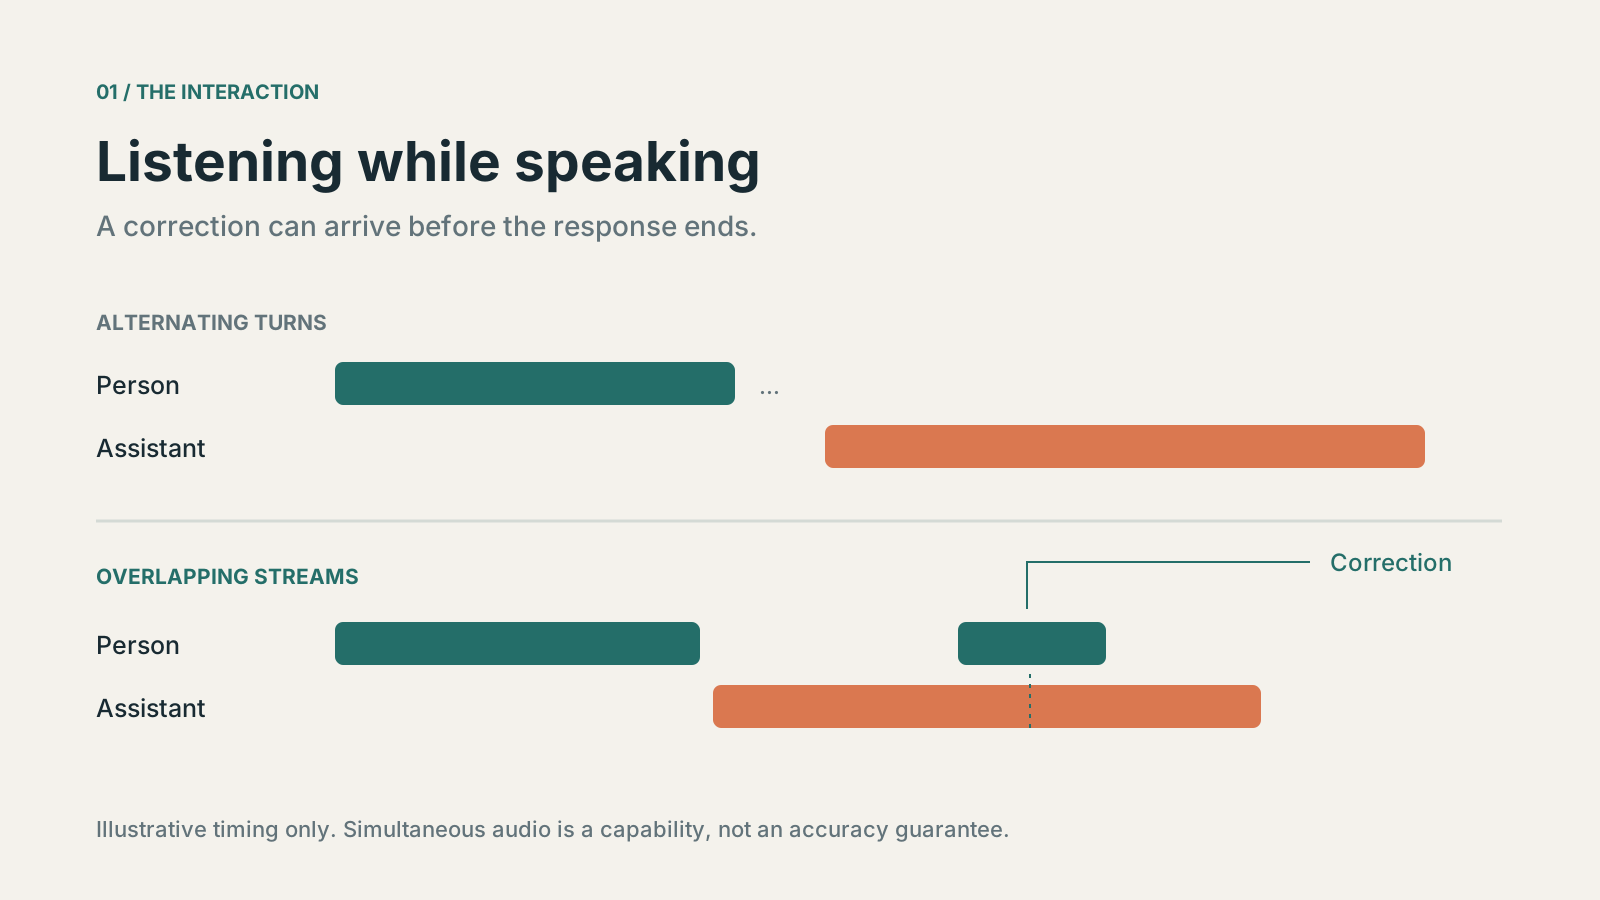
Tylko termin koncepcyjny; słupki nie przedstawiają zmierzonego opóźnienia. Tryb pełnego dupleksu opisuje jednoczesne wejście i wyjście, natomiast użyteczna obsługa przerwań nadal zależy od modelu i zastosowania.
Tłumacz na żywo i asystent głosowy mają różne zadania
Czerwcowe ogłoszenie Google opisuje ciągłe tłumaczenie mowy na ponad 70 języków. Model generuje przetłumaczoną mowę podczas słuchania, równoważąc potrzebę szerszego kontekstu z przebywaniem blisko mówiącego. Google twierdzi, że pozostaje kilka sekund w tyle, co jest oczekiwaniem bardziej użytecznym niż wyobrażanie sobie zerowego opóźnienia. Wersja deweloperska była publiczną wersją zapoznawczą. Opis premiery Google, 9 czerwca 2026 r..
Liczby dotyczące skali są w tym ogłoszeniu konkretne. Tłumaczenie mowy w Google Meet ma objąć zamiast pięciu obsługiwanych języków ponad 70, a zamiast tłumaczenia wyłącznie z angielskiego i na angielski — ponad 2000 kombinacji językowych w ramach jednego spotkania. Funkcja startuje jako prywatna wersja zapoznawcza dla wybranych klientów biznesowych Workspace, a szersze wdrożenie zaplanowano na dalszą część 2026 roku. Grab testuje model przy odbiorach pasażerów, gdy kierowcy i podróżni muszą się odnaleźć — to scenariusz obejmujący ponad 10 mln połączeń głosowych miesięcznie. Ogłoszenie przytacza pochwały partnerów dotyczące jakości, dokładności i niskiego opóźnienia, ale nie podaje żadnego wyniku liczbowego. Dane z premiery Google, 9 czerwca 2026 r..
Istnieje rozróżnienie, które warto zachować w widocznym miejscu. Przewodnik dotyczący tłumaczenia na żywo Google opisuje tłumacza, który przetwarza strumień audio w sposób ciągły, z ustawieniami specyficznymi dla tłumaczenia i bez obsługi narzędzi ani ogólnych instrukcji. GPT-Live-1 to model konwersacyjny, który może współpracować z osobnym agentem. Jeden pomaga przenieść znaczenie mówiącego na inny język; drugi uczestniczy w wymianie. Nie należy ich przedstawiać jako usług wymiennych. Przewodnik tłumaczenia na żywo Google, dokumentacja modelu OpenAI, sprawdzono 11 września 2026 r.
| Kamień milowy | Co zostało ogłoszone | Czego nie ustala |
|---|---|---|
| Google, 9 czerwca 2026 r | Gemini 3.5 Live Translate; ciągłe tłumaczenie mowy; publiczna wersja zapoznawcza dewelopera | Jednakowa jakość dla każdej pary językowej lub natychmiastowy dostęp do każdego produktu Google |
| OpenAI, 8 lipca 2026 r | Wdrożenie GPT-Live w ChatGPT, z jednoczesnym słuchaniem i mówieniem | Uniwersalna dokładność na poziomie tłumacza |
| OpenAI, 10 września 2026 | Dostęp API GPT-Live-1 do tworzenia aplikacji głosowych | Automatyczna integracja z każdą usługą spotkania lub sporządzania notatek |
Zakres wydania wynika z trzech ogłoszeń, do których linki znajdują się powyżej. To jest oś czasu, a nie ranking wydajności.
Podsumowując, zmiany te uwidaczniają ważny kierunek: tłumaczenie może stać się bardziej ciągłe, a interakcja z asystentem może stać się mniej sztywna. Połączenie tych możliwości w niezawodne wielojęzyczne spotkania pozostaje pracą nad aplikacjami. Ktoś wciąż musi zdecydować, czyj dźwięk jest interpretowany, dokąd trafiają wyniki, w jaki sposób przeprowadzane są poprawki i co widzą uczestnicy.
Opublikowane liczby: 0,05 USD za minutę i żadnego wyniku dokładności
Minuta głosu GPT-Live-1 kosztuje w API 0,05 USD, z rozliczaniem sekundowym, bez zaokrąglania do pełnej minuty. Ta cena obejmuje wyłącznie warstwę głosową po stronie front-endu; model zaplecza i narzędzia, którym sesja deleguje pracę, są rozliczane osobno według zwykłych stawek. Dokumentacja modelu OpenAI, sprawdzona 11 września 2026 r..
Rachunek jest prosty, ale łatwo go źle odczytać. 30-minutowa sesja kosztuje 1,50 USD za czas warstwy głosowej, godzina 3,00 USD, a 100 godzin miesięcznie daje 300 USD, i to jeszcze przed jakimkolwiek rozumowaniem po stronie zaplecza. Aplikacja, która każdemu uczestnikowi spotkania uruchamia osobną sesję, mnoży te kwoty przez liczbę sesji. Czerwcowe ogłoszenie Google nie podaje ceny Gemini 3.5 Live Translate, dlatego ten tekst nie porównuje obu rozwiązań pod względem kosztów.
| Dane | Wartość | Źródło i data | Co mierzy |
|---|---|---|---|
| Cena GPT-Live-1 w API | 0,05 USD za minutę, rozliczane co sekundę | OpenAI, 10 września 2026 r. | Tylko warstwa głosowa; model zaplecza i narzędzia rozliczane osobno |
| Full Duplex Bench | +30 punktów procentowych względem GPT-Realtime-2.1 | OpenAI, 10 września 2026 r. | Pauzy, zmiana tur i przerywanie, nie tłumaczenie |
| Tau3 | Pierwsze miejsce, z GPT-6 Astra (średni poziom rozumowania) | OpenAI, 10 września 2026 r. | Skuteczność w zadaniach mówionych (Pass@1), w tym 97 zadań bankowych |
| Wczesna ocena Speak | Prawie 80% mniej przerywania podczas pauz na zastanowienie | OpenAI (wypowiedź partnera), 10 września 2026 r. | Przerywanie w porównaniu z wcześniejszymi systemami turowymi |
| Korzystanie z głosu w ChatGPT | Ponad 150 mln osób tygodniowo | OpenAI, 8 lipca 2026 r. | Użycie funkcji głosowych i dyktowania, nie jakość |
| Gemini 3.5 Live Translate | 70+ języków, wykrywanych automatycznie | Google, 9 czerwca 2026 r. | Zasięg, nie jakość dla poszczególnych par językowych |
| Tłumaczenie mowy w Google Meet | 5 → 70+ języków; 2000+ kombinacji na spotkanie | Google, 9 czerwca 2026 r. | Planowana aktualizacja, najpierw w prywatnej wersji zapoznawczej |
| Opóźnienie tłumaczenia | „Zaledwie kilka sekund za mówiącym” | Google, 9 czerwca 2026 r. | Opis dostawcy, nie zmierzona wartość |
Wszystkie liczby pochodzą od samych dostawców, z ogłoszeń i dokumentacji, do których prowadzą linki w tym tekście. Żadna z nich nie jest liczbowym wynikiem dokładności tłumaczenia, takim jak ocena ludzi czy automatyczna metryka dla danej pary językowej.
Ta luka ma największe znaczenie dla osób wybierających narzędzie do spotkań wielojęzycznych. Benchmarki interakcji mówią, czy system dobrze czeka, słucha i radzi sobie z zakłóceniami; nie mówią, czy „poniedziałek” przetrwał podróż na koreański. Lipcowe zastrzeżenie OpenAI dotyczące nienatywnych akcentów w niektórych językach oraz brak wyników dla poszczególnych par po stronie Google prowadzą do tej samej praktycznej zasady: przetestuj pary językowe, których Twój zespół faktycznie używa, zanim zaczniesz polegać na którymkolwiek z tych rozwiązań przy podejmowaniu decyzji.
Mniejsza bariera językowa ułatwia zabranie głosu
Rozważmy hipotetyczne 30-minutowe spotkanie projektowe z czterema osobami, które najlepiej czują się w trzech różnych językach. Korzyści z lepszego tłumaczenia mówionego nie polegają jedynie na tym, że każda osoba słyszy więcej słów. Polega na tym, że grupa może zadawać pytania uzupełniające, zanim niepewność stanie się nieporozumieniem. Wstępny pomysł można wyrazić bez uprzedniego dopracowania go na drugi język.
To zmienia ekonomię uczestnictwa w bardzo zwyczajnym sensie: wnoszenie wkładu wymaga mniej wysiłku. Cicha osoba z odpowiednim doświadczeniem ma inny sposób na włączenie się do dyskusji. Osoba prowadząca spotkanie może poświęcić mniej czasu na rekonstrukcję przerwanego zdania. Wyjaśnienie może nastąpić, gdy jest przydatne, a wszyscy nadal pamiętają omawianą kwestię.
Spodziewam się, że będzie to miało znaczenie w zdalnych zespołach, dyskusjach w klasie, rozmowach z klientami i nieformalnych wymianach zdań podczas podróży. Są to oczekiwania dotyczące tego, gdzie technologia może pomóc, a nie twierdzenie, że to samo doświadczenie jest już dostępne dla wszystkich. Para językowa, akcent, słownictwo, jakość mikrofonu i otaczający produkt – wszystko to pozostaje częścią wyniku.
Naturalne brzmienie głosu trzeba oceniać oddzielnie od poprawności przekazywanego sensu. W lipcowej prezentacji OpenAI wskazało na nienatywne akcenty i ograniczoną płynność w niektórych językach. Dlatego należy sprawdzać języki faktycznie używane, zamiast uogólniać wynik udanego pokazu po angielsku. Było to zastrzeżenie z chwili premiery, a nie aktualna ocena wszystkich wrześniowych wdrożeń. Wprowadzenie do GPT-Live dotyczące GPT-Live i zastrzeżenie językowe, 8 lipca 2026 r.
Właściwą ambicją jest szersze uczestnictwo i łatwy sposób wyjaśnienia. Data, kwota, imię i nazwisko osoby lub przyrzeczenie warunkowe powinny być łatwe do sprawdzenia. System może brzmieć pewnie, podczas gdy uczestnik nadal musi powiedzieć: „Proszę, pokaż mi to zdanie”. Pokazanie tekstu i zachowanie oryginału, w przypadku którego uczestnicy zgodzili się na nagranie, daje możliwość realizacji tej prośby.
Nawet płynna rozmowa wymaga zapisania decyzji
Wróćmy do hipotetycznego spotkania. Ktoś proponuje publikację w piątek, jeśli zakończy się przegląd bezpieczeństwa. Inna osoba woli poniedziałek, by dać zespołowi wsparcia więcej czasu na przygotowania. Grupa wybiera poniedziałek i wyznacza osobę odpowiedzialną, ale jeden warunek wstępny pozostaje niespełniony. Podsumowanie, które zapamiętało tylko początkowo proponowany piątek, pomija decyzję spotkania.
Żadna poprawa rytmu konwersacji nie usuwa różnicy między sugestią, warunkiem i decyzją. Osoby pracujące w tym samym języku muszą już je rozróżniać. Wielojęzyczna interakcja sprawia, że cenniejsze jest zachowanie ścieżki od pierwotnego oświadczenia do przetłumaczonego brzmienia i ostatecznego uzgodnionego działania.
Chciałbym, aby czytelnik, który przegapił rozmowę, aby uzyskać praktyczny zapis spotkania, szybko dowiedział się o trzech rzeczach: o tym, co zdecydowała grupa, kto jest odpowiedzialny za następny krok i jakie pytania pozostają otwarte. Termin należy określić jako uzgodniony tylko wtedy, gdy został uzgodniony. Jeżeli źródło jest niejasne, protokół powinien pogłębiać tę niepewność, zamiast ją przekształcać w fałszywe wnioski.
Nie wymaga to przekształcania każdej rozmowy w wyczerpujące archiwum. Krótka notatka z decyzją może być bardziej użyteczna niż strony niezróżnicowanego transkrypcji. Ważny związek zachodzi pomiędzy zwięzłą relacją a materiałem pomocniczym: odpowiednim oryginalnym sformułowaniem, nagraniem, jeśli jest dostępne i autoryzowane, oraz dokumentem omawianym przez grupę.
To powiązanie ułatwia również poprawianie błędów. Uczestnik może wskazać oryginalną wypowiedź, poprawić podsumowanie i udostępnić skorygowaną decyzję. Bez tego kolejna osoba może ponownie streścić streszczenie, zamieniając pierwsze nieporozumienie w pozornie ustalony fakt. Lepsza interakcja głosowa ułatwia rozmowę, a dobre zapisy pozwalają później sprawdzić jej wynik.
Wspólne pomysły potrzebują swoich źródeł
Przydatny pomysł rzadko zaczyna się i kończy w trakcie jednej rozmowy. Ktoś znajduje artykuł, zapisuje fragment, zadaje pytanie na jego temat i przynosi pytanie na spotkanie. Inna osoba dodaje kontrprzykład z filmu lub artykułu badawczego. Następny krok zależy od możliwości ponownego połączenia tych elementów po zakończeniu rozmowy.
Dlatego zapisywanie źródeł z internetu pozostaje przydatne nawet przy świetnej głosowej AI. URL pozwala wrócić do oryginału, wybrany fragment wskazuje ważne miejsce, a osobista notatka wyjaśnia, dlaczego je zapisano. Każdy element pełni inną funkcję. Razem przekazują pomysł lepiej niż pojedynczy akapit wygenerowany przez AI.
„Powinniśmy zmienić pierwsze kroki nowych użytkowników” daje niewiele kontekstu osobie przejmującej temat. „Ten artykuł skłonił nas do przemyślenia pierwszych pięciu minut; oto fragment, nasza dyskusja i uzgodniony eksperyment” daje materiał do oceny. Przykład jest hipotetyczny, ale różnica konkretna: sam wniosek wymaga zaufania, a rozumowanie i źródło pozwalają kontynuować rozmowę.
Ta sama dyscyplina chroni źródło przed zamazaniem w komentarzu. Cytat powinien pozostać rozpoznawalny jako cytat. Tłumaczenie jest interpretacją tego źródła, a podsumowanie spotkania to kolejny pogląd pochodny. Uwidocznienie tych ról pozwala ludziom produktywnie się nie zgadzać bez konieczności rekonstruowania tego, co ktoś pierwotnie powiedział.
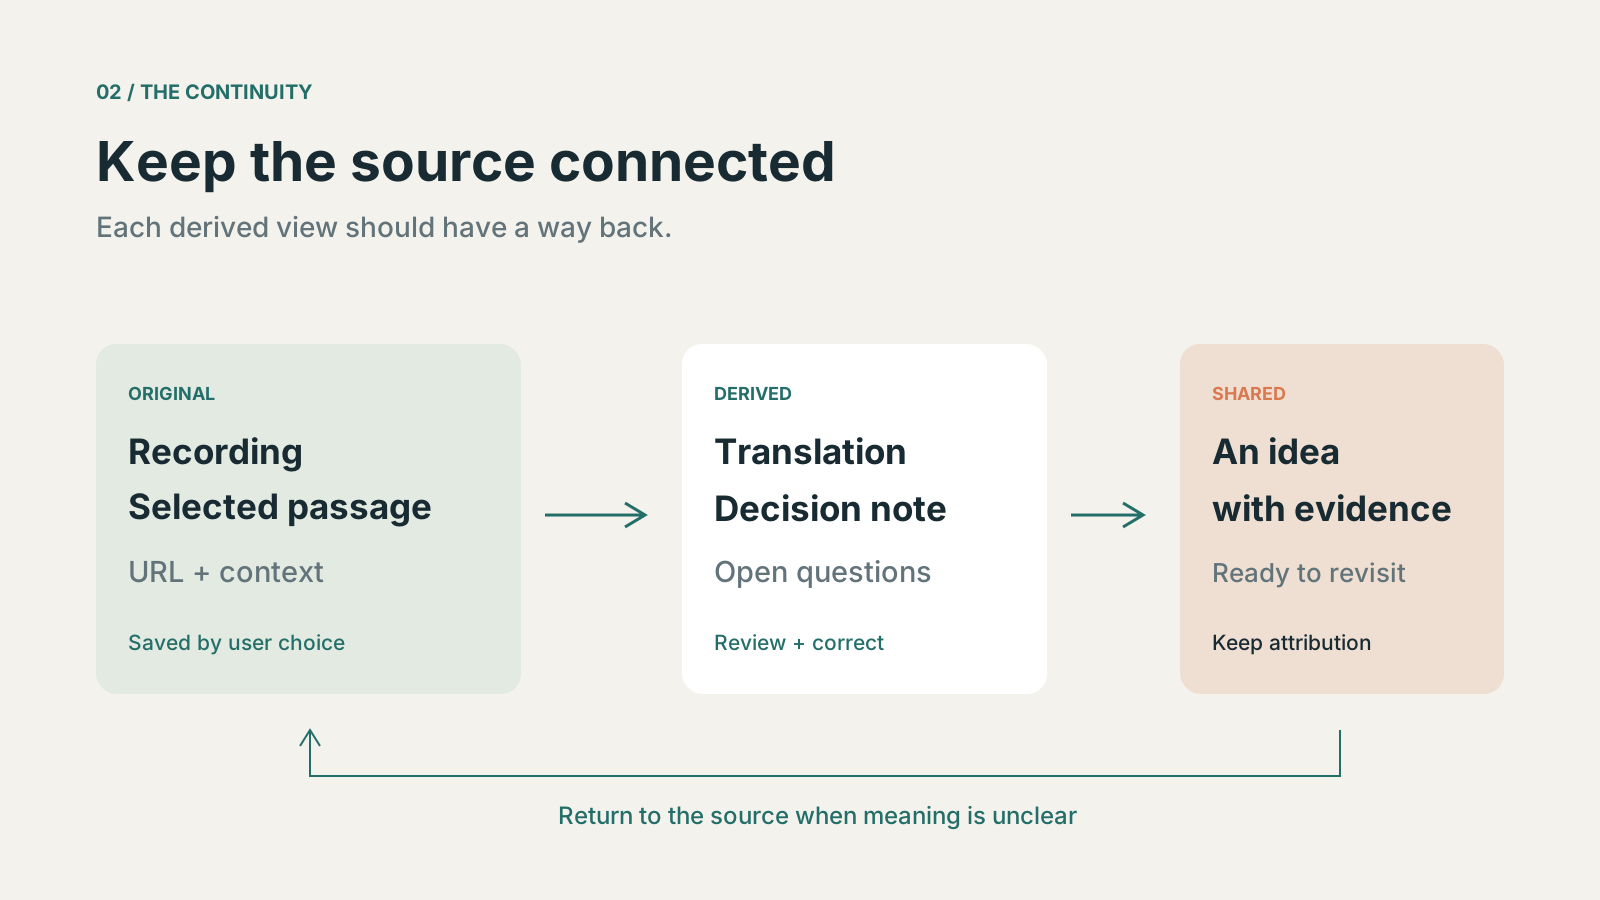
Oryginalny proponowany przepływ pracy. Zachowaj autoryzowane materiały źródłowe, umożliwij poprawianie tekstu pochodnego i utrzymuj widoczność połączenia podczas udostępniania. Diagram nie twierdzi, że obecnie każde łącze jest funkcją zautomatyzowaną.
Kontekst musi przetrwać zakończenie rozmowy
Systemy głosowe również zaczynają oddzielać rozmowę od pracy odbywającej się za nią. Dokumentacja delegacji OpenAI wyjaśnia, że przemówienie na żywo i delegowana praca mogą być kontynuowane niezależnie; ukończona odpowiedź zaplecza nie oznacza, że użytkownik usłyszał odpowiedź. Jest to przydatne inżynierskie przypomnienie szerszego problemu z produktem: wrażenia mówione i trwały wynik to odrębne rzeczy do sprawdzenia. Dokumentacja delegacji OpenAI, sprawdzona 11 września 2026 r..
Dla zwykłych użytkowników pytanie jest prostsze. Czy po zakończeniu rozmowy będę mógł znaleźć decyzję jutro? Czy kolega może zrozumieć, dlaczego to zrobiliśmy? Czy mogę wrócić do artykułu, który podważył nasze założenie, bez przeszukiwania historii czatów, przeglądarki i nagrania? Te pytania pozostają, nawet jeśli każde zdanie zostanie pięknie zinterpretowane.
Istnieją powody do optymizmu, jeśli chodzi o to, że bariery językowe staną się mniej dominujące. Powinniśmy z radością powitać narzędzia, które pozwolą większej liczbie osób na komfortowy wkład. Oczekuję, że łatwiejsza rozmowa zwiększy wartość połączenia tego, co mówimy, z tym, co przechowujemy, udostępniamy i ostatecznie robimy. Spotkanie nie musi trwać wiecznie; jego użyteczny wynik powinien przetrwać wezwanie.
Kierunek, w którym chcemy rozwijać Telli.sh
Dla Telli.sh to kierunek rozwoju: pomagać zamieniać rozmowy i odkrycia w wiedzę, do której można wrócić. Dziś produkt łączy notatki, nagrania, tłumaczenia i Clips w jednej przestrzeni. Chcemy wzmacniać związki między tymi materiałami, aby protokół, pomysł i źródło nie rozpraszały się ponownie.
Chcemy spójnego procesu: zapisać rozmowę za odpowiednią zgodą, sprawdzić istotne punkty, jasno opisać decyzje i udostępnić pomysł wraz z jego podstawami. Jeśli dyskusja zaczyna się od strony internetowej, Clip powinien pomagać zachować URL i kontekst wybrany przez użytkownika. Jeśli tłumaczenie ułatwia zrozumienie, oryginał powinien pozostać dostępny do porównania i korekty.
To opis kierunku produktu, a nie ogłoszenie, że Telli.sh już zintegrowało GPT-Live-1 lub Gemini 3.5 Live Translate. Przyszłe funkcje głosowe powinny przynosić realną korzyść w różnych językach, zapewniać wiarygodne zapisy i jasną kontrolę nad tym, co zostaje zachowane. Postęp modeli ma poprawiać przestrzeń pracy bez uzależniania osobistej wiedzy od jednego modelu.
Im łatwiej rozmawiać ponad granicami językowymi, tym bardziej chcemy pomagać zachować wartość rozmów. Zacznij od ważnego spotkania, pomysłu do podzielenia się lub źródła, które jeszcze się przyda.