120 darmowych minut, w których nie mieści się jeden wywiad: co naprawdę daje darmowa transkrypcja AI po indonezyjsku
Darmowy plan Notty daje 120 minut transkrypcji miesięcznie i ogranicza pojedyncze nagranie do 3 minut. TurboScribe daje 3 pliki dziennie z pułapem 30 minut. API Google wydaje 60 darmowych minut i żadnego interfejsu. 7 sierpnia 2026 roku Deepgram wypuścił ulepszony model indonezyjski — wyłącznie na ścieżce wsadowej. Przetestowane porównanie darmowych planów, na które naprawdę trafia dziennikarz, badacz albo rekruter w Indonezji, oraz limitów, których żaden z nich nie reklamuje.
Macie na telefonie 47-minutowy wywiad. Rozmówca z Surabai, nagrany dziś rano, w większości po indonezyjsku, z typową domieszką angielskiego — deadline, stakeholder, follow up. Transkrypt jest potrzebny na dziś i zdecydowanie wolelibyście za niego nie płacić.
Więc szukacie, trafiacie na narzędzie reklamujące 120 darmowych minut transkrypcji miesięcznie i zakładacie konto. Wasz 47-minutowy plik mieści się w 120 z ogromnym zapasem. Potem wysyłka się nie udaje, a w tabeli porównania planów, kilka wierszy niżej, siedzi druga liczba, której nikt nie wstawia do nagłówka: maksymalna transkrypcja na jedno nagranie, 3 minuty.
Tak wygląda cała ta kategoria. Darmowe plany reklamuje się liczbą brzmiącą najhojniej, a ogranicza zupełnie inną liczbą trzy wiersze niżej. Ten tekst jest porównaniem, którego nam samym brakowało: co każdy darmowy plan faktycznie daje wywiadowi po indonezyjsku, czego po cichu odmawia i jak sprawdzić dowolny z nich w pięć minut, zanim się zwiążecie.
W skrócie
- Darmowe plany mają trzy niezależne pułapy — minuty miesięcznie, minuty na plik i pliki dziennie — a tym, który rozbija wywiady, prawie zawsze jest limit na plik, nie miesięczna pula.
- Indonezyjskie rozpoznawanie mowy realnie poprawiło się w tym miesiącu: 7 sierpnia 2026 roku Deepgram wypuścił ulepszony indonezyjski model Nova-3, ale wyłącznie na ścieżce wsadowej, nie strumieniowej. Przesłanie nagrania na tym zyskuje; napisy na żywo nie.
- Żaden publiczny ranking nie mierzy dokładności dla indonezyjskiego. Open ASR Leaderboard dodał swój pierwszy język Globalnego Południa 28 sierpnia 2026 roku i był to hindi. Dopóki to się nie zmieni, wasz własny 5-minutowy klip testowy jest jedynym benchmarkiem, który opisuje wasze audio.
Darmowe plany obok siebie
Każda liczba poniżej pochodzi z cennika albo dokumentacji samego dostawcy, pobranych 31 sierpnia 2026 roku. Zadaniem odniesienia jest jeden 47-minutowy wywiad dwóch osób, bo to jest plik, który ludzie naprawdę mają.
| Narzędzie | Darmowy plan | Najdłuższy pojedynczy plik za darmo | Indonezyjski | Próg płatny |
|---|---|---|---|---|
| Notta | 120 min/miesiąc, 50 wysyłek/miesiąc, 10 podsumowań AI/miesiąc, 1 stanowisko | 3 minuty | Niepotwierdzony | Pro 8,17 $/miesiąc przy płatności rocznej — 1800 min/miesiąc, pliki do 5 godzin |
| TurboScribe | 3 transkrypty dziennie, niższy priorytet w kolejce | 30 minut | Tak | Unlimited 10 $/miesiąc, 120 $ rozliczane rocznie — pliki do 10 godzin |
| Transkriptor | Brak opublikowanej darmowej puli miesięcznej | — | Tak | Lite 9,99 $/miesiąc — 300 min/miesiąc |
| Maestra | Brak opublikowanej darmowej puli miesięcznej | — | Tak | Płatność za zużycie 12 $ za 60 minut; Lite 23 $/miesiąc — 180 min/miesiąc |
| Google Cloud Speech-to-Text | 60 min/miesiąc, potem 0,016 $/min | Brak praktycznego limitu | Tak, id-ID | 0,016 $/min z logowaniem danych, 0,024 $/min bez |
| API transkrypcji OpenAI | Brak | Brak praktycznego limitu | Tak | 0,006 $/min (gpt-4o-transcribe), 0,003 $/min (mini) |
| Whisper, na własnym serwerze | Bez limitu, licencja MIT | Tyle, ile udźwignie wasz sprzęt | Tak | Darmowe oprogramowanie, wasz własny czas GPU |
| Telli.sh | 60 min/miesiąc | Do wysokości przydziału | Tak | Plany płatne startują od 300 min/miesiąc |
Źródła: cenniki poszczególnych dostawców, pobrane 31 sierpnia 2026 roku; dokumentacja obsługiwanych języków Google dla id-ID; opublikowany cennik API OpenAI. Żywa strona z cennikiem TurboScribe blokuje pobieranie automatyczne, więc jej dane pochodzą ze zrzutu tej strony w Internet Archive i zgadzają się z tym, jak plan jest obecnie opisywany gdzie indziej — sprawdźcie je, zanim na nich oprzecie decyzję. Nie udało nam się pobrać listy języków z Notty 31 sierpnia 2026 roku, więc jej obsługę indonezyjskiego oznaczamy jako niepotwierdzoną, zamiast ją zakładać.
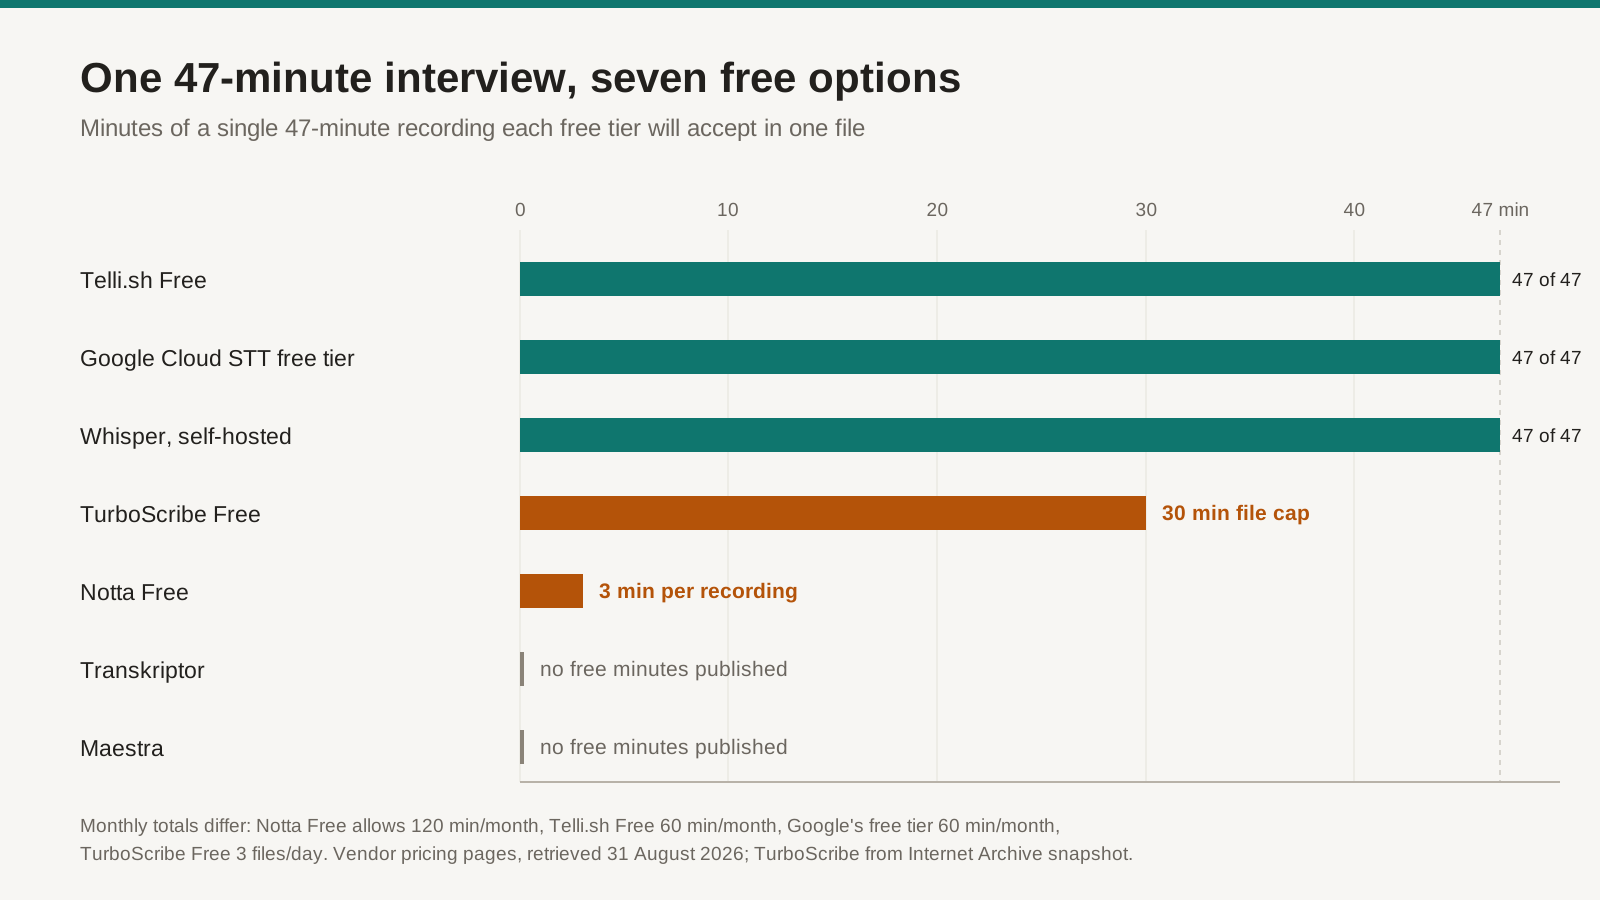
Jedna jednostka na jednej osi: minuty jednego 47-minutowego wywiadu przyjęte w pojedynczym pliku. Przydziały miesięczne są różne i podajemy je pod wykresem.
120 minut Notty jest prawdziwe. To trzyminutowy pułap rozbija wywiad.
Przeczytajcie darmowy plan Notty uważnie, a okaże się, że wcale nie jest skąpy — 120 minut transkrypcji miesięcznie, 50 wysłanych plików, 10 podsumowań AI, 1000 kredytów AI, bez karty kredytowej. Do notatek głosowych i krótkich rozmów to naprawdę użyteczny przydział, i to więcej miesięcznych minut, niż rozdaje większość konkurencji.
Potem przeczytajcie jeden wiersz niżej w tej samej tabeli porównawczej: maksymalna transkrypcja na jedno nagranie, 3 minuty w planie Free, wobec 5 godzin w Pro. Wasze 120 minut to czterdzieści osobnych trzyminutowych fragmentów. 47-minutowy wywiad w ogóle nie wejdzie do systemu.
I tu jest sedno, które wykracza daleko poza jednego dostawcę: darmowy plan to nie jedna liczba, tylko trzy pułapy, a marketing cytuje ten najwyższy. Minuty miesięcznie są nagłówkiem. Minuty na plik decydują, czy wasz wywiad w ogóle da się przetranskrybować. Pliki dziennie decydują, czy w niedzielę przerobicie tydzień pracy w terenie.
TurboScribe odwraca ten sam kompromis. Jego darmowy plan nie reklamuje żadnej miesięcznej puli minut — trzy transkrypty dziennie, każdy do 30 minut, jeden plik naraz, z niższym priorytetem w kolejce. Trzy 30-minutowe pliki dziennie to 90 minut audio, czyli miesięczne 120 minut Notty przebite w dwa dni. Ale 47-minutowy wywiad nadal się nie mieści, bo wiążącym ograniczeniem znowu jest limit na plik. Musielibyście podzielić nagranie, a każde cięcie kosztuje was ciągłość mówiących w miejscu cięcia.
Transkriptor i Maestra rozwiązują to napięcie inaczej: w zasadzie nie mają darmowego planu. Opublikowane plany Transkriptora zaczynają się od Lite, 9,99 $ miesięcznie za 300 minut transkrypcji, przez Pro za 19,99 $ za 2400 minut (8,33 $ miesięcznie, jeśli zapłacicie 99,99 $ z góry za rok). Maestra sprzedaje kredyty w modelu pay-as-you-go po 12 $ za 60 minut, a Lite kosztuje 23 $ miesięcznie za 180 minut. Obie wymieniają indonezyjski; tabela języków Maestry oznacza indonezyjski jako obsługiwany zarówno w transkrypcji, tłumaczeniu, lektorze, jak i w trybie czasu rzeczywistego. Żadna nie publikuje cyklicznego darmowego przydziału, co jest swoistą formą uczciwości.
Indonezyjski wymiernie poprawił się 7 sierpnia — dokładnie na jednej ścieżce
W indonezyjskim rozpoznawaniu mowy zdarzyło się w tym miesiącu coś realnego, a prawie nikt piszący o „narzędziach do transkrypcji AI" o tym nie wspomniał.
7 sierpnia 2026 roku Deepgram wydał ulepszone jednojęzyczne modele Nova-3 i dodał ormiański. Changelog jest konkretny w sposób, w jaki komunikaty dostawców rzadko bywają. Pod nagłówkiem Batch models: tamilski i indonezyjski. Pod nagłówkiem Streaming models: tamilski i białoruski.
Indonezyjski pojawia się na jednej liście, a na drugiej nie.
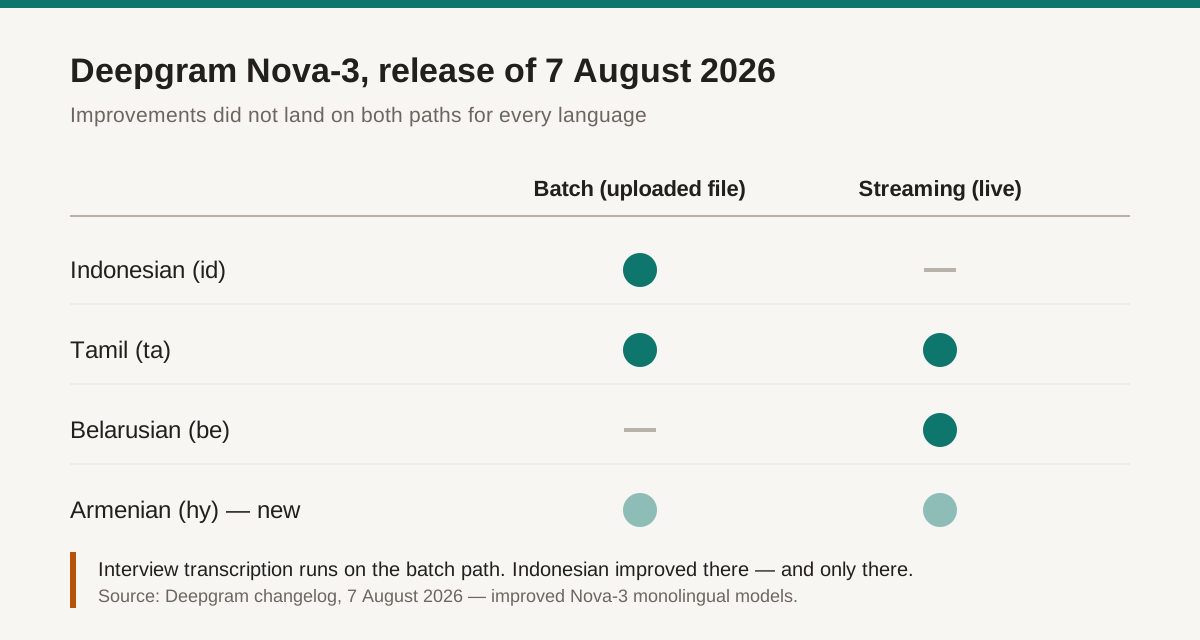
To samo wydanie poprawiło indonezyjski we wsadzie, a białoruski w strumieniu. „Lepsza obsługa indonezyjskiego" to nie jeden fakt. Źródło: changelog Deepgram, 7 sierpnia 2026 roku.
To rozróżnienie ląduje dokładnie na pracy z wywiadami. Wsad to ścieżka, którą idzie przesłany plik — silnik widzi całe nagranie, może korzystać z kontekstu z obu stron i nie ściga się z buforem audio na żywo. Strumień to ścieżka napisów na żywo. Jeśli nagrywacie wywiad, a potem go wysyłacie, jesteście na ścieżce wsadowej, czyli tej, która w tym miesiącu poprawiła się dla indonezyjskiego. Jeśli liczyliście na dokładne indonezyjskie napisy na żywo w trakcie samej rozmowy, ten konkretny model 7 sierpnia się nie zmienił.
Dłuższą wersję tego wywodu napisaliśmy w tekście co naprawdę ukrywa słowo „obsługiwany" w pokryciu językowym rozpoznawania mowy, bo ten wzorzec powtarza się w całej branży: język nie jest obsługiwany albo nieobsługiwany, tylko obsługiwany na danej ścieżce, w danym trybie, na danym poziomie jakości, na dany dzień. Akurat dla transkrypcji wywiadów dobra wiadomość jest taka, że ścieżka, której potrzebujecie, to ta, która się poprawiła.
Nikt nie publikuje benchmarku dokładności dla indonezyjskiego, więc benchmarkiem musicie być wy
Oto niewygodna część pisania uczciwego porównania: nie damy wam tabeli WER dla indonezyjskiego, bo żadna wiarygodna publiczna nie istnieje.
Open ASR Leaderboard — najbliższa rzecz, jaką ta dziedzina ma do neutralnej tablicy wyników — prowadził zakładkę wielojęzyczną obejmującą wyłącznie języki europejskie aż do 28 sierpnia 2026 roku, gdy Hugging Face i Voice Arena dodały hindi jako jej pierwszy język Globalnego Południa. Indonezyjskiego, z mniej więcej 280 milionami ludzi na rodzimym rynku, nadal tam nie ma. Dostawcy publikują deklaracje dokładności dla angielskiego i milczą o reszcie.
Sama struktura Whispera podpowiada tę samą asymetrię. Tokenizer OpenAI deklaruje 100 tokenów językowych, a indonezyjski zajmuje w tej tabeli pozycję 17 — pozycja godna szacunku, wygodnie przed większością listy i nieporównywalna z wolumenem danych stojącym za angielskim, chińskim czy hiszpańskim. Zadeklarowany token nie jest gwarancją jakości; jest deklaracją, że model spróbuje.
Uczciwy wniosek operacyjny brzmi więc tak: dla indonezyjskiego benchmarkiem jest wasze własne audio. Nie plik demonstracyjny dostawcy, nie ranking, nie gwiazdki na portalu z recenzjami. Wasz dyktafon, wasze pomieszczenie, regionalny akcent waszego rozmówcy, słownictwo waszej branży. Brzmi jak wykręt, dopóki nie zauważycie, że porządne zrobienie tego zajmuje jakieś dwadzieścia minut.
Test 5-minutowy: zróbcie to, zanim komukolwiek zapłacicie
Weźcie pięciominutowy fragment prawdziwego wywiadu — najlepiej z dwoma mówiącymi, hałasem w tle i przynajmniej trzema nazwami własnymi. Puśćcie go przez każdego kandydata. Potem sprawdźcie pięć rzeczy, w tej kolejności.
- Policzcie błędy w nazwach własnych. Nazwiska ludzi, nazwy firm, miejsc i terminy produktowe. To tutaj indonezyjskie ASR niezawodnie zawodzi i tutaj błąd robi największe szkody dalej, bo błędne nazwisko przenosi się po cichu do każdego podsumowania i cytatu, które później wygenerujecie. Pięć błędów w pięciu minutach to mniej więcej 47 w całym wywiadzie.
- Sprawdźcie konkretnie linijki z mieszanką języków. Znajdźcie zdanie, w którym angielskie słowo siedzi w środku indonezyjskiej frazy, i przeczytajcie, co narzędzie wyprodukowało. To najbardziej prognostyczny pojedynczy test dla profesjonalnego indonezyjskiego audio i jednocześnie ten, którego nie porusza żadna strona dostawcy.
- Zweryfikujcie etykiety mówiących w piątej minucie, a nie w pierwszej. Diaryzacja zwykle wygląda idealnie w pierwszych sekundach. Liczy się to, czy Mówiący A jest nadal Mówiącym A po pierwszym wejściu w słowo, nakładających się głosach albo długiej pauzie.
- Poszukajcie znaczników czasu, z którymi da się coś zrobić. Jeśli kiedykolwiek będziecie musieli zweryfikować cytat wobec nagrania, potrzebujecie znaczników czasu na poziomie linii w eksporcie, a nie tylko w odtwarzaczu na stronie. Dziennikarze i badacze jakościowi powinni traktować to jako wymóg obowiązkowy.
- Wyeksportujcie plik i otwórzcie go gdzie indziej. TXT, DOCX, SRT, VTT — cokolwiek potrzebuje wasz obieg pracy. To tu darmowe plany najczęściej się zatrzymują, a transkrypt, którego nie umiecie wyjąć z narzędzia, jest demem, a nie zapisem.
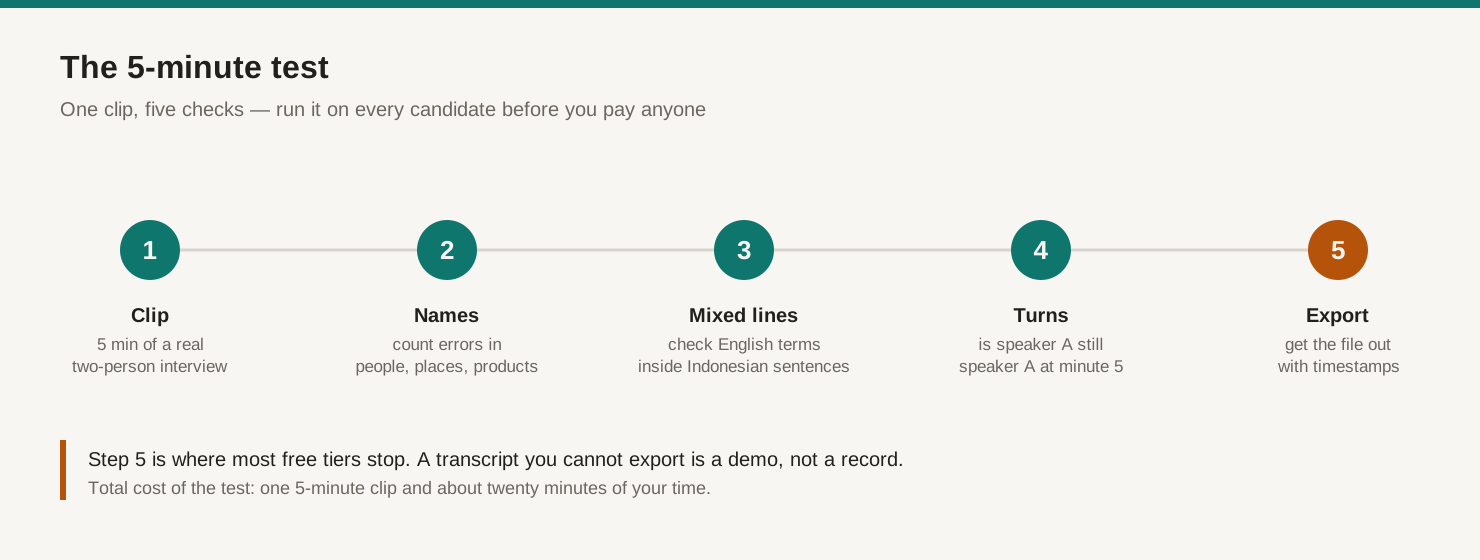
Pięć kontroli, w kolejności, w jakiej dopadają was przy prawdziwej ocenie.
Jeśli szukacie obiegu pracy, który zaczyna się po wyborze narzędzia — przeglądania transkryptu, zanim zaufacie podsumowaniu, trzymania cytatów przypiętych do źródłowego audio — opisaliśmy go osobno w tekście jak zamienić nagranie wywiadu w transkrypt i podsumowanie, które da się przejrzeć.
Indonezyjskie wywiady pękają w jednym miejscu: na angielskim słowie w środku zdania
Profesjonalny indonezyjski nie jest jednojęzyczny. „Nanti kita follow up setelah meeting dengan tim product" to nie jest zepsuty indonezyjski; tak mówi product manager w Dżakarcie i mniej więcej tak samo mówią rekruter, konsultant i założyciel startupu. Każdy transkrypt, który poprzekręca angielskie fragmenty, poprzekręcał dokładnie te terminy, na których stoją wasze notatki.
To najtrudniejsza rzecz w tej kategorii i warto rozumieć dlaczego. Większość silników mowy uruchamia jeden jednojęzyczny model na żądanie. Ustawiacie język na indonezyjski, a model jest najmocniejszy w indonezyjskiej fonetyce i indonezyjskim słownictwie — co oznacza, że angielskie słowo wchodzące w środku zdania jest albo transliterowane na coś o indonezyjskim kształcie, albo gubione. Ustawienie języka na angielski tylko odwraca kierunek szkody. Tryby wielojęzyczne albo przełączania kodów istnieją, ale są węższe niż listy jednojęzyczne: na sierpień 2026 roku Nova-3 od Deepgram dokumentuje 58 języków pojedynczo, a przełączanie kodów w dokładnie 10.
Dwa praktyczne środki zaradcze, oba tanie. Po pierwsze, ustawcie język źródłowy jawnie na indonezyjski, zamiast zostawiać włączone autowykrywanie — autodetekcja zgaduje na podstawie sekund o najmniejszym kontekście w całym pliku, a błędny strzał degraduje naraz wszystko, co dalej. Po drugie, jeśli narzędzie oferuje własny słownik albo listę słów kluczowych, wpiszcie do niego powracające angielskie terminy i nazwy własne przed przetwarzaniem, nie po.
Nazwijmy to problemem gado-gado, od indonezyjskiej sałatki mieszanej: audio jest wymieszane z założenia, a każdy silnik chce je podać jako jedno danie.
Jeśli umiecie pisać kod, transkrypcja kosztuje mniej niż kawa
Porównanie darmowych planów zmienia całkowicie kształt, gdy jesteście gotowi dotknąć API, a te liczby warto znać, nawet jeśli ostatecznie z niego nie skorzystacie.
OpenAI liczy 0,006 $ za minutę za gpt-4o-transcribe i 0,003 $ za minutę za wariant mini. Wasz 47-minutowy wywiad kosztuje 28 centów, albo 14 centów na mini. Google Cloud Speech-to-Text daje pierwsze 60 minut miesięcznie za darmo, potem 0,016 $ za minutę z włączonym logowaniem danych i 0,024 $ bez, a id-ID wymienia zarówno na modelu chirp, jak i chirp_2 w regionie asia-southeast1. Whisper ma licencję MIT i nie kosztuje nic poza waszym własnym sprzętem.
Przy takich cenach samo rozpoznawanie jest praktycznie darmowe. To, co naprawdę kupujecie w jakimkolwiek produkcie konsumenckim, to wszystko dookoła: interfejs do wysyłki, etykiety mówiących, znaczniki czasu, edytor, wyszukiwanie po starych wywiadach, podsumowania, eksporty i miejsce, w którym zapis nadal istnieje za pół roku.
Tak wygląda uczciwe postawienie pytania „zbudować czy kupić". Jeśli macie trzy wywiady rocznie i umiecie odpalić skrypt w Pythonie, odpalcie skrypt. Jeśli macie trzy tygodniowo i musicie znaleźć cytat z marca, nie kupujecie rozpoznawania mowy — kupujecie system archiwizacji z doczepionym rozpoznawaniem.
Czego nie zrobi za was żaden darmowy plan
Sprawiedliwie to sprawiedliwie, więc oto ograniczenia dotyczące każdej opcji ze stołu, łącznie z naszą.
Darmowe plany nie dają wam wiarygodnej diaryzacji mówiących. To jeden z droższych elementów potoku i w całej kategorii rutynowo rezerwuje się go dla planów płatnych. Jeśli rozdzielenie dwóch mówiących jest w waszej pracy kluczowe, zaplanujcie na to budżet, zamiast liczyć na szczęście.
Darmowe plany nie obiecują przechowywania. Storage kosztuje; darmowe przechowywanie jest uprzejmością, którą można cofnąć zmianą regulaminu. Eksportujcie wszystko, co ma znaczenie, i trzymajcie własną kopię — co jest zarazem odpowiedzią na pytanie o uzależnienie od dostawcy, którego nikt nie zadaje, dopóki nie musi odejść.
Darmowe plany nie podnoszą podłogi dokładności dla waszych konkretnych mówiących. Regionalne akcenty, starsi rozmówcy, audio o jakości telefonicznej i gęste przełączanie kodów — wszystko to pogarsza wynik, a żaden poziom planu nie zmienia tego, ile audio takiego jak wasze widział model. Wyższa opłata kupuje minuty i funkcje, a nie inny rozpoznawacz.
I żadne narzędzie, darmowe czy płatne, nie usuwa etapu przeglądu. Podsumowanie AI zbudowane na nieprzejrzanym transkrypcie dziedziczy każdy jego błąd — pewnym głosem i niewidocznie.
Na koniec: porównywać trzeba nie minuty, tylko wywiady
Każdy darmowy plan w tej kategorii reklamuje pewną ilość czasu. To zła jednostka dla pracy z wywiadami, bo czas ma znaczenie tylko wtedy, gdy przychodzi w jednym ciągłym kawałku. Sto dwadzieścia minut posiekanych na trzyminutowe plasterki jest dla dziennikarza warte mniej niż trzydzieści nieprzerwanych minut, a oba są warte mniej niż sześćdziesiąt minut, które pomieszczą całą rozmowę z nienaruszonymi etykietami mówiących.
Więc porównując narzędzia, przeliczcie każdy darmowy plan na jedyną walutę, która się dla was liczy: ile moich prawdziwych wywiadów to przetranskrybuje, od początku do końca, bez dzielenia pliku? Dla kilku znanych darmowych planów uczciwa odpowiedź brzmi: zero, i nie napiszą wam tego na stronie z cennikiem.
Warstwa rozpoznawania staje się towarem masowym zmierzającym w stronę jednej trzeciej centa za minutę. Dla indonezyjskiego brakuje wciąż zapisu, który da się przeszukać, poprawić, zacytować i nadal znaleźć w przyszłym kwartale.
Gdzie w tym wszystkim jest Telli.sh: jesteśmy jedną z opcji powyżej i powiemy o tym konkretnie. Plan Free w Telli.sh to 60 minut miesięcznie — mniej minut w nagłówku niż 120 u Notty i celowo nieposiekanych trzyminutowym limitem na nagranie, więc cały wywiad wchodzi jako jeden plik. Dostajecie indonezyjski transkrypt, tłumaczenie na dowolny z 44 języków docelowych, podsumowanie AI generowane z transkryptu oraz interfejs dostępny w 15 językach, w tym po indonezyjsku. Powyżej 60 minut miesięcznie to produkt płatny, a jeśli macie mały wolumen i umiecie odpalić skrypt, droga przez API naprawdę wychodzi taniej. Zróbcie na nas test 5-minutowy dokładnie tak samo, jak zrobilibyście go komukolwiek innemu.
Źródła
- Deepgram, "Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian", changelog datowany na 7 sierpnia 2026 roku — ulepszone modele wsadowe dla tamilskiego i indonezyjskiego, ulepszone modele strumieniowe dla tamilskiego i białoruskiego, ormiański (
hy) dodany do obu. - Hugging Face i Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 sierpnia 2026 roku — hindi jako pierwszy język Globalnego Południa w rankingu.
- Cennik Notty, pobrany 31 sierpnia 2026 roku — plan Free 120 minut/miesiąc, maksymalnie 3 minuty na nagranie, 50 wysłanych plików/miesiąc, 10 podsumowań AI/miesiąc; Pro 8,17 $/miesiąc przy płatności rocznej z 1800 minutami/miesiąc.
- Cennik Transkriptora, pobrany 31 sierpnia 2026 roku — Lite 9,99 $/miesiąc (300 minut), Pro 19,99 $/miesiąc (2400 minut, 99,99 $/rok przy rozliczeniu rocznym), Team 30 $/stanowisko/miesiąc (3000 minut na stanowisko).
- Cennik Maestry i lista języków Maestry, pobrane 31 sierpnia 2026 roku — płatność za zużycie 12 $ za 60 kredytów, Lite 23 $/miesiąc za 180 minut; indonezyjski wymieniony dla transkrypcji, tłumaczenia, lektora i trybu czasu rzeczywistego.
- Cennik TurboScribe w wersji zarchiwizowanej przez Internet Archive — plan Free z 3 transkryptami dziennie, limitem 30 minut na plik i wysyłką pojedynczych plików; Unlimited za 10 $/miesiąc, 120 $ rozliczane rocznie, pliki do 10 godzin. Żywa strona zwraca automatom HTTP 403; traktujcie te liczby orientacyjnie i potwierdźcie je w serwisie.
- Cennik Google Cloud Speech-to-Text i obsługiwane języki, pobrane 31 sierpnia 2026 roku — pierwsze 60 minut miesięcznie za darmo, 0,016 $/min z logowaniem danych i 0,024 $/min bez;
id-IDnachirpichirp_2wasia-southeast1. - Cennik API OpenAI, pobrany 31 sierpnia 2026 roku —
gpt-4o-transcribepo 0,006 $/minutę,gpt-4o-mini-transcribepo 0,003 $/minutę. - OpenAI Whisper, na licencji MIT; tabela
LANGUAGESw tokenizerze deklaruje 100 języków, z indonezyjskim (id) na pozycji 17, pobrane 31 sierpnia 2026 roku.