120 minutes gratuites qui ne tiennent pas un seul entretien : ce que la transcription IA gratuite donne vraiment en bahasa indonesia
L'offre gratuite de Notta accorde 120 minutes de transcription par mois et plafonne un enregistrement unique à 3 minutes. TurboScribe donne 3 fichiers par jour avec une limite de 30 minutes. L'API de Google offre 60 minutes gratuites et aucune interface. Le 7 août 2026, Deepgram a livré un modèle indonésien amélioré — sur la voie batch uniquement. Une comparaison testée des offres gratuites qu'un journaliste, un chercheur ou un recruteur en Indonésie rencontre réellement, et des limites qu'aucune d'elles n'affiche.
Vous avez un entretien de 47 minutes sur votre téléphone. Une source à Surabaya, enregistrée ce matin, essentiellement en bahasa indonesia avec les habituelles incrustations d'anglais — deadline, stakeholder, follow up. Il vous faut la transcription aujourd'hui, et vous préféreriez fortement ne pas la payer.
Vous cherchez donc, vous tombez sur un outil qui annonce 120 minutes de transcription gratuites par mois, et vous créez un compte. Vos 47 minutes tiennent largement dans 120. Puis l'envoi échoue, et enfouie dans le tableau comparatif des offres se trouve un second chiffre que personne ne met en titre : transcription maximale par enregistrement, 3 minutes.
Voilà la forme de toute cette catégorie. Les offres gratuites sont vendues sur le chiffre qui semble le plus généreux et bridées par un autre chiffre trois lignes plus bas. Cet article est la comparaison que nous aurions voulu trouver : ce que chaque offre gratuite donne réellement à un entretien en indonésien, ce qu'elle refuse en silence, et comment tester n'importe laquelle en cinq minutes avant de vous engager.
L'essentiel
- Les offres gratuites comportent trois plafonds indépendants — minutes par mois, minutes par fichier et fichiers par jour — et celui qui casse les entretiens est presque toujours la limite par fichier, pas le total mensuel.
- La reconnaissance de l'indonésien s'est réellement améliorée ce mois-ci : Deepgram a livré un modèle Nova-3 indonésien amélioré le 7 août 2026, mais sur la voie batch uniquement, pas en streaming. Envoyer un enregistrement en profite ; le sous-titrage en direct, non.
- Aucun classement public ne mesure la précision en indonésien. L'Open ASR Leaderboard a ajouté sa première langue du Sud global le 28 août 2026, et c'était le hindi. Tant que cela ne change pas, votre propre extrait de test de 5 minutes est le seul benchmark qui décrive votre audio.
Les offres gratuites, côte à côte
Chaque chiffre ci-dessous provient de la grille tarifaire ou de la documentation publiée par l'éditeur, consultées le 31 août 2026. La tâche de référence est un entretien de 47 minutes à deux voix, parce que c'est le fichier que les gens ont réellement.
| Outil | Offre gratuite | Fichier unique le plus long, en gratuit | Indonésien | Premier palier payant |
|---|---|---|---|---|
| Notta | 120 min/mois, 50 envois/mois, 10 résumés IA/mois, 1 siège | 3 minutes | Non confirmé | Pro 8,17 $/mois en facturation annuelle — 1 800 min/mois, fichiers de 5 heures |
| TurboScribe | 3 transcriptions par jour, priorité de file réduite | 30 minutes | Oui | Unlimited 10 $/mois, 120 $ par an — fichiers de 10 heures |
| Transkriptor | Aucune minute mensuelle gratuite publiée | — | Oui | Lite 9,99 $/mois — 300 min/mois |
| Maestra | Aucune minute mensuelle gratuite publiée | — | Oui | À la carte 12 $ pour 60 minutes ; Lite 23 $/mois — 180 min/mois |
| Google Cloud Speech-to-Text | 60 min/mois, puis 0,016 $/min | Pas de plafond pratique | Oui, id-ID | 0,016 $/min avec journalisation des données, 0,024 $/min sans |
| API de transcription OpenAI | Aucune | Pas de plafond pratique | Oui | 0,006 $/min (gpt-4o-transcribe), 0,003 $/min (mini) |
| Whisper, auto-hébergé | Illimité, licence MIT | Votre matériel | Oui | Logiciel libre, votre propre temps GPU |
| Telli.sh | 60 min/mois | Jusqu'au quota | Oui | Les offres payantes commencent à 300 min/mois |
Sources : la page tarifaire de chaque éditeur, consultée le 31 août 2026 ; la documentation Google des langues prises en charge pour id-ID ; les tarifs d'API publiés par OpenAI. La page tarifaire en ligne de TurboScribe bloque la consultation automatisée : ses chiffres viennent donc d'une capture de l'Internet Archive et correspondent à la description de l'offre ailleurs — vérifiez-les avant de vous en servir. Nous n'avons pas pu récupérer de liste de langues chez Notta le 31 août 2026 ; sa prise en charge de l'indonésien est donc notée comme non confirmée plutôt que supposée.
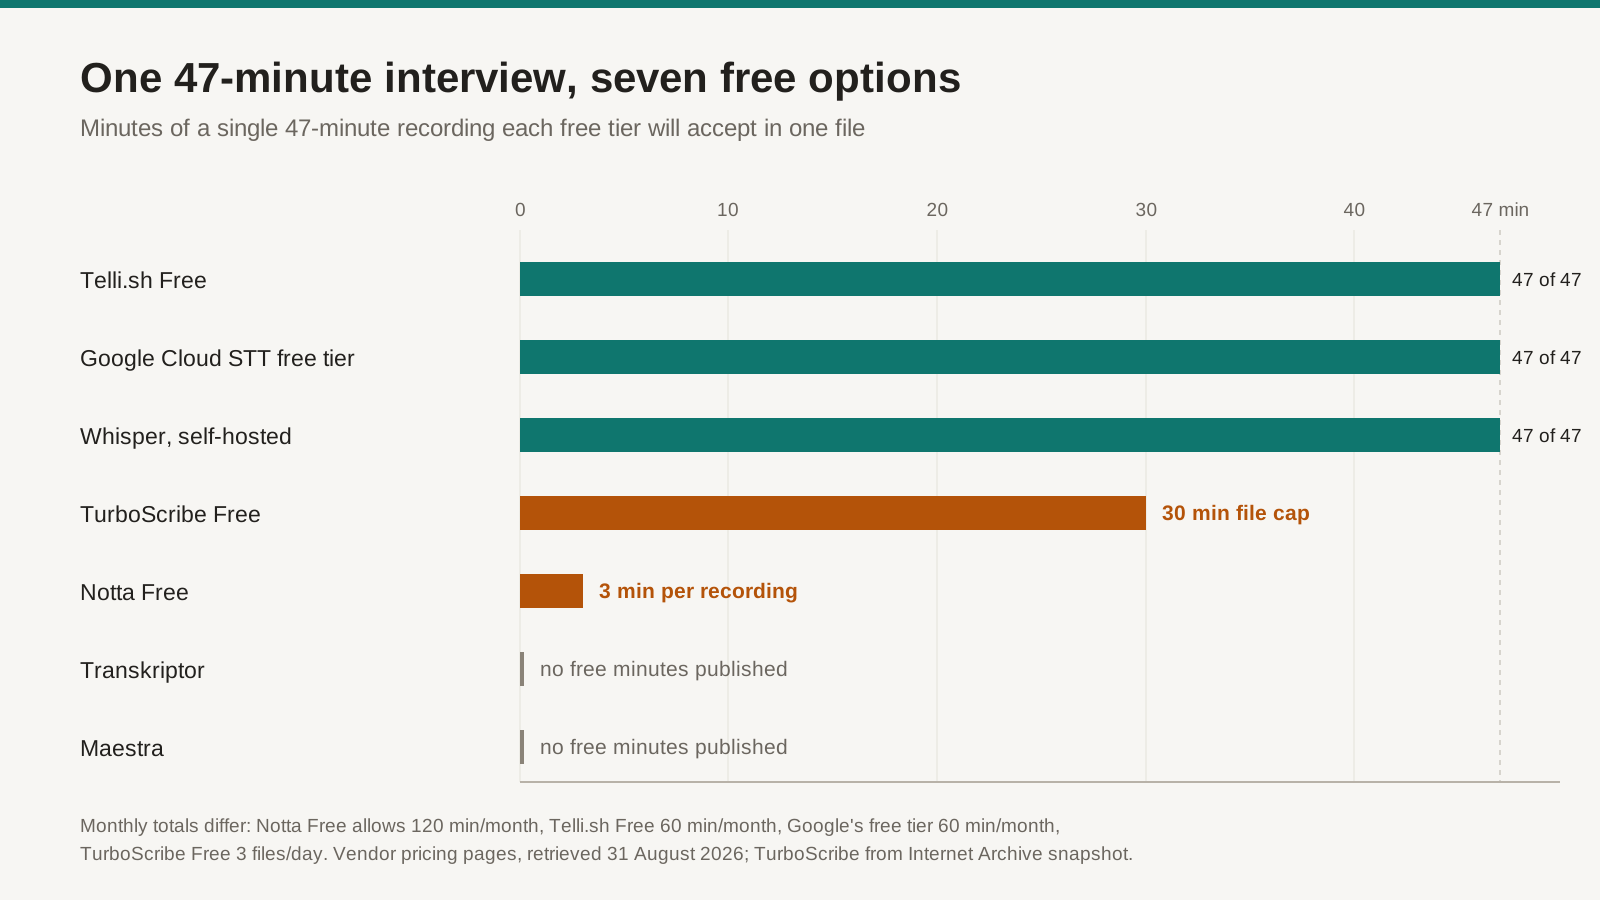
Une seule unité sur un axe : les minutes d'un entretien de 47 minutes acceptées dans un fichier unique. Les quotas mensuels diffèrent et sont indiqués sous le graphique.
Les 120 minutes de Notta sont réelles. C'est le plafond de trois minutes qui casse l'entretien.
Lisez attentivement l'offre gratuite de Notta et vous ne la trouverez pas avare — 120 minutes de transcription par mois, 50 envois de fichiers, 10 résumés IA, 1 000 crédits IA, sans carte bancaire. Pour des mémos vocaux et des appels courts, c'est un quota réellement utile, et c'est plus de minutes mensuelles que ce que la plupart des concurrents offrent.
Puis lisez une ligne plus bas dans le même tableau comparatif : transcription maximale par enregistrement, 3 minutes en gratuit, contre 5 heures en Pro. Vos 120 minutes sont 40 fragments distincts de trois minutes. Un entretien de 47 minutes ne peut tout simplement pas entrer dans le système.
Voici le point, et il dépasse n'importe quel éditeur : une offre gratuite n'est pas un chiffre, c'est trois plafonds, et le marketing cite toujours le plus élevé. Les minutes par mois font le titre. Les minutes par fichier décident si votre entretien est transcriptible. Les fichiers par jour décident si vous pouvez traiter une semaine de terrain un dimanche.
TurboScribe inverse le même arbitrage. Son offre gratuite n'annonce aucun réservoir mensuel de minutes — trois transcriptions par jour, chacune jusqu'à 30 minutes, un fichier à la fois, avec une priorité de file réduite. Trois fichiers de 30 minutes par jour, cela fait 90 minutes d'audio, soit bien au-delà des 120 minutes mensuelles de Notta en deux jours. Mais un entretien de 47 minutes n'entre toujours pas, parce que la contrainte qui mord est de nouveau la limite par fichier. Il vous faudrait découper l'enregistrement, et chaque coupe vous coûte la continuité des locuteurs de part et d'autre.
Transkriptor et Maestra tranchent la tension autrement : pour l'essentiel, ils n'ont pas d'offre gratuite. Les formules publiées par Transkriptor commencent à Lite, 9,99 $ par mois pour 300 minutes de transcription, et montent à Pro à 19,99 $ pour 2 400 minutes (8,33 $ par mois si vous payez 99,99 $ à l'année). Maestra vend des crédits à la carte à 12 $ pour 60 minutes, avec Lite à 23 $ par mois pour 180 minutes. Les deux listent l'indonésien ; le tableau des langues de Maestra le marque pris en charge en transcription, traduction, voix off et temps réel à la fois. Ni l'un ni l'autre ne publie de quota gratuit récurrent, ce qui est une forme d'honnêteté en soi.
L'indonésien s'est amélioré de façon mesurable le 7 août — sur une seule voie
Quelque chose de réel est arrivé à la reconnaissance de l'indonésien ce mois-ci, et presque personne parmi ceux qui couvrent les « outils de transcription IA » ne l'a mentionné.
Le 7 août 2026, Deepgram a publié des modèles monolingues Nova-3 améliorés et ajouté l'arménien. Le changelog est précis d'une manière rare pour une annonce d'éditeur. Sous Batch models : tamoul et indonésien. Sous Streaming models : tamoul et biélorusse.
L'indonésien figure dans une liste et pas dans l'autre.
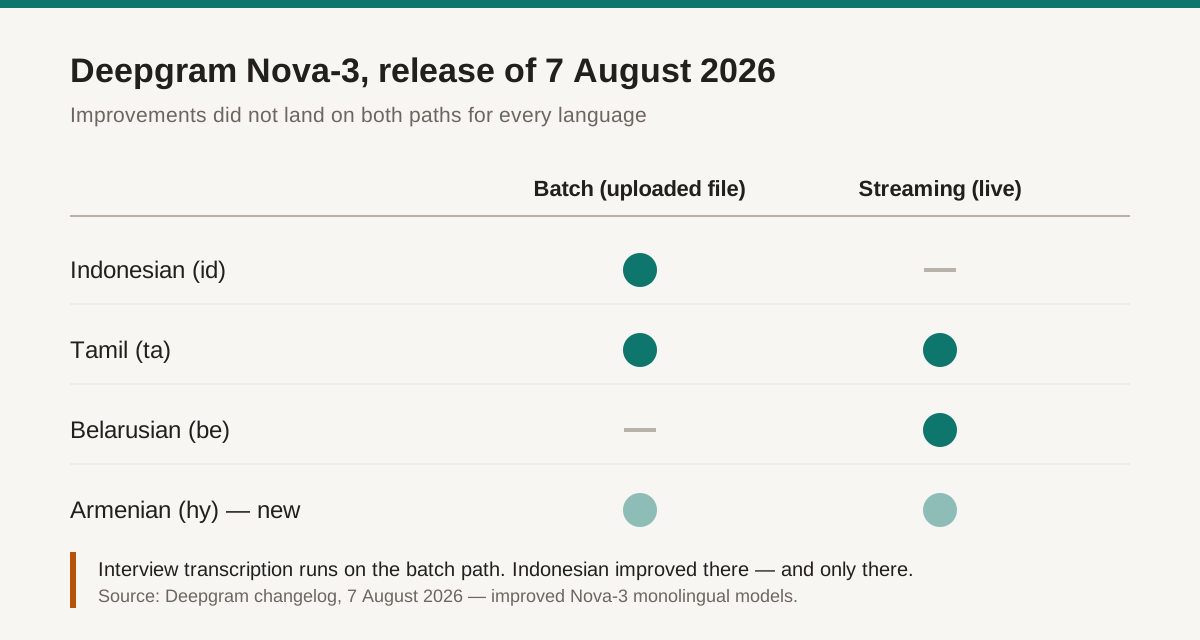
La même publication a amélioré l'indonésien en batch et le biélorusse en streaming. « Meilleure prise en charge de l'indonésien » n'est pas un fait unique. Source : changelog Deepgram, 7 août 2026.
Cette distinction touche directement le travail d'entretien. Le batch est la voie que suit un fichier envoyé : le moteur voit tout l'enregistrement, peut exploiter le contexte dans les deux sens et ne court pas derrière un tampon audio en direct. Le streaming est la voie des sous-titres en direct. Si vous enregistrez un entretien et l'envoyez ensuite, vous êtes sur la voie batch, celle précisément où l'indonésien a progressé ce mois-ci. Si vous espériez des sous-titres indonésiens fiables pendant l'entretien lui-même, ce modèle-là n'a pas bougé le 7 août.
Nous avons écrit la version longue de cet argument dans ce que « pris en charge » cache réellement dans la couverture linguistique de la reconnaissance vocale, parce que le motif se répète dans toute l'industrie : une langue n'est pas prise en charge ou non, elle est prise en charge sur une voie, dans un mode, à un niveau de qualité, à une date donnée. Pour la transcription d'entretiens, la bonne nouvelle est que la voie dont vous avez besoin est celle qui s'est améliorée.
Personne ne publie de benchmark de précision pour l'indonésien : c'est donc à vous d'être le benchmark
Voici la partie inconfortable d'une comparaison honnête : nous ne pouvons pas vous donner de tableau de WER pour l'indonésien, parce qu'il n'en existe aucun de public et de crédible.
L'Open ASR Leaderboard — ce que le domaine a de plus proche d'un tableau de bord neutre — a maintenu un onglet multilingue limité aux langues européennes jusqu'au 28 août 2026, date à laquelle Hugging Face et Voice Arena y ont ajouté le hindi comme première langue du Sud global. L'indonésien, avec environ 280 millions de personnes sur son marché domestique, n'y figure toujours pas. Les éditeurs publient des chiffres de précision pour l'anglais et se taisent ailleurs.
La structure même de Whisper suggère la même asymétrie. Le tokenizer d'OpenAI déclare 100 jetons de langue, et l'indonésien occupe la position 17 dans cette table — honorable, confortablement devant la majorité de la liste, et très loin du volume de données derrière l'anglais, le chinois ou l'espagnol. Un jeton déclaré n'est pas une garantie de qualité ; c'est l'annonce que le modèle tentera la langue.
La conclusion opérationnelle honnête est donc celle-ci : pour l'indonésien, le benchmark, c'est votre propre audio. Pas le fichier de démonstration de l'éditeur, pas un classement, pas la note en étoiles d'un site de tests. Votre enregistreur, votre pièce, l'accent régional de votre interlocuteur, le vocabulaire de votre secteur. Cela ressemble à une échappatoire jusqu'à ce que vous remarquiez que le faire correctement prend environ vingt minutes.
Le test de 5 minutes : faites-le avant de payer qui que ce soit
Prenez une tranche de cinq minutes d'un vrai entretien — idéalement à deux voix, avec du bruit de fond et au moins trois noms propres. Passez-la dans chaque candidat. Puis vérifiez cinq choses, dans cet ordre.
- Comptez les erreurs sur les noms propres. Noms de personnes, d'entreprises, de lieux et termes produit. C'est là que la reconnaissance de l'indonésien échoue avec régularité, et là qu'une erreur fait le plus de dégâts en aval, parce qu'un nom faux se propage silencieusement dans chaque résumé et chaque citation que vous produirez ensuite. Cinq erreurs en cinq minutes, cela fait environ 47 dans votre entretien.
- Vérifiez spécifiquement les lignes en langue mixte. Trouvez une phrase où un mot anglais se glisse dans une proposition indonésienne et lisez ce que l'outil a produit. C'est le test le plus prédictif pour de l'audio professionnel en indonésien, et le seul qu'aucune page éditeur n'aborde.
- Contrôlez l'attribution des locuteurs à la cinquième minute, pas à la première. La diarisation paraît presque toujours parfaite dans les premières secondes. Ce qui compte, c'est de savoir si le Locuteur A est encore le Locuteur A après la première interruption, la première prise de parole simultanée ou le premier long silence.
- Cherchez des horodatages exploitables. Si vous devez un jour vérifier une citation contre l'audio, il vous faut des horodatages ligne par ligne dans l'export, pas seulement dans le lecteur web. Les journalistes et les chercheurs en méthodes qualitatives devraient traiter ce point comme obligatoire.
- Exportez le fichier et ouvrez-le ailleurs. TXT, DOCX, SRT, VTT — ce dont votre flux de travail a besoin. C'est là que les offres gratuites s'arrêtent le plus souvent, et une transcription que vous ne pouvez pas sortir de l'outil est une démonstration, pas une trace.
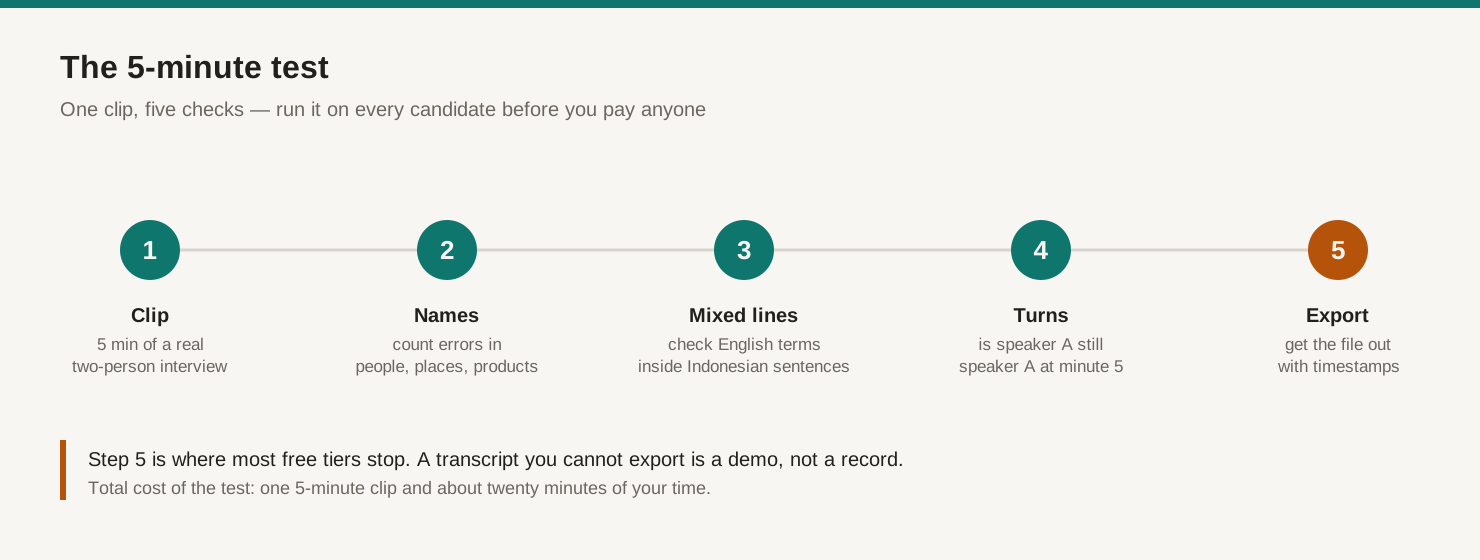
Les cinq vérifications, dans l'ordre où une évaluation réelle les rencontre.
Si vous cherchez le flux de travail qui vient après le choix de l'outil — relire la transcription avant de faire confiance au résumé, garder les citations attachées à l'audio source —, nous l'avons traité à part dans transformer l'audio d'un entretien en transcription et résumé vérifiables.
Là où les entretiens indonésiens cassent vraiment : le mot anglais au milieu de la phrase
L'indonésien professionnel n'est pas monolingue. « Nanti kita follow up setelah meeting dengan tim product » n'est pas de l'indonésien abîmé ; c'est la façon dont parle un chef de produit à Jakarta, et à peu près celle d'un recruteur, d'un consultant ou d'un fondateur de start-up. Toute transcription qui massacre les fragments anglais a massacré exactement les termes dont dépendent vos notes.
C'est la chose la plus difficile de la catégorie, et il vaut la peine de comprendre pourquoi. La plupart des moteurs vocaux exécutent un modèle monolingue par requête. Vous réglez la langue sur l'indonésien, et le modèle est au mieux de sa forme sur la phonétique et le lexique indonésiens — ce qui signifie qu'un mot anglais arrivant en milieu de phrase est soit translittéré en quelque chose de forme indonésienne, soit perdu. Régler sur l'anglais ne fait qu'inverser les dégâts. Des modes multilingues ou d'alternance codique existent, mais ils sont plus étroits que les listes monolingues : en août 2026, Nova-3 de Deepgram documente 58 langues une à une et l'alternance codique dans exactement 10.
Deux parades pratiques, toutes deux peu coûteuses. D'abord, réglez explicitement la langue source sur l'indonésien plutôt que de laisser la détection automatique — l'automatique s'engage sur une supposition tirée des secondes les moins contextuelles de tout le fichier, et une erreur dégrade tout l'aval d'un coup. Ensuite, si l'outil propose un lexique personnalisé ou une liste de mots-clés, entrez-y vos termes anglais récurrents et vos noms propres avant le traitement, pas après.
Appelons cela le problème du gado-gado, du nom de la salade indonésienne où tout arrive mélangé dans la même assiette : l'audio est mixte par nature, et chaque moteur veut le servir comme un plat unique.
Si vous savez coder, transcrire coûte moins cher qu'un café
La comparaison des offres gratuites change entièrement de forme dès que vous acceptez de toucher à une API, et les chiffres valent d'être connus même si vous décidez de ne pas le faire.
OpenAI facture 0,006 $ par minute pour gpt-4o-transcribe et 0,003 $ par minute pour la variante mini. Votre entretien de 47 minutes coûte 28 centimes, ou 14 centimes en mini. Google Cloud Speech-to-Text offre les 60 premières minutes par mois, puis 0,016 $ par minute avec la journalisation des données activée et 0,024 $ sans, et liste id-ID sur ses modèles chirp et chirp_2 dans la région asia-southeast1. Whisper est sous licence MIT et ne coûte rien d'autre que votre propre matériel.
À ces prix, la reconnaissance elle-même est quasiment gratuite. Ce que vous achetez réellement à un produit grand public, c'est tout ce qui l'entoure : une interface d'envoi, l'attribution des locuteurs, les horodatages, un éditeur, la recherche dans les anciens entretiens, les résumés, les exports, et un endroit où la trace existe encore dans six mois.
Voilà la formulation honnête de la question « construire ou acheter ». Si vous avez trois entretiens par an et savez lancer un script Python, lancez le script. Si vous en avez trois par semaine et devez retrouver une citation de mars, vous ne cherchez pas de la reconnaissance — vous cherchez un système de classement avec de la reconnaissance greffée dessus.
Ce qu'aucune offre gratuite ne fera pour vous
Jouons franc jeu : voici les limites qui valent pour toutes les options du tableau, la nôtre comprise.
Les offres gratuites ne vous donnent pas de diarisation fiable. C'est l'une des parties les plus coûteuses de la chaîne et elle est couramment réservée aux formules payantes dans toute la catégorie. Si séparer deux locuteurs est essentiel à votre travail, budgétez-le au lieu d'espérer.
Les offres gratuites ne promettent pas de conservation. Le stockage coûte de l'argent ; un stockage gratuit est une politesse révocable par un changement de conditions. Exportez tout ce qui compte et gardez votre propre copie — ce qui répond aussi à la question de la dépendance à l'éditeur, que personne ne pose avant de vouloir partir.
Les offres gratuites ne relèvent pas le plancher de précision pour vos locuteurs à vous. Accents régionaux, personnes âgées, audio de qualité téléphonique et forte alternance codique dégradent le résultat, et aucun palier tarifaire ne change l'exposition du modèle sous-jacent à votre audio. Payer plus vous achète des minutes et des fonctions, pas un autre moteur de reconnaissance.
Et aucun outil, gratuit ou payant, ne supprime la relecture. Un résumé IA bâti sur une transcription non relue hérite de chacune de ses erreurs, avec aplomb et sans se voir.
Au fond : l'unité à comparer n'est pas la minute, c'est l'entretien
Toutes les offres gratuites de cette catégorie mettent en avant une quantité de temps. C'est la mauvaise unité pour le travail d'entretien, parce que le temps ne compte que s'il vient d'un seul tenant. Cent vingt minutes découpées en tranches de trois minutes valent moins, pour un journaliste, que trente minutes ininterrompues, et les deux valent moins que soixante minutes qui tiennent une conversation entière avec l'attribution des locuteurs intacte.
Alors quand vous comparez des outils, convertissez chaque offre gratuite dans la seule monnaie qui compte pour vous : combien de mes entretiens réels ceci transcrit-il de bout en bout, sans découper le fichier ? Pour plusieurs offres gratuites bien connues, la réponse honnête est zéro, et la page tarifaire ne vous le dira pas.
La couche de reconnaissance est une commodité qui file vers un tiers de centime la minute. Ce qui reste rare pour l'indonésien, c'est une trace que vous pouvez chercher, corriger, citer, et retrouver encore le trimestre prochain.
Où Telli.sh s'inscrit : nous sommes une option parmi celles ci-dessus, et nous allons être précis. L'offre gratuite de Telli.sh, c'est 60 minutes par mois — moins de minutes affichées que les 120 de Notta, et délibérément sans plafond de trois minutes par enregistrement, si bien qu'un entretien complet entre en un seul fichier. Vous obtenez la transcription en indonésien, la traduction vers l'une des 44 langues cibles, un résumé IA généré à partir de la transcription, et une interface disponible en 15 langues, dont le bahasa indonesia. Au-delà de 60 minutes par mois, c'est un produit payant, et si votre volume est faible et que vous savez lancer un script, la voie API coûte réellement moins cher. Faites-nous passer le test de 5 minutes exactement comme vous le feriez pour n'importe qui d'autre.
Envoyer un enregistrement d'entretien
Sources
- Deepgram, "Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian", changelog daté du 7 août 2026 — modèles batch améliorés pour le tamoul et l'indonésien, modèles streaming améliorés pour le tamoul et le biélorusse, arménien (
hy) ajouté pour les deux. - Hugging Face et Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 août 2026 — le hindi comme première langue du Sud global du classement.
- Tarifs Notta, consultés le 31 août 2026 — offre gratuite de 120 minutes/mois, maximum de 3 minutes par enregistrement, 50 envois de fichiers/mois, 10 résumés IA/mois ; Pro à 8,17 $/mois en facturation annuelle avec 1 800 minutes/mois.
- Tarifs Transkriptor, consultés le 31 août 2026 — Lite 9,99 $/mois (300 minutes), Pro 19,99 $/mois (2 400 minutes, 99,99 $ à l'année), Team 30 $/siège/mois (3 000 minutes par siège).
- Tarifs Maestra et langues prises en charge par Maestra, consultés le 31 août 2026 — à la carte 12 $ pour 60 crédits, Lite 23 $/mois pour 180 minutes ; indonésien listé en transcription, traduction, voix off et temps réel.
- Tarifs TurboScribe tels que capturés par l'Internet Archive — offre gratuite de 3 transcriptions par jour avec une limite de 30 minutes par fichier et envoi d'un fichier à la fois ; Unlimited à 10 $/mois, 120 $ facturés à l'année, fichiers de 10 heures. La page en ligne renvoie un HTTP 403 aux requêtes automatisées ; considérez ces chiffres comme indicatifs et confirmez-les sur le site.
- Tarifs Google Cloud Speech-to-Text et langues prises en charge, consultés le 31 août 2026 — 60 premières minutes gratuites par mois, 0,016 $/min avec journalisation des données et 0,024 $/min sans ;
id-IDsurchirpetchirp_2enasia-southeast1. - Tarifs de l'API OpenAI, consultés le 31 août 2026 —
gpt-4o-transcribeà 0,006 $/minute,gpt-4o-mini-transcribeà 0,003 $/minute. - OpenAI Whisper, sous licence MIT ; la table
LANGUAGESdu tokenizer déclare 100 langues avec l'indonésien (id) en position 17, consultée le 31 août 2026.