120 minutos gratis que no dan ni para una entrevista: qué ofrece de verdad la transcripción con IA gratuita en bahasa indonesia
El plan gratuito de Notta concede 120 minutos de transcripción al mes y limita cada grabación a 3 minutos. TurboScribe da 3 archivos al día con un techo de 30 minutos. La API de Google entrega 60 minutos gratis y ninguna interfaz. El 7 de agosto de 2026, Deepgram lanzó un modelo indonesio mejorado, solo en la vía batch. Una comparación probada de los planes gratuitos con los que se topan de verdad periodistas, investigadores y entrevistadores de RR. HH. en Indonesia, y de los límites que ninguno de ellos anuncia.
Tiene una entrevista de 47 minutos en el móvil. Una fuente en Surabaya, grabada esta mañana, casi toda en bahasa indonesia con la habitual dispersión de inglés: deadline, stakeholder, follow up. Necesita la transcripción hoy y preferiría con ganas no pagar por ella.
Así que busca, aterriza en una herramienta que anuncia 120 minutos de transcripción gratis al mes y se registra. Sus 47 minutos caben de sobra en 120. Entonces falla la subida y, enterrado en la tabla comparativa de planes, aparece un segundo número que nadie pone en el titular: transcripción máxima por grabación, 3 minutos.
Esa es la forma de toda esta categoría. Los planes gratuitos se anuncian con el número que suena más generoso y se limitan con otro número tres filas más abajo. Este artículo es la comparación que nos habría gustado encontrar: qué le da realmente cada plan gratuito a una entrevista en indonesio, qué le niega en silencio y cómo probar cualquiera de ellos en cinco minutos antes de comprometerse.
En resumen
- Los planes gratuitos tienen tres techos independientes — minutos al mes, minutos por archivo y archivos al día — y el que rompe las entrevistas es casi siempre el límite por archivo, no el total mensual.
- El reconocimiento del indonesio mejoró de verdad este mes: Deepgram lanzó un modelo Nova-3 indonesio mejorado el 7 de agosto de 2026, pero solo en la vía batch, no en streaming. Subir una grabación se beneficia; los subtítulos en vivo, no.
- Ninguna clasificación pública mide la precisión en indonesio. El Open ASR Leaderboard incorporó su primer idioma del Sur Global el 28 de agosto de 2026, y fue el hindi. Hasta que eso cambie, su propio clip de prueba de 5 minutos es el único benchmark que describe su audio.
Los planes gratuitos, uno al lado del otro
Cada cifra de abajo procede de los precios o la documentación publicados por el propio proveedor, consultados el 31 de agosto de 2026. El trabajo de referencia es una entrevista de 47 minutos con dos personas, porque ese es el archivo que la gente tiene de verdad.
| Herramienta | Plan gratuito | Archivo único más largo, en gratis | Indonesio | Punto de entrada de pago |
|---|---|---|---|---|
| Notta | 120 min/mes, 50 subidas/mes, 10 resúmenes con IA/mes, 1 puesto | 3 minutos | Sin confirmar | Pro 8,17 $/mes con facturación anual — 1.800 min/mes, archivos de 5 horas |
| TurboScribe | 3 transcripciones al día, prioridad de cola más baja | 30 minutos | Sí | Unlimited 10 $/mes, 120 $ al año — archivos de 10 horas |
| Transkriptor | No publica minutos mensuales gratuitos | — | Sí | Lite 9,99 $/mes — 300 min/mes |
| Maestra | No publica minutos mensuales gratuitos | — | Sí | Pago por uso 12 $ por 60 minutos; Lite 23 $/mes — 180 min/mes |
| Google Cloud Speech-to-Text | 60 min/mes, después 0,016 $/min | Sin techo práctico | Sí, id-ID | 0,016 $/min con registro de datos, 0,024 $/min sin él |
| API de transcripción de OpenAI | Ninguno | Sin techo práctico | Sí | 0,006 $/min (gpt-4o-transcribe), 0,003 $/min (mini) |
| Whisper, autoalojado | Ilimitado, licencia MIT | Su hardware | Sí | Software libre, su propio tiempo de GPU |
| Telli.sh | 60 min/mes | Hasta agotar la cuota | Sí | Los planes de pago empiezan en 300 min/mes |
Fuentes: la página de precios de cada proveedor, consultada el 31 de agosto de 2026; la documentación de idiomas compatibles de Google para id-ID; los precios de API publicados por OpenAI. La página de precios en vivo de TurboScribe bloquea la consulta automatizada, así que sus cifras salen de una captura del Internet Archive y coinciden con cómo se describe el plan en otros sitios: verifíquelas antes de apoyarse en ellas. El 31 de agosto de 2026 no pudimos obtener una lista de idiomas de Notta, así que su compatibilidad con el indonesio queda marcada como sin confirmar en lugar de darse por supuesta.
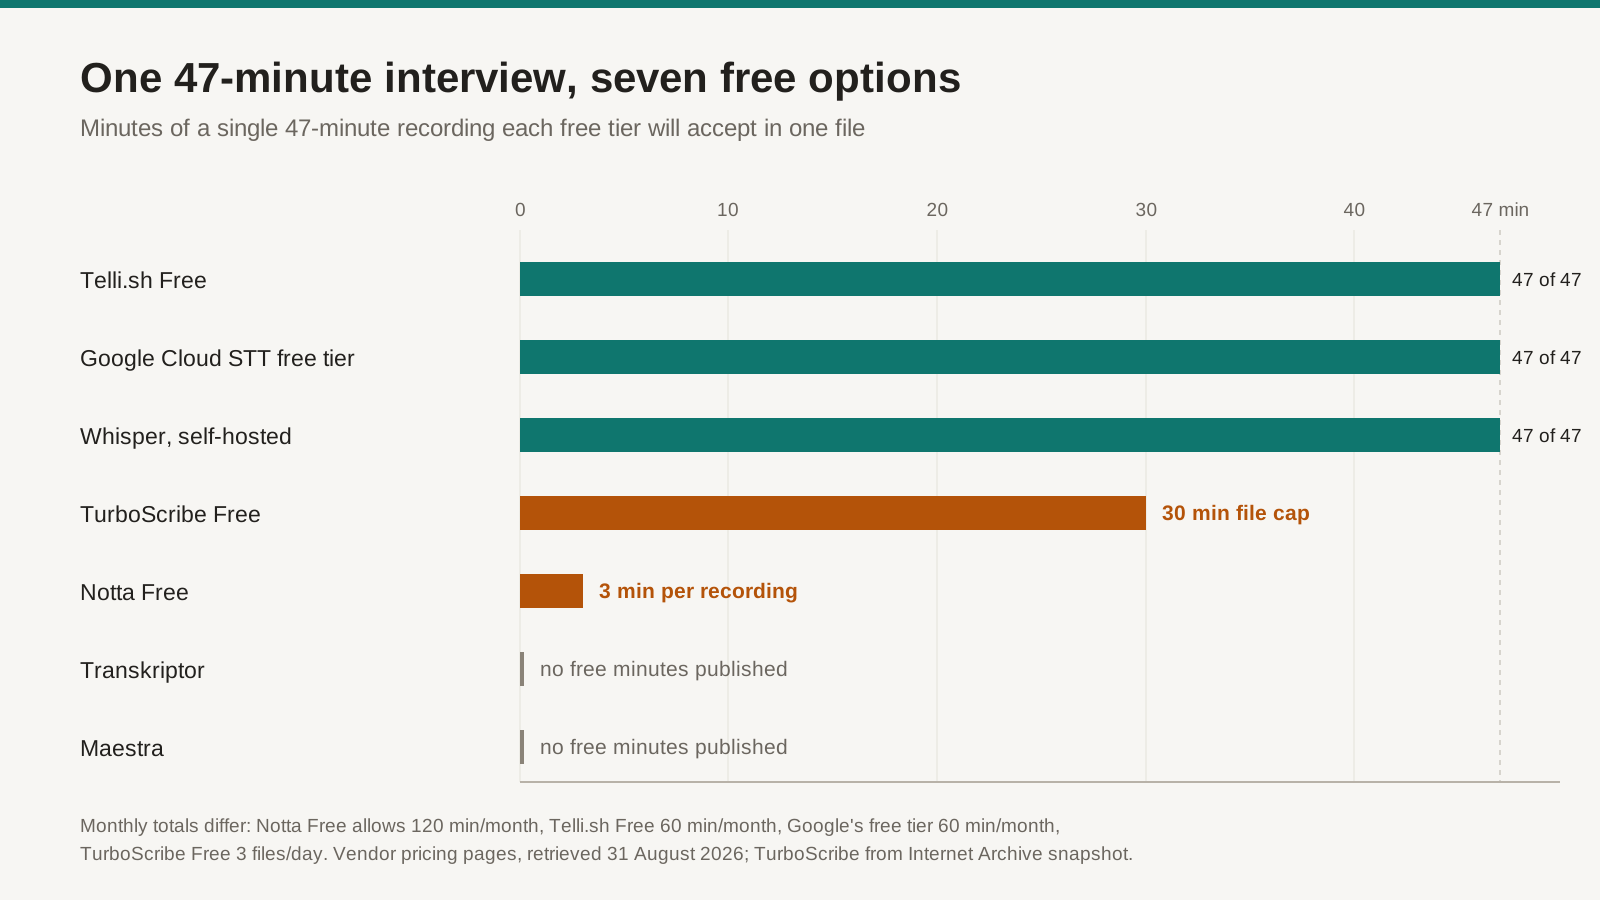
Una misma unidad en un eje: minutos de una entrevista de 47 minutos aceptados en un único archivo. Las cuotas mensuales difieren y se indican debajo del gráfico.
Los 120 minutos de Notta son reales. Lo que rompe la entrevista es el techo de tres minutos.
Lea con calma el plan gratuito de Notta y no lo encontrará tacaño: 120 minutos de transcripción al mes, 50 subidas de archivos, 10 resúmenes con IA, 1.000 créditos de IA y ninguna tarjeta de crédito. Para notas de voz y llamadas cortas es una cuota realmente útil, y son más minutos mensuales de los que regala la mayoría de la competencia.
Ahora lea una fila más abajo en esa misma tabla comparativa: transcripción máxima por grabación, 3 minutos en el plan gratuito, frente a 5 horas en Pro. Sus 120 minutos son 40 fragmentos sueltos de tres minutos. Una entrevista de 47 minutos no llega siquiera a entrar en el sistema.
Aquí está el punto, y va más allá de cualquier proveedor concreto: un plan gratuito no es un número, son tres techos, y el marketing cita siempre el más alto. Los minutos al mes son el titular. Los minutos por archivo son los que deciden si su entrevista es transcribible. Los archivos al día son los que deciden si puede procesar una semana de trabajo de campo un domingo.
TurboScribe invierte el mismo trato. Su plan gratuito no anuncia bolsa mensual de minutos: tres transcripciones al día, cada una de hasta 30 minutos, un archivo cada vez, con prioridad de cola más baja. Tres archivos de 30 minutos al día son 90 minutos de audio, muy por encima de los 120 mensuales de Notta en dos días. Pero una entrevista de 47 minutos sigue sin caber, porque la restricción que aprieta vuelve a ser el límite por archivo. Tendría que partir la grabación, y cada corte le cuesta la continuidad de los hablantes a ambos lados.
Transkriptor y Maestra resuelven la tensión de otra manera: en la práctica no tienen plan gratuito. Los planes publicados de Transkriptor arrancan en Lite, 9,99 $ al mes por 300 minutos de transcripción, y suben a Pro por 19,99 $ con 2.400 minutos (8,33 $ al mes si paga 99,99 $ por el año). Maestra vende créditos de pago por uso a 12 $ por 60 minutos, con Lite a 23 $ al mes por 180 minutos. Ambos listan el indonesio; la tabla de idiomas de Maestra lo marca como compatible por igual para transcripción, traducción, locución y tiempo real. Ninguno publica una cuota gratuita recurrente, lo cual es su propia forma de honestidad.
El indonesio mejoró de forma medible el 7 de agosto, en exactamente una vía
Algo real le ocurrió este mes al reconocimiento del indonesio, y casi nadie de los que cubren «herramientas de transcripción con IA» lo mencionó.
El 7 de agosto de 2026, Deepgram publicó modelos monolingües Nova-3 mejorados y añadió el armenio. El changelog es específico de una forma que rara vez lo son los anuncios de proveedor. Bajo Batch models: tamil e indonesio. Bajo Streaming models: tamil y bielorruso.
El indonesio aparece en una lista y no en la otra.
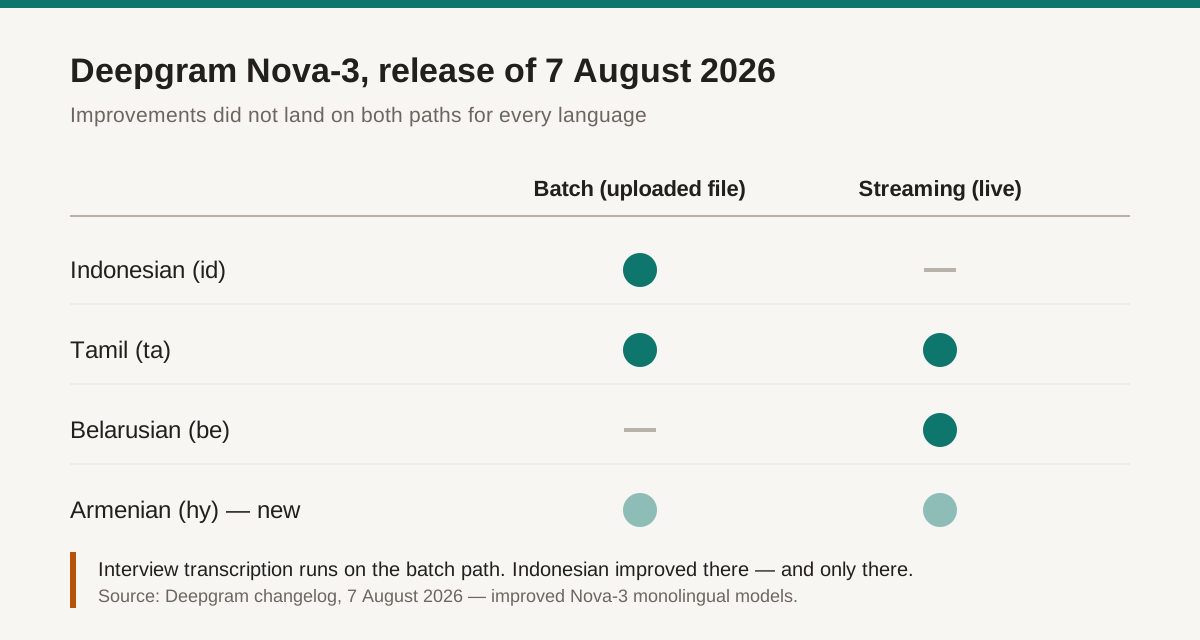
La misma publicación mejoró el indonesio en batch y el bielorruso en streaming. «Mejor compatibilidad con el indonesio» no es un único hecho. Fuente: changelog de Deepgram, 7 de agosto de 2026.
Esa distinción cae de lleno sobre el trabajo con entrevistas. Batch es la vía que sigue un archivo subido: el motor ve la grabación entera, puede usar contexto en ambas direcciones y no va persiguiendo un búfer de audio en vivo. Streaming es la vía de los subtítulos en directo. Si graba una entrevista y la sube después, está en la vía batch, que es justo la vía en la que el indonesio mejoró este mes. Si esperaba subtítulos indonesios fiables durante la propia entrevista, ese modelo concreto no cambió el 7 de agosto.
La versión larga de este argumento la escribimos en qué esconde en realidad la palabra «compatible» en la cobertura de idiomas del reconocimiento de voz, porque el patrón se repite en todo el sector: un idioma no está soportado o no soportado, está soportado en una vía, en un modo, en un nivel de calidad y a una fecha. Para la transcripción de entrevistas en concreto, la buena noticia es que la vía que usted necesita es la que mejoró.
Nadie publica un benchmark de precisión para el indonesio, así que le toca a usted ser el benchmark
Esta es la parte incómoda de escribir una comparación honesta: no podemos darle una tabla de WER para el indonesio, porque no existe ninguna pública y creíble.
El Open ASR Leaderboard — lo más parecido a un marcador neutral que tiene el campo — mantuvo una pestaña multilingüe que solo cubría idiomas europeos hasta el 28 de agosto de 2026, cuando Hugging Face y Voice Arena añadieron el hindi como su primer idioma del Sur Global. El indonesio, con unos 280 millones de personas en su mercado doméstico, sigue sin estar. Los proveedores publican cifras de precisión para el inglés y callan en todo lo demás.
La propia estructura de Whisper apunta a la misma asimetría. El tokenizador de OpenAI declara 100 tokens de idioma, y el indonesio ocupa la posición 17 de esa tabla: respetable, cómodamente por delante de la mayor parte de la lista y muy lejos del volumen de datos que hay detrás del inglés, el chino o el español. Un token declarado no es una garantía de calidad; es la afirmación de que el modelo intentará ese idioma.
Así que la conclusión operativa honesta es esta: para el indonesio, el benchmark es su propio audio. No el archivo de demostración del proveedor, ni una clasificación, ni las estrellas de una web de reseñas. Su grabadora, su sala, el acento regional de su entrevistado, el vocabulario de su sector. Suena a excusa hasta que uno se da cuenta de que hacerlo bien lleva unos veinte minutos.
La prueba de 5 minutos: hágala antes de pagar a nadie
Coja un fragmento de cinco minutos de una entrevista real, idealmente con dos hablantes, ruido de fondo y al menos tres nombres propios. Páselo por cada candidato. Después compruebe cinco cosas, en este orden.
- Cuente los errores en nombres propios. Nombres de personas, empresas, lugares y términos de producto. Ahí es donde el reconocimiento del indonesio falla con regularidad y donde un error hace más daño río abajo, porque un nombre equivocado se propaga en silencio a cada resumen y cada cita que genere después. Cinco errores en cinco minutos son unos 47 en su entrevista.
- Revise específicamente las líneas en idioma mixto. Busque una frase en la que una palabra inglesa quede dentro de una oración indonesia y lea lo que produjo la herramienta. Es la prueba más predictiva para audio profesional en indonesio, y la única que ninguna página de proveedor aborda.
- Verifique las etiquetas de hablante en el minuto cinco, no en el minuto uno. La diarización suele parecer perfecta en los primeros segundos. Lo que importa es si el Hablante A sigue siendo el Hablante A después de la primera interrupción, el primer solapamiento o la primera pausa larga.
- Busque marcas de tiempo con las que pueda trabajar. Si alguna vez va a necesitar contrastar una cita con el audio, necesita marcas de tiempo por línea en la exportación, no solo en el reproductor web. Periodistas e investigadores cualitativos deberían tratar esto como obligatorio.
- Exporte el archivo y ábralo en otro sitio. TXT, DOCX, SRT, VTT: lo que su flujo de trabajo necesite. Aquí es donde más a menudo se detienen los planes gratuitos, y una transcripción que no puede sacar de la herramienta es una demostración, no un registro.
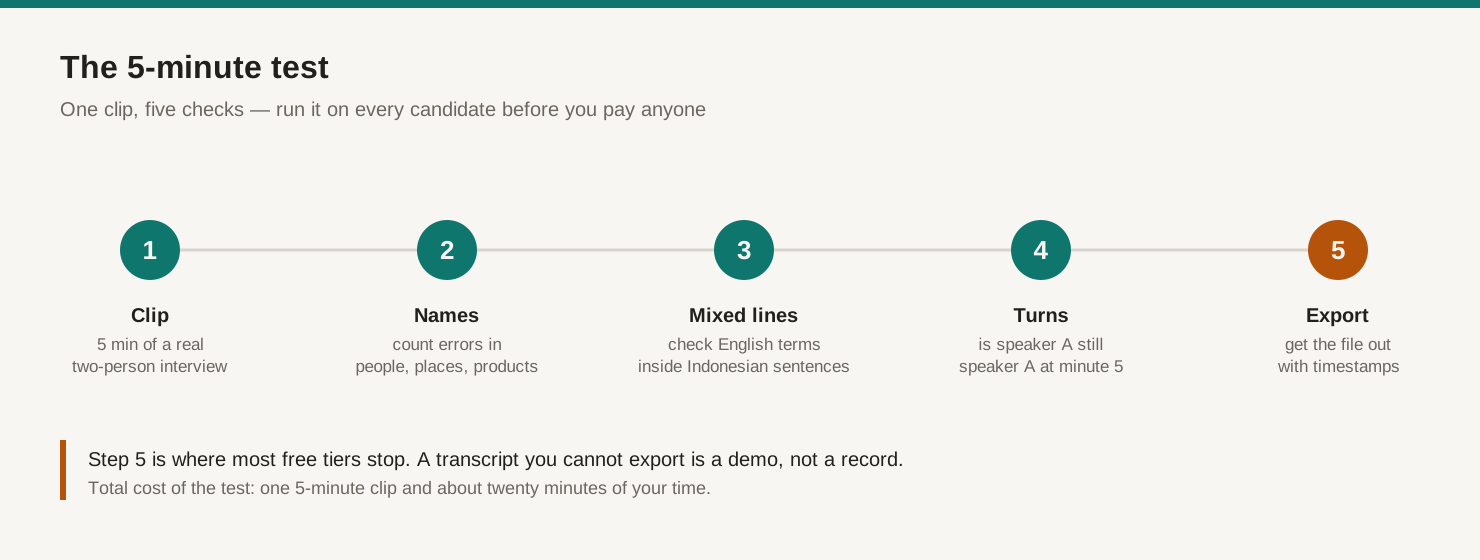
Las cinco comprobaciones, en el orden en que las encuentra una evaluación real.
Si busca el flujo de trabajo que viene después de elegir herramienta — revisar la transcripción antes de fiarse del resumen, mantener las citas atadas al audio original —, lo tratamos aparte en convertir el audio de una entrevista en una transcripción y un resumen revisables.
Dónde se rompen de verdad las entrevistas en indonesio: en la palabra inglesa en mitad de la frase
El indonesio profesional no es monolingüe. «Nanti kita follow up setelah meeting dengan tim product» no es indonesio roto; es como habla un jefe de producto en Yakarta, y más o menos como hablan también un reclutador, un consultor y un fundador de startup. Cualquier transcripción que destroce los fragmentos en inglés ha destrozado justo los términos de los que dependen sus notas.
Esto es lo más difícil de la categoría, y merece la pena entender por qué. La mayoría de los motores de voz ejecutan un modelo monolingüe por petición. Usted fija el idioma en indonesio, y el modelo está en su mejor forma con la fonética y el vocabulario indonesios, lo que significa que una palabra inglesa que llega a mitad de frase o se translitera a algo de forma indonesia o se pierde. Fijar el idioma en inglés solo invierte el daño. Existen modos multilingües o de alternancia de código, pero son más estrechos que las listas monolingües: a agosto de 2026, Nova-3 de Deepgram documenta 58 idiomas de uno en uno y alternancia de código en exactamente 10.
Dos mitigaciones prácticas, ambas baratas. Primera: fije explícitamente el idioma de origen en indonesio en lugar de dejar la detección automática; la detección se compromete con una suposición tomada de los segundos con menos contexto de todo el archivo, y un error degrada de golpe todo lo que viene después. Segunda: si la herramienta ofrece vocabulario personalizado o lista de palabras clave, meta ahí sus términos ingleses recurrentes y sus nombres propios antes de la ejecución, no después.
Llámelo el problema del gado-gado, por la ensalada indonesia en la que todo llega mezclado en el mismo plato: el audio viene mezclado por diseño, y cada motor quiere servirlo como un solo plato.
Si sabe programar, transcribir cuesta menos que un café
La comparación de planes gratuitos cambia de forma por completo si está dispuesto a tocar una API, y las cifras merecen conocerse aunque decida no hacerlo.
OpenAI cobra 0,006 $ por minuto por gpt-4o-transcribe y 0,003 $ por minuto por la variante mini. Su entrevista de 47 minutos cuesta 28 céntimos, o 14 céntimos en mini. Google Cloud Speech-to-Text regala los primeros 60 minutos al mes y después cobra 0,016 $ por minuto con el registro de datos activado y 0,024 $ sin él, y lista id-ID tanto en chirp como en chirp_2 en la región asia-southeast1. Whisper tiene licencia MIT y no cuesta nada más allá de su propio hardware.
A esos precios, el reconocimiento en sí es casi gratis. Lo que en realidad compra en cualquier producto de consumo es todo lo que lo rodea: una interfaz de subida, etiquetas de hablante, marcas de tiempo, un editor, búsqueda entre entrevistas antiguas, resúmenes, exportaciones y un lugar donde el registro siga estando dentro de seis meses.
Ese es el planteamiento honesto de la disyuntiva entre construir y comprar. Si tiene tres entrevistas al año y sabe ejecutar un script de Python, ejecute el script. Si tiene tres a la semana y necesita encontrar una cita de marzo, no está comprando reconocimiento: está comprando un archivador con reconocimiento incorporado.
Lo que ningún plan gratuito hará por usted
Seamos justos, así que aquí van los límites que se aplican a todas las opciones de la mesa, la nuestra incluida.
Los planes gratuitos no le dan diarización fiable. Es una de las partes más caras de la cadena y en toda la categoría se reserva de forma rutinaria a los planes de pago. Si separar dos hablantes es esencial para su trabajo, presupuéstelo en lugar de confiar en la suerte.
Los planes gratuitos no prometen conservación. El almacenamiento cuesta dinero; el almacenamiento gratuito es una cortesía que un cambio de política puede revocar. Exporte todo lo que importe y guarde su propia copia, que además es la respuesta a la pregunta sobre dependencia del proveedor que nadie hace hasta que necesita marcharse.
Los planes gratuitos no elevan el suelo de precisión para sus hablantes concretos. Los acentos regionales, los entrevistados mayores, el audio con calidad de teléfono y la alternancia de código intensa degradan el resultado, y ningún nivel de plan cambia la exposición del modelo subyacente a su audio. Pagar más le compra minutos y funciones, no un reconocedor distinto.
Y ninguna herramienta, gratuita o de pago, elimina la pasada de revisión. Un resumen de IA construido sobre una transcripción sin revisar hereda todos sus errores, con aplomo y de forma invisible.
En el fondo: la unidad que hay que comparar no son minutos, son entrevistas
Todos los planes gratuitos de esta categoría anuncian una cantidad de tiempo. Es la unidad equivocada para el trabajo con entrevistas, porque el tiempo solo importa si viene en una pieza continua. Ciento veinte minutos troceados en rodajas de tres minutos valen menos para un periodista que treinta minutos ininterrumpidos, y ambos valen menos que sesenta minutos capaces de sostener una conversación entera con las etiquetas de hablante intactas.
Así que, cuando compare herramientas, convierta cada plan gratuito a la única moneda que le importa: ¿cuántas de mis entrevistas reales transcribe esto de principio a fin, sin partir el archivo? Para varios planes gratuitos muy conocidos, la respuesta honesta es cero, y eso no se lo dirán en la página de precios.
La capa de reconocimiento es un producto básico camino de un tercio de céntimo por minuto. Lo que sigue siendo escaso para el indonesio es un registro que pueda buscar, corregir, citar y seguir encontrando el trimestre que viene.
Dónde encaja Telli.sh: somos una opción entre las varias de arriba, y vamos a ser concretos. El plan gratuito de Telli.sh son 60 minutos al mes — menos minutos de titular que los 120 de Notta y, deliberadamente, sin trocear por un tope de tres minutos por grabación, de modo que una entrevista completa entra como un solo archivo. Obtiene la transcripción en indonesio, traducción a cualquiera de 44 idiomas de destino, un resumen con IA generado a partir de la transcripción y una interfaz disponible en 15 idiomas, incluido el bahasa indonesia. Más allá de 60 minutos al mes es un producto de pago y, si su volumen es bajo y sabe ejecutar un script, la vía de la API sale de verdad más barata. Háganos la prueba de 5 minutos igual que se la haría a cualquier otro.
Subir una grabación de entrevista
Fuentes
- Deepgram, "Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian", changelog con fecha de 7 de agosto de 2026 — modelos batch mejorados para tamil e indonesio, modelos de streaming mejorados para tamil y bielorruso, armenio (
hy) añadido en ambos. - Hugging Face y Voice Arena, "The Open ASR Leaderboard Adds Its First Global South Language", 28 de agosto de 2026 — el hindi como primer idioma del Sur Global de la clasificación.
- Precios de Notta, consultados el 31 de agosto de 2026 — plan gratuito de 120 minutos/mes, máximo de 3 minutos por grabación, 50 subidas de archivos/mes, 10 resúmenes con IA/mes; Pro a 8,17 $/mes con facturación anual y 1.800 minutos/mes.
- Precios de Transkriptor, consultados el 31 de agosto de 2026 — Lite 9,99 $/mes (300 minutos), Pro 19,99 $/mes (2.400 minutos, 99,99 $ al año), Team 30 $/puesto/mes (3.000 minutos por puesto).
- Precios de Maestra e idiomas compatibles de Maestra, consultados el 31 de agosto de 2026 — pago por uso 12 $ por 60 créditos, Lite 23 $/mes por 180 minutos; indonesio listado para transcripción, traducción, locución y tiempo real.
- Precios de TurboScribe según la captura del Internet Archive — plan gratuito de 3 transcripciones diarias con tope de 30 minutos por archivo y subidas de un solo archivo; Unlimited a 10 $/mes, 120 $ facturados al año, archivos de 10 horas. La página en vivo devuelve HTTP 403 a las consultas automatizadas; trate estas cifras como orientativas y confírmelas en el sitio.
- Precios de Google Cloud Speech-to-Text e idiomas compatibles, consultados el 31 de agosto de 2026 — primeros 60 minutos al mes gratis, 0,016 $/min con registro de datos y 0,024 $/min sin él;
id-IDenchirpychirp_2enasia-southeast1. - Precios de la API de OpenAI, consultados el 31 de agosto de 2026 —
gpt-4o-transcribea 0,006 $/minuto,gpt-4o-mini-transcribea 0,003 $/minuto. - OpenAI Whisper, con licencia MIT; la tabla
LANGUAGESdel tokenizador declara 100 idiomas con el indonesio (id) en la posición 17, consultada el 31 de agosto de 2026.