Nadie dijo septiembre: la revisión de nueve minutos que todo resumen de IA necesita
La investigación sobre resumen de transcripciones de reuniones halló que el 30,4 % de los resúmenes generados a partir de sesiones de concejos municipales contenía al menos un error factual, y detrás hay siete tipos de error con nombre propio. Una guía práctica para revisar una acta escrita por IA contra su propia transcripción: qué comprobar, en qué orden, y qué decir en la reunión para que la revisión dure nueve minutos y no treinta.
El resumen tenía tres párrafos, estaba bien organizado y era falso exactamente en una frase: el equipo acordó lanzar la migración en septiembre.
Nadie había acordado eso. Alguien dijo que septiembre probablemente sería viable si el proveedor respondía a tiempo: una condicional, dicha una sola vez, en medio de una digresión sobre otra cosa. El modelo eliminó la condición, ascendió la conjetura a decisión, y el acta se envió a once personas que no estaban en la sala. Dos de ellas empezaron a planificar contando con septiembre.
No hay nada exótico en esto. Es uno de los comportamientos mejor documentados de los sistemas de resumen automático, tiene nombre en la literatura de investigación y no va a desaparecer porque el próximo modelo sea más grande. Este artículo te da tres cosas: las siete formas en que un resumen se aparta de lo que realmente se dijo, una revisión de nueve minutos que las atrapa todas, y las pocas frases que puedes decir durante la reunión para acortar esa revisión.
En resumen:
- En el banco de pruebas TofuEval (NAACL 2024), el 30,4 % de los resúmenes generados a partir de transcripciones reales de concejos municipales contenía al menos un error factual; en los temas marginales —las digresiones— la cifra subía al 43,6 %.
- Los errores no son ruido aleatorio. Los investigadores los clasificaron en siete tipos con nombre, y los dos que más daño hacen en reuniones son presentar una opinión como hecho y los desplazamientos de tiempo y modalidad: justo donde «podríamos» se convierte en «vamos a».
- Tampoco puedes devolverle la comprobación al modelo: en FaithBench (octubre de 2024) los mejores detectores de alucinaciones alcanzaron una precisión cercana al 50 %, y en TofuEval los evaluadores basados en LLM perdieron frente a métricas especializadas más pequeñas.
Imagen: Shixart1985, Wikimedia Commons, CC BY 2.0. Las gafas son la clave. Alguien todavía tiene que leerlo.
La captura está resuelta. La comprobación no ha empezado.
Cuenta las herramientas de actas lanzadas en Hacker News en los últimos seis meses: al menos quince entre el 1 de marzo y el 13 de agosto de 2026. Transcriptores en el dispositivo, blocs de notas sin bot en la llamada, importadores para Obsidian, clones de Granola en código abierto. Todas llevan las mismas dos funciones: capturar el audio y generar el resumen.
Ninguna lleva el tercer paso, el único con juicio dentro. El resumen llega a tu bandeja ya maquetado, ya seguro de sí mismo, ya enviado a toda la sala. Lo que ese flujo afirma de forma implícita es una sola cosa: este resultado está terminado.
Aquí está el punto: un resumen generado no es el registro de la reunión. Es una declaración sobre la reunión, producida por un sistema que no responde de su exactitud, y hay que leerlo como cualquier otro relato de segunda mano: contrastándolo con la evidencia de la que salió.
Por suerte, esa evidencia está justo al lado. La misma herramienta que produjo el resumen produjo la transcripción, y contrastar una con otra lleva menos tiempo del que la reunión dedicó a las presentaciones.
La cifra que debería cambiar cómo lees tus actas
TofuEval, publicado por investigadores de Salesforce AI y colaboradores en NAACL 2024, es lo más parecido a una medición controlada que tenemos sobre esto. Tomaron dos corpus de diálogo —uno de entrevistas periodísticas y otro llamado MeetingBank, formado por transcripciones reales de concejos municipales de EE. UU.—, pidieron a cinco modelos de lenguaje que escribieran resúmenes por tema y encargaron a lingüistas profesionales anotar cada frase del resumen según su consistencia factual con la fuente.
En las transcripciones de reuniones, promediando los cinco modelos, el 30,4 % de los resúmenes sobre los temas principales contenía al menos una inconsistencia factual, y la cifra subía al 43,6 % en los temas marginales. El artículo lo dice sin rodeos: salvo GPT-3.5-Turbo, «aproximadamente el 40-50 % de sus resúmenes contiene al menos una inconsistencia factual».
La salvedad honesta: esos cinco modelos son de 2023 —Vicuna, tres tamaños de WizardLM y GPT-3.5-Turbo— y los modelos punteros de hoy son claramente mejores en fidelidad factual. Pero hay dos hallazgos del mismo artículo que sobreviven a esa objeción, y son los que afectan a tu martes.
Primero, la escala no lo arregló de forma fiable. En los datos de reuniones, la tasa de error de WizardLM-30B fue solo 3,8 puntos porcentuales menor que la de WizardLM-7B, pese a ser más de cuatro veces mayor; en algunas comparaciones, el modelo más grande de una familia producía más errores. Segundo, el número de errores no guardaba relación significativa con la longitud del resumen (correlación de Pearson ρ = 0,18). Un resumen más largo y detallado no es más seguro. Esperar a un modelo más grande no es un proceso de revisión.
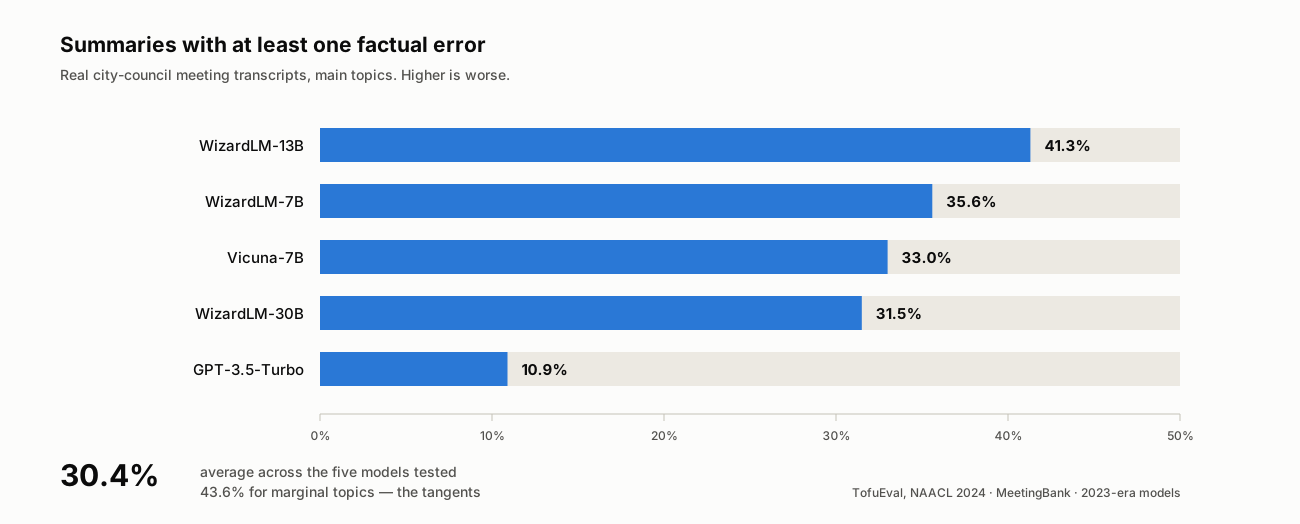
Porcentaje de resúmenes de transcripciones reales de concejos municipales con al menos un error factual, solo temas principales. Fuente: TofuEval, Tang et al., NAACL 2024 (arXiv:2402.13249). Los modelos evaluados son de 2023; los tipos de error de abajo les sobrevivieron.
Siete formas en que un resumen se aparta de la sala
Lo más útil de ese artículo no es el porcentaje: es la taxonomía. Siete tipos de error con nombre que los anotadores derivaron de miles de frases marcadas, ampliando una taxonomía anterior construida sobre diálogos cortos.
Léelos una vez y empezarás a verlos en tus propias actas, porque no son fallos aleatorios: son caminos concretos y repetibles por los que comprimir el habla en prosa elimina una distinción de la que la sala dependía.
| Tipo de error (TofuEval) | Cómo se ve en un acta | Cómo atraparlo |
|---|---|---|
| Información extrínseca | Un dato que aparece en el resumen y en ningún punto del audio: una cifra, el nombre de un cliente, un motivo que nadie dio | Busca el nombre propio o la cifra en la transcripción; si no aparece, fue inventado |
| Atribución errónea | La decisión correcta asignada a la persona equivocada, o la objeción de uno anotada al otro | Salta a la marca de tiempo y mira quién está hablando |
| Opinión como hecho | «El cambio de precio aumentará la fuga de clientes» cuando alguien solo temía que pudiera pasar | Busca el atenuante en el original: cree, teme, sospecha |
| Error de razonamiento | Cuentas mal hechas, o una relación causa-efecto que la sala nunca trazó | Rehaz cada cálculo; pregunta si ese «porque» se dijo o se dedujo |
| Tiempo / aspecto / modalidad | «Podríamos lanzar en septiembre» se convierte en «lanzaremos en septiembre» | Contrasta cada verbo en futuro con el modal original |
| Contradicción | Una negación perdida: «no movemos la fecha» pasa a «movemos la fecha» | Busca no, nunca, salvo que cerca de la afirmación |
| Desplazamiento sutil de significado | «hacer una recomendación» reformulado como «hacer una petición» | Compara el verbo del resumen con el verbo de la fuente |
Tres de ellos se reconocen mejor viéndolos en concreto. Aquí va cada uno con la transcripción y la frase del resumen puestas una al lado de la otra.
Una negación perdida: error de contradicción. Lo que se dijo en la sala:
DANIEL (00:31:12): O sea, la fecha de lanzamiento no la movemos. Cambie
lo que cambie, esa fecha se mantiene.
Lo que escribió el resumen:
El equipo acordó mover la fecha de lanzamiento.
Falta una palabra y la frase ya ordena la acción contraria. Además es gramaticalmente impecable, y justo por eso la relectura pasa de largo mientras que buscar «no» cerca de la decisión la caza en cuatro segundos.
Una atribución errónea: error de referencia. Lo que se dijo en la sala:
PRIYA (00:18:40): Yo estoy en contra del precio por puesto. Dos clientes
grandes nos dijeron el trimestre pasado que así se cae el trato.
MINA (00:18:55): Sí, de acuerdo.
Lo que escribió el resumen:
Mina se opuso al precio por puesto, citando comentarios de clientes
grandes.
Todos los hechos de esa frase están en la transcripción. La persona no. Ahí está toda la dificultad: esto no se detecta preguntando si las afirmaciones son ciertas, solo preguntando si pertenecen a la persona a la que se las han colgado.
Una conjetura ascendida: error de modalidad. Lo que se dijo en la sala:
SAM (00:44:02): Septiembre probablemente sea viable, si el proveedor nos
contesta a tiempo.
Lo que escribió el resumen:
El equipo acordó lanzar la migración en septiembre.
Dos matizadores eliminados —la palabra «probablemente» y toda la oración condicional— y una conjetura compartida se convirtió en un compromiso con fecha. Nadie tuvo que mentir para que pasara. Lo hizo la compresión.
Dos de ellos merecen atención especial, porque son los que cuestan dinero de verdad.
Presentar la opinión como hecho es el incidente de septiembre del inicio de este texto. En una reunión, la mayoría de las frases van atenuadas: la gente piensa en voz alta y el atenuante carga con todo el significado. Los modelos de resumen eliminan atenuantes por diseño, porque son lo primero que se recorta al comprimir. El resultado se lee más rotundo de lo que fue la sala, y precisamente por eso nadie lo cuestiona.
Los desplazamientos de modalidad hacen el mismo daño con las fechas. «Podría», «debería», «probablemente» y «si el proveedor nos contesta» son la diferencia entre un plan y un compromiso, y son también las palabras más baratas de soltar. Un resumen que dice que el equipo hará algo en septiembre ha fabricado en silencio una fecha límite que nadie ha asumido.
Fíjate en lo que ambos tienen en común. El modelo no inventó hechos de la nada: eliminó matizadores. Es la edición menos visible que puede hacer, y la que ningún lector detecta sin la fuente delante.
La invención ocurre en las digresiones
Los datos contienen un segundo patrón que encaja exactamente con cómo transcurren las reuniones.
Los resúmenes de temas marginales —lo que se menciona de pasada en vez de discutirse a fondo— eran sustancialmente peores: 43,6 % frente a 30,4 % en el corpus de reuniones. Los investigadores explican el mecanismo: cuando un tema apenas está cubierto en la fuente, los modelos «recurren a su propio conocimiento para hacer inferencias sobre el tema, introduciendo en el resumen información sin respaldo». Donde la evidencia es fina, se rellena con cultura general, y ese relleno es indistinguible en tono de las partes que sí están fundamentadas.
Tus reuniones están llenas de temas marginales: los dos minutos sobre la revisión de seguridad, el proveedor mencionado una sola vez, la cifra que alguien recordaba a medias. Esas líneas son las menos discutidas y las más propensas a estar mal, y se leerán con la misma fluidez que el resto.
La capa de abajo tiene la misma forma. En «Careless Whisper», presentado en ACM FAccT 2024, Koenecke y sus colegas hallaron que alrededor del 1 % de las transcripciones de Whisper contenía frases enteras alucinadas que no existían de ninguna forma en el audio original, y que el 38 % de esas alucinaciones incluía daños explícitos: asociaciones inventadas, autoridad falsa, violencia fabricada. Lo interesante es el detonante: las alucinaciones se daban de forma desproporcionada en hablantes con tramos no vocales más largos.
Silencio, en otras palabras. Y de eso está hecha una reunión: las pausas para pensar, alguien quitándose el silencio, una pantalla compartida cargando, los cuatro segundos después de una pregunta difícil. Ese es justo el material que un modelo de transcripción tiene más probabilidades de rellenar con algo que nunca se dijo. También significa que los errores de transcripción y los de resumen no son independientes: una línea inventada en la transcripción es, para el resumen, una entrada perfectamente fundamentada.
No puedes devolverle la comprobación al modelo
La idea obvia es que un segundo modelo verifique al primero. Las mediciones no animan.
En el mismo estudio de TofuEval, los autores evaluaron LLM como jueces binarios de consistencia factual y encontraron que todos, GPT-4 incluido, «rinden mal detectando errores en resúmenes generados por LLM», y quedaban por detrás de métricas de factualidad no basadas en LLM, más pequeñas y creadas para esa tarea. Incluso cuando GPT-4 señalaba correctamente una frase, su explicación del porqué era correcta en torno al 80 % de las veces; para el resto de evaluadores, alrededor de la mitad.
FaithBench, publicado por Vectara en octubre de 2024, puso número al techo. Reunió las alucinaciones que produjeron diez LLM modernos de ocho familias y sobre las que los detectores existentes discrepaban, y reportó que incluso los mejores detectores de alucinaciones lograron una precisión cercana al 50 %. Cara o cruz, justo en los casos que importan.
Así que la revisión es tuya. Suena a carga hasta que notas la asimetría: el detector tiene que juzgar un texto cualquiera contra un documento desconocido, mientras que tú estabas en la sala. Ya sabes qué afirmación sonaba rara. Solo tienes que comprobarla.
Tres artefactos, tres trabajos distintos
La mayoría de las discusiones «notas de IA contra notas de verdad» son un error de categoría. Una reunión produce tres artefactos, no son sustitutos, y el equipo que se queda con uno solo siempre pierde algo concreto.
| Transcripción en bruto | Resumen de IA | Registro de decisiones | |
|---|---|---|---|
| Conserva las palabras exactas | Sí — literal | No — comprimido, se caen los atenuantes | No |
| Quién lo dijo | Sí, con separación de hablantes | A veces; la atribución errónea es un tipo de error con nombre | Sí — el responsable es el objetivo |
| Cuándo se dijo | Sí — con marca de tiempo | Rara vez | Solo la fecha límite |
| Decisiones con responsable y fecha | Enterradas en unas 9.000 palabras | Parcialmente y sin fiabilidad | Sí — es su única función |
| Qué se descartó y por qué | Sí, si alguien lo dijo | Suele eliminarse por redundante | Sí, en una línea |
| Se lee en 60 segundos | No | Sí | Sí |
| Se puede contrastar con evidencia | Es la evidencia | Solo si sobrevive la transcripción | Solo si sobreviven ambas |
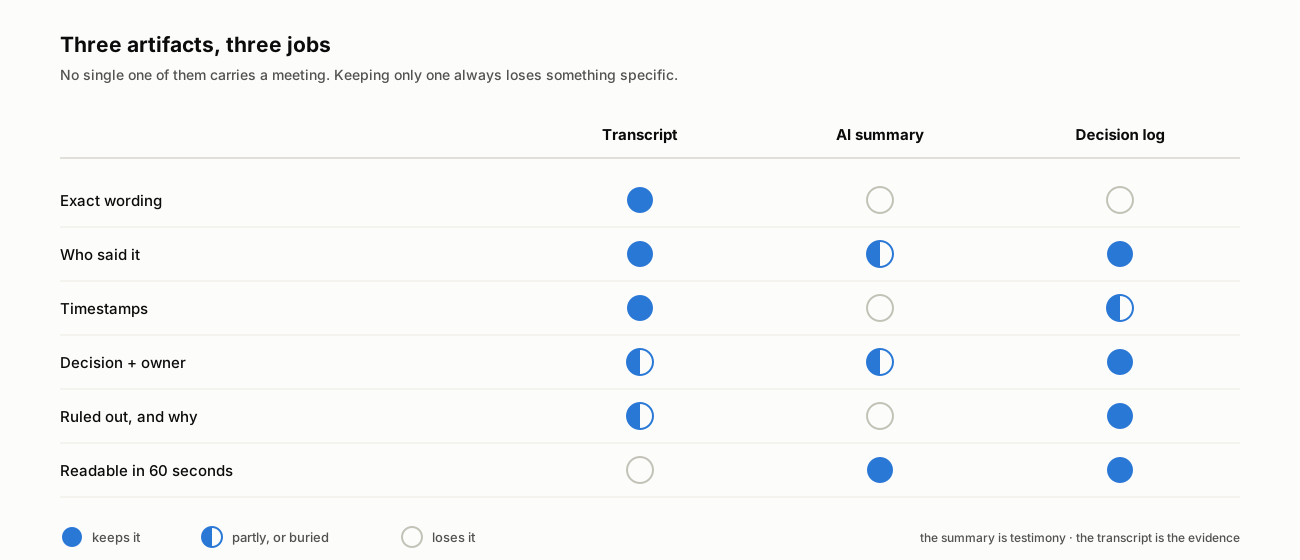
Qué conserva, conserva a medias o pierde cada artefacto. La fila de abajo decide si los otros dos valen algo.
Esa última fila es todo el argumento. Un resumen sin transcripción superviviente es infalsable: cuando un compañero dice «no fue eso lo que acordamos», tienes dos opiniones y ningún registro. Y aquí es donde un acta de IA es más frágil que una humana: las actas escritas por una persona llevaban su falibilidad a la vista y todo el mundo las leía con la desconfianza adecuada. La prosa de máquina llega con encabezados limpios y afirmaciones seguras, y toma prestada una autoridad que no ha ganado.
Llamémoslo por su nombre: el resumen es un testimonio y la transcripción es la prueba. El testimonio sirve. El testimonio es también lo que se contrasta.
La revisión de nueve minutos, en orden
Este es el procedimiento que recomendamos, cronometrado para una reunión de 60 minutos. El orden importa: pone delante las comprobaciones cuyo error cuesta más, de modo que si te interrumpen en el minuto cuatro ya has cazado los errores caros.
- 0:00–1:30 — Lee solo las frases de decisión. Ignora por completo el resumen narrativo en la primera pasada. Busca cada frase que afirme un resultado, un compromiso o una fecha. En una reunión típica de una hora hay entre tres y seis. Son las únicas líneas sobre las que alguien actuará.
- 1:30–3:00 — Restaura la modalidad. Para cada una de esas frases, salta a su punto en la transcripción y comprueba el verbo. ¿Alguien dijo vamos a o dijo podríamos, deberíamos, probablemente? Si el original estaba atenuado, reescribe la línea devolviendo el atenuante; mejor aún, márcala como pregunta abierta con responsable.
- 3:00–4:30 — Comprueba cada nombre propio y cada cifra. Nombres, empresas, versiones, precios, fechas, porcentajes. Busca cada uno en la transcripción. Lo que no aparezca allí es información extrínseca: bórralo o confírmalo fuera. Es trabajo de caja de búsqueda, no de lectura.
- 4:30–5:30 — Verifica la atribución. Para cada decisión y cada objeción, confirma quién habla en esa marca de tiempo. La atribución errónea es el error con más probabilidades de causar un problema personal en vez de uno de planificación, y es el más rápido de comprobar.
- 5:30–6:30 — Caza las negaciones perdidas. Busca en la transcripción no, nunca, salvo que, en lugar de alrededor de cada decisión. Un error de contradicción invierte el significado dejando la frase perfectamente gramatical, así que releer no lo encuentra: buscar sí.
- 6:30–8:00 — Pregunta qué falta. Este es el paso que ninguna herramienta hará por ti, porque un resumen no puede señalar sus propias omisiones. Dos preguntas: ¿qué descartamos y por qué? ¿Y qué pregunta no logramos responder? Ninguna de las dos sobrevive a la compresión, y ambas son lo que hará útil el acta dentro de seis meses.
- 8:00–9:00 — Escribe el registro de decisiones y envíalo. De tres a seis líneas, cada una con qué se decidió, quién asume el siguiente paso y para cuándo. Enlázalo a la transcripción. Ese enlace es lo que hace que toda la revisión sea recomprobable por otra persona.
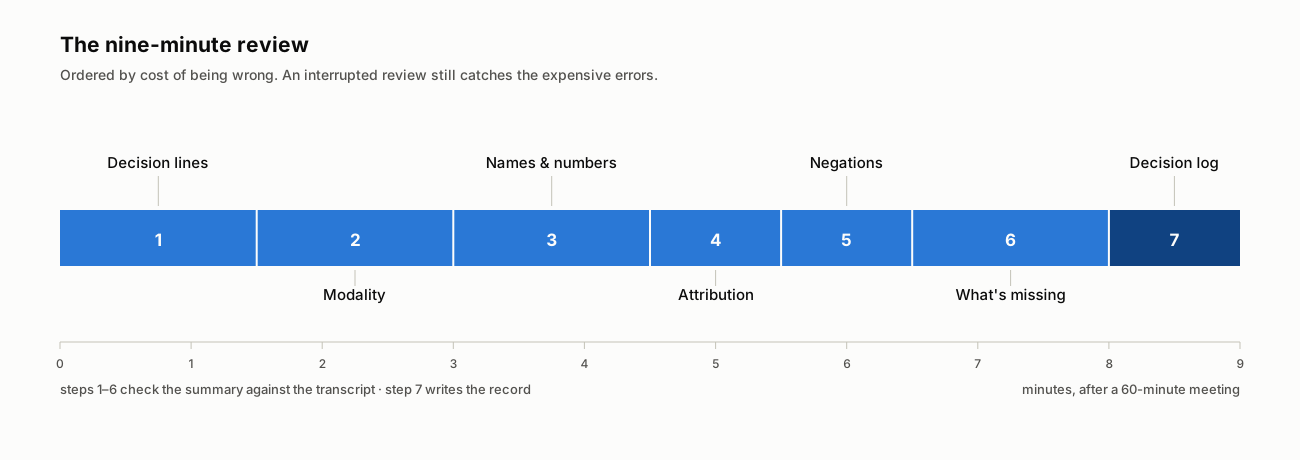
El orden es el diseño: modalidad y detalles inventados primero, omisiones al final. Una revisión interrumpida sigue atrapando los errores caros.
Dos apuntes para hacerlo a diario. Si la reunión fue de 30 minutos, esto es trabajo de cuatro minutos. Y si lo haces en la herramienta que guarda a la vez el resumen y la transcripción con marcas de tiempo, los pasos 2 a 5 son búsquedas y clics en lugar de cambiar de ventana, que es la diferencia entre un hábito que sobrevive a una semana ocupada y otro que no.
Diez segundos en la reunión ahorran cinco minutos de revisión
La revisión se acorta muchísimo si la información ya está en la grabación desde el principio. Un modelo no puede recuperar lo que nadie dijo, y casi todo lo que vuelve ambigua un acta nunca estuvo en el audio.
- Abre con la pregunta, en voz alta. «Hoy decidimos si la migración sale antes o después de la conferencia.» Una pregunta enunciada le da al modelo un tema principal en lugar de un puñado de temas marginales, y los marginales eran el caso del 43,6 %.
- Di la decisión en una frase, con nombre y fecha, antes de que nadie se vaya. «Decisión: Mina se encarga del seguimiento con el proveedor y confirmamos la fecha de septiembre antes del día 25.» Cualquier herramienta del mercado captura esa frase a la perfección. Ninguna la inventará.
- Di la negación de forma explícita. «No movemos la fecha de lanzamiento» es más seguro que encogerse de hombros y asentir, porque una negación perdida es un tipo de error documentado y una negación no pronunciada no puede perderse.
- Nombra qué rechazasteis y por qué, en una línea. «Consideramos el precio por puesto y lo descartamos porque dos clientes grandes se opusieron el trimestre pasado.» Esta es la frase que impide que el mismo debate se reabra en seis meses.
- Deletrea una vez los nombres propios raros. Nombres de proveedores, nombres en clave internos y siglas son justo lo que la transcripción destroza y el resumen repite después con total seguridad.
- No dejes que hable el silencio. Si la sala se queda callada porque todos están leyendo un documento, dilo. Los tramos largos sin voz son la condición en la que más alucinan los modelos de transcripción.
Nada de esto es teatro de reunión. Es dictar al registro: una habilidad que ganó más valor cuando el registro empezó a escribirse solo.
En conclusión
Un resumen de reunión hecho por IA no es un registro. Es un testimonio sobre un registro, entregado con fluidez, por un testigo que no tiene nada en juego respecto a la exactitud y con una tendencia documentada a dejarse la palabra «probablemente».
Ese replanteamiento zanja la discusión manual-contra-IA, que nunca fue una discusión real. Guarda la grabación, porque es la única prueba. Deja que el modelo escriba el resumen, porque es más rápido que tú y no se aburre en el minuto cuarenta. Y luego dedica nueve minutos a la única parte que exige haber estado allí: contrastar las frases seguras con lo que de verdad se dijo y escribir las tres líneas sobre las que alguien tiene que actuar.
Los equipos que se van a quemar en 2026 no son los que se saltaron la herramienta de actas con IA. Son los que leyeron su salida como si fuera una transcripción cuando era una paráfrasis, y no guardaron la transcripción que habría mostrado la diferencia. La versión completa de lo que un acta debe llevar está en las seis cosas que un acta de reunión sigue necesitando, y por qué la tasa de error de palabras casi no dice nada sobre si una transcripción sirve, en la precisión no basta.
Dónde encaja Telli.sh: la revisión de nueve minutos solo funciona si el resumen y la fuente viven en el mismo sitio. Telli.sh mantiene la transcripción con marcas de tiempo y atribución de hablantes junto a un resumen de IA editable, de modo que comprobar una afirmación es una búsqueda y un clic en lugar de una caza entre dos sistemas; y cuando la sala no habla un solo idioma, la traducción se coloca al lado del original en vez de sustituirlo. El resumen llega como un borrador que corriges, no como un resultado que aceptas.
Empezar una nota de IA en directo
Fuentes
- Tang et al., «TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization», NAACL 2024 (arXiv:2402.13249, 20 de febrero de 2024)
- Koenecke et al., «Careless Whisper: Speech-to-Text Hallucination Harms», ACM FAccT 2024 (arXiv:2402.08021, 12 de febrero de 2024)
- Bao et al., «FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs», Vectara (arXiv:2410.13210, 17 de octubre de 2024)
- Hu et al., «MeetingBank: A Benchmark Dataset for Meeting Summarization», ACL 2023 (arXiv:2305.17529, 27 de mayo de 2023)
- Wang et al., «Analyzing and Evaluating Faithfulness in Dialogue Summarization», EMNLP 2022 (arXiv:2210.11777, 21 de octubre de 2022)
- Página de la imagen en Wikimedia Commons
