Niemand hat September gesagt: die Neun-Minuten-Prüfung, die jede KI-Zusammenfassung braucht
Forschung zur Zusammenfassung von Meeting-Transkripten zeigt: 30,4 % der generierten Zusammenfassungen echter Stadtratssitzungen enthielten mindestens einen Sachfehler — und dahinter stehen sieben benannte Fehlertypen. Ein praktischer Leitfaden, wie Sie eine KI-Mitschrift gegen ihr eigenes Transkript prüfen: was Sie in welcher Reihenfolge kontrollieren und was Sie im Meeting sagen sollten, damit die Prüfung neun statt dreißig Minuten dauert.
Die Zusammenfassung war drei Absätze lang, sauber gegliedert und in genau einem Satz falsch: Das Team hat vereinbart, die Migration im September auszuliefern.
Vereinbart hatte das niemand. Jemand hatte gesagt, September sei vermutlich machbar, falls der Anbieter rechtzeitig antworte — ein Konditionalsatz, einmal geäußert, mitten in einem Nebenstrang. Das Modell strich die Bedingung, beförderte die Vermutung zur Entscheidung, und die Notiz ging an elf Personen, die nicht im Raum gewesen waren. Zwei davon begannen, gegen September zu planen.
Daran ist nichts Exotisches. Es ist eines der am gründlichsten dokumentierten Verhaltensmuster automatischer Zusammenfassungssysteme, es hat in der Forschungsliteratur einen Namen, und es verschwindet nicht, weil das nächste Modell größer wird. Dieser Beitrag liefert drei Dinge: die sieben Arten, auf die eine Zusammenfassung zuverlässig von der Realität des Gesprächs abweicht, eine Neun-Minuten-Prüfung, die alle sieben findet, und die wenigen Sätze im Meeting, die diese Prüfung verkürzen.
Kurz gefasst:
- Im Benchmark TofuEval (NAACL 2024) enthielten 30,4 % der generierten Zusammenfassungen echter Stadtratstranskripte mindestens einen Sachfehler; bei Randthemen — den Abschweifungen — stieg der Wert auf 43,6 %.
- Die Fehler sind kein zufälliges Rauschen. Forschende haben sie in sieben benannte Typen sortiert, und die beiden schädlichsten für Meetings sind Meinung als Tatsache und Verschiebungen in Tempus und Modalität — genau dort, wo aus „wir könnten“ ein „wir werden“ wird.
- Die Prüfung lässt sich nicht ans Modell zurückgeben: Auf FaithBench (Oktober 2024) erreichten die besten Halluzinationsdetektoren knapp 50 % Genauigkeit, und in TofuEval unterlagen LLM-Prüfer kleineren Spezialmetriken.
Bild: Shixart1985, Wikimedia Commons, CC BY 2.0. Die Brille ist der Punkt. Lesen muss das Ganze am Ende trotzdem jemand.
Die Aufzeichnung ist gelöst. Die Prüfung hat nie begonnen.
Zählt man die Meeting-Notiz-Tools, die in den letzten sechs Monaten auf Hacker News vorgestellt wurden, kommt man zwischen dem 1. März und dem 13. August 2026 auf mindestens fünfzehn: On-Device-Transkribierer, botfreie Notizblöcke, Obsidian-Importer, quelloffene Granola-Klone. Jedes einzelne bringt dieselben zwei Funktionen mit: Audio aufnehmen, Zusammenfassung erzeugen.
Keines bringt den dritten Schritt mit — den einzigen, in dem Urteilsvermögen steckt. Die Zusammenfassung landet bereits formatiert, bereits selbstbewusst und bereits an alle verschickt in Ihrem Postfach. Die stillschweigende Behauptung dieses Ablaufs lautet: Dieses Ergebnis ist fertig.
Hier der Punkt: Eine generierte Zusammenfassung ist keine Aufzeichnung des Meetings. Sie ist eine Aussage über das Meeting, erstellt von einem System, das für seine Richtigkeit nicht haftet — und sie sollte gelesen werden wie jeder andere Bericht aus zweiter Hand: gegen die Belege, aus denen sie stammt.
Die Belege liegen glücklicherweise direkt daneben. Dasselbe Werkzeug, das die Zusammenfassung erzeugt hat, hat auch das Transkript erzeugt, und beides gegeneinander zu prüfen dauert weniger lange als die Vorstellungsrunde des Meetings.
Die Zahl, die Ihre Art zu lesen ändern sollte
TofuEval, veröffentlicht von Forschenden bei Salesforce AI und Mitautoren auf der NAACL 2024, ist das Nächste an einer kontrollierten Messung, das wir zu diesem Thema haben. Sie nahmen zwei Dialogkorpora — eines mit Nachrichteninterviews, eines namens MeetingBank aus echten Transkripten US-amerikanischer Stadtratssitzungen —, ließen fünf Sprachmodelle themenbezogene Zusammenfassungen schreiben und ließen professionelle Linguistinnen und Linguisten jeden Satz gegen die Quelle auf sachliche Konsistenz annotieren.
Bei den Meeting-Transkripten enthielten im Mittel über die fünf Modelle 30,4 % der Zusammenfassungen zu den Hauptthemen mindestens eine sachliche Inkonsistenz, bei Randthemen waren es 43,6 %. Die Arbeit formuliert es unmissverständlich: Mit Ausnahme von GPT-3.5-Turbo enthielten „ungefähr 40–50 % ihrer Zusammenfassungen mindestens eine sachliche Inkonsistenz“.
Die ehrliche Einschränkung: Diese fünf Modelle stammen aus 2023 — Vicuna, drei Größen WizardLM und GPT-3.5-Turbo — und heutige Spitzenmodelle sind bei Faktentreue deutlich besser. Zwei Befunde derselben Arbeit überstehen diesen Einwand jedoch, und es sind die, die Ihren Dienstag betreffen.
Erstens hat Skalierung das Problem nicht verlässlich gelöst. Die Fehlerquote von WizardLM-30B lag bei den Meeting-Daten nur 3,8 Prozentpunkte unter der von WizardLM-7B, obwohl das Modell mehr als viermal so groß ist; in manchen Vergleichen produzierte das größere Modell derselben Familie sogar mehr Fehler. Zweitens bestand kein nennenswerter Zusammenhang zwischen Fehlerzahl und Länge der Zusammenfassung (Pearson ρ = 0,18). Eine längere, detailliertere Zusammenfassung ist keine sicherere. Auf ein größeres Modell zu warten ist kein Prüfprozess.
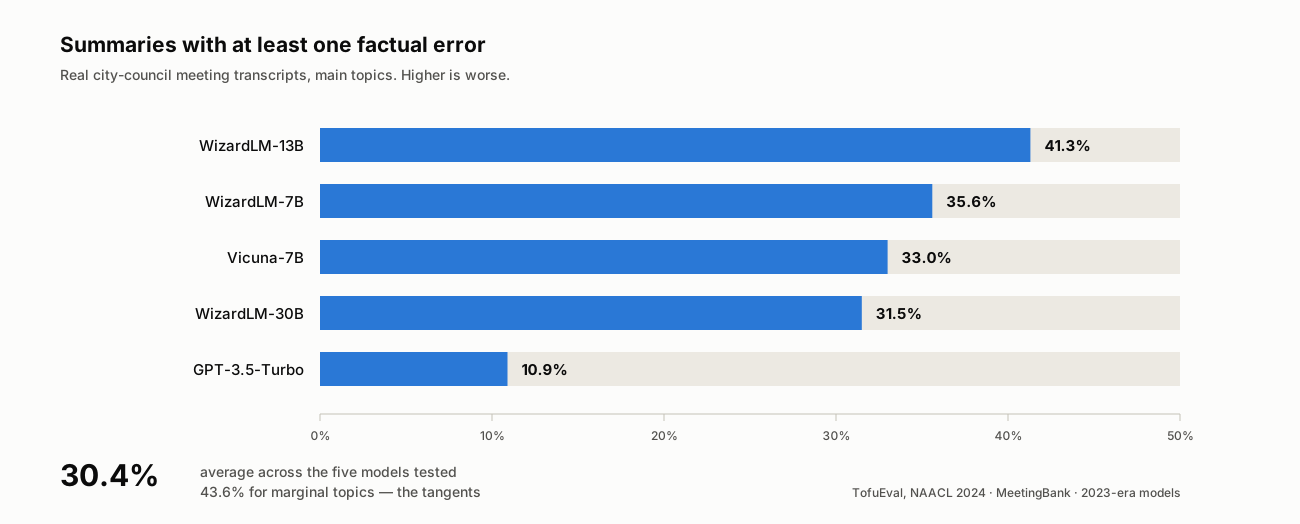
Anteil der Zusammenfassungen echter Stadtratstranskripte mit mindestens einem Sachfehler, nur Hauptthemen. Quelle: TofuEval, Tang et al., NAACL 2024 (arXiv:2402.13249). Die getesteten Modelle stammen aus 2023; die Fehlertypen unten haben sie überlebt.
Sieben Arten, wie eine Zusammenfassung vom Raum abweicht
Das Nützlichste an dieser Arbeit ist nicht der Prozentsatz, sondern die Typologie: sieben benannte Fehlerarten, die die Annotierenden aus Tausenden markierten Sätzen abgeleitet haben, als Erweiterung einer älteren Typologie für kurze Dialoge.
Einmal gelesen, sehen Sie sie in Ihren eigenen Notizen wieder. Denn es sind keine zufälligen Aussetzer, sondern spezifische, wiederkehrende Wege, auf denen beim Verdichten von Gesprochenem zu Prosa genau die Unterscheidung verloren geht, auf die sich der Raum verlassen hat.
| Fehlertyp (TofuEval) | Wie er in der Mitschrift aussieht | So finden Sie ihn |
|---|---|---|
| Extrinsische Information | Ein Detail, das in der Zusammenfassung steht und im Audio nirgends — eine Zahl, ein Kundenname, eine Begründung, die niemand gegeben hat | Im Transkript nach dem Eigennamen oder der Zahl suchen; kein Treffer heißt: erfunden |
| Fehlzuordnung | Die richtige Entscheidung der falschen Person zugeschrieben, oder der Einwand von A bei B verbucht | Zum Zeitstempel springen und nachsehen, wer spricht |
| Meinung als Tatsache | „Die Preisänderung wird die Abwanderung erhöhen“ — obwohl jemand nur befürchtet hat, dass sie es könnte | Im Original nach der Abschwächung suchen: denkt, befürchtet, vermutet |
| Schlussfolgerungsfehler | Falsch gerechnet, oder ein Kausalzusammenhang, den der Raum nie gezogen hat | Jede Zahl nachrechnen; fragen, ob das „weil“ gesagt oder gefolgert wurde |
| Tempus / Aspekt / Modalität | „Wir könnten im September ausliefern“ wird zu „wir liefern im September aus“ | Jedes Futur gegen das ursprüngliche Modalverb prüfen |
| Widerspruch | Eine verlorene Verneinung: „Wir verschieben den Termin nicht“ wird zu „wir verschieben den Termin“ | Im Transkript nach nicht, nie, außer in der Nähe der Aussage suchen |
| Feine Bedeutungsverschiebung | „eine Empfehlung aussprechen“ wird zu „eine Forderung stellen“ | Das Verb der Zusammenfassung mit dem Verb der Quelle vergleichen |
Drei davon erkennt man am leichtesten am konkreten Objekt. Hier steht jeweils das Transkript neben dem Satz aus der Zusammenfassung.
Eine verlorene Verneinung — Widerspruchsfehler. Was im Raum gesagt wurde:
DANIEL (00:31:12): Also, wir verschieben den Launch-Termin nicht. Was
sich sonst ändert, dieses Datum steht.
Was die Zusammenfassung daraus machte:
Das Team hat vereinbart, den Launch-Termin zu verschieben.
Ein Wort weg, und der Satz weist die gegenteilige Handlung an. Er ist dabei grammatisch einwandfrei — genau deshalb rutscht das Korrekturlesen daran vorbei, während eine Suche nach „nicht“ in der Nähe der Entscheidung es in vier Sekunden findet.
Eine Fehlzuordnung — Misreferenzierung. Was im Raum gesagt wurde:
PRIYA (00:18:40): Bei Pro-Seat würde ich widersprechen. Zwei
Enterprise-Kunden sagten uns letztes Quartal, das killt den Deal.
MINA (00:18:55): Ja, sehe ich auch so.
Was die Zusammenfassung daraus machte:
Mina widersprach der Pro-Seat-Bepreisung und verwies auf Rückmeldungen
von Enterprise-Kunden.
Jede Tatsache in diesem Satz steht im Transkript. Die Person nicht. Genau darin liegt die Schwierigkeit: Sie können das nicht aufdecken, indem Sie fragen, ob die Aussagen stimmen — nur indem Sie fragen, ob sie der Person gehören, der sie zugeschrieben wurden.
Eine beförderte Vermutung — Modalitätsfehler. Was im Raum gesagt wurde:
SAM (00:44:02): September ist wahrscheinlich machbar, falls der
Anbieter rechtzeitig auf uns zurückkommt.
Was die Zusammenfassung daraus machte:
Das Team hat vereinbart, die Migration im September auszuliefern.
Zwei Einschränkungen entfernt — das Wort „wahrscheinlich“ und der gesamte Konditionalsatz — und aus einer gemeinsamen Vermutung wurde eine Zusage mit Datum. Dafür musste niemand lügen. Das hat die Verdichtung erledigt.
Zwei davon verdienen besondere Aufmerksamkeit, weil sie Teams echtes Geld kosten.
Meinung als Tatsache ist der September-Vorfall vom Anfang dieses Textes. In Meetings sind die meisten Sätze abgeschwächt — Menschen denken laut, und die Abschwächung trägt die gesamte Bedeutung. Zusammenfassungsmodelle entfernen Abschwächungen konstruktionsbedingt, denn sie sind das Erste, was man beim Verdichten streicht. Das Ergebnis liest sich entschiedener, als der Raum war, und genau deshalb wird es nicht hinterfragt.
Modalitätsverschiebungen richten denselben Schaden bei Terminen an. „Könnte“, „sollte“, „vermutlich“ und „falls der Anbieter sich meldet“ sind der Unterschied zwischen einem Plan und einer Zusage — und zugleich die billigsten Wörter zum Weglassen. Eine Zusammenfassung, in der das Team im September etwas tut, hat leise eine Frist hergestellt, für die niemand einsteht.
Beachten Sie das Gemeinsame: Das Modell hat keine Tatsachen aus dem Nichts erfunden. Es hat Einschränkungen entfernt — der unauffälligste Eingriff, den es vornehmen kann, und derjenige, den kein Leser ohne die Quelle bemerkt.
Erfunden wird auf den Nebenwegen
Die Daten enthalten ein zweites Muster, das sich exakt mit dem Ablauf realer Meetings deckt.
Zusammenfassungen zu Randthemen — Dingen, die nur beiläufig erwähnt statt ausführlich besprochen wurden — waren deutlich schlechter: 43,6 % gegenüber 30,4 % im Meeting-Korpus. Die Forschenden erklären den Mechanismus: Wenn ein Thema in der Quelle kaum vorkommt, stützen sich Modelle „auf ihr eigenes Wissen, um Schlüsse über das Thema zu ziehen, und bringen dabei nicht belegte Informationen in die Zusammenfassung ein“. Dünne Belege werden mit Allgemeinwissen aufgefüllt, und die Füllung ist im Ton nicht von den belegten Teilen zu unterscheiden.
Ihre Meetings sind voller Randthemen: die zwei Minuten über das Security-Review, der einmal erwähnte Anbieter, die Zahl, an die sich jemand halb erinnert. Diese Zeilen sind am wenigsten besprochen und am ehesten falsch — und sie lesen sich genauso flüssig wie der Rest.
Die Ebene darunter hat dieselbe Form. In „Careless Whisper“, vorgestellt auf der ACM FAccT 2024, fanden Koenecke und Kolleginnen, dass rund 1 % der Whisper-Transkriptionen ganze halluzinierte Wendungen oder Sätze enthielten, die im zugrunde liegenden Audio in keiner Form vorkamen, und dass 38 % dieser Halluzinationen explizite Schäden trugen: erfundene Zusammenhänge, falsche Autorität, konstruierte Gewalt. Interessant ist der Auslöser: Halluzinationen traten überproportional bei Sprechenden mit längeren nicht-vokalen Abschnitten auf.
Also bei Stille. Und daraus besteht ein Meeting: Denkpausen, jemand stummschaltet sich frei, ein Screenshare lädt, die vier Sekunden nach einer unangenehmen Frage. Genau dieses Rohmaterial füllt ein Transkriptionsmodell am ehesten mit etwas, das nie gesagt wurde. Damit sind Transkript- und Zusammenfassungsfehler auch nicht unabhängig: Eine erfundene Transkriptzeile ist für die Zusammenfassung eine perfekt belegte Eingabe.
Die Prüfung lässt sich nicht ans Modell zurückgeben
Der naheliegende Gedanke ist, ein zweites Modell das erste verifizieren zu lassen. Die Messwerte machen wenig Mut.
In derselben TofuEval-Studie prüften die Autoren LLMs als binäre Faktenkonsistenz-Richter und stellten fest, dass sie alle, GPT-4 eingeschlossen, „schlecht darin sind, Fehler in LLM-generierten Zusammenfassungen zu erkennen“ — und von kleineren, eigens für diese Aufgabe gebauten Nicht-LLM-Metriken übertroffen wurden. Selbst wenn GPT-4 einen Satz korrekt markierte, war seine Erklärung des Warum nur in etwa 80 % der Fälle richtig; bei den übrigen Prüfern in etwa der Hälfte.
FaithBench, im Oktober 2024 von Vectara veröffentlicht, hat der Obergrenze eine Zahl gegeben. Der Benchmark sammelte Halluzinationen von zehn modernen LLMs aus acht Modellfamilien, bei denen sich vorhandene Detektoren uneins waren — und berichtet, dass selbst die besten Halluzinationsdetektoren knapp 50 % Genauigkeit erreichten. Ein Münzwurf, genau in den Fällen, die zählen.
Die Prüfung liegt also bei Ihnen. Das klingt nach Last, bis man die Asymmetrie sieht: Der Detektor muss beliebigen Text gegen ein unbekanntes Dokument beurteilen, während Sie im Raum waren. Sie wissen bereits, welche Behauptung schief klang. Sie müssen sie nur nachschlagen.
Drei Artefakte, drei Aufgaben
Die meisten „KI-Notizen gegen echte Notizen“-Debatten sind ein Kategorienfehler. Ein Meeting produziert drei Artefakte, sie ersetzen einander nicht, und ein Team, das nur eines behält, verliert immer etwas Bestimmtes.
| Rohtranskript | KI-Zusammenfassung | Entscheidungslog | |
|---|---|---|---|
| Exakter Wortlaut erhalten | Ja — wörtlich | Nein — verdichtet, Abschwächungen fallen weg | Nein |
| Wer es gesagt hat | Ja, bei Sprechertrennung | Manchmal; Fehlzuordnung ist ein benannter Fehlertyp | Ja — die Zuständigkeit ist der Zweck |
| Wann es gesagt wurde | Ja — mit Zeitstempel | Selten | Nur die Frist |
| Entscheidungen mit Zuständigkeit und Datum | In rund 9.000 Wörtern vergraben | Teilweise und unzuverlässig | Ja — das ist seine einzige Aufgabe |
| Was verworfen wurde und warum | Ja, falls es jemand ausgesprochen hat | Meist als redundant gestrichen | Ja, in einer Zeile |
| In 60 Sekunden lesbar | Nein | Ja | Ja |
| Gegen Belege prüfbar | Es ist der Beleg | Nur wenn das Transkript erhalten bleibt | Nur wenn beides erhalten bleibt |
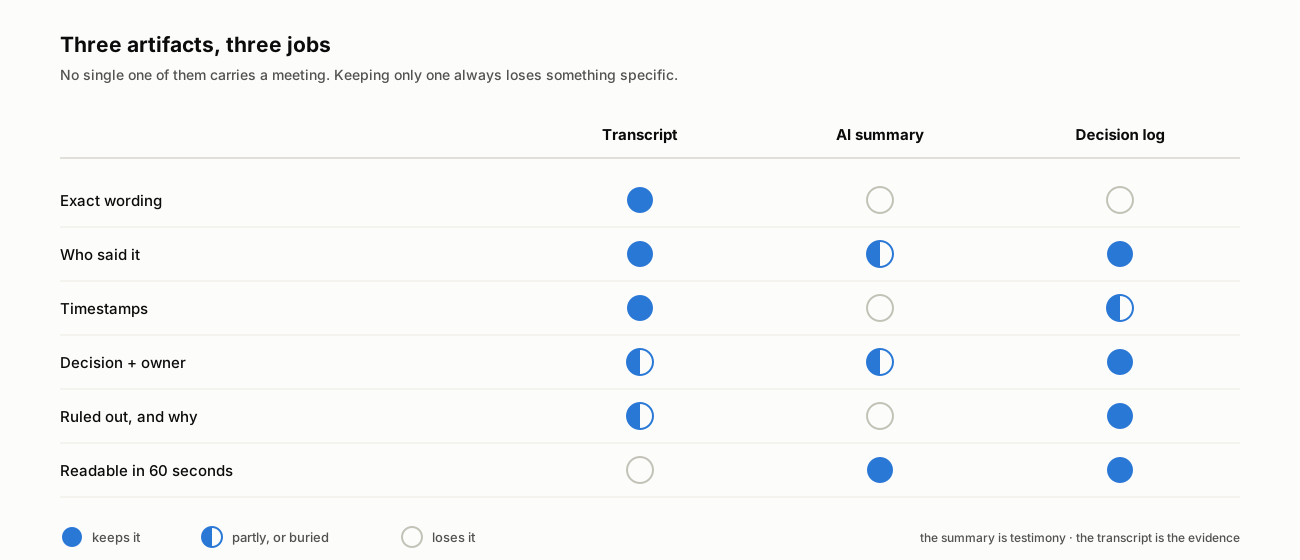
Was jedes Artefakt behält, teilweise behält oder verliert. Die unterste Zeile entscheidet, ob die anderen beiden etwas wert sind.
Die unterste Zeile ist das ganze Argument. Eine Zusammenfassung ohne erhaltenes Transkript ist unwiderlegbar — wenn eine Kollegin sagt „so haben wir das nicht vereinbart“, haben Sie zwei Meinungen und keine Aufzeichnung. Genau hier ist eine KI-Notiz fragiler als eine menschliche: Handschriftliche Protokolle trugen ihre Fehlbarkeit sichtbar mit sich, und alle lasen sie mit angemessenem Misstrauen. Maschinenprosa kommt in sauberen Überschriften und selbstsicheren Aussagesätzen an und borgt sich eine Autorität, die sie sich nicht verdient hat.
Nennen wir es beim Namen: Die Zusammenfassung ist eine Zeugenaussage, das Transkript ist der Beweis. Zeugenaussagen sind nützlich. Zeugenaussagen sind auch das, was man überprüft.
Die Neun-Minuten-Prüfung, der Reihe nach
Das ist der Ablauf, den wir empfehlen, getaktet für ein 60-Minuten-Meeting. Die Reihenfolge zählt: Sie stellt die Prüfungen mit den höchsten Fehlerkosten nach vorn, damit Sie, wenn Sie in Minute vier unterbrochen werden, die teuren Fehler bereits gefunden haben.
- 0:00–1:30 — Nur die Entscheidungssätze lesen. Ignorieren Sie im ersten Durchgang die erzählende Zusammenfassung vollständig. Suchen Sie jeden Satz, der ein Ergebnis, eine Zusage oder ein Datum behauptet. In einem typischen 60-Minuten-Meeting sind das drei bis sechs. Nur diese Zeilen werden jemals umgesetzt.
- 1:30–3:00 — Die Modalität wiederherstellen. Springen Sie für jeden dieser Sätze an die passende Stelle im Transkript und prüfen Sie das Verb. Hieß es werden oder könnten, sollten, vermutlich? War das Original abgeschwächt, schreiben Sie die Zeile mit der Abschwächung zurück — oder besser: markieren Sie sie als offene Frage mit Zuständigkeit.
- 3:00–4:30 — Jeden Eigennamen und jede Zahl prüfen. Namen, Firmen, Versionen, Preise, Daten, Prozentwerte. Suchen Sie jedes einzeln im Transkript. Was dort nicht vorkommt, ist extrinsische Information: löschen oder außerhalb bestätigen. Das ist Suchfeldarbeit, keine Lesearbeit.
- 4:30–5:30 — Zuordnung verifizieren. Bestätigen Sie für jede Entscheidung und jeden Einwand, wer an dieser Stelle spricht. Fehlzuordnung ist der Fehler, der eher zwischenmenschliche als planerische Probleme auslöst — und er ist am schnellsten geprüft.
- 5:30–6:30 — Nach verlorenen Verneinungen jagen. Suchen Sie im Transkript rund um jede Entscheidung nach nicht, nie, kein, außer und statt. Ein Widerspruchsfehler dreht die Bedeutung um und lässt den Satz grammatisch einwandfrei — Korrekturlesen findet ihn nicht, Suchen schon.
- 6:30–8:00 — Fragen, was fehlt. Diesen Schritt kann kein Werkzeug übernehmen, denn eine Zusammenfassung kann ihre eigenen Auslassungen nicht kennzeichnen. Zwei Fragen: Was haben wir verworfen und warum? Und welche Frage haben wir nicht beantwortet? Beides überlebt die Verdichtung nicht, und beides macht die Notiz in sechs Monaten brauchbar.
- 8:00–9:00 — Das Entscheidungslog schreiben und verschicken. Drei bis sechs Zeilen, jede mit dem, was entschieden wurde, wer den nächsten Schritt verantwortet und bis wann. Verlinken Sie es mit dem Transkript. Dieser Link macht die gesamte Prüfung für andere nachprüfbar.
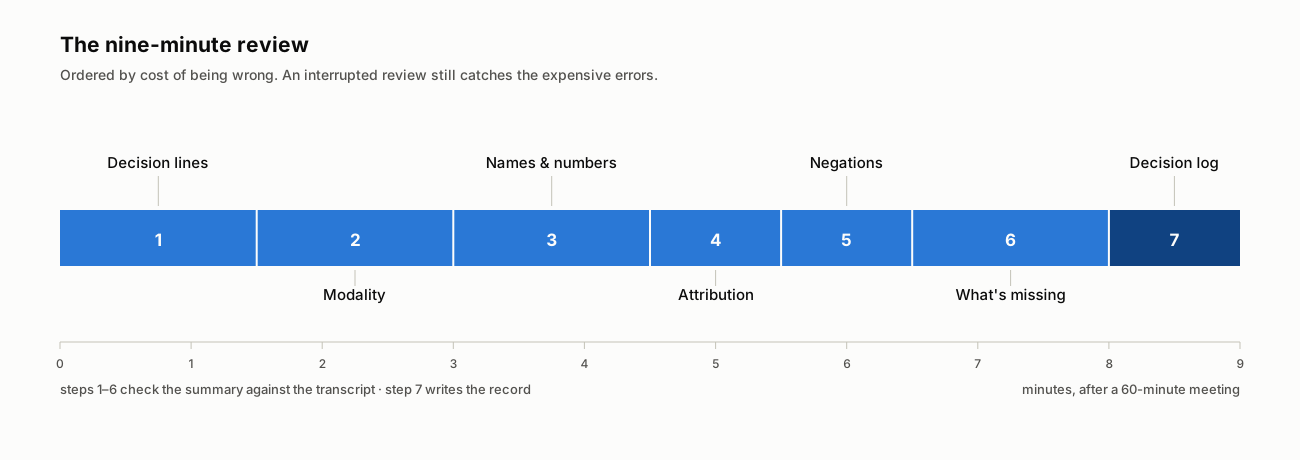
Die Reihenfolge ist die Konstruktion: Modalität und erfundene Details zuerst, Auslassungen zuletzt. Eine unterbrochene Prüfung fängt die teuren Fehler trotzdem ab.
Zwei Hinweise für den Alltag. Bei einem 30-Minuten-Meeting ist das eine Vier-Minuten-Aufgabe. Und wenn Sie es in dem Werkzeug tun, das Zusammenfassung und zeitgestempeltes Transkript zusammen hält, sind die Schritte 2 bis 5 Suchen und Klicks statt Fensterwechsel — das ist der Unterschied zwischen einer Gewohnheit, die eine volle Woche übersteht, und einer, die es nicht tut.
Zehn Sekunden im Meeting sparen fünf Minuten in der Prüfung
Die Prüfung wird drastisch kürzer, wenn die Information von vornherein in der Aufnahme steckt. Ein Modell kann nicht wiederherstellen, was niemand gesagt hat, und das meiste, was Notizen mehrdeutig macht, war nie im Audio.
- Eröffnen Sie mit der Frage, laut ausgesprochen. „Wir entscheiden heute, ob die Migration vor oder nach der Konferenz ausgeliefert wird.“ Eine ausgesprochene Frage gibt dem Modell ein Hauptthema statt einer Ansammlung von Randthemen — und Randthemen waren der 43,6-%-Fall.
- Sagen Sie die Entscheidung in einem Satz, mit Namen und Datum, bevor jemand geht. „Entscheidung: Mina übernimmt das Nachfassen beim Anbieter, den September-Termin bestätigen wir bis zum 25.“ Jedes Tool am Markt hält diesen Satz perfekt fest. Keines erfindet ihn.
- Sprechen Sie die Verneinung ausdrücklich aus. „Wir verschieben den Launch-Termin nicht“ ist sicherer als ein Schulterzucken und ein Nicken, denn eine weggefallene Verneinung ist ein dokumentierter Fehlertyp — und eine nie gesprochene Verneinung kann nicht wegfallen.
- Nennen Sie in einer Zeile, was Sie verworfen haben und warum. „Wir haben Pro-Seat-Preise erwogen und verworfen, weil im letzten Quartal zwei Enterprise-Kunden dagegen waren.“ Dieser Satz verhindert, dass dieselbe Debatte in sechs Monaten wieder aufgeht.
- Ungewöhnliche Eigennamen einmal buchstabieren. Anbieternamen, interne Codenamen und Abkürzungen sind genau das, was ein Transkript verstümmelt und eine Zusammenfassung dann selbstbewusst wiederholt.
- Lassen Sie die Stille nicht sprechen. Wenn es still wird, weil alle ein Dokument lesen, sagen Sie es. Lange nicht-vokale Abschnitte sind die Bedingung, unter der Transkriptionsmodelle am stärksten halluzinieren.
Nichts davon ist Meeting-Theater. Es ist Diktat an das Protokoll — eine Fähigkeit, die mehr wert wurde, als das Protokoll begann, sich selbst zu schreiben.
Unterm Strich
Eine KI-Meeting-Zusammenfassung ist keine Aufzeichnung. Sie ist eine Aussage über eine Aufzeichnung, flüssig vorgetragen, von einem Zeugen ohne Interesse an Genauigkeit und mit einer dokumentierten Neigung, das Wort „vermutlich“ fallen zu lassen.
Diese Umdeutung erledigt die Debatte „manuell gegen KI“, die nie eine echte Debatte war. Behalten Sie die Aufnahme, denn sie ist der einzige Beleg. Lassen Sie das Modell die Zusammenfassung schreiben, denn es ist schneller als Sie und wird in Minute vierzig nicht müde. Und investieren Sie dann neun Minuten in den einen Teil, für den man dabei gewesen sein muss: die selbstsicheren Sätze gegen das Gesagte zu prüfen und die drei Zeilen aufzuschreiben, an denen jemand arbeiten muss.
Die Teams, die sich 2026 die Finger verbrennen, sind nicht die ohne KI-Notiztool. Es sind die, die dessen Ausgabe für ein Transkript hielten, obwohl sie eine Paraphrase war — und die das Transkript nicht behalten haben, das den Unterschied gezeigt hätte. Die ausführlichere Fassung dessen, was eine gute Notiz tragen muss, steht in den sechs Dingen, die eine Meeting-Notiz weiterhin braucht, und warum die Wortfehlerrate fast nichts darüber sagt, ob ein Transkript brauchbar ist, in Genauigkeit allein reicht nicht.
Wo Telli.sh hineinpasst: Die Neun-Minuten-Prüfung funktioniert nur, wenn Zusammenfassung und Quelle am selben Ort liegen. Telli.sh hält das zeitgestempelte Transkript mit Sprecherzuordnung direkt neben einer bearbeitbaren KI-Zusammenfassung, sodass das Prüfen einer Aussage eine Suche und ein Klick ist statt einer Jagd durch zwei Systeme — und wenn im Raum nicht alle dieselbe Sprache sprechen, steht die Übersetzung neben dem Original statt an seiner Stelle. Die Zusammenfassung kommt als Entwurf, den Sie korrigieren, nicht als Ergebnis, das Sie akzeptieren.
Quellen
- Tang et al., „TofuEval: Evaluating Hallucinations of LLMs on Topic-Focused Dialogue Summarization“, NAACL 2024 (arXiv:2402.13249, 20. Februar 2024)
- Koenecke et al., „Careless Whisper: Speech-to-Text Hallucination Harms“, ACM FAccT 2024 (arXiv:2402.08021, 12. Februar 2024)
- Bao et al., „FaithBench: A Diverse Hallucination Benchmark for Summarization by Modern LLMs“, Vectara (arXiv:2410.13210, 17. Oktober 2024)
- Hu et al., „MeetingBank: A Benchmark Dataset for Meeting Summarization“, ACL 2023 (arXiv:2305.17529, 27. Mai 2023)
- Wang et al., „Analyzing and Evaluating Faithfulness in Dialogue Summarization“, EMNLP 2022 (arXiv:2210.11777, 21. Oktober 2022)
- Wikimedia-Commons-Bildseite
