5단계, 4개의 산출물: Telli.sh는 회의 녹음으로 정확히 무엇을 하는가
Telli.sh 파이프라인 전체를 단계별로 살펴봅니다. 실시간 녹음과 오디오 업로드, 화자 구분이 포함된 AI 회의 전사, 44개 언어 대상 실시간 회의 번역, 10가지 포맷의 AI 요약, 그리고 공유 가능한 노트까지. 정직한 한계와 정확한 가격, 그리고 회의 전사 정확도가 실제로 무엇을 요구하는지도 함께 다룹니다.
여덟 명이 사무실에 서 있습니다. 한 사람이 마이그레이션이 왜 밀렸는지 설명하고 있고, 두 사람은 반쯤 흘려듣고 있습니다. 뒤쪽에 선 누군가가 3주 뒤에 중요해질 문장을 말하지만, 아무도 그걸 적지 않습니다.
그게 원재료입니다. 이 글은 그 원재료를 저희 시스템이 어떻게 다루는지, 오디오가 흐르기 시작한 순간부터 채널에 링크를 붙여넣는 순간까지 단계별로 설명합니다.
먼저 밝혀둡니다. 이 글은 Telli.sh를 만드는 팀이 쓴 제품 소개 글입니다. 저희는 리서치 글과 함께 이런 제품 글도 주기적으로 올립니다. 다만 여기서 하려는 건, 회의적인 독자가 직접 검증할 수 있을 만큼 구체적으로 기계 내부를 설명하는 일입니다. 실제 모델 이름, 실제 숫자, 실제 한계로요. "AI 기반"이라는 안개 같은 형용사 말고요.
요약:
- 녹음은 다섯 개의 처리 단계를 거치고, 네 종류의 산출물을 따로 남깁니다. 원문 전사본, 화자 매핑, 정제된 스크립트, 그리고 적용한 포맷별 요약본입니다.
- 화자 구분은
pyannote/speaker-diarization-community-1위에서 청크 단위로 돌아가며, 음성 임베딩을 이어서 누적하기 때문에 5분 차와 50분 차에서 같은 사람이 같은 라벨을 유지합니다.- 번역 대상은 44개 언어 코드, 인터페이스 자체는 15개 언어, 요약은 10가지 기본 포맷에 이름·지시문·섹션 목록으로 직접 정의하는 커스텀 포맷까지 지원합니다.
- 무료 플랜은 카드 없이 월 60분입니다. 유료 플랜은 월 300분, 500분, 1,000분에 각각 5달러, 8달러, 10달러입니다.
이미지: Klean Denmark, "Daily sprint meeting", Wikimedia Commons, CC BY-SA 2.0. 이 파이프라인 전체가 존재하는 이유인 바로 그런 회의.
오디오가 들어오는 경로는 둘, 그리고 둘은 같지 않다
진입점은 정확히 두 개이고, 둘의 차이가 이후 모든 것을 결정합니다.
첫 번째는 실시간 녹음입니다. 브라우저가 16,000Hz 샘플레이트로 고정된 AudioContext를 열고, AudioWorklet을 로드한 뒤 마이크 입력을 4,096 샘플 단위로 버퍼링합니다. 16kHz 기준으로 256밀리초마다 패킷 하나입니다. 각 프레임은 32비트 float에서 16비트 정수 PCM으로 변환돼 /ws/audio/{sessionId} 웹소켓으로 전송됩니다. 두 번째 소켓인 /ws/session/{id}는 제어 채널을 담당합니다. 언어 변경, 컨텍스트 갱신, SUMMARIZE 명령, 그리고 세션을 닫고 노트를 저장하는 FINISH 명령이 여기로 흐릅니다.
두 번째는 파일 업로드입니다. 업로드 모달에 녹음 파일을 떨어뜨리면 POST /upload로 스트리밍되고, 서버는 줄바꿈 구분 JSON으로 응답합니다. 스피너가 아니라 스트림이기 때문에, 가짜 퍼센트 대신 이름이 붙은 실제 단계로 진행 상황을 보여줄 수 있습니다. 여기서 제한은 정직하게 말해두는 편이 낫습니다. 파일당 500MB, 그리고 파일 선택기는 audio/*만 받습니다. MP4 화면 녹화 안에 회의가 들어 있다면 오디오 트랙을 먼저 추출해야 합니다. 그건 지금 저희가 대신 해드리지 않습니다.
두 경로는 같은 처리 축으로 합류합니다. 1단계부터는 실시간 녹음이든 업로드 파일이든 동일하게 다뤄집니다.
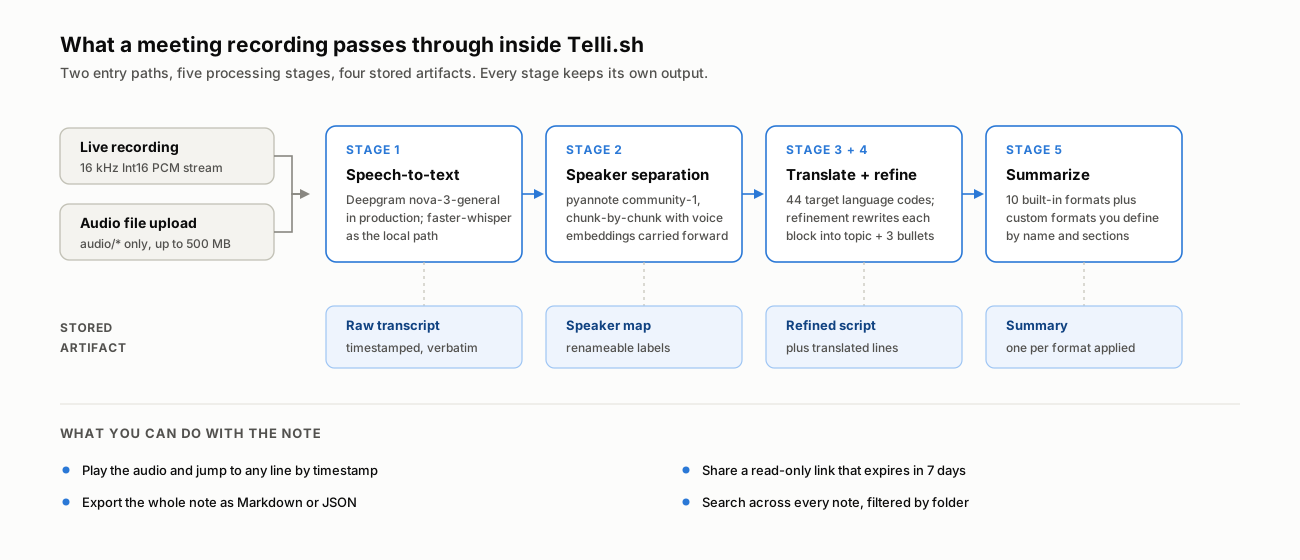
모든 단계는 자기 출력물을 그대로 보관합니다. 다음 단계가 앞 단계를 덮어쓰지 않습니다.
1·2단계: 말을 듣고, 그 말이 누구 것인지 가려낸다
음성 인식이 먼저 돕니다. 프로덕션에서는 배치 경로와 스트리밍 경로 모두 Deepgram의 nova-3-general 모델을 씁니다. 코드베이스에는 자체 호스팅용으로 faster-whisper 기반 로컬 경로도 함께 들어 있고, 프로바이더 설정 하나로 전환됩니다. 그런데 이 선택은 사람들이 기대하는 것보다 훨씬 덜 중요합니다. 이유는 저희가 길게 다룬 적이 있습니다. 독립 벤치마크 상위권 음성 모델들의 단어 오류율은 이제 약 1.5%포인트 안에 몰려 있습니다. 엔진 선택은 더 이상 품질 차이가 생기는 지점이 아닙니다.
품질 차이는 화자 구분에서 생깁니다.
화자 분리는 pyannote/speaker-diarization-community-1으로 돌아갑니다. 실제로 중요한 구현 세부는 긴 녹음을 어떻게 다루느냐입니다. 파일 전체를 한 번에 처리하는 대신, 파이프라인은 오디오를 청크로 나눠 각 청크 직후에 화자를 배정합니다. 동시에 화자별 음성 임베딩 사전을 누적해두고, 이후 모든 청크에서 그 누적된 집합과 대조해 재식별합니다. 두 시간짜리 녹음에서 같은 사람이 슬그머니 SPEAKER_00이었다가 SPEAKER_03이 되고 다시 SPEAKER_07이 되는 전형적인 실패를 막는 장치가 이겁니다.
한 구간이 두 화자의 발언에 걸쳐 있으면, 더 많이 겹치는 쪽으로 라벨이 갑니다. 겹침이 적을 때는 임베딩 유사도가 타이브레이커 역할을 합니다.
라벨은 SPEAKER_00, SPEAKER_01처럼 일반명으로 나옵니다. 모델은 SPEAKER_01이 당신 회사 엔지니어링 총괄이라는 걸 알 방법이 없으니까요. 노트에서 한 번 이름을 바꾸면 그 매핑이 노트와 함께 저장되고 이후 모든 곳에 적용됩니다. 내보내기와 공유 링크에도요. 역할 분담은 정직하게 이렇습니다. 목소리를 갈라내는 건 기계가, 이름을 붙이는 건 사람이 합니다.
각 단계가 실제로 남기는 것
저희가 지키는 설계 원칙은 하나입니다. 어떤 단계도 앞 단계의 출력을 파괴하지 않는다. 실제로 무슨 말이 나왔는지로 언제든 돌아갈 수 있어야 합니다.
| 산출물 | 생성 단계 | 내용 | 용도 |
|---|---|---|---|
| 원문 전사본 | 1·2단계 | 타임스탬프가 붙은 축자 문장, 줄마다 화자 라벨 | 실제로 무슨 말이 나왔는지 확인, 줄 클릭으로 오디오 이동 |
| 화자 매핑 | 2단계 + 사용자 편집 | 노트의 라벨-이름 대응표 | 나머지 모든 화면을 읽을 수 있게 만듦. 노트·내보내기·공유에 적용 |
| 정제된 스크립트 | 4단계 | 블록마다 굵은 주제 한 줄과 최대 3개 요점 | 긴 회의를 다 읽지 않고 훑기 |
| 번역문 | 3단계 | 원문 옆에 붙는 줄 단위 번역 | 내가 쓰지 않는 언어로 진행된 회의 읽기 |
| 요약본 | 5단계 | 적용한 포맷마다 하나씩 생성되는 구조화 문서 | 실제로 사람들에게 보내는 물건 |
노트 화면에서는 세 종류의 탭으로 보입니다. 히스토리(원문 전사본), 스크립트(정제본), 그리고 생성한 요약 포맷마다 하나씩입니다. 녹음 오디오가 저장돼 있으면 위쪽에 플레이어가 붙고, 전사본의 아무 줄이나 클릭하면 그 타임스탬프로 오디오가 이동합니다.
3단계: 번역에서 중요한 숫자는 44다
실시간 회의 번역은 초기 사용자를 가장 많이 끌어온 기능이고, 범위를 정확히 말해둘 가치가 있습니다. 이 카테고리에서 "100개 이상 언어 지원"만큼 검증하기 어려운 문구도 없으니까요.
서로 다른 두 숫자가 있고, 같은 숫자가 아닙니다.
- 번역 대상으로 허용되는 언어 코드는 44개입니다. 백엔드 설정에 명시적으로 나열돼 있고,
zh와 구분되는zh-TW가 포함됩니다. 대만과 중국 본토를 함께 다룬다면 들리는 것보다 훨씬 중요한 차이입니다. - 인터페이스 자체와 AI가 요약을 써주는 언어는 15개입니다. 영어, 한국어, 일본어, 중국어, 독일어, 프랑스어, 스페인어, 이탈리아어, 포르투갈어, 러시아어, 폴란드어, 베트남어, 태국어, 인도네시아어, 말레이어입니다.
실시간 세션에서 번역은 끝에 몰아서가 아니라 점진적으로 이뤄집니다. 전사본에 문장부호 경계가 도착할 때마다 해당 구간의 번역이 원문 옆으로 흘러들어오고, 세션별 캐시가 바뀌지 않은 텍스트의 재번역을 막습니다. 파일 업로드에서는 대신 줄을 묶어서 배치로 처리합니다. 아무도 화면을 보고 있지 않을 때는 지연 시간보다 처리량이 중요하니까요.
노트 모드와 구분되는 번역 워크플로 모드도 있습니다. 회의록이 아니라 번역 자체가 결과물인 경우, 즉 실시간으로 따라가야 하는 이중언어 대화를 위한 모드입니다.
4단계: 아무도 요구하지 않지만 모두에게 필요한 단계
여기서 설명이 의견으로 넘어갑니다. 그리고 이 의견에는 단서를 달지 않겠습니다. 정제 단계는 이 파이프라인에서 가장 저평가된 단계입니다.
사람 말의 축자 전사본은 거의 읽을 수 없습니다. 사람은 문장을 다시 시작하고, 말끝을 흐리고, "네 네 맞아요"를 네 번 반복하고, 하나의 결정을 90초짜리 헛기침 속에 파묻습니다. 그걸 단어 하나 안 틀리고 받아 적어봐야 여전히 90초짜리 헛기침입니다.
그래서 정제 단계는 대화를 블록 단위로 잘라 엄격한 제약 아래 다시 씁니다. 이 제약은 코드가 아니라 프롬프트 템플릿에 정의돼 있어서 배포 없이 조정할 수 있습니다. 각 블록은 내용에서 도출된 굵은 주제 한 줄로 시작합니다. 역할 이름도 아니고 대괄호도 없습니다. 그 뒤에 최대 세 개의 요점이 붙고, 블록당 약 300자를 목표로 합니다. 화자 이름과 타임스탬프는 명시적으로 제거합니다. 이미 원문 전사본에 있는 정보이고, 반복하면 훑어보기용 화면이 덜 훑어보기 좋아지니까요.
그 템플릿에 들어 있는 제약 하나는 따로 이름을 붙일 가치가 있습니다. 모델은 들은 내용의 어조에 맞추라는 지시를 받고, 특히 편한 대화에 비즈니스 회의체를 억지로 씌우지 말라는 지시를 받습니다. 복도에서 나눈 잡담을 이사회 회의록처럼 요약한 결과물은 요약이 아예 없는 것보다 나쁩니다.
저희는 그 결과물을 스크립트라고 부릅니다. 한눈에 읽을 수 있는 버전이고, 분쟁 상황에서 인용할 수 있는 버전은 탭 하나 옆에 그대로 남아 있습니다.
5단계: 요약 포맷이 열 가지인 이유
마지막 단계는 실제로 보낼 문서를 만듭니다. LLM에게 그냥 "요약해줘"라고 하면 아무것도 아닌 것에 대한 요약이 나옵니다. 그래서 포맷은 숨겨진 기본값이 아니라 일급 선택지입니다.
기본 제공 포맷은 열 가지입니다. AI 요약(범용), 회의록, 보고용 요약, 강의 노트, 설교 / 강연, 상담 기록, 통화 요약, 인터뷰, 아이디어 노트, 발표 자료입니다. 각각 고유한 섹션 구조를 갖습니다. 회의록은 회의 개요, 주요 논의 사항, 결정 사항, 다음 단계 및 실행 항목을 만들고, 발표 자료는 발표 개요, 슬라이드 흐름, 핵심 메시지, 발표자 노트, 다음 액션을 만듭니다. 섹션 제목 자체가 언어별로 현지화돼 있어서 생성 시점에 번역되지 않습니다. 일본어 요약이 번역된 영어 문서가 아니라 일본어 문서처럼 읽히는 이유입니다.
열 가지 중 맞는 게 없으면 커스텀 포맷을 정의합니다. 이름, 지시문, 원하는 섹션 목록을 저장해두고 재사용합니다. "리스크와 미결 사항이 포함된 주간 이사회 업데이트"는 한 번만 써두면 되는 포맷입니다.
어떤 포맷이든 나중에 노트에 적용할 수 있고, 각각 자기 탭을 만듭니다. 같은 녹음을 세 부류의 독자를 위해 세 가지로 요약하는 건 여기서 편법이 아니라 정상적인 사용법입니다.
회의 전사 정확도는 숫자가 아니라 스택이다
이 카테고리의 도구를 비교 중이라면, 반박해볼 만한 절은 여기입니다.
업계는 단어 오류율이라는 숫자 하나를 발표하고, 그 숫자는 제품 선택에는 더 이상 쓸모가 없어졌습니다. 다들 바닥 근처에 몰려 있기 때문입니다. 저희는 그 논지를 STT 정확도만으로는 부족하다에서 자세히 해부했습니다. "않는다" 하나가 빠지면서 결정이 뒤집히는데도 정확도 예산에서는 0.016%밖에 쓰지 않는 사례를 포함해서요.
실무적으로 정리하면 이렇습니다. 실제 회의에서 살아남는 전사 정확도는 다섯 개 층으로 만들어지고, 음향 모델은 그중 맨 아래 한 층일 뿐입니다.
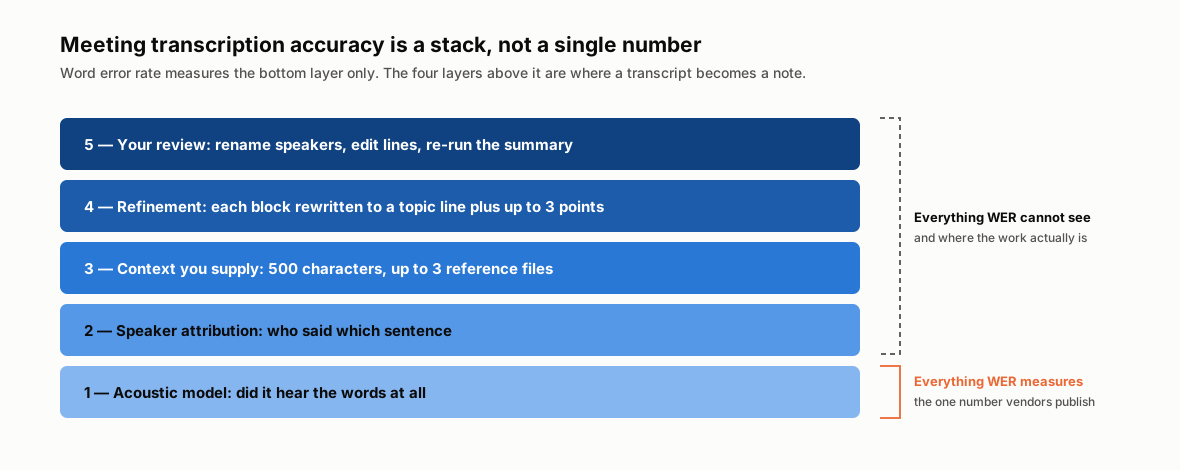
단어 오류율이 재는 건 1층뿐입니다. 전사본이 쓸 만한지를 결정하는 건 2층부터 5층입니다.
3층은 사용자가 직접 통제할 수 있는데도 대부분이 건너뛰는 층입니다. 녹음이나 업로드 전에 최대 500자의 컨텍스트 블록을 넣을 수 있습니다. 주제, 참석자 이름, 제품 코드, 약어 같은 것들이요. 그리고 참고 파일을 최대 3개 첨부할 수 있습니다. PDF, 이미지, 텍스트 파일의 텍스트를 브라우저에서 추출해 같은 500자 예산에 접어 넣습니다. 이 컨텍스트는 AI 단계로 전달됩니다.
이건 있으면 좋은 기능이 아닙니다. 고유명사는 어떤 회의에서든 정보량이 가장 높으면서 빈도는 가장 낮은 단어입니다. 내부 프로젝트명, 흔치 않은 성씨, 제품 SKU 같은 것들이죠. "케스트렐"이 제품이고 "라비"가 사람이라고 미리 알려주는 데는 15초가 들고, 그러지 않으면 손으로 10분 동안 고칠 오류가 사라집니다. 이 글을 읽고 딱 하나만 바꾼다면, 컨텍스트 입력란을 채우세요.
아무것도 없는 상태에서 공유 노트까지, 11단계
구체적으로, 첫 실행부터 공유 가능한 산출물까지입니다.
- 가입합니다. 무료 플랜은 카드 없이 월 60분이고, 유료 플랜과 동일한 파이프라인이 돕니다. 기능 차이가 아니라 할당량 차이입니다.
- 경로를 고릅니다. 실시간 녹음을 시작하거나, 업로드 모달을 열고 오디오 파일을 떨어뜨립니다.
audio/*, 500MB 미만입니다. - 언어 쌍을 설정합니다. 원본 언어는 자동 감지로 둬도 되고, 대상 언어가 번역과 요약이 나올 언어를 결정합니다.
- 컨텍스트 입력란을 채웁니다. 주제, 이름, 약어를 500자 안에서요. 덱이나 아젠다가 있으면 참고 파일을 최대 3개까지 붙입니다.
- 특정 위치에 정리하고 싶으면 폴더를 지정합니다. 나중에 옮겨도 됩니다.
- 녹음하거나 업로드 스트림을 기다립니다. 실시간 세션에서는 사람들이 말하는 대로 전사본이 나타나고, 대상 언어를 설정했다면 번역이 옆으로 흘러들어옵니다. 업로드 중에는 이름 붙은 단계가 보입니다. 음성 인식, 분석, 정제, 요약, 마무리 순입니다.
- 세션을 종료합니다.
FINISH제어 메시지가 발동해 마지막 구간을 비우고, 진행 중이던 정제를 기다리고, 오디오를 저장하고, 요약을 생성하고, 노트를 씁니다. - 화자 이름을 바꿉니다. SPEAKER_00을 한 번 실제 이름으로 바꾸면 매핑이 모든 화면과 모든 내보내기에 전파됩니다.
- 스크립트 탭으로 회의가 무슨 내용이었는지 파악하고, 이상해 보이는 대목이 있으면 히스토리로 내려가 그 줄을 클릭해 정확히 그 순간의 오디오를 듣습니다.
- 한쪽 독자에게는 회의록이, 다른 쪽에는 보고용 요약이 필요하다면 요약 포맷을 추가로 생성합니다.
- 공유하거나 내보냅니다. 공유 링크는 읽기 전용이고 7일 뒤 만료되며, 선택적으로 비밀번호를 걸 수 있습니다. 내보내기는 마크다운이나 JSON을 주고, 요약·정제 블록·전체 전사본이 한 파일에 담깁니다.
비용, 정확한 숫자로
할당량은 처리된 오디오의 분 단위로 계산되고, 등급을 가르는 건 그것뿐입니다.
| 플랜 | 월 사용 가능 분 | 월 요금 | 연 요금 | 100분당 실질 비용 |
|---|---|---|---|---|
| 무료 | 60 | USD 0 | — | — |
| 플러스 | 300 | USD 5.00 | USD 51.00 | USD 1.67 |
| 프로 | 500 | USD 8.00 | USD 81.60 | USD 1.60 |
| 프로+ | 1,000 | USD 10.00 | USD 102.00 | USD 1.00 |
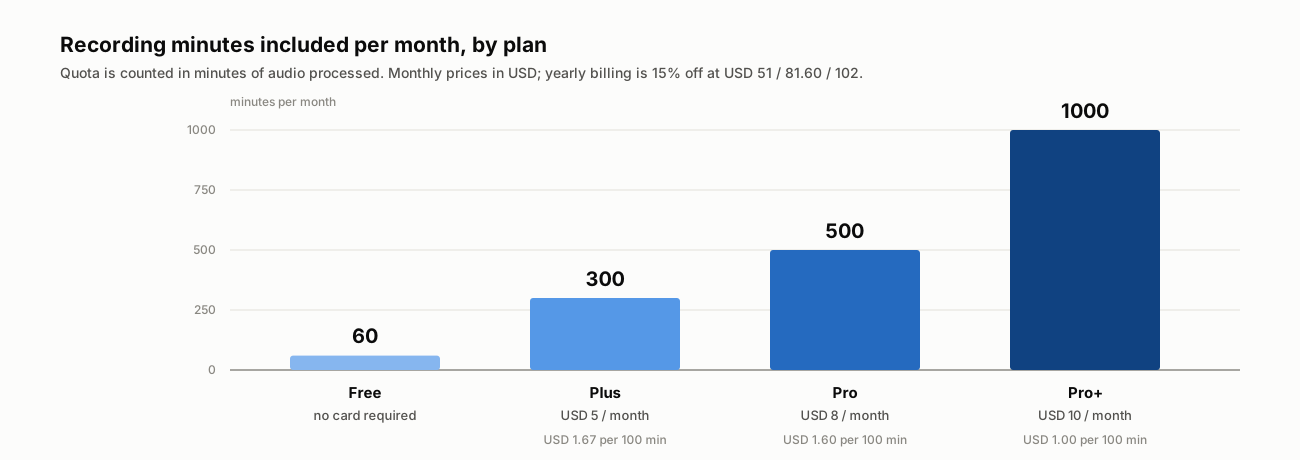
연 결제는 월 요금 × 12 × 0.85입니다. 등급이 올라갈수록 분당 단가가 좋아지고, 파이프라인은 달라지지 않습니다.
무료 60분은 긴 회의 하나, 또는 스탠드업 세 번입니다. 정말 중요한 질문 하나에 답하기에는 충분합니다. 이게 내가 실제로 보낼 만한 노트를 만들어내는가? 벤더 데모가 아니라 당신 오디오로요.
Telli.sh가 하지 않는 일
기능만 나열하는 제품 글은 광고입니다. 반대쪽 항목은 이렇습니다.
영상 파일을 받지 않습니다. 업로더는 audio/*만 받습니다. 오디오 트랙을 먼저 추출하세요.
통화에 대신 들어가지 않습니다. Zoom, Meet, Teams에 전화를 걸어 참가자 목록에 앉아 있는 봇이 없습니다. 회의실을 녹음하거나, 본인 기기의 오디오를 녹음하거나, 끝난 뒤 파일을 올리는 방식입니다.
나쁜 오디오를 고쳐주지 않습니다. 이건 카테고리 전체의 정직한 경계선입니다. 열두 명이 앉은 테이블 끝에 놓인 무지향성 노트북 마이크 하나로, 벽이 단단한 회의실에서 녹음하면 어떤 회사 모델을 돌려도 화자 분리 품질이 떨어집니다. 겹쳐 말하기와 멀리 있는 화자가 화자 귀속이 가장 먼저 무너지는 지점입니다. 테이블 한가운데 놓은 휴대폰이 테이블 끝의 노트북을 언제나 이기고, 비용은 0원입니다.
말해주지 않으면 당신 어휘를 모릅니다. 위의 3층 이야기입니다. 흔치 않은 고유명사가 가장 흔한 오류 원인이고, 컨텍스트 입력란이 해법입니다.
화자 라벨은 일반명으로 시작합니다. SPEAKER_01이 프리야라는 걸 알아맞힐 수 있는 시스템은 없습니다. 노트마다 한 번 이름을 바꾸면 됩니다.
공유 링크에는 기한이 있습니다. 7일, 그다음엔 링크가 죽습니다. 회의 콘텐츠에 대한 의도적인 기본값이지 빠뜨린 기능이 아닙니다. 다만 공유 링크는 보관소가 아니라는 뜻이기도 합니다. 영구 보관이 필요하면 마크다운으로 내보내세요.
결론
초기에 저희가 한 실수는 이걸 전사 제품이라고 생각한 것이었습니다. 아닙니다. 전사는 다섯 단계 중 1단계이고, 그중 해결에 가장 가까이 간 단계입니다.
저희가 실제로 만드는 건 녹음과 결정 사이의 거리입니다. 누가 말했는지 아는 일, 90초짜리 헛기침을 그 안에 든 한 문장으로 줄이는 일, 그 문장을 읽는 사람이 일하는 언어로 옮기는 일, 그리고 동료가 열어볼 수 있는 곳에 놓는 일입니다. 녹음은 증거입니다. 노트는 다음 주에 무슨 일이 일어날지를 바꾸는 물건입니다.
지금 컴퓨터에 회의 녹음 파일이 하나 있다면, 그게 유일하게 의미 있는 벤치마크입니다. 저희 경우엔 세팅에 60초가 걸렸고, 네 사람에게 보낸 노트가 나왔습니다.
출처
- STT 정확도만으로는 부족하다 — Telli.sh 블로그, 2026년 8월 4일 — 리더보드 격차를 포함한 단어 오류율 논지 전문
- pyannote/speaker-diarization-community-1 — Hugging Face — 이 파이프라인에서 쓰는 화자 분리 모델
- Deepgram Nova-3 모델 문서 — 프로덕션에서 쓰는 음성 인식 모델
- Telli.sh 요금제 — 위에 인용한 플랜 할당량과 가격
- Wikimedia Commons 이미지 페이지 — 대표 이미지, Klean Denmark, CC BY-SA 2.0
