Cinco etapas, cuatro artefactos: qué hace realmente Telli.sh con la grabación de una reunión
Un recorrido por toda la tubería de Telli.sh: grabación en vivo o subida de audio, transcripción de reuniones con IA e identificación de hablantes, traducción de reuniones en tiempo real a 44 idiomas de destino, resúmenes con IA en 10 formatos y una nota que se puede compartir. Con los límites honestos, los precios exactos y lo que de verdad exige la precisión de transcripción.
Ocho personas de pie en una sala. Una explica por qué se ha retrasado la migración. Dos escuchan a medias. Alguien al fondo dice la frase que importará dentro de tres semanas, y nadie la anota.
Esa es la materia prima. Este artículo trata de qué hace nuestro sistema con ella, etapa por etapa, desde que el audio empieza a moverse hasta que pegas un enlace en un canal.
Este es un recorrido del producto, preparado por el equipo que desarrolla Telli.sh. Sigue el audio desde la grabación o la carga hasta la transcripción, la traducción, el refinamiento y una nota que se puede compartir, e identifica los modelos, límites y precios en cada etapa.
Resumen:
- Una grabación atraviesa cinco etapas de procesamiento y deja cuatro artefactos guardados por separado: la transcripción en bruto, el mapa de hablantes, el guion depurado y un resumen por cada formato aplicado.
- La identificación de hablantes corre sobre
pyannote/speaker-diarization-community-1, bloque a bloque, arrastrando las huellas de voz para que la misma persona conserve la misma etiqueta del minuto 5 al minuto 50.- La traducción admite 44 códigos de idioma; la interfaz existe en 15 idiomas; los resúmenes llegan en 10 formatos integrados más los formatos propios que definas con nombre, instrucciones y lista de secciones.
- Consulta los precios actuales para facturación mensual o anual, minutos y funciones por plan. Pueden cambiar; verifica moneda, impuestos y condiciones al pagar. Este artículo no es una cotización.
Imagen: Klean Denmark, «Daily sprint meeting», Wikimedia Commons, CC BY-SA 2.0. Justo el tipo de reunión por el que existe toda esta tubería.
Hay dos formas de que entre el audio, y no son la misma
Hay exactamente dos puntos de entrada, y la diferencia entre ellos condiciona todo lo que viene después.
El primero es la grabación en vivo. El navegador abre un AudioContext fijado a 16.000 Hz, carga un AudioWorklet y almacena la entrada del micrófono en bloques de 4.096 muestras: a 16 kHz, un paquete cada 256 milisegundos. Cada bloque pasa de coma flotante de 32 bits a PCM entero de 16 bits y viaja por WebSocket hasta /ws/audio/{sessionId}. Un segundo socket, /ws/session/{id}, lleva el canal de control: cambios de idioma, actualizaciones de contexto, el comando SUMMARIZE y el comando FINISH, que cierra la sesión y escribe la nota.
El segundo es la subida de archivos. Sueltas una grabación en la ventana de subida, se transmite a POST /upload y la respuesta llega como JSON delimitado por líneas —un flujo, no un icono girando— para que la interfaz muestre progreso real con pasos con nombre y no un porcentaje inventado. Los límites conviene decirlos con claridad: 500 MB por archivo, y el selector solo acepta audio/*. Si tu reunión está dentro de una grabación de pantalla en MP4, hay que extraer antes la pista de audio. Eso hoy no lo hacemos por ti.
Ambos caminos convergen en la misma columna de procesamiento. A partir de la etapa 1, una grabación en vivo y un archivo subido reciben el mismo trato.
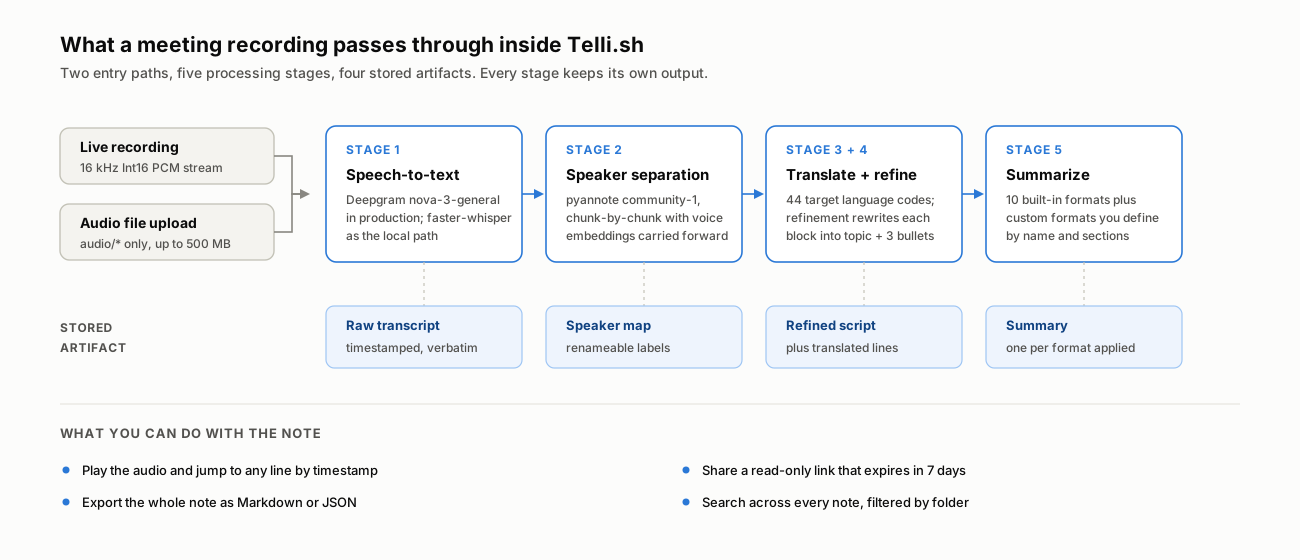
Cada etapa conserva su propia salida. Nada lo sobrescribe la etapa siguiente.
Etapas 1 y 2: oír las palabras y averiguar de quién eran
Primero corre el reconocimiento de voz. En producción, tanto la ruta por lotes como la de streaming usan el modelo nova-3-general de Deepgram; el código incluye además una ruta totalmente local basada en faster-whisper para despliegues autoalojados, que se selecciona con un único ajuste de proveedor. Esa elección importa menos de lo que la gente espera, por un motivo sobre el que hemos escrito largo y tendido: los mejores modelos de voz de los rankings independientes se agrupan hoy en torno a 1,5 puntos porcentuales de tasa de error de palabra. El motor ya no es donde vive la diferencia de calidad.
Donde vive es en la identificación de hablantes.
La diarización corre sobre pyannote/speaker-diarization-community-1. El detalle de implementación que de verdad importa es cómo trata las grabaciones largas. En lugar de diarizar el archivo entero de una pasada, la tubería procesa el audio por bloques y asigna hablantes justo después de cada bloque, pero mantiene un diccionario acumulado de huellas de voz por hablante y vuelve a identificar contra ese conjunto en cada bloque posterior. Ese es el mecanismo que evita el fallo clásico: una grabación de dos horas que renombra en silencio a la misma persona como SPEAKER_00, luego SPEAKER_03 y luego SPEAKER_07 según avanza la reunión.
Cuando un segmento se solapa con dos turnos de palabra, la etiqueta va al turno que más lo cubre, y la similitud de huellas actúa de desempate en los casos de poco solapamiento.
Recibes etiquetas genéricas —SPEAKER_00, SPEAKER_01— porque un modelo no puede saber que SPEAKER_01 es tu directora de ingeniería. Las renombras una vez en la nota y esa correspondencia se guarda con ella y se aplica en todas partes después, incluidas exportaciones y enlaces compartidos. Ese es el reparto honesto: la máquina separa las voces, tú pones los nombres.
Qué deja realmente cada etapa
La regla de diseño que mantenemos es que ninguna etapa destruye la salida de la anterior. Siempre debes poder volver a las palabras que se dijeron de verdad.
Los cuatro grupos guardados son transcripción, mapa de hablantes, texto refinado y resumen. Las traducciones van unidas a la transcripción; la quinta fila no es un quinto elemento independiente.
| Artefacto | Lo produce | Qué contiene | Para qué sirve |
|---|---|---|---|
| Transcripción en bruto | Etapas 1 + 2 | Líneas literales con marca de tiempo y etiqueta de hablante en cada una | Comprobar qué se dijo literalmente; pulsar una línea para saltar al audio |
| Mapa de hablantes | Etapa 2 (+ tus ediciones) | La correspondencia etiqueta-nombre de la nota | Hace legibles todas las demás vistas: se aplica en la nota, en exportaciones y en enlaces |
| Guion depurado | Etapa 4 | Cada bloque reescrito como una línea de tema en negrita y hasta 3 puntos | Ojear una reunión larga sin leerla |
| Líneas traducidas | Etapa 3 | Una traducción junto a cada línea original | Leer una reunión celebrada en un idioma con el que no trabajas |
| Resumen | Etapa 5 | Un documento estructurado por cada formato aplicado | Lo que realmente envías a la gente |
En la interfaz esto aparece como tres tipos de pestañas: Historial (transcripción en bruto), Guion (versión depurada) y una pestaña por cada formato de resumen generado. Si el audio se ha guardado, encima aparece un reproductor y, al pulsar cualquier línea de la transcripción, el audio salta a esa marca de tiempo.
Etapa 3: en traducción, la cifra que importa es 44
La traducción de reuniones en tiempo real es la función que más usuarios tempranos nos trajo, y merece la pena precisar su alcance, porque «compatible con más de 100 idiomas» es la afirmación menos verificable de esta categoría.
Hay dos cifras distintas y no son la misma:
- Se aceptan 44 códigos de idioma de destino para la traducción. Ese conjunto está enumerado de forma explícita en la configuración del backend e incluye
zh-TWcomo distinto dezh, algo que pesa más de lo que parece si trabajas entre Taiwán y China continental. - Hay 15 idiomas para la propia interfaz y para el idioma en el que la IA escribe tu resumen: inglés, coreano, japonés, chino, alemán, francés, español, italiano, portugués, ruso, polaco, vietnamita, tailandés, indonesio y malayo.
En una sesión en vivo la traducción es incremental, no se agrupa al final. Cuando llegan límites de puntuación a la transcripción, la traducción de ese segmento fluye junto al original, y una caché por sesión evita retraducir texto que no ha cambiado. En la subida de archivos, en cambio, las líneas se agrupan por lotes: cuando nadie mira una pantalla, importa más el rendimiento que la latencia.
También existe un modo de flujo de traducción, distinto del modo nota, para cuando la traducción es el entregable: una conversación bilingüe que hay que seguir en directo, no una reunión de la que hay que sacar un acta.
Etapa 4: la etapa que nadie pide y todo el mundo necesita
Aquí pasamos de la descripción a la opinión, y no la vamos a matizar: la depuración es la etapa más infravalorada de esta tubería.
Una transcripción literal del habla humana es casi ilegible. La gente reinicia frases, deja el final colgando, dice «sí, sí, claro» cuatro veces y entierra una decisión en noventa segundos de carraspeos. Transcribir eso sin fallar una palabra siguen siendo noventa segundos de carraspeos.
Por eso la etapa de depuración toma cada bloque de conversación y lo reescribe con restricciones estrictas, definidas en una plantilla de prompt y no en código, de modo que podemos ajustarlas sin desplegar. Cada bloque se convierte en una línea de tema en negrita derivada del contenido —no de un nombre de rol, no entre corchetes—, seguida de tres viñetas como máximo, con unos 300 caracteres por bloque como objetivo. Los nombres de hablante y las marcas de tiempo se eliminan de forma explícita: ya están en la transcripción en bruto, y repetirlos solo hace que la vista para ojear se ojee peor.
Una restricción de esa plantilla merece mención propia: al modelo se le indica que se ajuste al registro de lo que ha oído y, en concreto, que no imponga un tono de reunión de negocios a una conversación informal. Una charla de pasillo resumida como si fuera un acta del consejo es un artefacto peor que no tener resumen.
Al resultado lo llamamos el guion: la versión que puedes leer de un vistazo, a una pestaña de la versión que puedes citar en una disputa.
Etapa 5: diez formatos de resumen, porque «resumen» no es una sola cosa
La última etapa produce el documento que de verdad envías. Pedirle a un LLM «un resumen» te da el resumen de nada en particular, así que aquí el formato es una elección de primera clase y no un valor por defecto escondido.
Vienen diez formatos integrados: Resumen IA (general), Acta de reunión, Informe ejecutivo, Apuntes de clase, Sermón / Charla, Registro de sesión de asesoramiento, Resumen de llamada, Entrevista, Notas de ideas y Guion de presentación. Cada uno lleva su propia estructura de secciones: el acta produce visión general, puntos discutidos, decisiones y próximos pasos; el guion de presentación produce esquema, flujo de diapositivas, mensajes clave, notas del ponente y acciones siguientes. Los títulos de sección están localizados por idioma en lugar de traducirse al generar, y por eso un resumen en japonés se lee como un documento japonés y no como un texto inglés traducido.
Cuando ninguno de los diez encaja, defines un formato personalizado: un nombre, unas instrucciones y la lista de secciones que quieras, guardado y reutilizable. «Actualización semanal para el consejo con riesgos y decisiones pendientes» es un formato que se escribe una vez.
Cualquier formato puede aplicarse después a una nota y genera su propia pestaña. Resumir la misma grabación de tres formas para tres públicos es aquí un uso normal, no un apaño.
La precisión de transcripción es una pila, no un número
La tasa de error de palabra es solo una parte de la evaluación de una transcripción de reunión. En La precisión del STT no basta explicamos por qué perder un solo «no» puede invertir una decisión y apenas afectar a la puntuación general.
La versión práctica: la precisión de transcripción que sobrevive al contacto con una reunión real se construye en cinco capas, y el modelo acústico es solo la de abajo.
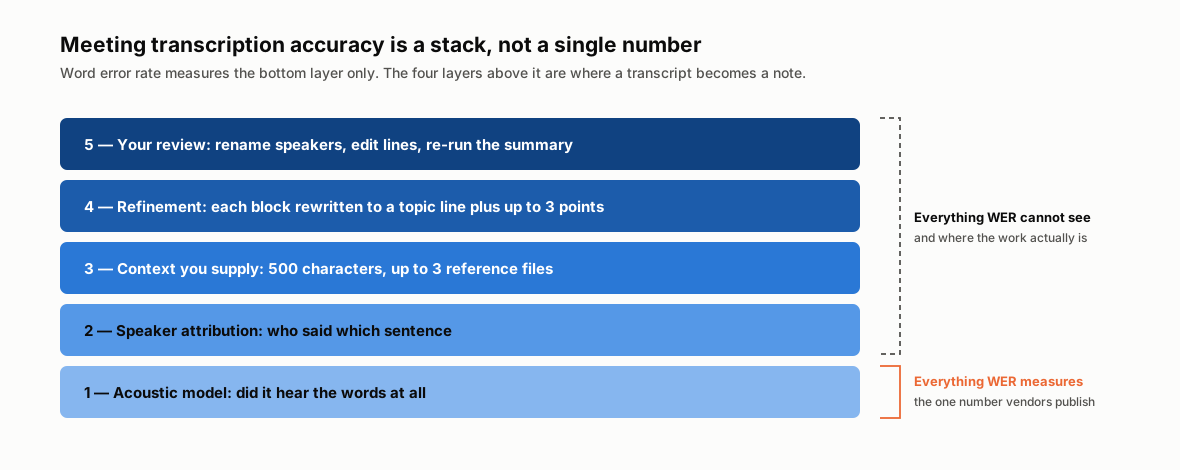
La tasa de error mide la capa 1. Las capas 2 a 5 deciden si la transcripción sirve.
La capa 3 es la que el usuario controla directamente y la que casi todo el mundo se salta. Antes de grabar o subir puedes aportar un bloque de contexto de hasta 500 caracteres —tema, nombres de participantes, códigos de producto, siglas— y adjuntar hasta 3 archivos de referencia (PDF, imagen o texto), cuyo texto se extrae en el navegador y se pliega en ese mismo presupuesto. Ese contexto se pasa a las etapas de IA.
Los nombres propios aportan mucha información, pero son poco frecuentes en los datos generales de entrenamiento: nombres de proyectos internos, apellidos poco comunes y referencias de producto. Añadir contexto —por ejemplo, indicar que «Kestrel» es un producto y «Ravi» una persona— ayuda al sistema a reconocerlos. Antes de grabar, rellena el campo de contexto con nombres y términos que el sistema quizá no conozca.
De cero a una nota compartida, en once pasos
En concreto, de la primera ejecución al artefacto compartible:
- Regístrate. Consulta los precios actuales para facturación mensual o anual, minutos y funciones por plan. Pueden cambiar; verifica moneda, impuestos y condiciones al pagar. Este artículo no es una cotización.
- Elige el camino: inicia una grabación en vivo o abre la ventana de subida y suelta un archivo de audio (
audio/*, menos de 500 MB). - Fija el par de idiomas. El origen puede quedarse en detección automática; el idioma de destino decide en qué salen la traducción y el resumen.
- Rellena el campo de contexto: tema, nombres, siglas, hasta 500 caracteres. Adjunta hasta 3 archivos de referencia si tienes una presentación o un orden del día.
- Elige carpeta si quieres archivar la nota en un sitio concreto. Puedes moverla después.
- Graba o espera al flujo de subida. En una sesión en vivo la transcripción aparece mientras la gente habla, con la traducción entrando al lado si has fijado idioma de destino. Durante una subida verás pasos con nombre: reconocimiento de voz, análisis, depuración, resumen y finalización.
- Termina la sesión. Eso dispara el mensaje de control
FINISH, que vacía el último segmento, espera a la depuración en curso, guarda el audio, genera el resumen y escribe la nota. - Renombra a los hablantes. SPEAKER_00 pasa a ser un nombre una vez y la correspondencia se propaga a todas las vistas y exportaciones.
- Lee la pestaña Guion para ver de qué iba la reunión; baja a Historial y pulsa una línea para oír el audio en ese momento exacto cuando algo parezca mal.
- Genera formatos de resumen adicionales si un público necesita el acta y otro el informe ejecutivo.
- Comparte o exporta. Un enlace compartido es de solo lectura, caduca a los 7 días y admite contraseña opcional. La exportación te da Markdown o JSON, con el resumen, los bloques depurados y la transcripción completa en un mismo archivo.
Sube una grabación que ya tengas
Precios simples y transparentes
Consulta los precios actuales para facturación mensual o anual, minutos y funciones por plan. Pueden cambiar; verifica moneda, impuestos y condiciones al pagar. Este artículo no es una cotización.
La licencia actual permite uso personal no comercial. Consulta términos, seguridad y privacidad. Pregunta a [email protected] sobre conservación y entrenamiento de IA antes de subir material sensible.
Lo que Telli.sh no hace
Un artículo de producto que solo enumera capacidades es un anuncio. Esta es la otra columna.
No admite archivos de vídeo. El subidor acepta audio/*. Extrae antes la pista de audio.
No se une a tus llamadas. No hay ningún bot que marque en Zoom, Meet o Teams y se siente en la lista de participantes. Grabas la sala, o el audio de tu propio equipo, o subes el archivo después.
No arregla el audio malo. Un micrófono omnidireccional de portátil en un extremo de una mesa de doce personas, en una sala de paredes duras, degradará la diarización corra el modelo de quien corra: el habla superpuesta y los hablantes lejanos son el primer punto donde se rompe la atribución. Un móvil en el centro de la mesa gana siempre al portátil del extremo, y no cuesta nada.
No conoce tu vocabulario si no se lo dices. Ver la capa 3 de más arriba. Los nombres propios poco habituales son la fuente de error más común, y el campo de contexto es el remedio.
Las etiquetas de hablante empiezan genéricas. Ningún sistema puede adivinar que SPEAKER_01 es Priya. Se renombra una vez por nota.
Los enlaces compartidos tienen fecha límite. Siete días y el enlace muere. Es un valor por defecto deliberado para contenido de reuniones, no una función que se nos olvidara, pero significa que un enlace compartido no es un archivo permanente. Exporta el Markdown si necesitas permanencia.
En resumen
Telli.sh es más que un producto de transcripción. La transcripción es la primera de cinco etapas, seguida de la atribución de hablantes, el refinamiento, la traducción y los resúmenes.
Lo que construimos en realidad es la distancia entre una grabación y una decisión: saber quién habló, reducir los noventa segundos de carraspeos a la frase que contienen, ofrecer esa frase en el idioma en el que trabaja quien la lee y dejarla donde un colega pueda abrirla. La grabación es una prueba. La nota es lo que cambia lo que ocurrirá la semana que viene.
Si tienes una grabación de una reunión, prueba el flujo con tu propio audio y revisa la nota resultante comparándola con la transcripción.
Inicia una sesión en directo con traducción
Fuentes
- La precisión del STT no basta — blog de Telli.sh, 4 de agosto de 2026 — el argumento completo sobre la tasa de error, con la dispersión del ranking
- pyannote/speaker-diarization-community-1 — Hugging Face — el modelo de diarización usado en esta tubería
- Documentación del modelo Deepgram Nova-3 — el modelo de reconocimiento de voz usado en producción
- Precios de Telli.sh — cuotas y precios vigentes
- Página de la imagen en Wikimedia Commons — imagen de cabecera, Klean Denmark, CC BY-SA 2.0
