Fünf Stufen, vier Artefakte: Was Telli.sh mit einer Meeting-Aufnahme tatsächlich macht
Ein Produkt-Walkthrough der gesamten Telli.sh-Pipeline — Live-Aufnahme oder Audio-Upload, KI-Meeting-Transkription mit Sprechererkennung, Echtzeit-Meetingübersetzung in 44 Zielsprachen, KI-Zusammenfassungen in 10 Formaten und eine teilbare Notiz. Mit den ehrlichen Grenzen, den exakten Preisen und dem, was Transkriptionsgenauigkeit wirklich erfordert.
Acht Menschen stehen in einem Raum. Einer erklärt, warum die Migration sich verschoben hat. Zwei hören halb zu. Jemand hinten sagt den Satz, auf den es in drei Wochen ankommen wird, und niemand schreibt ihn auf.
Das ist das Rohmaterial. Dieser Beitrag beschreibt, was unser System damit macht — Stufe für Stufe, vom Moment, in dem Audio zu fließen beginnt, bis zu dem Moment, in dem Sie einen Link in einen Channel einfügen.
Vorweg, damit niemand raten muss: Dies ist ein Produktbeitrag über Telli.sh, geschrieben vom Team, das es baut. Wir veröffentlichen solche Beiträge regelmäßig neben unseren Recherchetexten. Der Anspruch hier ist, die Maschinerie präzise genug zu beschreiben, dass eine skeptische Leserschaft die Angaben nachprüfen kann — echte Modellnamen, echte Zahlen, echte Grenzen statt des üblichen Nebels aus „KI-gestützt".
Kurzfassung:
- Eine Aufnahme durchläuft fünf Verarbeitungsstufen und hinterlässt vier getrennt gespeicherte Artefakte: das Roh-Transkript, die Sprecherzuordnung, das verdichtete Skript und je eine Zusammenfassung pro angewendetem Format.
- Die Sprechererkennung läuft auf
pyannote/speaker-diarization-community-1, blockweise und mit fortgeschriebenen Stimm-Embeddings — damit dieselbe Person in Minute 5 und in Minute 50 dasselbe Label behält.- Übersetzt wird in 44 Sprachcodes, die Oberfläche selbst gibt es in 15 Sprachen, Zusammenfassungen in 10 vorgefertigten Formaten plus beliebigen eigenen Formaten aus Name, Anweisung und Abschnittsliste.
- Der kostenlose Tarif umfasst 60 Minuten pro Monat ohne Karte. Bezahlt kosten 300, 500 und 1.000 Minuten 5, 8 bzw. 10 US-Dollar im Monat.
Bild: Klean Denmark, „Daily sprint meeting", Wikimedia Commons, CC BY-SA 2.0. Genau die Art Meeting, für die diese Pipeline existiert.
Zwei Wege hinein — und sie sind nicht derselbe Weg
Es gibt genau zwei Eingänge, und ihr Unterschied prägt alles Weitere.
Der erste ist die Live-Aufnahme. Der Browser öffnet einen AudioContext mit fest auf 16.000 Hz gesetzter Abtastrate, lädt ein AudioWorklet und puffert das Mikrofonsignal in Blöcken von 4.096 Samples — bei 16 kHz also ein Paket alle 256 Millisekunden. Jeder Block wird von 32-Bit-Float in 16-Bit-Integer-PCM umgewandelt und per WebSocket an /ws/audio/{sessionId} geschickt. Ein zweiter Socket, /ws/session/{id}, trägt den Steuerkanal: Sprachwechsel, Kontext-Updates, den Befehl SUMMARIZE und den Befehl FINISH, der die Sitzung schließt und die Notiz schreibt.
Der zweite ist der Datei-Upload. Sie ziehen eine Aufnahme in das Upload-Fenster, sie wird an POST /upload gestreamt, und die Antwort kommt als zeilengetrenntes JSON zurück — ein Stream, kein Ladekreisel — damit die Oberfläche echten Fortschritt in benannten Schritten zeigen kann statt einer erfundenen Prozentzahl. Die harten Grenzen gehören ehrlich benannt: 500 MB pro Datei, und die Dateiauswahl akzeptiert ausschließlich audio/*. Wenn Ihr Meeting in einer MP4-Bildschirmaufnahme steckt, müssen Sie die Tonspur vorher herauslösen. Das nehmen wir Ihnen heute nicht ab.
Beide Wege münden in dieselbe Verarbeitungsachse. Ab Stufe eins werden Live-Aufnahme und hochgeladene Datei identisch behandelt.
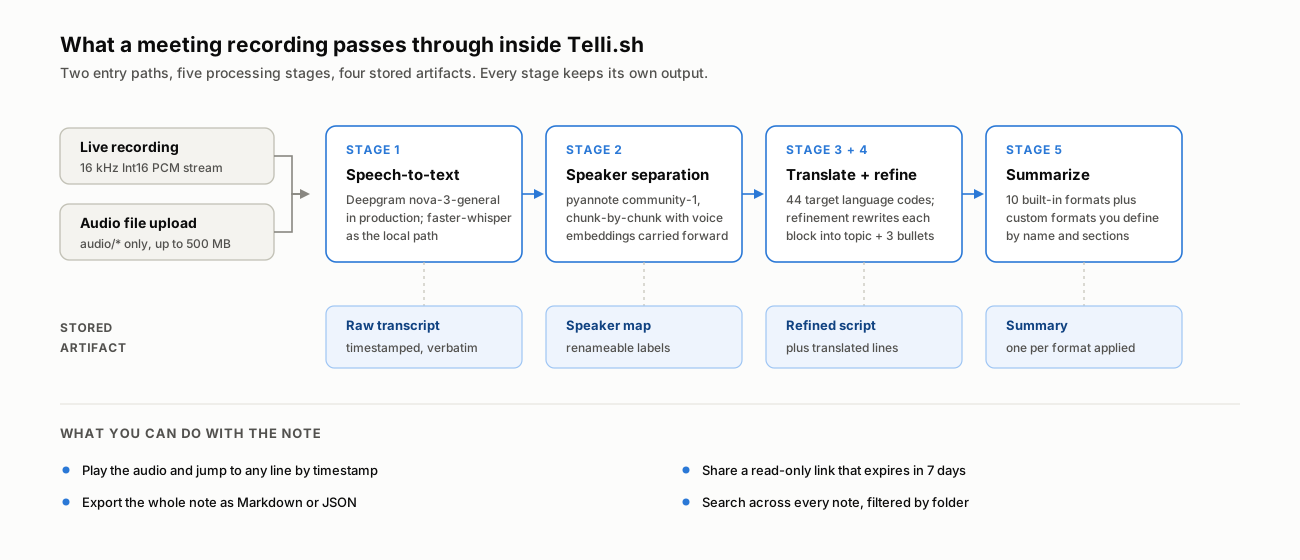
Jede Stufe behält ihre eigene Ausgabe. Nichts wird von der nachfolgenden Stufe überschrieben.
Stufe 1 und 2: die Wörter hören — und dann klären, wem sie gehörten
Zuerst läuft die Spracherkennung. In der Produktion nutzen sowohl der Batch- als auch der Streaming-Pfad Deepgrams Modell nova-3-general; die Codebasis enthält zusätzlich einen vollständig lokalen Pfad auf Basis von faster-whisper für Self-Hosting, umschaltbar über eine einzige Provider-Einstellung. Diese Wahl zählt weniger, als viele erwarten, und der Grund ist ausführlich beschrieben: Die führenden Sprachmodelle liegen in unabhängigen Benchmarks inzwischen innerhalb von rund 1,5 Prozentpunkten Wortfehlerrate beieinander. Die Engine ist nicht mehr der Ort, an dem der Qualitätsunterschied entsteht.
Der Unterschied entsteht bei der Sprechererkennung.
Die Diarisierung läuft auf pyannote/speaker-diarization-community-1. Das Implementierungsdetail, auf das es wirklich ankommt, ist der Umgang mit langen Aufnahmen. Statt die gesamte Datei in einem Durchgang zu diarisieren, verarbeitet die Pipeline das Audio in Blöcken und weist Sprecher unmittelbar nach jedem Block zu — hält dabei aber ein mitwachsendes Wörterbuch aus Stimm-Embeddings pro Sprecher und identifiziert bei jedem weiteren Block gegen diesen akkumulierten Bestand neu. Das ist der Mechanismus, der den klassischen Fehlerfall verhindert, bei dem eine zweistündige Aufnahme dieselbe Person still und leise erst SPEAKER_00, dann SPEAKER_03 und schließlich SPEAKER_07 nennt.
Überlappt ein Segment zwei Sprecherbeiträge, geht das Label an den Beitrag mit der größeren Überlappung; bei geringer Überlappung entscheidet die Ähnlichkeit der Embeddings.
Sie erhalten generische Labels — SPEAKER_00, SPEAKER_01 — weil ein Modell nicht wissen kann, dass SPEAKER_01 Ihre VP Engineering ist. Sie benennen sie einmal in der Notiz um, die Zuordnung wird mit der Notiz gespeichert und danach überall angewendet, auch in Exporten und Freigabelinks. Das ist die ehrliche Arbeitsteilung: Die Maschine trennt die Stimmen, Sie liefern die Namen.
Was jede Stufe tatsächlich hinterlässt
Unsere Designregel lautet: Keine Stufe zerstört die Ausgabe der vorherigen. Sie müssen immer zu den tatsächlich gesprochenen Wörtern zurückkommen können.
| Artefakt | Erzeugt von | Inhalt | Wozu es dient |
|---|---|---|---|
| Roh-Transkript | Stufe 1 + 2 | Zeitgestempelte wörtliche Zeilen mit Sprecherlabel pro Zeile | Prüfen, was wörtlich gesagt wurde; Zeile anklicken, um zum Audio zu springen |
| Sprecherzuordnung | Stufe 2 (+ Ihre Änderungen) | Die Label-zu-Name-Zuordnung dieser Notiz | Macht alle anderen Ansichten lesbar — greift in Notiz, Export und Freigabe |
| Verdichtetes Skript | Stufe 4 | Jeder Block als fette Themenzeile plus bis zu 3 Punkte | Ein langes Meeting überfliegen, statt es zu lesen |
| Übersetzte Zeilen | Stufe 3 | Eine Übersetzung neben jeder Originalzeile | Ein Meeting lesen, das in einer fremden Arbeitssprache lief |
| Zusammenfassung | Stufe 5 | Ein strukturiertes Dokument je angewendetem Format | Das, was Sie tatsächlich verschicken |
In der Notizansicht erscheinen sie als drei Arten von Tabs — Verlauf (Roh-Transkript), Skript (verdichtete Fassung) und je ein Tab pro erzeugtem Zusammenfassungsformat. Wenn das Audio der Aufnahme gespeichert wurde, sitzt darüber ein Player; ein Klick auf eine Transkriptzeile spult das Audio zu diesem Zeitstempel.
Stufe 3: Bei der Übersetzung ist 44 die relevante Zahl
Echtzeit-Meetingübersetzung hat die meisten unserer frühen Nutzerinnen und Nutzer hergebracht, und es lohnt sich, den Umfang präzise zu benennen — „unterstützt über 100 Sprachen" ist die am schlechtesten überprüfbare Behauptung dieser Kategorie.
Zwei verschiedene Zahlen sind im Spiel, und sie sind nicht dieselbe:
- 44 Zielsprachcodes werden für die Übersetzung akzeptiert. Diese Menge ist in der Backend-Konfiguration explizit aufgezählt und enthält
zh-TWgetrennt vonzh— was mehr ausmacht, als es klingt, wenn Sie über Taiwan und das Festland hinweg arbeiten. - 15 Sprachen stehen für die Oberfläche selbst und für die Sprache zur Verfügung, in der die KI Ihre Zusammenfassung schreibt: Englisch, Koreanisch, Japanisch, Chinesisch, Deutsch, Französisch, Spanisch, Italienisch, Portugiesisch, Russisch, Polnisch, Vietnamesisch, Thailändisch, Indonesisch und Malaiisch.
In einer Live-Sitzung wird inkrementell übersetzt, nicht am Ende gesammelt. Sobald Satzzeichengrenzen im Transkript eintreffen, läuft die Übersetzung dieses Segments neben dem Original ein, und ein Cache pro Sitzung verhindert, dass unveränderter Text erneut übersetzt wird. Beim Datei-Upload werden Zeilen stattdessen gebündelt — wenn niemand auf einen Bildschirm schaut, zählt Durchsatz mehr als Latenz.
Zusätzlich gibt es einen Übersetzungs-Workflow-Modus, getrennt vom Notizmodus, für den Fall, dass die Übersetzung selbst das Ergebnis ist: ein zweisprachiges Gespräch, dem Sie live folgen müssen, statt eines Meetings, aus dem ein Protokoll werden soll.
Stufe 4: die Stufe, die niemand verlangt und jeder braucht
Hier wechselt der Text von Beschreibung zu Meinung, und diese Meinung schwächen wir nicht ab: Die Verdichtung ist die am meisten unterschätzte Stufe dieser Pipeline.
Ein wörtliches Transkript menschlicher Rede ist nahezu unlesbar. Menschen setzen Sätze neu an, brechen ab, sagen viermal „ja, ja, genau" und begraben eine Entscheidung in neunzig Sekunden Räuspern. Eine wortgenaue Transkription davon sind immer noch neunzig Sekunden Räuspern.
Die Verdichtungsstufe nimmt daher jeden Gesprächsblock und schreibt ihn unter engen Vorgaben neu — definiert in einer Prompt-Vorlage statt im Code, damit wir ohne Deployment nachjustieren können. Jeder Block wird zu einer fetten Themenzeile, die aus dem Inhalt abgeleitet ist — nicht aus einem Rollennamen, nicht in eckigen Klammern — gefolgt von höchstens drei Stichpunkten, mit rund 300 Zeichen pro Block als Ziel. Sprechernamen und Zeitstempel werden ausdrücklich entfernt: Sie stehen bereits im Roh-Transkript, und ihre Wiederholung macht die Überflieg-Ansicht nur schlechter überfliegbar.
Eine Vorgabe in dieser Vorlage verdient es, benannt zu werden: Das Modell wird angewiesen, das Register des Gehörten zu treffen — und ausdrücklich nicht, einem lockeren Gespräch einen Vorstandston überzustülpen. Ein als Aufsichtsratsprotokoll zusammengefasstes Flurgespräch ist ein schlechteres Artefakt als gar keine Zusammenfassung.
Wir nennen das Ergebnis das Skript — die Fassung, die Sie auf einen Blick lesen können, einen Tab entfernt von der Fassung, die Sie im Streitfall zitieren können.
Stufe 5: Zehn Formate, weil „Zusammenfassung" keine einzelne Sache ist
Die letzte Stufe erzeugt das Dokument, das Sie tatsächlich verschicken. Wer ein LLM um „eine Zusammenfassung" bittet, bekommt eine Zusammenfassung von nichts Bestimmtem — deshalb ist das Format hier eine erstklassige Entscheidung und kein verstecktes Standardverhalten.
Zehn Formate sind eingebaut: KI-Zusammenfassung (allgemein), Besprechungsnotizen, Management-Report, Vorlesungsnotizen, Predigt / Vortrag, Beratungsprotokoll, Gesprächsnotiz, Interview, Ideennotizen und Präsentationsentwurf. Jedes bringt seine eigene Abschnittsstruktur mit: Besprechungsnotizen erzeugen Überblick, Diskussionspunkte, Entscheidungen und nächste Schritte; der Präsentationsentwurf erzeugt Gliederung, Folienabfolge, Kernbotschaften, Sprechernotizen und nächste Aktionen. Die Abschnittsüberschriften selbst sind pro Sprache lokalisiert und werden nicht erst bei der Generierung übersetzt — deshalb liest sich eine japanische Zusammenfassung wie ein japanisches Dokument und nicht wie ein übersetztes englisches.
Passt keines der zehn, definieren Sie ein eigenes Format: ein Name, eine Anweisung, die gewünschte Abschnittsliste — gespeichert und wiederverwendbar. „Wöchentliches Board-Update mit Risiken und offenen Entscheidungen" ist ein Format, das man einmal schreibt.
Jedes Format lässt sich nachträglich auf eine Notiz anwenden und erzeugt seinen eigenen Tab. Dieselbe Aufnahme dreimal für drei Zielgruppen zusammenzufassen, ist hier normaler Gebrauch und kein Workaround.
Transkriptionsgenauigkeit ist ein Stapel, keine Zahl
Wenn Sie Werkzeuge dieser Kategorie vergleichen, ist dies der Abschnitt zum Widersprechen.
Die Branche veröffentlicht eine Zahl — die Wortfehlerrate — und diese Zahl taugt nicht mehr zur Produktauswahl, weil alle dicht am Boden liegen. Wir haben dieses Argument in STT-Genauigkeit reicht nicht im Detail auseinandergenommen, samt des Falls, in dem ein einziges gestrichenes „nicht" eine Entscheidung umdreht und dabei 0,016% des Genauigkeitsbudgets kostet.
Praktisch gesprochen: Transkriptionsgenauigkeit, die den Kontakt mit einem echten Meeting übersteht, besteht aus fünf Schichten, und das akustische Modell ist nur die unterste davon.
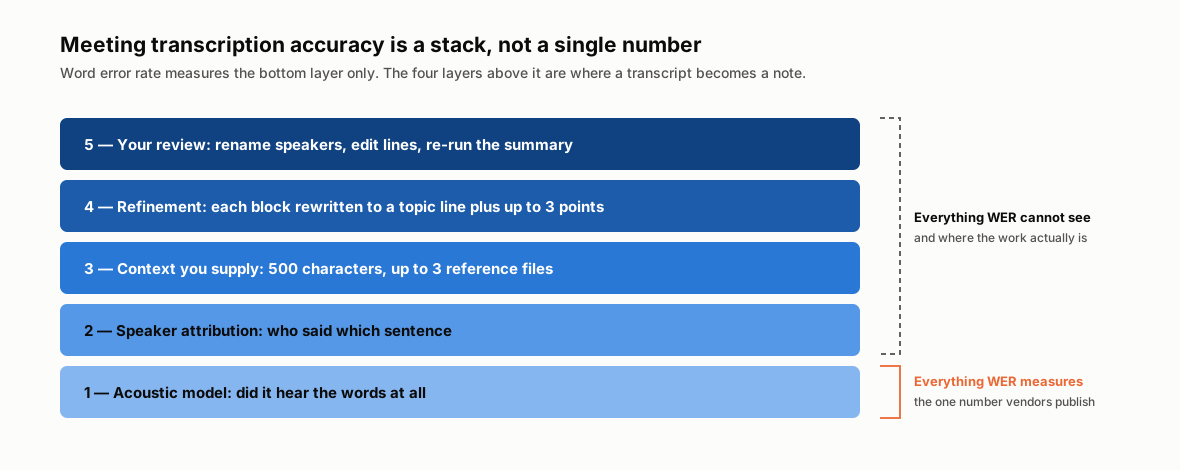
Die Wortfehlerrate misst Ebene 1. Die Ebenen 2 bis 5 entscheiden, ob das Transkript brauchbar ist.
Ebene 3 ist die, die Nutzende direkt steuern können und die die meisten überspringen. Vor Aufnahme oder Upload können Sie einen Kontextblock von bis zu 500 Zeichen hinterlegen — Thema, Namen der Teilnehmenden, Produktcodes, Abkürzungen — und bis zu 3 Referenzdateien anhängen (PDF, Bild oder Text), deren Text im Browser extrahiert und in dasselbe Kontextbudget eingefaltet wird. Dieser Kontext wird an die KI-Stufen übergeben.
Das ist kein Bonus. Eigennamen sind in jedem Meeting gleichzeitig die informationsreichsten und die seltensten Wörter: interne Projektnamen, ungewöhnliche Nachnamen, Produkt-SKUs. Dem System vorab zu sagen, dass „Kestrel" ein Produkt und „Ravi" eine Person ist, kostet fünfzehn Sekunden und beseitigt die Fehler, die Sie sonst zehn Minuten lang von Hand korrigieren. Wenn Sie nach diesem Beitrag genau eine Sache ändern: Füllen Sie das Kontextfeld aus.
Von null zur geteilten Notiz in elf Schritten
Konkret, vom ersten Durchlauf bis zum teilbaren Artefakt:
- Registrieren. Der kostenlose Tarif umfasst 60 Minuten pro Monat, ohne Kreditkarte, und lässt dieselbe Pipeline laufen wie die bezahlten Tarife — ein Kontingent-, kein Funktionsunterschied.
- Weg wählen: Live-Aufnahme starten oder das Upload-Fenster öffnen und eine Audiodatei ablegen (
audio/*, unter 500 MB). - Sprachpaar setzen. Die Quelle kann auf automatischer Erkennung bleiben; die Zielsprache bestimmt, worin Übersetzung und Zusammenfassung erscheinen.
- Kontextfeld ausfüllen — Thema, Namen, Abkürzungen, bis zu 500 Zeichen. Bis zu 3 Referenzdateien anhängen, falls Sie Deck oder Agenda haben.
- Einen Ordner wählen, falls die Notiz irgendwo Bestimmtes liegen soll. Verschieben geht später auch.
- Aufnehmen oder den Upload-Stream abwarten. In einer Live-Sitzung erscheint das Transkript, während gesprochen wird, mit einlaufender Übersetzung daneben, sofern eine Zielsprache gesetzt ist. Beim Upload sehen Sie benannte Schritte: Spracherkennung, Analyse, Verdichtung, Zusammenfassung, Abschluss.
- Sitzung beenden. Das löst die Steuernachricht
FINISHaus, die das letzte Segment leert, laufende Verdichtung abwartet, das Audio speichert, die Zusammenfassung erzeugt und die Notiz schreibt. - Sprecher umbenennen. Aus SPEAKER_00 wird einmal ein Name, und die Zuordnung greift in jeder Ansicht und jedem Export.
- Im Tab Skript lesen, worum es ging; wenn etwas falsch aussieht, in Verlauf wechseln und die Zeile anklicken, um das Audio an genau dieser Stelle zu hören.
- Weitere Zusammenfassungsformate erzeugen, wenn eine Zielgruppe Besprechungsnotizen braucht und eine andere einen Management-Report.
- Teilen oder exportieren. Ein Freigabelink ist schreibgeschützt, läuft nach 7 Tagen ab und kann ein optionales Passwort tragen. Der Export liefert Markdown oder JSON mit Zusammenfassung, verdichteten Blöcken und vollständigem Transkript in einer Datei.
Eine vorhandene Aufnahme hochladen
Was es kostet, in exakten Zahlen
Das Kontingent wird in verarbeiteten Audiominuten gezählt, und nur das trennt die Stufen.
| Tarif | Minuten pro Monat | Monatlich | Jährlich | Effektiv je 100 Minuten |
|---|---|---|---|---|
| Free | 60 | USD 0 | — | — |
| Plus | 300 | USD 5,00 | USD 51,00 | USD 1,67 |
| Pro | 500 | USD 8,00 | USD 81,60 | USD 1,60 |
| Pro+ | 1.000 | USD 10,00 | USD 102,00 | USD 1,00 |
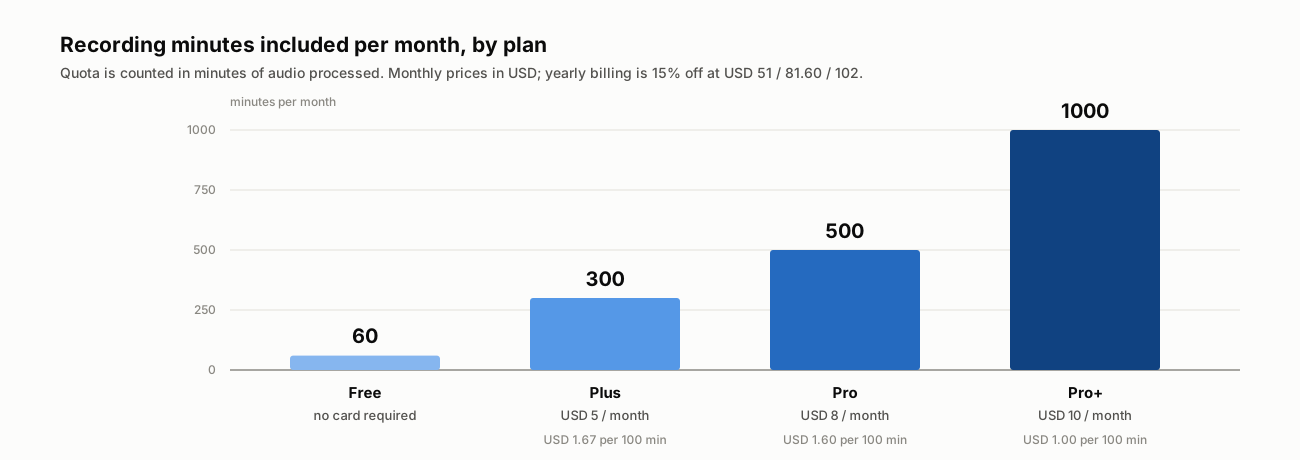
Jahresabrechnung ist monatlich × 12 × 0,85. Der Minutenpreis wird mit der Stufe besser; die Pipeline bleibt dieselbe.
Sechzig kostenlose Minuten sind ein langes Meeting oder drei Stand-ups. Das genügt, um die einzig relevante Frage zu beantworten: Entsteht daraus eine Notiz, die Sie tatsächlich verschicken würden? Mit Ihrem eigenen Audio, nicht mit einer Anbieter-Demo.
Das nächste Meeting live aufnehmen
Was Telli.sh nicht tut
Ein Produktbeitrag, der nur Fähigkeiten aufzählt, ist Werbung. Hier die andere Spalte.
Es nimmt keine Videodateien. Der Uploader akzeptiert audio/*. Tonspur vorher extrahieren.
Es tritt Ihren Calls nicht bei. Es gibt keinen Bot, der sich in Zoom, Meet oder Teams einwählt und in der Teilnehmerliste sitzt. Sie nehmen den Raum auf, oder das Audio Ihres Rechners, oder Sie laden die Datei danach hoch.
Es repariert kein schlechtes Audio. Das ist die ehrliche Grenze der ganzen Kategorie. Ein omnidirektionales Laptop-Mikrofon am Kopfende eines Tisches mit zwölf Personen, in einem Raum mit harten Wänden, liefert schlechtere Diarisierung — egal, wessen Modell läuft. Überlappende Rede und weit entfernte Sprechende sind die Stelle, an der Sprecherzuordnung zuerst bricht. Ein Telefon in der Tischmitte schlägt jedes Mal den Laptop am Ende des Tisches und kostet nichts.
Es kennt Ihr Vokabular nicht, wenn Sie es nicht mitteilen. Siehe Ebene 3 oben. Ungewöhnliche Eigennamen sind die häufigste Fehlerquelle, und das Kontextfeld ist die Abhilfe.
Sprecherlabels beginnen generisch. Kein System errät, dass SPEAKER_01 Priya ist. Einmal pro Notiz umbenennen.
Freigabelinks sind befristet. Sieben Tage, dann ist der Link tot. Das ist ein bewusster Standard für Meeting-Inhalte und keine vergessene Funktion — heißt aber auch: Ein Freigabelink ist kein Archiv. Für Dauerhaftigkeit das Markdown exportieren.
Fazit
Unser früher Fehler war, dies für ein Transkriptionsprodukt zu halten. Ist es nicht. Transkription ist Stufe eins von fünf und die Stufe, die einer Lösung am nächsten ist.
Was wir tatsächlich bauen, ist die Distanz zwischen einer Aufnahme und einer Entscheidung: zu wissen, wer gesprochen hat; die neunzig Sekunden Räuspern auf den einen Satz darin einzudampfen; diesen Satz in der Sprache wiederzugeben, in der die lesende Person arbeitet; und ihn dorthin zu legen, wo eine Kollegin ihn öffnen kann. Die Aufnahme ist ein Beleg. Die Notiz ist das, was nächste Woche verändert.
Wenn gerade eine Meeting-Aufnahme auf Ihrem Rechner liegt, ist das der einzige Benchmark, der zählt. Bei uns dauerte die Einrichtung sechzig Sekunden und ergab eine Notiz, die wir an vier Personen geschickt haben.
Eine übersetzte Live-Sitzung starten
Quellen
- STT-Genauigkeit reicht nicht — Telli.sh Blog, 4. August 2026 — das vollständige Argument zur Wortfehlerrate samt Leaderboard-Spanne
- pyannote/speaker-diarization-community-1 — Hugging Face — das in dieser Pipeline genutzte Diarisierungsmodell
- Deepgram Nova-3 Modelldokumentation — das in der Produktion genutzte Spracherkennungsmodell
- Telli.sh Preise — die oben zitierten Kontingente und Preise
- Wikimedia-Commons-Bildseite — Titelbild, Klean Denmark, CC BY-SA 2.0
