Google 会实时翻译你的越南语会议,却一个字都不会替你记下来
Google Meet 的翻译字幕覆盖 69 种语言,越南语在列;Google 翻译的 Live translate 覆盖 74 种。而 Meet 的 Transcripts 功能与它的 Gemini 记录助手各自只支持 8 种语言,越南语一个都没进。DeepL Voice 要转写越南语口语,只能走一条必须由管理员启用、且无法使用自动检测的第三方通道。本文盘点 2026 年的实时语音翻译究竟给了越南团队什么——以及它始终不给的是什么。
用越南语在 Google 上搜索「实时语音翻译」,你会得到一个相当不错的答案。Google 翻译的 Live translate 功能支持 74 种语言,越南语就在其中,Android 和 iOS 都能用。戴不戴耳机都能工作,锁屏之后照样运行,还提供一种面对面模式:把手机屏幕一分为二,让每位说话者各读自己那一半。
它确实好用。但有意思的地方不在这里。
有意思的是四个小时之后,在同一个平台上发生的事——当你想知道刚才到底谈定了什么的时候。Google Meet 的 Transcripts 功能,也就是能生成一份可长期保存的 Google 文档的那个功能,只支持八种语言,越南语不在其中。Meet 的「Take notes for me」支持的八种语言里同样没有它;这项功能自己的帮助页面还补了一句:它「一次只支持一种语言」,并且「目前不支持同一场会议中出现多种语言」。
TL;DR
- 凡是 Google 用来听的功能,越南语都在支持列表里:Live translate(74 种语言)、Meet 翻译字幕(69 种语言)。凡是 Google 用来写的功能,越南语都不在:Meet Transcripts 和 Meet 的 Gemini 记录助手,各支持 8 种语言。
- DeepL Voice 能把字幕显示成越南语,却无法用自己的模型转写越南语口语——越南语被放在一个第三方语言层里,必须由管理员启用,而且不能使用自动检测。
- 下方的比较展示了截至 2026 年 8 月 31 日各主要平台对越南语的支持情况,随后列出六个步骤,帮助越南语—英语会议留下记录。
同样的缺口也影响其他语言,详见我们对谈话结束后便消失的翻译所作的概述。对越南团队来说,问题更突出:那些为保留记录而设计的会议功能并不支持越南语。
今天的「实时语音翻译」在越南语上究竟能给你什么
先把账算清楚,因为 Google 的免费工具在它们被设计出来要做的那件事上,做得非常好。
根据 2026 年 8 月 31 日检索的 Android 帮助页面,Google 翻译的 Live translate 提供四种模式:Listening(把手机贴近耳朵,或戴上耳机,实时翻译对方的话)、Conversation(译文外放,双方轮流说)、Text only(只读文字,无音频)以及自定义设置。另有一个独立的 Face to face 模式:屏幕一分为二,每位说话者在自己那半边同时看到自己语言的转写和译文。麦克风会自动判断一种语言何时结束、另一种何时开始,因此没有人需要在句子之间去点按钮。
有两个细节值得比通常更多的肯定。第一,会话能在多任务切换中存活:Google 的文档写明,翻译会「在你切换应用、最小化程序或屏幕锁定时无缝继续」。第二,越南语可以下载离线包,而且已下载的语言包能在同一个界面里升级为更高质量的版本——在一个出差走访或工厂车间都不保证有稳定网络的国家,这一点很重要。
有一条限制值得直说,因为它常常出乎人们意料:这是一个手机功能。Google 自己关于网页版的帮助页面用一句话讲得很干脆:「在网页版 Google 翻译上,你无法一边说话一边翻译。」如果你的双语会议发生在笔记本电脑上,Live translate 根本不在场。
在出租车上、拜访供应商或走廊里与来访客户交谈时,Live translate 是一个能力不错的免费选择。当会议结束后还需要一份持久、可搜索的记录时,缺口就显现出来了。
Google 的实时翻译支持正在扩展,超越本文所述的手机和字幕功能
Google 的实时翻译支持正在扩展,超越本文撰写时已有的手机和字幕功能。
2026 年 6 月 9 日,Google 发布了 Gemini 3.5 Live Translate,一个覆盖 70 多种语言的语音到语音翻译模型。据 Slator 在 2026 年 6 月 16 日的报道,它正通过 Gemini Live API 与 Google AI Studio 以公开预览形式推出,在 Google Meet 中面向部分 Workspace 客户进入私有预览,并已随 Google 翻译移动端在 Android 和 iOS 上全球发布。
对 Meet 而言,真正重要的数字是前后对比。Meet 的语音翻译此前一直被限制在五种受支持的语言,而且只能在英语与其他语言之间互译。Gemini 3.5 Live Translate 把它扩展到70 多种语言、2,000 多个语言对组合,更大范围的可用性计划在 2026 年晚些时候落地。对一个越南团队来说,一个五种语言、以英语为枢纽的系统基本等于没有系统;2,000 个语言对则是另一种产品。
Google 给这个模型的定位很克制,这是好迹象而不是坏迹象。据 Slator 报道,文档把 Live Translate 与 Gemini 更宽泛的 Live Agent 能力作了对比:它的角色是一条实时翻译流水线,只接受音频输入,并有意舍弃了函数调用、搜索接地、工具与系统指令。它是一名口译员,而不是一个助理——这与 OpenAI 描述 GPT-Realtime-Translate 时划下的界线完全相同。Google 还在 Android 上加入了一种「聆听模式」,把译好的音频通过听筒播放,这样你在会议中就能听翻译,而不必显眼地戴着耳机。
所以,越南语的实时层正在从多个方向同时快速改善。现在轮到另一个问题了。
记录分界线:越南语止步之处
每个平台都有一条线。线的一边,是帮你在当下听懂话的功能;线的另一边,是把话变成你下周还拿得出来的东西的功能。我们把它叫作记录分界线——而对越南语来说,支持恰好就在这条线上消失。
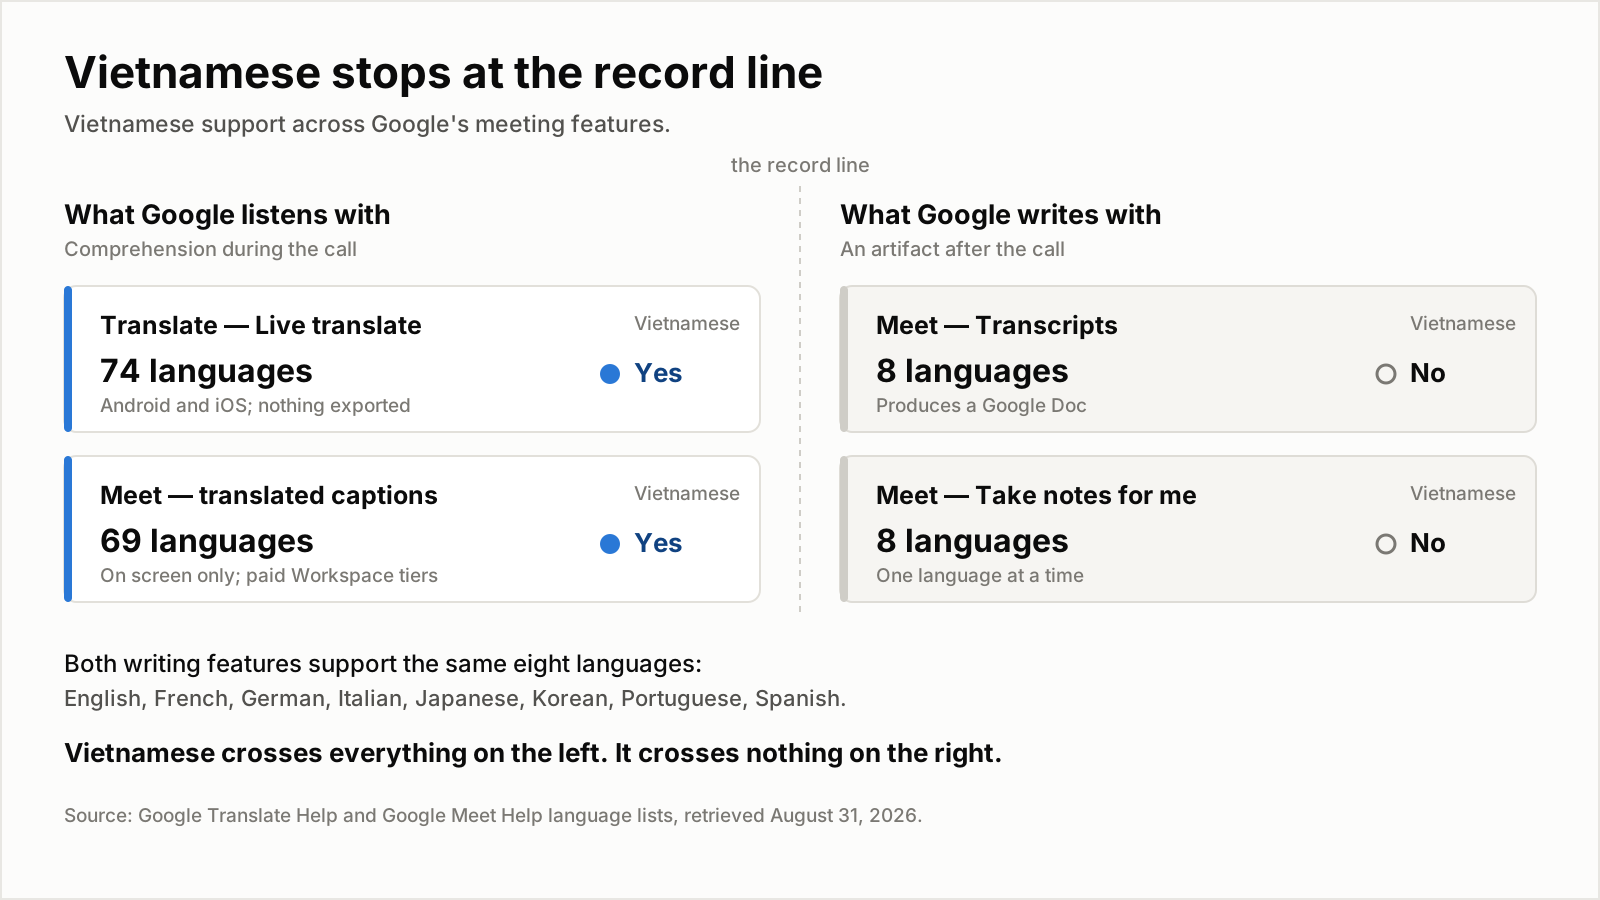
语言数量均出自 Google 自己的四个帮助页面,检索日期为 2026 年 8 月 31 日。越南语出现在两项「听」的功能中,而两项「写」的功能一个都没有。
按功能逐项比较,就能看清这条边界:
| Google 功能 | 是否支持越南语? | 语言数 | 通话结束后是否留下产物? |
|---|---|---|---|
| Google 翻译 — Live translate | 支持 | 74 | 否 |
| Google Meet — 翻译字幕 | 支持 | 69 | 仅显示在屏幕上;若开启 Record captions,会烧录进录制文件 |
| Google Meet — Transcripts | 不支持 | 8 | 是,一份 Google 文档 |
| Google Meet — 「Take notes for me」 | 不支持 | 8,且一次只能一种 | 是,Google 文档笔记外加一封邮件摘要 |
| Google Meet — Gemini 3.5 Live Translate | 正在推出 | 目前 5,私有预览中 70+ | 未说明 |
所有行的依据均为 Google 帮助页面与 Slator 2026 年 6 月 16 日的报道,检索日期为 2026 年 8 月 31 日。
Transcripts 与「Take notes for me」共享的那八种语言完全一致:英语、法语、德语、意大利语、日语、韩语、葡萄牙语、西班牙语。同一份名单出现了两次,而这是一份由欧洲和东亚大市场组成的名单。越南语——按三星 2024 年那篇工作总结里自己给出的数字,约有 9,700 万使用者——被挡在名单之外,和泰语、印尼语、印地语、阿拉伯语一起。
还有一条限制专门打在双语团队身上,而且即便团队全程使用受支持的语言也一样适用。Google 关于「Take notes for me」的帮助页面写明,该功能一次只支持一种语言,且目前不支持同一场会议中出现多种语言。一通在越南语和英语之间来回切换的越美会议,等于被判了两次出局:一次因为越南语,一次因为切换。
Meet 翻译字幕有一种有限的留存方式:选择 Record captions 后,字幕会嵌入录制片段中;会话期间也可以回看字幕。但嵌入视频的字幕不是可搜索、可编辑的转录文本,也不能为生成摘要提供文本。Meet 翻译字幕仅限付费 Workspace 版本:Business Standard、Business Plus、Enterprise Standard、Enterprise Plus、Enterprise Starter(可用至 2025 年 6 月 30 日),以及 Google AI Pro for Education。
DeepL 会把越南语字幕显示给你。转写越南语口语,则是另一个层级的事
DeepL Voice 提供另一种途径,但其文档把语音识别所用语言与字幕显示语言区分开来。
DeepL 把语言支持拆成两份名单。口语语言(Spoken languages)是识别器能听懂的语言,翻译语言(Translation languages)是字幕可以显示成的语言。越南语出现在翻译语言名单里,这份名单共 41 种语言。现在看另一边:DeepL 自家的模型转写 18 种口语语言——中文(普通话)、捷克语、荷兰语、英语、法语、德语、印尼语、意大利语、日语、韩语、波兰语、葡萄牙语、罗马尼亚语、俄语、西班牙语、瑞典语、土耳其语、乌克兰语。越南语不在其中。
越南语确实可以作为口语语言使用,但只存在于第二层:由第三方供应商 Speechmatics 转写的 20 种语言。随之而来的有三项条件,全部记载于 2026 年 8 月 31 日检索的 DeepL 帮助页面:
- 团队管理员必须在组织管理账户中启用第三方处理,否则这些语言完全无法工作。
- 自动检测不起作用。DeepL 的原话是:「第三方语言无法与 Auto-detect language 配合使用——必须手动选为 Spoken language。」
- 若要让与会者自行选择口语语言,主持人在把会议接入 DeepL Voice 时必须启用访问码。
这些要求本身都不算不合理——DeepL 指出 Speechmatics 是在零留存协议下运作的,转写数据在处理完成后即从其服务器删除。但把这些条件叠加起来,实际结果是:一位越南语使用者加入一场配备了 DeepL 的会议,距离「完全没被转写」只差一个没打勾的管理员设置,并且不能指望系统自动注意到他。与此同时,其留存策略与我们今天上午写过的那一套如出一辙——DeepL 的常见问题页面写道,会议数据「在内存中临时处理,通话结束后即删除」。
三星是那个值得点名的反例。越南语是 Galaxy AI 首批 16 种语言之一,而三星越南研发院在 2024 年 5 月 23 日发表了一篇罕见坦率的文章,讲述这件事为什么难。越南语有六个不同的声调;文中的例子是 ma、mả、má——鬼、坟、母亲——三者只在声调上不同。该院 ASR 负责人 Bui Ngoc Tung 描述过一个模型如何区分「约 20 毫秒」的音频帧,以判断一串帧到底属于哪个词。当一家韩国手机厂商愿意为越南语声调建模投入资源,而一家欧洲翻译公司把它外包给分包商时,这已经告诉了你市场如何给这门语言定价。
在语音识别方面,Deepgram 的 Nova-3 文档将越南语列为 vi(检索于 2026 年 8 月 31 日)。这属于我们在分析语音转文字覆盖范围中「支持」二字掩盖了什么一文讨论的 58 种语言之一。
没有任何厂商公布越南语会议语音的错误率,而语料库解释了原因
已发表的语音识别分数尚不能说明越南语转写在自然会议对话中的表现;现有语料库有助于解释这道缺口。
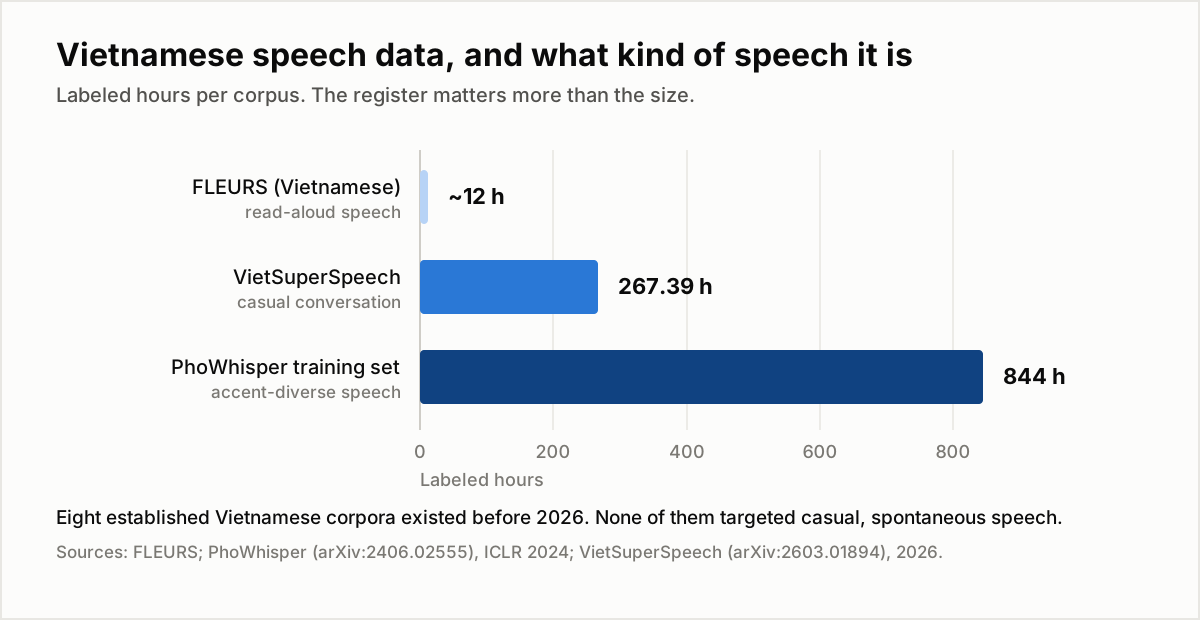
标注时长并不是故事的全部,语体才是。FLEURS 是朗读语音;PhoWhisper 的训练集覆盖多种口音;VietSuperSpeech 是第一个专为随意对话而构建的语料库。来源见下方列表。
常被引用的越南语基准 FLEURS 提供约 12 小时的朗读语音。发表于 ICLR 2024 Tiny Papers 分会的 PhoWhisper 使用一个按口音多样性挑选的 844 小时数据集微调 Whisper。2025 年 5 月 23 日发布的 VietASR 使用 70,000 小时无标注音频预训练、50 小时标注音频微调,并报告称其在真实场景数据上优于 Whisper Large-v3 和商用系统。
2026 年发布的 VietSuperSpeech 收录了 52,023 组随意口语越南语音频—文本对,共 267.39 小时:240.67 小时训练数据和 26.72 小时评测数据,包含 1,380 万个带完整变音符号的字符。作者这样描述该数据集要解决的缺口:
「尽管 VLSP2020、VIET_BUD500、VietSpeech、FLEURS、VietMed、Sub-GigaSpeech2-Vi、viVoice 和 Sub-PhoAudioBook 等语料库对正式语体和朗读语音提供了广泛覆盖,却没有任何一个专门针对对话式 AI 应用不可或缺的随意、自发语体。」
该数据集针对的是会议中常见的表达方式:打断、含糊其辞、在越南语句子中插入英文产品名,以及话说一半便停下。仅凭朗读语音上的分数,无法证明系统能多准确地处理这类对话。
对团队来说,实际的保障是一份可供人检查和修正的转录文本。首先,所选的会议功能必须能够生成越南语转录。
如何开一场让记录活下来的越南语—英语会议
在通话前和通话期间,请检查以下六点:
- 需要时,为即时理解和留存记录分别选择工具。 Google 翻译或 Meet 字幕可以帮助即时理解越南语;但这两项功能都无法生成本文所说的、可长期保留的越南语转录文本。
- 把越南语显式设为口语语言,不要依赖自动检测。在 DeepL 上这是强制要求——包括越南语在内的第三方语言无法被自动检测。在其他地方它同样是更好的选择,因为自动检测会在最初几秒就锁定一个猜测,而那几秒恰恰是整场会话中上下文最少的音频。
- 去看记录功能的语言列表,而不是平台的语言列表。本文要描述的陷阱,就是想当然地认为一个能翻译越南语的平台也能转写越南语。在 Google Meet 里,69 对 8 就是这两个假设之间的鸿沟。
- 在通话开始前先把语码转换的问题挑明。如果你的团队会把英语产品名、工单号和缩写塞进越南语句子里——每一支离岸工程团队都会——那就先确认你的记录工具能容忍一场会话中出现两种语言。Meet 的记录助手明确不行。
- 在最初五分钟里,当场修正专有名词。越南语的变音符号和英语产品代号,是转写最稳定翻车的两个地方,也是一行写错就会对建立在其上的任何摘要造成最大伤害的两个地方。会议进行中修正只需要几秒。
- 把越南语原文、英语译文和摘要放进同一份记录里。而不是三个工具里的三个文件。翻译是单向的:明年你可以用更好的模型从越南语重新翻译一遍,但你永远无法从英语里把越南语还原回来。
如需按步骤了解产品操作,请参阅我们六月的指南:把双语会议录音变成可复核的 AI 笔记。
结论:越南语已经跨过了理解的鸿沟,还没跨过记录的鸿沟
越南语支持已扩展到实时字幕、口译音频和语音识别等功能,让团队有更多方式跟上对话。但已公布的语言覆盖范围不等于你的账号现在就能使用。Meet 的 Gemini 3.5 Live Translate 扩展仍处于预览和逐步推出阶段,并非普遍适用的语言对替代方案。请在会前确认所需功能、账号权限以及越南语的输入输出方向。
没有动的是记录。那两个能产出长期留存产物的 Google 功能,加起来支持八种语言,而且是同样的八种,越南语一个都没进。DeepL 会把字幕译成越南语,却把它的转写外包给一家分包商,还藏在一个管理员开关后面。市场已经作出判断:越南语是一门值得被听见的语言,还不是一门值得被写下来的语言。
所以,该向厂商提的问题不是他们是否支持越南语。现在他们几乎都会说支持,而且几乎都只是指「听」的那一半。该问的是:通话结束之后,你们的哪些功能仍然支持越南语——你能把那个具体功能的语言列表给我看吗?
Telli.sh 的位置:记录层正是我们在造的那一层。Telli.sh 用会议实际被说出的语言来转写,翻译成包括越南语在内的 44 种目标语言,并把三种产物保存在同一份笔记里——越南语原文、与之对齐的译文,以及在此之上生成的摘要。界面本身提供 15 种语言,越南语在列,因此岘港的团队和悉尼的客户可以各用自己的语言读同一场会议,同时共享同一份可修正的记录。
参考来源
- Google 翻译帮助中心,"Hear live speech to speech translations with Live translate"(Android),检索于 2026 年 8 月 31 日——包含越南语在内的 74 种语言列表、四种翻译模式、面对面模式,以及后台持续运行。
- Google 翻译帮助中心,"Download languages to use offline"(Android),检索于 2026 年 8 月 31 日——离线语言包与更高质量版本的升级。
- Google Meet 帮助中心,"Use translated captions in Google Meet",检索于 2026 年 8 月 31 日——包含越南语在内的 69 种语言列表、付费 Workspace 版本,以及 Record captions。
- Google Meet 帮助中心,"Use Transcripts with Google Meet",检索于 2026 年 8 月 31 日——受支持的八种转写语言。
- Google Meet 帮助中心,"'Take notes for me' in Google Meet",检索于 2026 年 8 月 31 日——同样的八种语言,以及一次只支持一种语言的限制。
- Slator,"Google Expands AI Live Speech Translation with Gemini 3.5 Live Translate",2026 年 6 月 16 日——6 月 9 日的发布、70+ 种语言、Meet 从五种语言扩展到 2,000+ 个语言对,以及聆听模式。
- DeepL 帮助中心,"DeepL Voice languages",检索于 2026 年 8 月 31 日——由 DeepL 转写的 18 种口语语言、包含越南语在内的 20 种第三方口语语言、41 种翻译语言、自动检测限制,以及 Speechmatics 的零留存协议。
- 三星新闻室,"The Learning Curve, Part 3: Taking AI Data From Good to Great",2024 年 5 月 23 日——越南语位列 Galaxy AI 首批 16 种语言、六个声调、ma/mả/má 例子,以及约 20 ms 音频帧的描述。
- Deepgram,Models & Languages Overview,检索于 2026 年 8 月 31 日——Nova-3 语言列表中的越南语(
vi)。 - Le、Nguyen 与 Nguyen,"PhoWhisper: Automatic Speech Recognition for Vietnamese",ICLR 2024 Tiny Papers——844 小时、口音多样的微调数据集。
- "VietASR: Achieving Industry-level Vietnamese ASR with 50-hour labeled data and Large-Scale Speech Pretraining",2025 年 5 月 23 日——70,000 小时无标注数据,50 小时标注数据。
- "VietSuperSpeech: A Large-Scale Vietnamese Conversational Speech Dataset",2026 年——52,023 组配对、267.39 小时,以及八个语料库共同存在的语体缺口。