O Google vai traduzir sua reunião em vietnamita em tempo real. E não vai registrar uma única palavra.
As legendas traduzidas do Google Meet cobrem 69 idiomas, incluindo o vietnamita, e o Live translate do Google Tradutor cobre 74. O recurso Transcripts do Meet e seu anotador do Gemini suportam exatamente 8 idiomas cada, e o vietnamita não está em nenhum dos dois. O DeepL Voice só consegue transcrever vietnamita falado por meio de um provedor terceirizado que precisa ser habilitado por um administrador e não funciona com detecção automática. Uma análise do que a tradução de voz ao vivo realmente entrega às equipes vietnamitas em 2026 — e do que ela nunca entrega.
Pesquise por tradução de voz ao vivo em vietnamita no Google e você chega a uma resposta genuinamente boa. O recurso Live translate do Google Tradutor suporta 74 idiomas, o vietnamita entre eles, tanto no Android quanto no iOS. Funciona com ou sem fones de ouvido, continua ativo quando a tela é bloqueada e oferece um modo cara a cara que divide o celular ao meio para que cada pessoa leia o seu próprio lado.
Funciona. E não é essa a parte interessante.
A parte interessante é o que acontece na mesma plataforma quatro horas depois, quando você quer saber o que de fato ficou acordado. O recurso Transcripts do Google Meet — aquele que gera um Google Doc duradouro — suporta exatamente oito idiomas, e o vietnamita não é um deles. Nem está entre os oito suportados pelo «Take notes for me» do Meet, cuja própria página de ajuda acrescenta que o recurso «suporta um idioma por vez» e que «vários idiomas falados na mesma reunião não são suportados atualmente».
Resumo
- O vietnamita é suportado por todas as superfícies do Google que escutam: Live translate (74 idiomas), legendas traduzidas do Meet (69 idiomas). E não é suportado por nenhuma das superfícies do Google que escrevem: Transcripts do Meet e o anotador do Gemini no Meet, 8 idiomas cada.
- O DeepL Voice consegue exibir legendas em vietnamita, mas não consegue transcrever vietnamita falado com seus próprios modelos — o vietnamita fica em uma camada de terceiros que um administrador precisa habilitar e que não funciona com detecção automática.
- A comparação abaixo mostra onde o vietnamita tem suporte nas principais plataformas em 31 de agosto de 2026, seguida de seis etapas para conduzir uma reunião vietnamita–inglês que deixe um registro.
A mesma lacuna afeta outros idiomas, como explicamos em nossa visão geral sobre a tradução que desaparece depois da conversa. Para equipes vietnamitas, o problema é mais grave: os recursos de reunião projetados para preservar um registro não incluem o vietnamita.
O que a «tradução de voz ao vivo» realmente entrega em vietnamita hoje
Vamos começar pela contabilidade honesta, porque as ferramentas gratuitas do Google são muito boas naquilo para que foram construídas.
O Live translate do Google Tradutor traz quatro modos, segundo sua página de ajuda para Android consultada em 31 de agosto de 2026: Listening (encoste o celular no ouvido ou use fones para a tradução em tempo real de outra pessoa), Conversation (as traduções são reproduzidas em voz alta e os falantes se alternam), Text only (leitura, sem áudio) e Custom settings. Há também um modo Face to face separado, no qual a tela se divide e cada falante vê tanto a transcrição quanto a tradução do seu próprio idioma em sua metade. O microfone detecta automaticamente quando um idioma para e o outro começa, então ninguém precisa tocar em um botão entre uma frase e outra.
Dois detalhes merecem mais crédito do que costumam receber. Primeiro, a sessão sobrevive ao multitarefa: a documentação do Google afirma que a tradução «continua sem interrupções quando você troca de aplicativo, minimiza o aplicativo ou quando a tela é bloqueada». Segundo, o vietnamita pode ser baixado para uso offline, e os pacotes baixados podem ser atualizados para uma versão de qualidade superior na mesma tela — o que importa em um país onde uma visita técnica ou o chão de fábrica não são ambientes de conectividade garantida.
Uma limitação vale ser dita com todas as letras, porque surpreende as pessoas: isto é um recurso de celular. A própria página de ajuda do Google para a versão web diz, em uma frase: «Você não pode falar e traduzir ao mesmo tempo no Google Tradutor para a web». Se a sua reunião bilíngue acontece em um notebook, o Live translate não está na sala.
Para uma corrida de táxi, uma visita a fornecedor ou uma conversa de corredor com um cliente visitante, a tradução ao vivo é uma opção gratuita e eficaz. A lacuna aparece quando uma reunião precisa de um registro duradouro e pesquisável depois que a conversa termina.
O Gemini 3.5 Live Translate leva o Meet de cinco idiomas para mais de setenta
O suporte do Google à tradução ao vivo está se expandindo para além dos recursos de telefone e de legendas disponíveis quando este artigo foi publicado.
Em 9 de junho de 2026, o Google anunciou o Gemini 3.5 Live Translate, um modelo de tradução fala-a-fala que cobre mais de 70 idiomas. Como a Slator informou em 16 de junho de 2026, ele está sendo lançado pela Gemini Live API e pelo Google AI Studio em prévia pública, entrando em prévia privada no Google Meet para clientes Workspace selecionados, e chegando globalmente dentro do aplicativo móvel do Google Tradutor no Android e no iOS.
O número que importa para o Meet é o antes e depois. A tradução de fala no Meet estava limitada a cinco idiomas suportados, com tradução apenas de e para o inglês. O Gemini 3.5 Live Translate expande isso para mais de 70 idiomas e mais de 2.000 combinações de pares de idiomas, com disponibilidade mais ampla prevista para o final de 2026. Para uma equipe vietnamita, um sistema de cinco idiomas com pivô em inglês era, na prática, sistema nenhum; 2.000 pares são outro produto.
O Google está posicionando o modelo de forma restrita, o que é um bom sinal e não um mau sinal. Segundo a Slator, a documentação contrasta o Live Translate com as capacidades mais amplas de Live Agent do Gemini: ele funciona como um pipeline de tradução em tempo real, aceita entrada apenas de áudio e omite deliberadamente chamada de funções, ancoragem em busca, ferramentas e instruções de sistema. É um intérprete, não um assistente — a mesma distinção que a OpenAI fez ao descrever o GPT-Realtime-Translate. O Google também adicionou um «modo de escuta» no Android que envia o áudio traduzido pelo alto-falante do ouvido, para você acompanhar uma tradução sem usar fones visíveis em uma reunião.
Ou seja: a camada ao vivo para o vietnamita está melhorando rápido e por várias frentes ao mesmo tempo. Agora, a outra pergunta.
A linha do registro: onde o vietnamita para
Toda plataforma tem uma linha. De um lado estão os recursos que ajudam você a entender a fala no momento em que ela acontece. Do outro, os recursos que transformam a fala em algo que você ainda terá na semana que vem. Chame isso de a linha do registro — e, para o vietnamita, é exatamente ali que o suporte desaparece.
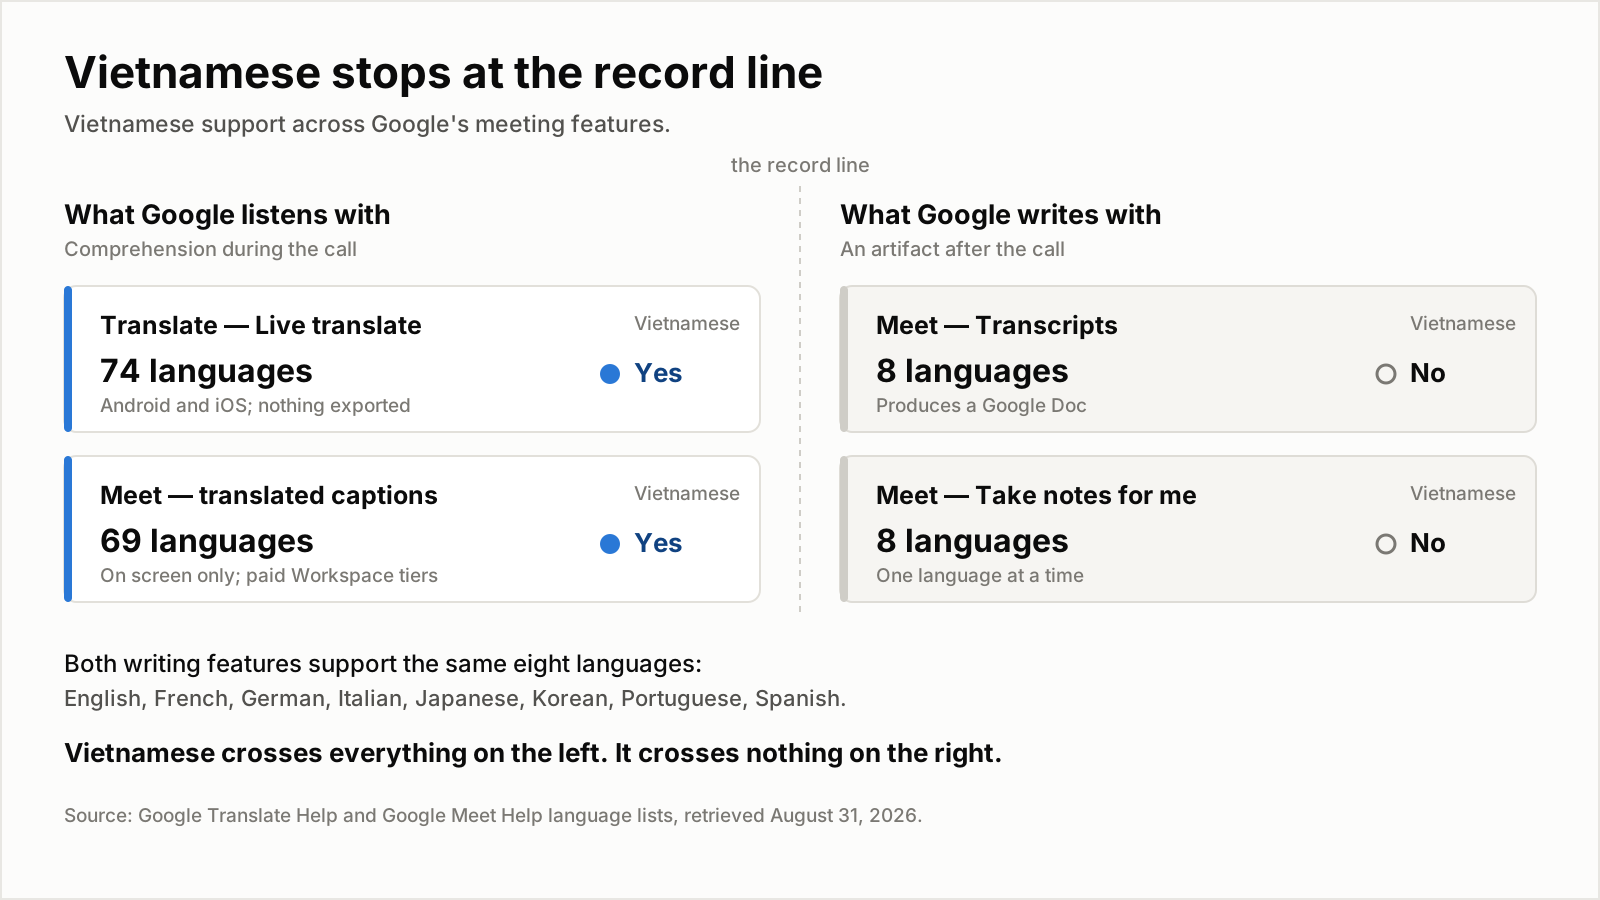
As contagens de idiomas são do próprio Google, extraídas de quatro páginas de ajuda consultadas em 31 de agosto de 2026. O vietnamita aparece nos dois recursos de escuta e em nenhum recurso de escrita.
A comparação recurso por recurso deixa esse limite claro:
| Recurso do Google | Vietnamita suportado? | Idiomas | Deixa um artefato depois da chamada? |
|---|---|---|---|
| Google Tradutor — Live translate | Sim | 74 | Não |
| Google Meet — legendas traduzidas | Sim | 69 | Só na tela; embutidas no vídeo se você usar Record captions |
| Google Meet — Transcripts | Não | 8 | Sim, um Google Doc |
| Google Meet — «Take notes for me» | Não | 8, um por vez | Sim, notas no Google Docs mais um resumo por e-mail |
| Google Meet — Gemini 3.5 Live Translate | Em implantação | 5 hoje, 70+ em prévia privada | Não informado |
Todas as linhas vêm de páginas de Ajuda do Google e do relatório da Slator de 16 de junho de 2026, consultados em 31 de agosto de 2026.
Os oito idiomas compartilhados por Transcripts e «Take notes for me» são idênticos: inglês, francês, alemão, italiano, japonês, coreano, português e espanhol. É a mesma lista duas vezes, e é uma lista de grandes mercados europeus e do Leste Asiático. O vietnamita — cerca de 97 milhões de falantes, pela própria contagem da Samsung em seu relato de 2024 sobre o trabalho — está fora dela, ao lado do tailandês, do indonésio, do hindi e do árabe.
Há mais uma restrição que atinge especificamente equipes bilíngues, e que se aplica mesmo a equipes que trabalham inteiramente em idiomas suportados. A página de ajuda do Google para «Take notes for me» afirma que o recurso suporta um idioma por vez e que vários idiomas falados na mesma reunião não são suportados atualmente. Uma chamada Vietnã–EUA que alterna entre vietnamita e inglês é desqualificada duas vezes: uma por ser vietnamita, outra por alternar.
As legendas traduzidas do Meet têm uma forma limitada de persistência: selecione Record captions e elas serão incorporadas ao vídeo gravado; também é possível revê-las durante a sessão. No entanto, legendas incorporadas ao vídeo não são uma transcrição pesquisável ou editável e não fornecem texto para gerar um resumo. As legendas traduzidas do Meet estão limitadas às edições pagas do Workspace: Business Standard, Business Plus, Enterprise Standard, Enterprise Plus, Enterprise Starter (disponível até 30 de junho de 2025) e Google AI Pro for Education.
O DeepL vai mostrar legendas em vietnamita. Transcrever vietnamita falado é outra camada.
O DeepL Voice oferece outra opção, mas sua documentação distingue o idioma usado para o reconhecimento de fala daquele exibido nas legendas.
O DeepL divide o suporte a idiomas em duas listas. Idiomas falados são os que o reconhecedor aceita. Idiomas de tradução são aqueles em que as legendas podem ser exibidas. O vietnamita aparece na lista de tradução, que chega a 41 idiomas. Agora olhe para o outro lado: os modelos próprios do DeepL transcrevem 18 idiomas falados — chinês (mandarim), tcheco, holandês, inglês, francês, alemão, indonésio, italiano, japonês, coreano, polonês, português, romeno, russo, espanhol, sueco, turco e ucraniano. O vietnamita não está entre eles.
O vietnamita está disponível como idioma falado, mas apenas em uma segunda camada de 20 idiomas transcritos por um provedor terceirizado, a Speechmatics. Três condições vêm junto, todas documentadas na página de ajuda do DeepL consultada em 31 de agosto de 2026:
- Um administrador da equipe precisa habilitar o processamento por terceiros na conta de administrador da organização antes que qualquer um desses idiomas funcione.
- A detecção automática não funciona. Nas palavras do DeepL: «Idiomas de terceiros não funcionam com Auto-detect language — eles precisam ser selecionados manualmente como Spoken language».
- Para permitir que os participantes escolham seu próprio idioma falado, o anfitrião precisa habilitar um código de acesso ao conectar a reunião ao DeepL Voice.
Nada disso é irracional — o DeepL observa que a Speechmatics opera sob um acordo de retenção zero, então os dados de transcrição são excluídos dos servidores deles assim que processados. Mas empilhe os requisitos e você chega ao resultado prático: uma pessoa que fala vietnamita entrando em uma reunião equipada com DeepL está a uma configuração de administrador desmarcada de não ser transcrita, e não pode contar com o sistema para notá-la automaticamente. Enquanto isso, a postura de retenção é a mesma sobre a qual escrevemos esta manhã — o FAQ do DeepL diz que os dados da reunião são «processados temporariamente na memória e excluídos quando a chamada termina».
A Samsung é o contraexemplo que vale nomear. O vietnamita esteve entre os 16 primeiros idiomas lançados pela Galaxy AI, e o Samsung R&D Institute Vietnam publicou em 23 de maio de 2024 um relato incomumente franco sobre por que aquilo foi difícil. O vietnamita tem seis tons distintos; o exemplo do artigo é que ma, mả e má — fantasma, túmulo e mãe — diferem apenas pelo tom. Bui Ngoc Tung, líder de ASR do instituto, descreveu um modelo que diferencia quadros de áudio de «cerca de 20 milissegundos» para decidir a qual palavra pertence uma sequência de quadros. Quando uma fabricante coreana de celulares investe em modelagem tonal do vietnamita e uma empresa europeia de tradução repassa o idioma a um subcontratado, isso diz algo sobre como o mercado precifica essa língua.
No reconhecimento de fala, a documentação do Nova-3 da Deepgram lista o vietnamita como vi (consultada em 31 de agosto de 2026). Esse é um dos 58 idiomas abordados em nossa análise do que a palavra «suportado» esconde na cobertura de fala para texto.
Nenhum fornecedor publica uma taxa de erro para fala vietnamita em reuniões, e os corpora explicam por quê
As pontuações publicadas de reconhecimento de fala ainda não mostram às equipes como a transcrição em vietnamita funcionará em reuniões espontâneas; os corpora disponíveis ajudam a explicar essa lacuna.
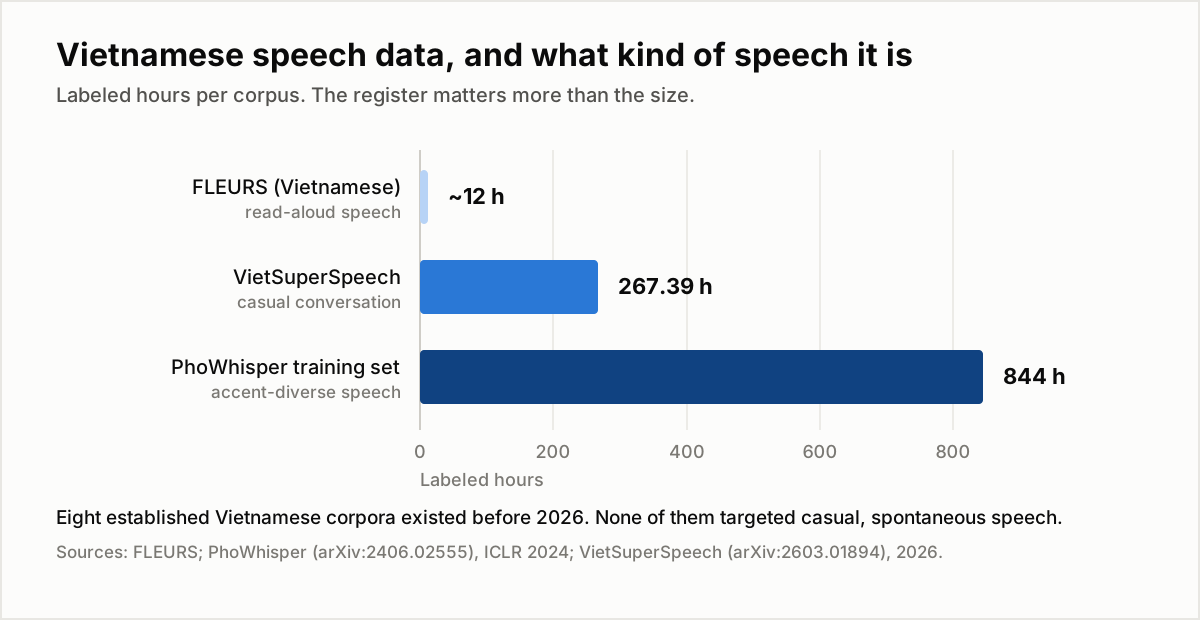
As horas rotuladas não são a história toda — o registro é. O FLEURS é fala lida; o conjunto de treinamento do PhoWhisper abrange sotaques; o VietSuperSpeech é o primeiro corpus construído especificamente para conversa informal. Fontes datadas na lista abaixo.
O FLEURS, um benchmark vietnamita bastante citado, oferece cerca de 12 horas de fala lida em voz alta. O PhoWhisper, apresentado na trilha Tiny Papers da ICLR 2024, ajustou o Whisper com um conjunto de dados de 844 horas selecionado pela diversidade de sotaques. O VietASR, publicado em 23 de maio de 2025, usou 70.000 horas de áudio não rotulado e 50 horas rotuladas, e relata superar o Whisper Large-v3 e sistemas comerciais em dados do mundo real.
O VietSuperSpeech, lançado em 2026, reúne 52.023 pares de áudio e texto, totalizando 267,39 horas de vietnamita conversacional informal: 240,67 horas de treinamento e 26,72 de avaliação, com 13,8 milhões de caracteres integralmente marcados com diacríticos. Os autores descrevem assim a lacuna que o conjunto de dados aborda:
«Embora corpora como VLSP2020, VIET_BUD500, VietSpeech, FLEURS, VietMed, Sub-GigaSpeech2-Vi, viVoice e Sub-PhoAudioBook ofereçam ampla cobertura de fala formal e lida, nenhum deles se dirige especificamente ao registro casual e espontâneo indispensável para aplicações de IA conversacional.»
O conjunto de dados busca captar o registro comum em reuniões: interrupções, hesitações, nomes de produtos em inglês no meio de frases vietnamitas e pensamentos inacabados. Uma pontuação baseada apenas em fala lida não permite determinar, por si só, a precisão de um sistema nesse tipo de conversa.
Para as equipes, a proteção prática é uma transcrição que as pessoas possam revisar e corrigir. Para isso, o recurso de reunião escolhido precisa primeiro criar uma transcrição em vietnamita.
Como conduzir uma reunião vietnamita–inglês para que o registro sobreviva
Use estas seis verificações antes e durante a chamada:
- Quando necessário, escolha ferramentas separadas para compreensão e registro. O Google Tradutor ou as legendas do Meet podem ajudar a compreender vietnamita ao vivo; nenhum desses recursos cria a transcrição duradoura em vietnamita descrita aqui.
- Defina o vietnamita explicitamente como idioma falado; não dependa da detecção automática. No DeepL isso é obrigatório — idiomas de terceiros, vietnamita incluído, não podem ser detectados automaticamente. Em todo o resto continua sendo a melhor escolha, porque a detecção automática se compromete com um palpite nos primeiros segundos, no áudio menos contextual de toda a sessão.
- Confira a lista de idiomas do recurso de registro, não a da plataforma. A armadilha que este texto existe para descrever é supor que uma plataforma que traduz vietnamita também o transcreve. No Google Meet, 69 contra 8 é a distância entre essas duas suposições.
- Nomeie o problema da alternância de idiomas antes da chamada. Se sua equipe joga nomes de produtos, IDs de tíquete e siglas em inglês dentro de frases em vietnamita — e toda equipe de engenharia offshore faz isso —, verifique se sua ferramenta de registro tolera dois idiomas em uma mesma sessão. O anotador do Meet explicitamente não tolera.
- Corrija os nomes próprios nos primeiros cinco minutos, ao vivo. Os diacríticos do vietnamita e os codinomes de produtos em inglês são os dois pontos em que a transcrição quebra de forma confiável, e também os dois pontos em que uma linha errada causa mais estrago a qualquer resumo construído sobre ela. Corrigir durante a reunião custa segundos.
- Mantenha o texto original em vietnamita, a tradução para o inglês e o resumo em um único registro. Não três arquivos em três ferramentas. A tradução é de mão única: você pode retraduzir a partir do vietnamita no ano que vem com um modelo melhor, mas nunca vai recuperar o vietnamita a partir do inglês.
Para um passo a passo do produto, consulte nosso guia de junho sobre como transformar a gravação de uma reunião bilíngue em uma nota de IA revisável.
A conclusão: o vietnamita cruzou o abismo da compreensão, e não o do registro
O vietnamita agora é compatível com legendas ao vivo, áudio interpretado e reconhecimento de fala. Isso dá às equipes mais maneiras de acompanhar uma conversa, mas a cobertura anunciada não significa que o recurso esteja disponível na sua conta. A expansão do Gemini 3.5 Live Translate no Meet é uma prévia e uma implantação gradual, não um substituto universal dos pares de idiomas atualmente compatíveis. Confira o recurso, a conta e a direção do vietnamita de que você precisa antes da reunião.
O que não se moveu é o registro. Os dois recursos do Google que produzem um artefato duradouro suportam oito idiomas entre si, os mesmos oito, e o vietnamita não está em nenhum. O DeepL legenda para o vietnamita, mas encaminha a transcrição dele a um subcontratado atrás de um botão de administrador. O mercado decidiu que o vietnamita é uma língua que vale a pena ouvir e ainda não uma língua que vale a pena registrar por escrito.
Então a pergunta a fazer a um fornecedor não é se ele suporta vietnamita. Quase todos hoje dizem que sim, e quase todos querem dizer a metade que escuta. A pergunta é: quais dos seus recursos suportam vietnamita depois que a chamada termina — e você pode me mostrar a lista de idiomas desse recurso específico?
Onde o Telli.sh se encaixa: a camada do registro é a camada que nós construímos. O Telli.sh transcreve a reunião no idioma em que ela foi de fato falada, traduz para 44 idiomas de destino, incluindo o vietnamita, e mantém os três artefatos na mesma nota — o texto original em vietnamita, a tradução alinhada a ele e o resumo gerado em cima. A própria interface está disponível em 15 idiomas, vietnamita incluído, para que uma equipe em Da Nang e um cliente em Sydney leiam a mesma reunião no seu próprio idioma e ainda compartilhem um único registro corrigível.
Comece uma nota de reunião traduzida ao vivo
Fontes
- Google Translate Help, "Hear live speech to speech translations with Live translate" (Android), consultado em 31 de agosto de 2026 — a lista de 74 idiomas incluindo o vietnamita, os quatro modos de tradução, o modo cara a cara e a continuação em segundo plano.
- Google Translate Help, "Download languages to use offline" (Android), consultado em 31 de agosto de 2026 — pacotes offline e atualizações de qualidade superior.
- Google Meet Help, "Use translated captions in Google Meet", consultado em 31 de agosto de 2026 — a lista de 69 idiomas incluindo o vietnamita, as edições pagas do Workspace e o Record captions.
- Google Meet Help, "Use Transcripts with Google Meet", consultado em 31 de agosto de 2026 — os oito idiomas suportados para transcrição.
- Google Meet Help, "'Take notes for me' in Google Meet", consultado em 31 de agosto de 2026 — os mesmos oito idiomas e a limitação de um idioma por vez.
- Slator, "Google Expands AI Live Speech Translation with Gemini 3.5 Live Translate", 16 de junho de 2026 — o anúncio de 9 de junho, mais de 70 idiomas, o Meet saindo de cinco idiomas para mais de 2.000 pares, e o modo de escuta.
- DeepL Help Center, "DeepL Voice languages", consultado em 31 de agosto de 2026 — os 18 idiomas falados transcritos pelo DeepL, os 20 idiomas falados de terceiros incluindo o vietnamita, os 41 idiomas de tradução, a restrição da detecção automática e o acordo de retenção zero da Speechmatics.
- Samsung Newsroom, "The Learning Curve, Part 3: Taking AI Data From Good to Great", 23 de maio de 2024 — o vietnamita entre os 16 primeiros idiomas da Galaxy AI, os seis tons, o exemplo ma/mả/má e a descrição dos quadros de ~20 ms.
- Deepgram, Models & Languages Overview, consultado em 31 de agosto de 2026 — o vietnamita (
vi) na lista de idiomas do Nova-3. - Le, Nguyen e Nguyen, "PhoWhisper: Automatic Speech Recognition for Vietnamese", ICLR 2024 Tiny Papers — o conjunto de fine-tuning de 844 horas com diversidade de sotaques.
- "VietASR: Achieving Industry-level Vietnamese ASR with 50-hour labeled data and Large-Scale Speech Pretraining", 23 de maio de 2025 — 70.000 horas não rotuladas, 50 horas rotuladas.
- "VietSuperSpeech: A Large-Scale Vietnamese Conversational Speech Dataset", 2026 — 52.023 pares, 267,39 horas e a lacuna de registro nos oito corpora.