[Cuaderno de ideas de IA 02] Timestral: predice las cifras de mañana sin pedirle a un chatbot que adivine
Una introducción a los pequeños modelos de series temporales de Mistral: qué significan las predicciones probabilísticas, dónde ayudan y cómo empezar con un experimento en CPU y una comparación honesta.
Cuaderno de ideas de IA explora las ideas y las posibilidades prácticas que hay detrás de los nuevos modelos y herramientas de IA.
La cola de soporte de mañana es una cifra antes de convertirse en un párrafo. Quizá quieras saber si debes asignar a otra persona, si un servidor necesita más capacidad o si el pedido habitual de existencias cubrirá el fin de semana. Una explicación fluida solo resulta útil cuando la predicción tiene una base sólida.
Timestral, presentado por Mistral AI el 15 de octubre de 2026, es una familia de modelos para predecir secuencias numéricas. Produce predicciones probabilísticas en lugar de respuestas de chat, admite varias series relacionadas y está publicado en cuatro tamaños: 5M, 28M, 123M y 209M de parámetros. Anuncio de Mistral
Esta introducción lleva esa descripción hasta un primer experimento útil. Veremos qué datos proporcionar al modelo, cómo interpretar un intervalo de predicción y cómo compararlo con una referencia sencilla. Los ejemplos son ejercicios propuestos, para que puedas probar la idea sin confundir una ilustración con un resultado medido.
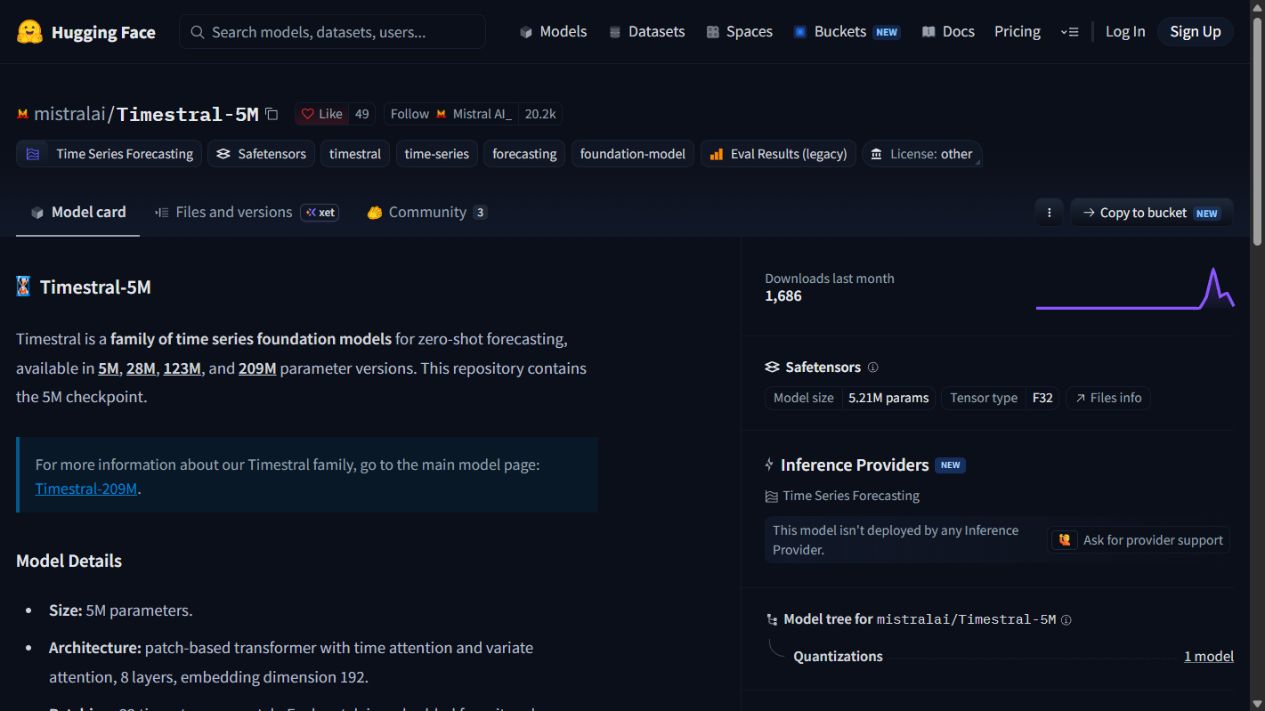 La página de Timestral-5M de Mistral AI, capturada el 20 de octubre de 2026. La pantalla identifica un checkpoint de predicción; no es una gráfica de un experimento realizado para este artículo.
Una predicción empieza con un reloj y una cantidad
Una serie temporal registra una cantidad en pasos sucesivos de tiempo. Algunos ejemplos son el número de solicitudes por minuto, los pedidos diarios o la temperatura a intervalos regulares. La separación temporal forma parte del significado: 100 solicitudes por minuto y 100 solicitudes por hora describen sistemas muy distintos.
Antes de seleccionar un modelo, expresa la decisión en una frase. «Estimar el volumen diario de soporte de mañana para planificar la cobertura» es más claro que «extraer información de nuestros datos». Especifica el objetivo, el horizonte y la acción que podría cambiar.
Después decide qué representa una observación. Un ticket de soporte creado hoy y uno resuelto hoy son eventos distintos. Combinarlos en una columna por comodidad puede ocultar precisamente el cuello de botella que querías entender.
Timestral entra en juego después de esta definición. Puede procesar un historial numérico, pero el equipo sigue siendo responsable del significado de esas cifras. Un modelo no puede reparar un objetivo que cambia silenciosamente de solicitudes a trabajos completados a mitad del archivo.
El resultado útil es un intervalo sobre el que puedas actuar
Una predicción puntual ofrece una cifra. Una predicción probabilística describe varios niveles posibles del valor futuro y ayuda a ver cuánto margen rodea a la estimación central. El resultado publicado de Timestral incluye 21 cuantiles por cada paso temporal predicho. Repositorio de inferencia
Imagina un ejercicio en el que la mediana predicha para mañana es de 100 tickets y un cuantil superior es de 140. Son cifras inventadas, pero muestran la decisión: la dotación ordinaria puede cubrir la estimación central, mientras que un plan de refuerzo cubre un día más intenso. La predicción resulta útil porque cambia cómo te preparas.
Un cuantil no promete que la realidad permanecerá por debajo de una línea. Debes comprobar la calibración mediante predicciones históricas repetidas. Si las observaciones superan una supuesta predicción del percentil 90 con mucha más frecuencia de la esperada, ese nivel no funciona como un límite fiable de planificación para tus datos.
El límite adecuado también depende de la decisión. Quedarse sin existencias y mantener un pequeño excedente tienen costes diferentes. Por eso un equipo puede actuar sobre un cuantil superior a la mediana, mientras otra tarea admite un plan más barato y menos conservador.
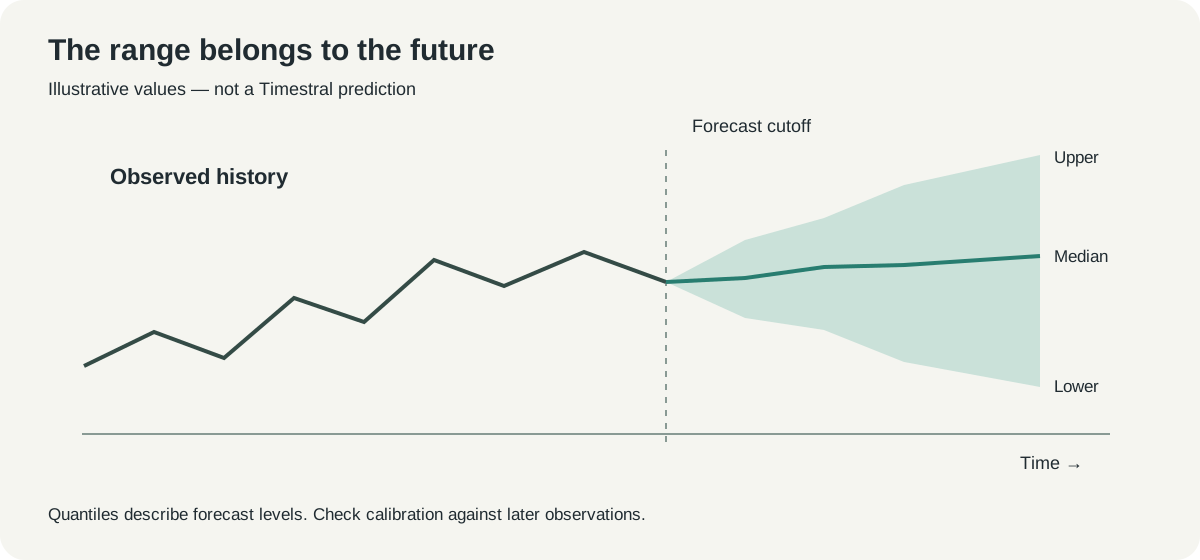 Diagrama explicativo original. La curva y el intervalo son inventados para explicar una ventana de predicción; no son resultados de Timestral.
Las señales relacionadas solo ayudan si se respeta cuándo estaban disponibles
Mistral describe Timestral como un modelo multivariante compatible con covariables disponibles solo en el pasado y con otras cuyo futuro ya se conoce. En términos cotidianos, puede utilizar varias señales numéricas relacionadas e información cuyos valores futuros ya están disponibles. Descripción del lanzamiento
El calendario de apertura de una tienda se conoce antes de que llegue mañana. Las ventas reales de mañana, no. Un experimento de predicción debe respetar esa diferencia aunque la hoja de cálculo terminada contenga cómodamente ambas columnas.
En un ejercicio de capacidad de servidores, un lanzamiento de producto programado puede conocerse de antemano, mientras que el volumen exacto de solicitudes sigue siendo desconocido. En un ejercicio sobre volumen de pedidos, puede disponerse de un indicador de festivos, mientras que el número final de pedidos es el objetivo. Son ejemplos de esa distinción, no afirmaciones sobre una integración desplegada.
El tiempo meteorológico ilustra bien un error fácil de cometer. Un archivo histórico puede contener el tiempo que realmente hizo. Una predicción real solo habría tenido disponible el pronóstico meteorológico de aquel momento. Evaluar con la observación posterior proporciona al sistema información que no habría tenido al tomar la decisión.
Empieza por el experimento más pequeño que responda a una pregunta
El repositorio oficial ofrece inferencia independiente en CPU o GPU. La opción de CPU facilita una primera prueba sin tratar el tamaño del modelo como un requisito de hardware completo. Las dependencias, los tensores cargados, la longitud del historial y el número de series también contribuyen a la memoria utilizada. Instalación y uso
Como introducción, el checkpoint de 5M es un candidato razonable para explorar la interfaz. Es un punto de partida sugerido para un ejercicio pequeño, no una afirmación de que superará a checkpoints mayores con tus datos. Establece un flujo funcional antes de comparar tamaños.
- Abre el repositorio oficial e inspecciona las instrucciones de instalación y los enlaces de licencia. Trabaja en un entorno Python separado.
- Prepara una serie con muestreo regular. Conserva las marcas temporales y las unidades en el archivo original aunque el array numérico enviado al modelo solo contenga valores.
- Reserva las últimas observaciones como horizonte de prueba. No las incluyas en el historial utilizado para esa predicción.
- Carga un checkpoint, solicita el horizonte elegido e inspecciona tanto la predicción central como los cuantiles.
- Compara con una predicción sencilla construida a partir del mismo historial. Repite con varios puntos de corte anteriores antes de sacar conclusiones.
El repositorio documenta esta vía de instalación y declara como requisitos Python 3.10 o posterior y PyTorch 2.4 o posterior. La instalación descarga código; revisa y fija una revisión cuando necesites un entorno reproducible.
python -m venv .venv
# Activate the environment using your shell's activation command.
python -m pip install "git+https://github.com/mistralai/timestral.git"
Aquí tienes una adaptación deliberadamente pequeña de la interfaz de inferencia documentada. Los valores son recuentos diarios sintéticos; el código no implica que este artículo haya ejecutado el modelo ni obtenido un resultado concreto.
import numpy as np
from timestral import TimestralForecaster

history = np.array([
    80, 83, 85, 88, 96, 61, 58,
    82, 84, 87, 91, 99, 64, 60,
    85, 86, 89, 94, 102, 66, 63,
], dtype=np.float32)

model = TimestralForecaster.from_pretrained("mistralai/Timestral-5M")
forecast = model.forecast(history, prediction_length=7)
print(forecast.median)
print(forecast.quantile(0.9))
Tres semanas de datos inventados bastan para ilustrar la API, no para establecer el rendimiento en un proceso empresarial. Sustitúyelas por una serie suficientemente larga y bien comprendida antes de tomar una decisión. Comprueba las observaciones ausentes y los eventos inusuales en lugar de convertir silenciosamente cada hueco en cero.
Tres tareas muestran por qué predecir difiere de generar texto
La planificación diaria de soporte conecta una predicción con la dotación de personal. La entrada podría ser un historial de tickets creados cada día, acompañado de un calendario de fines de semana y cierres conocidos. La pregunta de evaluación es si la predicción ayuda a preparar capacidad, especialmente para días intensos que un promedio sencillo no detecta.
La planificación de servidores conecta una predicción con un límite técnico. Las solicitudes por intervalo pueden ser el objetivo, pero los errores, la latencia y la capacidad admitida requieren seguimiento independiente. Una predicción de la demanda esperada no demuestra que una aplicación soporte una carga determinada.
La planificación de existencias conecta una predicción con el plazo de reposición. Si reponer lleva varios días, la demanda de mañana por sí sola es un horizonte equivocado. El ejercicio útil predice el intervalo durante el que el siguiente pedido aún no puede llegar y compara las consecuencias de la escasez y del exceso de existencias.
Los tres ejemplos comparten un patrón: definir la cantidad, definir cuándo se toma la decisión y definir qué cambia por la predicción. El modelo se convierte así en un instrumento dentro del flujo de trabajo. Resulta más fácil valorar ese instrumento cuando la acción prevista es visible.
Compara las predicciones en el momento en que podrían haberse realizado
Una prueba retrospectiva recrea oportunidades anteriores de predicción. Elige un punto de corte histórico, proporciona solo la información disponible antes de él y predice el intervalo siguiente. Adelanta el corte y repite sin permitir que las observaciones futuras se filtren hacia atrás en la selección del modelo.
Empieza por una referencia que se ajuste al patrón. El valor del mismo día de la semana anterior puede servir para un ciclo semanal; el último valor observado puede servir para un proceso estable y de horizonte corto. Ninguna opción es automáticamente sólida, pero ambas permiten saber si la complejidad añadida se justifica.
| Comparación | Qué mantener fijo | Qué puede decirte el resultado |
|---|---|---|
| Timestral frente a una referencia estacional | Objetivo, cortes y horizonte de predicción | Si el modelo mejora los errores relevantes para la decisión |
| 5M frente a un checkpoint mayor | Preparación de datos y puntuación | Si los recursos adicionales del modelo aportan suficiente beneficio |
| Con y sin un calendario conocido | Información histórica disponible en cada corte | Si la señal adicional ayuda sin filtrar el futuro |
| Mediana frente a un cuantil superior para decidir | Predicciones y supuestos de costes empresariales | Cómo cambia la política de planificación, en lugar de cómo cambia el modelo |
No pierdas de vista los periodos con valores cero o próximos a cero. Un error porcentual puede ser difícil de interpretar cuando el objetivo es diminuto. Usa métricas apropiadas para la serie e inspecciona los fallos concretos junto a la puntuación agregada.
En una prueba piloto práctica, una pequeña tabla con los mayores fallos suele enseñar más que un promedio destacado. ¿El error estuvo asociado a un intervalo ausente, un festivo, una caída del sistema o un cambio real de demanda? La respuesta determina si hay que mejorar el flujo de datos, añadir información o reconsiderar el enfoque de predicción.
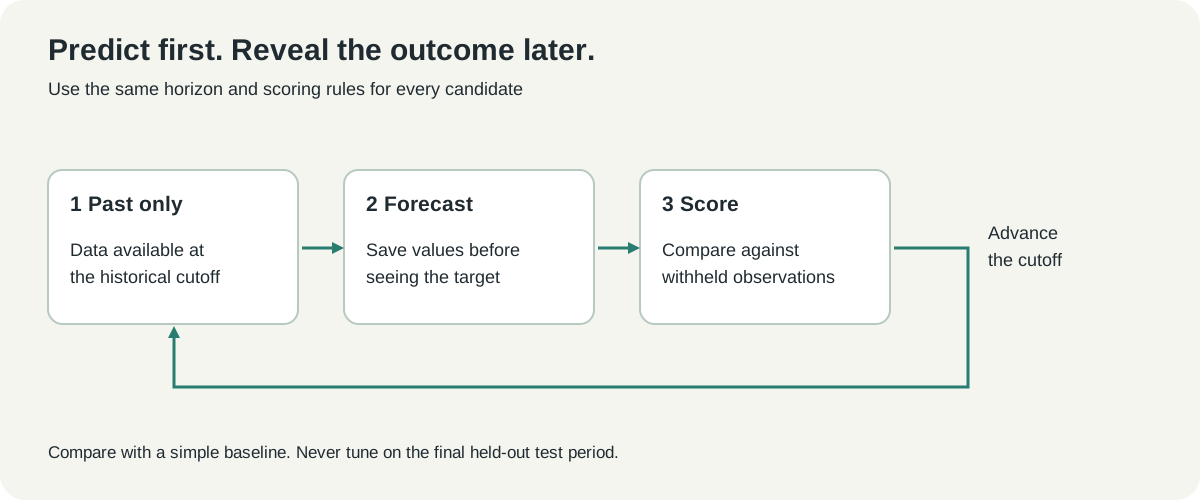 Diagrama original de pruebas retrospectivas. Cada predicción utiliza información disponible en su propio corte; las observaciones posteriores se reservan para puntuar.
Unos pesos pequeños son solo una parte del despliegue
El repositorio distingue el código Apache 2.0 de los pesos del modelo publicados bajo una licencia MIT modificada. Lee las condiciones reales de los pesos del checkpoint elegido; un repositorio abierto y un modelo con licencia independiente son artefactos de distribución distintos. Explicación de licencias del repositorio
Las descargas iniciales y la inferencia habitual también son etapas distintas. El cargador documentado puede utilizar un modelo local en caché, pero una aplicación solo permanece desconectada si todos sus componentes lo hacen. Un modelo de predicción local no impide que otra parte del flujo envíe datos a un servicio remoto.
Para operaciones repetidas, registra qué checkpoint produjo cada predicción y hasta cuándo llegan los datos de entrada. Una gráfica sin ese corte puede confundirse con una predicción aunque incorpore observaciones posteriores. Mantén intactos los valores predichos para compararlos después con lo que ocurrió.
Un servicio de predicción también debe tener un plan para los datos ausentes y las ejecuciones fallidas. Mostrar la predicción de ayer como si fuera nueva crea una interfaz engañosamente saludable. Haz visible la marca temporal de los últimos datos procesados correctamente y decide cuándo una referencia sencilla es preferible a una salida obsoleta del modelo.
Una predicción más rápida solo sirve si mejora la decisión
Mistral informa de inferencia adecuada para CPU y buenos resultados de benchmark en esta familia. Son razones para investigar, no mediciones de tu propio flujo de datos. Un tiempo publicado del modelo no incluye todas las posibles lecturas de archivos, cálculos de características, colas o gráficas de una aplicación. Anuncio del 15 de octubre
Existe la tentación habitual de centrar la prueba piloto en el checkpoint más grande que pueda ejecutarse. Una pregunta mejor es si la predicción llega antes de la decisión y mejora los errores que importan. Un resultado algo más preciso que llega después del plazo para organizar turnos tiene un valor operativo limitado.
También conviene distinguir una mejora numérica de una mejora de política. Un error medio menor puede dejar sin cambios los días intensos más costosos. A la inversa, un cuantil superior mejor calibrado puede mejorar la planificación aunque la mediana apenas cambie.
Decide estos criterios antes de comparar modelos. Así la prueba piloto puede concluir con una elección útil: conservar la referencia, usar un checkpoint pequeño o justificar una configuración más exigente. Cualquiera puede ser el resultado correcto si las pruebas son claras.
La predicción debe dejar constancia antes de que llegue mañana
En nuestra opinión, Timestral resulta interesante porque incorpora una tarea numérica especializada a un flujo accesible de uso de modelos. Su resultado puede funcionar como una previsión meteorológica de la carga de trabajo: una expectativa central, un intervalo y un motivo para prepararse. El valor aparece cuando esas predicciones se encuentran con una decisión real de planificación.
Empieza por una cantidad y un horizonte. Guarda la predicción antes de conocer el resultado y compárala honestamente con una alternativa sencilla. Así un lanzamiento prometedor se convierte en un experimento cuyo resultado realmente puedes aprovechar.
Fuentes y recursos visuales
Consultado el 20 de octubre de 2026. Los ejemplos y las gráficas son ilustrativos, no resultados de ejecución del modelo. El autor capturó la ficha pública del modelo; los diagramas explicativos son originales. Consulta el registro de medios para conocer fuentes y avisos de licencia.
- Anuncio de Mistral, 15 de octubre de 2026
- Código oficial de inferencia, instalación y distinción de licencias
- Checkpoint Timestral-5M
- Licencia del checkpoint
Conserva juntas la predicción y la realidad observada
Guarda la definición de los datos, el corte de predicción y las notas de revisión junto a los enlaces originales. Telli.sh puede ayudarte a organizar ese registro experimental. Crea una cuenta en Telli.sh