AnyDecisionModel i AnySpeechRecognizer oddzielają słuchanie od wyborów w aplikacji Swift
Dwa niezależne pakiety Swift łączą silniki mowy i decyzje o określonym typie. Gdzie pomaga lokalne wnioskowanie, dlaczego pewność wymaga kalibracji i jak rozpocząć ograniczony pilotaż aplikacji.
Nagranie rozmowy z pomocą techniczną zawiera dwa różne problemy. Najpierw aplikacja musi odtworzyć słowa rozmówcy. Następnie zdecydować, czy prośba należy do rozliczeń, wsparcia technicznego czy innego zespołu. Traktowanie obu jako jednej otwartej rozmowy zaciemnia odpowiedzialność aplikacji.
Programista Mattt przedstawił AnySpeechRecognizer i AnyDecisionModel 29 października 2026 r. To niezależne pakiety Swift dla twórców aplikacji na platformy Apple: pierwszy daje wybór silników rozpoznawania mowy, drugi zwraca wybory o określonym typie i rozkłady prawdopodobieństwa. Korzystają ze znanych wzorców Swift, ale nie są zapowiedziami produktów Apple. Wprowadzenie Mattta wyjaśnia oba zadania na tym samym przykładzie rozmowy ze wsparciem.
Interesującą zmianą jest możliwość oddzielnego wyboru i oceny tych zadań. Ten przewodnik wyjaśnia wkład pakietów, wpływ lokalnych i hostowanych mechanizmów na projekt aplikacji oraz to, dlaczego liczbowa pewność nadal wymaga polityki produktu.
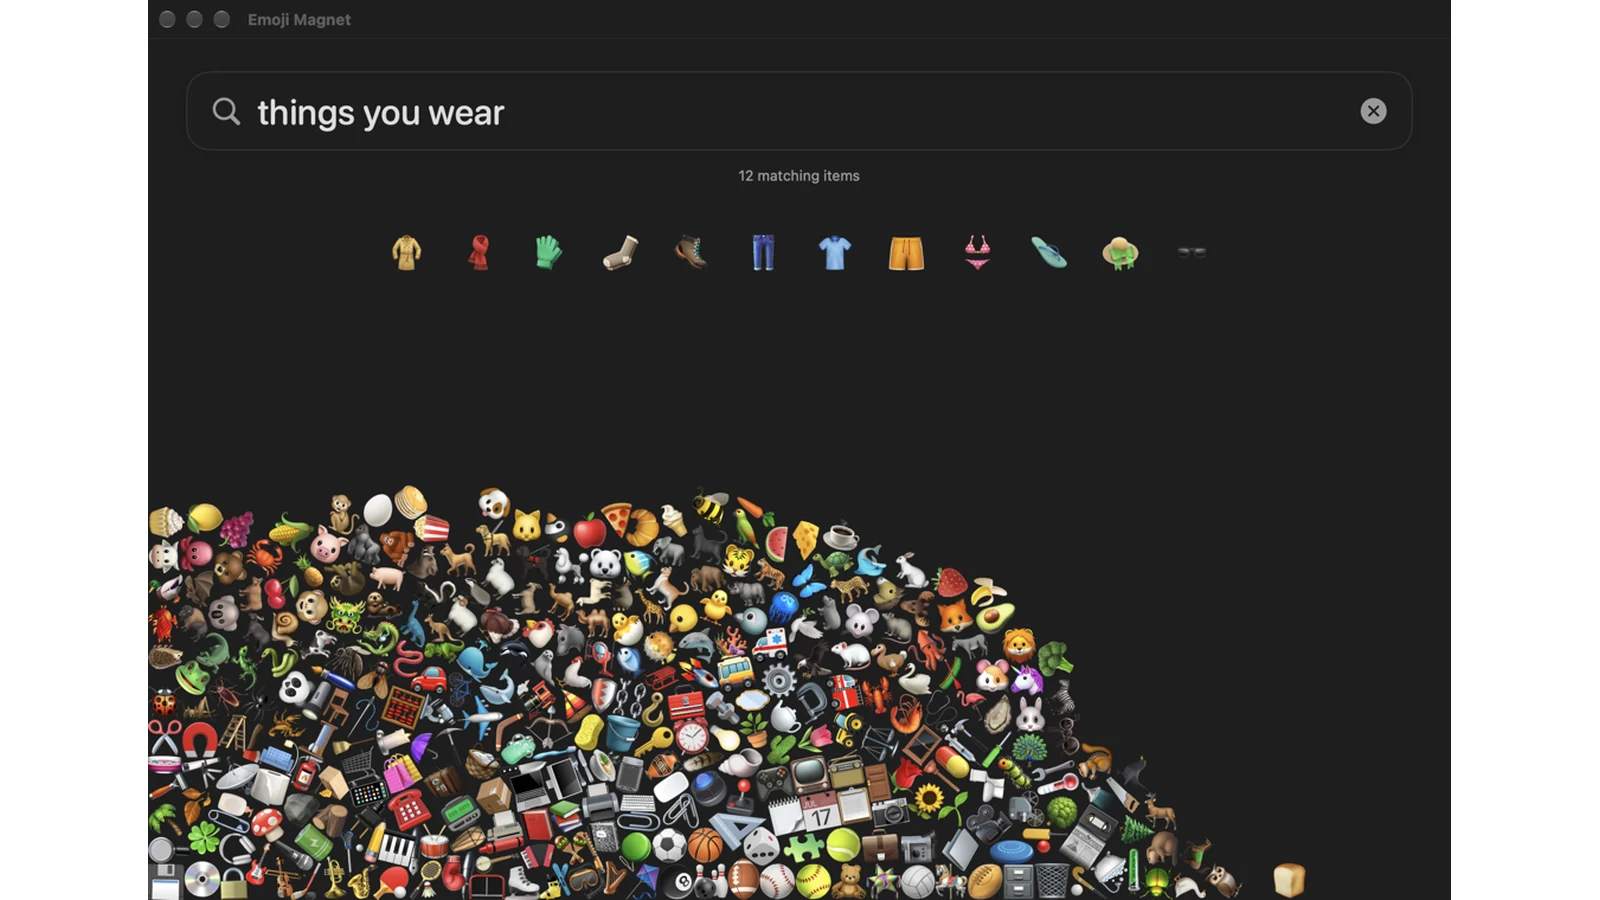 Przykładowa aplikacja Emoji Magnet Mattta używa AnyDecisionModel do sortowania emoji. Zrzut dokumentacji dostarczony przez autora, Apache 2.0; zmniejszony z dodanymi marginesami. Źródło obrazu · Licencja i informacje o obrazie.
Transkrypcja i decyzja o kierowaniu wymagają osobnych testów odbioru
Wyobraźmy sobie rozmówcę mówiącego: „Faktura jest błędna i nie mogę się zalogować, żeby ją pobrać”. Transkrypcja może odtworzyć zdanie poprawnie, a polityka kierowania nadal zawieść. Czy firma wyśle je do rozliczeń z powodu faktury, do wsparcia z powodu logowania, czy do ogólnej kolejki, bo występują oba problemy?
Odpowiedź zależy od polityki usługi. Model nie uzupełni brakującej reguły odpowiedzialności samą mocno preferowaną etykietą. Przed oceną dowolnego zaplecza zapisz znaczenie każdej opcji i zachowanie przy dopasowaniu kilku. To daje cel lepszy niż „wynik wyglądał rozsądnie”.
Rozdzielenie etapów ułatwia też diagnozowanie. Jeśli rozpoznawanie zmieni nazwę produktu, zachowaj transkrypcję i sprawdź, czy poprawne słowa zmieniłyby decyzję. Jeśli tekst jest trafny, ale zespół wybrano źle, zbadaj definicje opcji i model decyzyjny. To różne naprawy, a połączenie ukrywa źródło błędu.
Naszym zdaniem najcenniejszą abstrakcją jest granica między słyszeniem a wyborem. Każdy etap powinien tworzyć materiał, który następny może sprawdzić. Zespół produktu może wtedy zdecydować, co wykonywać automatycznie, a co pozostawić jako sugestię dla człowieka.
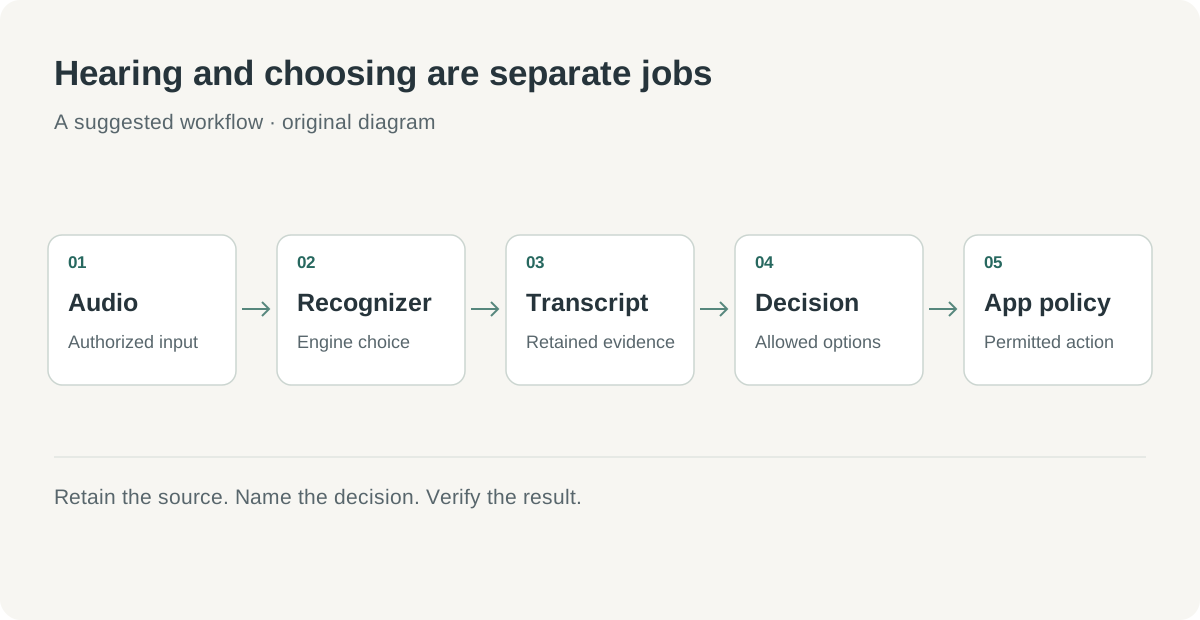 Autorski schemat: rozpoznawanie dostarcza dowodów, ograniczona decyzja — rozkładu, a aplikacja ustala dozwolone działanie.
Wybór silnika ma znaczenie, gdy zmienia się dźwięk aplikacji
README AnySpeechRecognizer, sprawdzone 2 listopada, opisuje API wzorowane na nowoczesnym frameworku Speech Apple, z opcjami Apple, Parakeet i Qwen3-ASR. Możliwości silników się różnią: opublikowane porównanie wymienia wyniki wstępne na żywo i znaczniki czasu słów dla niektórych ścieżek, podczas gdy Qwen3-ASR zwraca segmenty bez czasu słów. Pakiet wymaga Swift 6.2 lub nowszego oraz macOS albo iOS 26 lub nowszego, z dodatkowymi wymaganiami sprzętowymi poszczególnych modeli.
Różnica jest widoczna w projekcie produktu. Napisy na żywo korzystają z tekstu napływającego przed końcem wypowiedzi, ale muszą pokazywać, że wstępne słowa mogą się zmienić. Import pliku może priorytetowo traktować wynik końcowy i pozwolić użytkownikowi zaczekać na przetworzenie nagrania. Ten sam ekran transkrypcji nie powinien udawać identycznego zachowania czasowego obu trybów.
W przykładowej aplikacji wywiadów czas słów może być niezbędny, ponieważ dotknięcie zdania powinno przenosić do właściwego fragmentu nagrania. W przykładowej skrzynce głosowej mogą wystarczyć segmenty, bo zadaniem jest przegląd krótkiej wiadomości. Wybierz silnik po zdefiniowaniu interakcji, a potem testuj język, akcenty i warunki nagrań rzeczywistych odbiorców.
Tak samo traktuj obsługę języków. Lista języków to kontrola kwalifikacji, a zaszumione nagranie klienta — test odbioru. Udostępniaj oryginał uprawnionym recenzentom i zapewnij poprawianie ważnych nazw lub liczb. Poprawki są przydatnym dowodem przy decyzji o konfiguracji silnika lub lepszej interakcji odzyskiwania po błędzie.
Pakiet pozostawia też przechwytywanie dźwięku aplikacji. To użyteczna granica odpowiedzialności: aplikacja nadal odpowiada za zgodę na nagrywanie, wybór źródła i cykl przechwytywania. Biblioteki rozpoznawania nie należy mylić z kompletną funkcją nagrywania, zwłaszcza gdy interfejs musi obsłużyć przerwania, anulowanie i przedwczesne zakończenie.
Typowane decyzje zmniejszają pracę parsowania, nie odpowiedzialność
README AnyDecisionModel, sprawdzone 2 listopada, dokumentuje prawdopodobieństwa binarne, wybory spośród dozwolonych opcji i oceny na uporządkowanych skalach. Oferuje lokalne ścieżki MLX, Core AI i llama.cpp oraz zaplecza Jev i Ollama. API zwraca wyniki strukturalne, bez konieczności wydobywania etykiety z akapitu wyjaśnienia.
To może znacznie uprościć aplikację. Gdy dozwolonym wynikiem jest dział, kod może jawnie obsłużyć każdy dział. Gdy pytanie dotyczy konieczności kontroli wiadomości, wynik może zasilać politykę ze stanem oceny. Aplikacja nadal musi określić znaczenie „kontroli” i właściciela kolejki.
Przykładowa aplikacja zgłoszeń konserwacyjnych pokazuje różnicę. Pracownik nagrywa opis, rozpoznawanie tworzy tekst, a warstwa decyzyjna sugeruje kategorię sprzętu. Aplikacja może pokazać sugestię obok transkrypcji przed zapisem. Nie powinna po cichu przekształcać kategorii w ocenę bezpieczeństwa, zlecenie naprawy ani zgodę na eksploatację.
Uporządkowane oceny także potrzebują konkretnych definicji. Jeśli zespół pyta o pilność w trzech poziomach, każdy powinien opisywać działanie lub oczekiwanie obsługi. „Niska”, „średnia” i „wysoka” są łatwe do wyświetlenia, ale trudne do oceny, gdy recenzenci rozumieją je różnie. Krótkie pisemne kryteria ujawniają rozbieżności, zanim staną się problemami treningu lub progów.
| Podejście | Co otrzymuje aplikacja | Kiedy pomaga | Główne pytanie oceny |
|---|---|---|---|
| Otwarta generacja | Tekst, czasem z uzasadnieniem | Użytkownik potrzebuje wyjaśnienia lub szkicu | Czy treść jest poprawna i użyteczna? |
| Ograniczony wybór | Wybrana dozwolona opcja i rozkład | Aplikacja ma zdefiniowane kategorie | Czy wybór odpowiada polityce kategorii? |
| Uporządkowana ocena | Rozkład między zdefiniowanymi poziomami | Aplikacja ma sensowne kryteria rankingu | Czy poziomy odpowiadają zamierzonemu działaniu? |
| Ocena człowieka | Zapisana decyzja osoby | Brakuje kontekstu lub skutki wymagają osądu | Czy recenzent ma wystarczające dowody? |
Porównanie dotyczy projektu interfejsu, nie twierdzenia, że jedna technika zawsze wygrywa. Niektóre ekrany potrzebują ograniczonego wyboru i krótkiego wyjaśnienia. Oddziel wyjaśnienie od dowodów i pozwól edytować decyzję, gdy umożliwia to proces.
Pewność opisuje rozkład, nie gwarancję trafności
README AnyDecisionModel wprowadza szczególnie przydatne rozróżnienie: lokalna pewność mierzy koncentrację rozkładu odpowiedzi, nie prawdopodobieństwo poprawności wybranej odpowiedzi. Ostrzega też przed porównywaniem pewności różnych mechanizmów, jakby korzystały z jednego wzoru. Kalibrację należy dopasowywać osobno od danych oceny. Dokumentacja projektu, sprawdzona 2 listopada 2026 r..
Załóżmy, że przykładowy test zwraca jeden dział z prawdopodobieństwem 0,90 i rozdziela resztę między inne. To mówi, że model preferował ten dział przy otrzymanym pytaniu i opcjach. Nie dowodzi 90-procentowej historycznej skuteczności dla takiej wiadomości klienta. Kategorie mogą być źle zdefiniowane, wejście może pomijać ważny kontekst lub model systematycznie preferować jedną opcję.
Przydatna polityka produktu potrzebuje więc jawnej ścieżki „wstrzymaj do oceny”. Zacznij od pokazywania wszystkich decyzji recenzentom i zbierania poprawek. Potem sprawdź, czy jakiś podzbiór jest wystarczająco niezawodny do wąsko określonego działania automatycznego. Próg powinien wynikać z obserwowanych błędów i ich kosztu, nie z pozornie przekonującej liczby.
Zestaw oceny powinien zawierać niejednoznaczne wiadomości, nieznane nazwy i przypadki niepasujące do żadnego działu. System może wyglądać dobrze, gdy każdy przykład ma czystą kategorię, a potem zawodzić na mieszanych prośbach dominujących w prawdziwym wsparciu. Niech recenzenci zapisują powód zmiany wyboru, aby odróżnić błąd modelu od brakującej polityki.
Zbadaj też koszt każdego kierunku błędu. Wysłanie rutynowej prośby do kontroli kosztuje czas; ciche skierowanie wrażliwej prośby do niewłaściwych osób może mieć inne konsekwencje. Jedna średnia to ukrywa. Raportuj przypadki ważne dla właścicieli produktu, a potem wybierz politykę, którą wyjaśnią użytkownikom i opiekunom.
Dlatego zmiana zaplecza jest zmianą produktu. To samo wywołanie Swift może ukrywać inne zachowanie, znaczenie liczb i zależności operacyjne. Powtórz ocenę przed przeniesieniem starego progu do nowej konfiguracji. Zachowaj identyfikator modelu, konfigurację i definicje opcji przy wyniku, aby później wyjaśnić powstanie decyzji.
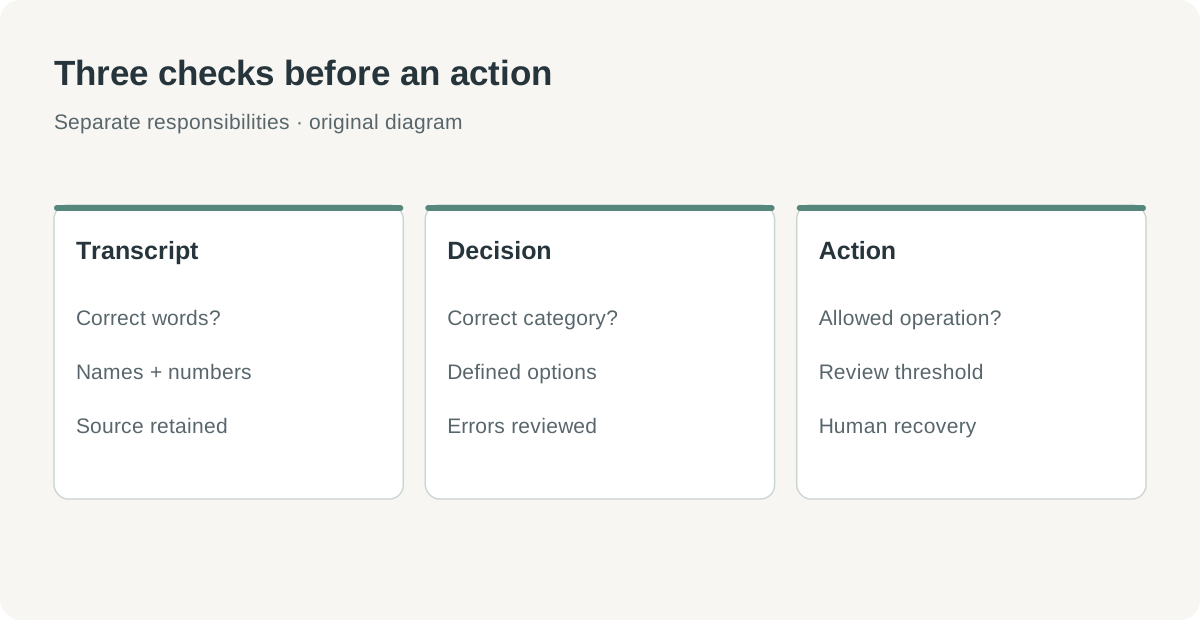 Autorski schemat: silna preferencja nie usuwa potrzeby oceny poprawności i określenia polityki działania. Pewność i trafność odpowiadają na różne pytania.
Lokalność zmienia obowiązki zespołu
Uruchamianie modelu na urządzeniu może być atrakcyjne dla skrzynki głosowej lub narzędzia referencyjnego offline. Zespół może projektować wokół lokalnych wejść i przewidywalnej granicy sieciowej. Jednak pobieranie modeli, zgodność sprzętu, pamięć i pierwsza konfiguracja stają się widoczną częścią doświadczenia. Obietnica prywatności powinna opisywać całą drogę, włącznie z ewentualnym później dodanym etapem hostowanym.
Hostowane zaplecze decyzyjne przenosi część pracy operacyjnej do usługi, ale wprowadza sieć, poświadczenia i dostępność usługi do procesu. Użytkownik potrzebuje zrozumiałego stanu po błędzie lub podczas oczekiwania. Ponowienie powinno zachować pierwotną transkrypcję i nie powtarzać przypadkowo już ukończonego działania dalej w procesie.
Obecna dokumentacja rozróżnia też testowaną zgodność od weryfikacji działającej usługi. AnyDecisionModel podaje, że testy zgodności protokołu Jev i Ollama używają stałych danych testowych. To cenne pokrycie, ale dostarczana aplikacja nadal powinna zweryfikować wybraną konfigurację usługi od początku do końca. README AnyDecisionModel, sprawdzone 2 listopada.
Nie obiecuj identycznej wydajności na Macu dewelopera i najmniejszym obsługiwanym telefonie. Cel wdrożenia określa zamierzone miejsce działania kodu; nie dostarcza pomiarów opóźnień, baterii i pamięci każdego urządzenia. Aplikacja może zacząć od plików na jednej sprawdzonej maszynie, a rozszerzać wsparcie po zaliczeniu interakcji na kolejnym sprzęcie.
Zacznij od procesu plikowego możliwego do sprawdzenia
Pierwszy pilotaż powinien ułatwiać badanie błędów. Mała aplikacja plikowa często daje jaśniejszy początek niż asystent na żywo, bo dozwolone nagranie można odtwarzać i porównywać. Celem jest potwierdzenie etapów i przekazania przed dodaniem czasu rzeczywistego.
- Zdefiniuj jedno zadanie z krótką listą decyzji i pisemną regułą dla niejednoznaczności. Uwzględnij opcję oceny w polityce aplikacji.
- Sprawdź bieżące wymagania i dodaj właściwą zależność pakietu Swift. Wybierz jeden silnik rozpoznawania i jedno zaplecze decyzji zamiast kwalifikować wszystkie kombinacje naraz.
- Zaimportuj mały zbiór nagrań, do których masz uprawnienia. Oryginały, oczekiwane transkrypcje i decyzje recenzentów przechowuj osobno.
- Jawnie zainstaluj lub przygotuj wymagane zasoby modeli zgodnie z dokumentacją. Pokaż przygotowanie i przetwarzanie jako odrębne stany interfejsu.
- Uruchom rozpoznawanie, zachowaj końcowy tekst i zadaj ograniczone pytania o ten tekst. Pokaż wynik przy źródle zamiast od razu wykonywać działanie zewnętrzne.
- Oceń błędy według etapów, a po zmianach sprawdź osobny zbiór nagrań. Zapisuj konfigurację przy każdym wyniku.
- Dodaj obsługę anulowania, niedostępnego modelu i awarii sieci przed przejściem do nagrywania na żywo lub automatycznego routingu.
Kryterium sukcesu powinno być zrozumiałe dla właściciela produktu. Pilotaż skrzynki głosowej może na przykład wymagać odnalezienia nagrania źródłowego, poprawienia transkrypcji i zmiany sugerowanej kolejki bez utraty oryginałów. To użyteczny wynik procesu jeszcze przed decyzją o automatyzacji.
Małe decyzje też zasługują na kompletny projekt produktu
Pakiety proponują atrakcyjną architekturę: jeden komponent słucha, drugi wybiera, a kod aplikacji egzekwuje dozwolone działanie. Powstają miejsca pomiaru jakości i odzyskiwania po awarii. Łatwiej też rozmawiać o granicach liczbowej odpowiedzi z osobami, które muszą jej zaufać.
Warto sprawdzić łatwość utrzymania. Czy zespół wymieni rozpoznawanie bez przepisywania aplikacji? Czy oceni nowe zaplecze decyzji bez udawania, że stare progi nadal obowiązują? Czy użytkownik poprawi wynik dokładnie tam, gdzie wystąpił błąd?
Mały model pomaga, gdy jego zadanie jest jasne, a wynik ma odpowiedzialnego właściciela. Abstrakcja Swift łączy części; polityka decyzyjna produktu nadaje im cel.
Źródła
- Mattt: przedstawiamy AnySpeechRecognizer i AnyDecisionModel, 29 października 2026 r.
- AnySpeechRecognizer: wymagania, porównanie silników i przykłady, sprawdzono 2 listopada 2026 r.
- AnyDecisionModel: zaplecza, kalibracja i ograniczenia, sprawdzono 2 listopada 2026 r. Licencje kodu pakietów i poszczególnych modeli wymagają oddzielnego rozpatrzenia.
- Mattt: dokumentacja i zrzut Emoji Magnet, dokumentacja Apache-2.0; sprawdzono 2 listopada 2026 r.
Zachowaj powiązanie decyzji implementacyjnej ze źródłem
Telli.sh to jedna z możliwości przechowywania materiałów źródłowych, do których masz uprawnienia, i notatek stojących za decyzją implementacyjną. Utwórz przestrzeń na notatki.