AnyDecisionModel e AnySpeechRecognizer separano l'ascolto dalle scelte di un'app Swift
Due pacchetti Swift di terze parti collegano motori vocali e decisioni tipizzate. Dove aiuta l'inferenza locale, perché la confidenza va calibrata e come avviare una prova applicativa circoscritta.
Una registrazione di assistenza contiene due problemi diversi. Prima, un'applicazione deve ricostruire ciò che il chiamante ha detto. Poi deve decidere se la richiesta spetti alla fatturazione, all'assistenza tecnica o a un altro team. Trattare entrambi come un'unica conversazione aperta rende meno visibili le responsabilità dell'app.
Lo sviluppatore Mattt ha presentato AnySpeechRecognizer e AnyDecisionModel il 29 ottobre 2026. Sono pacchetti Swift di terze parti per sviluppatori delle piattaforme Apple: uno offre una scelta di motori di riconoscimento vocale, l'altro restituisce scelte tipizzate e distribuzioni di probabilità. Si basano su schemi familiari di Swift, ma non sono annunci di prodotti Apple. L'introduzione di Mattt spiega i due compiti attraverso lo stesso esempio di chiamata all'assistenza.
Lo sviluppo interessante è la possibilità di scegliere e valutare separatamente questi compiti. Questa guida spiega il contributo dei pacchetti, come i sistemi locali e ospitati cambino il progetto dell'app e perché un valore numerico di confidenza richieda comunque una politica di prodotto.
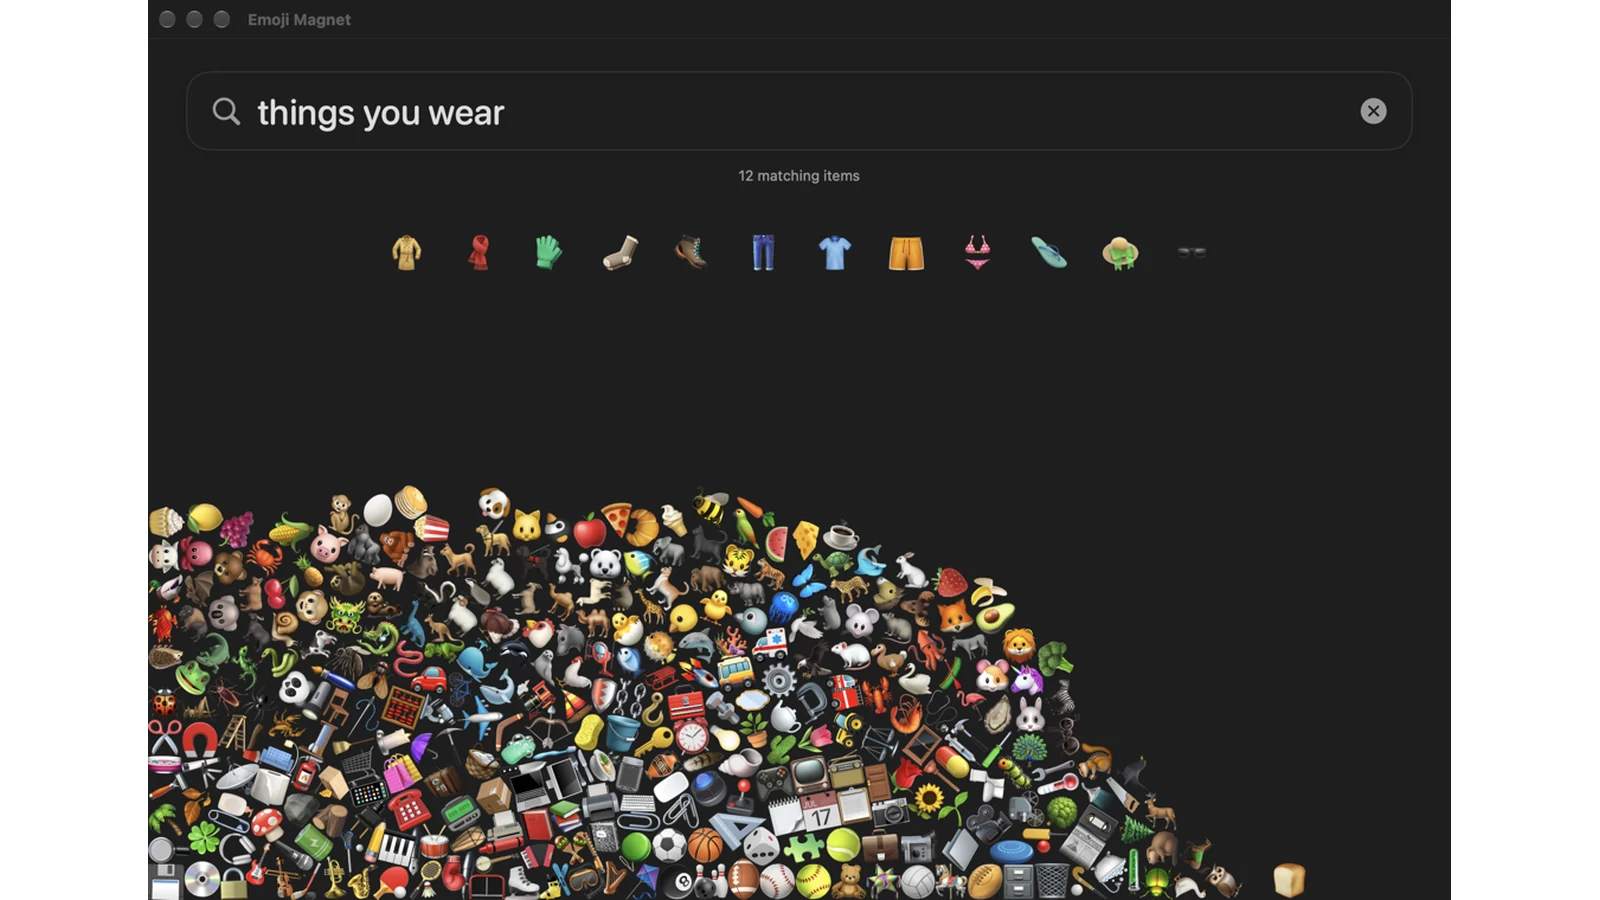 L'app di esempio Emoji Magnet di Mattt usa AnyDecisionModel per ordinare le emoji. Schermata della documentazione fornita dall'autore, Apache 2.0; ridimensionata con margini. Fonte dell'immagine · Licenza e note sull'immagine.
Trascrizione e instradamento richiedono test di accettazione separati
Immagina un chiamante che dica: «La fattura è sbagliata e non riesco ad accedere per scaricarla». Una trascrizione può riprodurre correttamente la frase mentre la politica di instradamento fallisce comunque. L'azienda la invia alla fatturazione per via della fattura, all'assistenza tecnica per il problema di accesso oppure a una coda generale perché sono presenti entrambi?
La risposta dipende dalla politica del servizio. Un modello non può fornire una regola di responsabilità mancante restituendo semplicemente un'etichetta nettamente preferita. Prima di valutare qualsiasi sistema, scrivi che cosa significhi ogni opzione ammessa e che cosa debba accadere quando ne corrispondono più di una. Questo offre all'app un obiettivo più utile di «il risultato sembrava sensato».
Separare le fasi facilita anche la diagnosi degli errori. Se il riconoscitore cambia il nome di un prodotto, conserva la trascrizione e verifica se la decisione sarebbe cambiata con le parole corrette. Se la trascrizione è accurata ma il team scelto è sbagliato, esamina definizioni delle opzioni e modello decisionale. Sono correzioni diverse e combinarle nasconde l'origine dell'errore.
La nostra lettura è che l'astrazione più preziosa sia un confine fra ascoltare e scegliere. Ogni fase dovrebbe produrre un artefatto esaminabile dalla successiva. Il team di prodotto può quindi decidere quali fasi meritino esecuzione automatica e quali debbano restare suggerimenti per una persona.
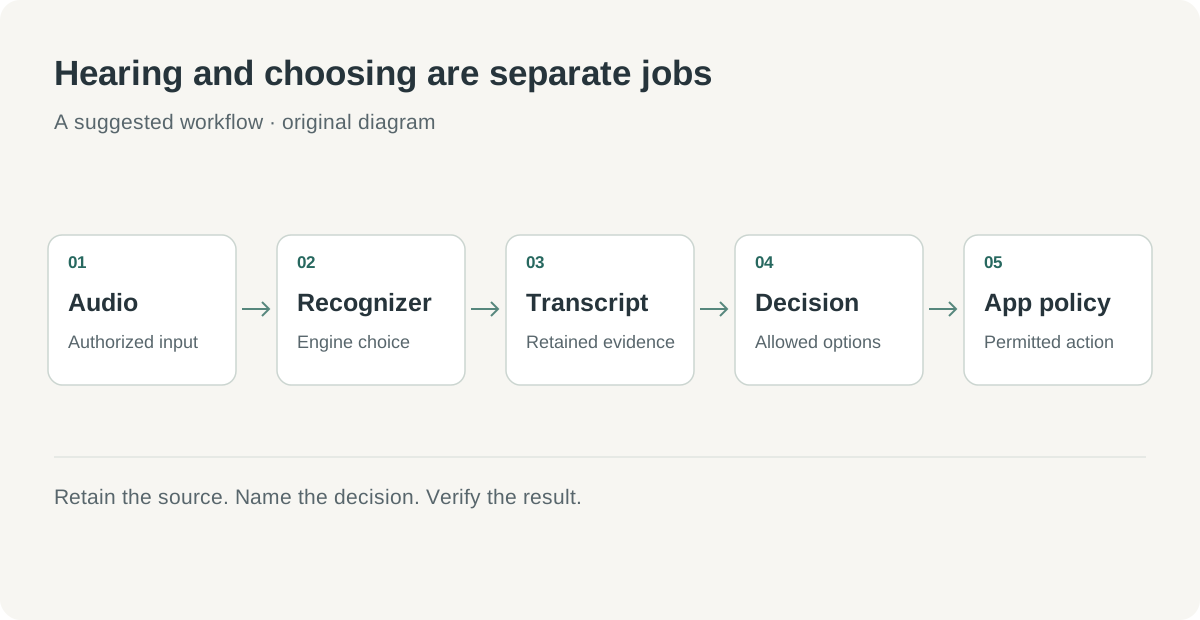 Diagramma originale del flusso: il riconoscimento fornisce le prove; una decisione circoscritta fornisce una distribuzione; l'applicazione stabilisce quale azione sia consentita.
La scelta del motore conta quando cambia l'audio dell'app
Il README di AnySpeechRecognizer, consultato il 2 novembre, descrive un'API modellata sul moderno framework Speech di Apple, con opzioni Apple, Parakeet e Qwen3-ASR. Le capacità dei motori differiscono: il confronto pubblicato elenca risultati provvisori in tempo reale e temporizzazione delle parole per alcuni percorsi, mentre Qwen3-ASR fornisce risultati per segmento senza tempi delle parole. Il pacchetto richiede Swift 6.2 o successivo e macOS o iOS 26 o successivo, con ulteriori requisiti hardware per particolari modelli.
Questa differenza è visibile nel progetto del prodotto. Una visualizzazione di sottotitoli dal vivo beneficia del testo che arriva prima che la persona finisca di parlare, ma deve mostrare che le parole provvisorie possono cambiare. Un flusso di importazione di file può dare priorità ai risultati finali e far attendere il completamento dell'elaborazione. La stessa schermata di trascrizione non dovrebbe fingere che le due modalità abbiano tempi identici.
Per un'app illustrativa di interviste, i tempi delle parole possono essere essenziali perché toccare una frase dovrebbe portare al punto pertinente della registrazione. Per un'app illustrativa di messaggi vocali, può bastare una trascrizione per segmenti, perché il compito principale è rivedere un breve messaggio. Scegli il motore dopo aver definito l'interazione, poi provalo con lingue, accenti e condizioni di registrazione realmente usati dal pubblico.
Il supporto linguistico merita lo stesso trattamento. Un elenco di lingue supportate è un controllo di idoneità, mentre una registrazione rumorosa di un cliente è un test di accettazione. Mantieni l'audio originale disponibile ai revisori autorizzati e offri un modo per correggere nomi o numeri importanti. Le correzioni sono prove utili per decidere se il riconoscitore necessiti di un'altra configurazione o se il prodotto debba offrire un recupero migliore.
Il pacchetto lascia inoltre all'applicazione l'acquisizione audio. È una linea utile di responsabilità: l'app resta responsabile di autorizzazione alla registrazione, scelta della sorgente e ciclo di vita dell'acquisizione. Una libreria di riconoscimento non equivale a un'intera funzione di registrazione, soprattutto quando l'interfaccia deve gestire interruzioni, annullamento e un utente che si ferma prima.
Le decisioni tipizzate riducono l'interpretazione del testo, non la responsabilità
Il README di AnyDecisionModel, consultato il 2 novembre, documenta probabilità binarie, scelte fra opzioni ammesse e punteggi su scale ordinate. Offre percorsi locali MLX, Core AI e llama.cpp, oltre a Jev e Ollama. L'API restituisce risultati strutturati, senza costringere l'applicazione a recuperare un'etichetta da un paragrafo esplicativo.
Questo può semplificare notevolmente un'app. Quando il risultato ammesso è un reparto, il codice applicativo può gestire esplicitamente ogni reparto. Quando la domanda è se un messaggio richieda revisione, il risultato può alimentare una politica con uno stato di revisione. L'app deve comunque definire che cosa significhi «revisione» e chi sia responsabile della coda.
Un'app illustrativa di segnalazioni di manutenzione chiarisce la distinzione. Un lavoratore registra una descrizione, il riconoscitore produce testo e il livello decisionale suggerisce una fra più categorie di attrezzatura. L'applicazione può mostrare il suggerimento accanto alla trascrizione prima del salvataggio. Non dovrebbe trasformarlo silenziosamente in una valutazione di sicurezza, un ordine di riparazione o un permesso di usare l'attrezzatura.
Anche i punteggi ordinati richiedono definizioni concrete. Se un team chiede l'urgenza su una scala di tre livelli, ogni livello dovrebbe descrivere un'azione o un'aspettativa di servizio. «Bassa», «media» e «alta» sono etichette facili da mostrare ma difficili da valutare quando i revisori le interpretano diversamente. Una breve griglia scritta rende visibili i disaccordi prima che diventino problemi di addestramento o soglia.
| Approccio | Che cosa riceve l'applicazione | Utile quando | Domanda principale di valutazione |
|---|---|---|---|
| Generazione aperta | Testo che può includere una motivazione | L'utente necessita di una spiegazione o una bozza | Il contenuto è corretto e utilizzabile? |
| Scelta circoscritta | Un'opzione ammessa selezionata e una distribuzione | L'app ha categorie definite | La scelta segue la politica delle categorie? |
| Punteggio ordinato | Una distribuzione su livelli definiti | L'app ha una griglia di ordinamento significativa | I livelli corrispondono all'azione prevista? |
| Revisione umana | La decisione registrata di una persona | Il contesto è incompleto o le conseguenze richiedono giudizio | Il revisore riceve prove sufficienti? |
Il confronto riguarda il progetto dell'interfaccia, non afferma che una tecnica vinca sempre. Alcune schermate hanno bisogno sia di una scelta circoscritta sia di una spiegazione concisa. Mantieni distinguibile la spiegazione dalle prove e lascia modificabile la decisione quando il flusso lo consente.
La confidenza descrive una distribuzione, non garantisce l'accuratezza
Il README di AnyDecisionModel introduce una distinzione particolarmente utile: la confidenza locale misura quanto sia concentrata la distribuzione delle risposte, non la probabilità che la risposta scelta sia corretta. Avverte anche di non confrontare valori di confidenza di sistemi diversi come se condividessero la stessa formula. La calibrazione va adattata separatamente dai dati di valutazione. Documentazione del progetto, consultata il 2 novembre 2026.
Supponi che un test illustrativo restituisca un reparto con probabilità 0,90 e distribuisca il resto fra altri reparti. Questo dice che il modello ha favorito quel reparto con la domanda e le opzioni ricevute. Non dimostra un tasso storico di successo del 90% per quel tipo di messaggio. Le definizioni delle categorie possono essere scadenti, l'input può omettere contesto cruciale oppure il modello può preferire sistematicamente un'opzione.
Una politica di prodotto utile richiede quindi un percorso esplicito «trattieni per revisione». Inizia rendendo tutte le decisioni visibili ai revisori e raccogliendo le correzioni. Poi valuta se un sottoinsieme sia abbastanza affidabile per un'azione automatica definita in modo ristretto. La soglia deriva dagli errori osservati e dal loro costo, non da un numero scelto perché sembra sicuro.
L'insieme di valutazione dovrebbe contenere messaggi ambigui, nomi insoliti e casi in cui nessuno dei reparti disponibili sia adatto. Un sistema può apparire forte quando ogni esempio appartiene chiaramente a una categoria, poi fallire sulle richieste miste che dominano l'assistenza reale. Fai registrare ai revisori perché hanno cambiato una scelta, così che il team distingua una risposta errata da una politica mancante.
Esamina anche il costo di ogni direzione d'errore. Inviare una richiesta ordinaria in revisione consuma tempo; instradare silenziosamente una richiesta sensibile al pubblico sbagliato può avere conseguenze diverse. Un singolo punteggio medio nasconde questa differenza. Riporta i casi importanti per i responsabili del prodotto, poi scegli una politica d'azione che possano spiegare a utenti e manutentori.
È anche per questo che cambiare sistema è una modifica del prodotto. La stessa chiamata Swift può nascondere comportamenti, semantiche numeriche e dipendenze operative diversi. Ripeti la valutazione prima di trasferire una vecchia soglia in una nuova configurazione. Conserva identificatore del modello, configurazione e definizioni delle opzioni insieme al risultato, così che una revisione successiva possa spiegarne la produzione.
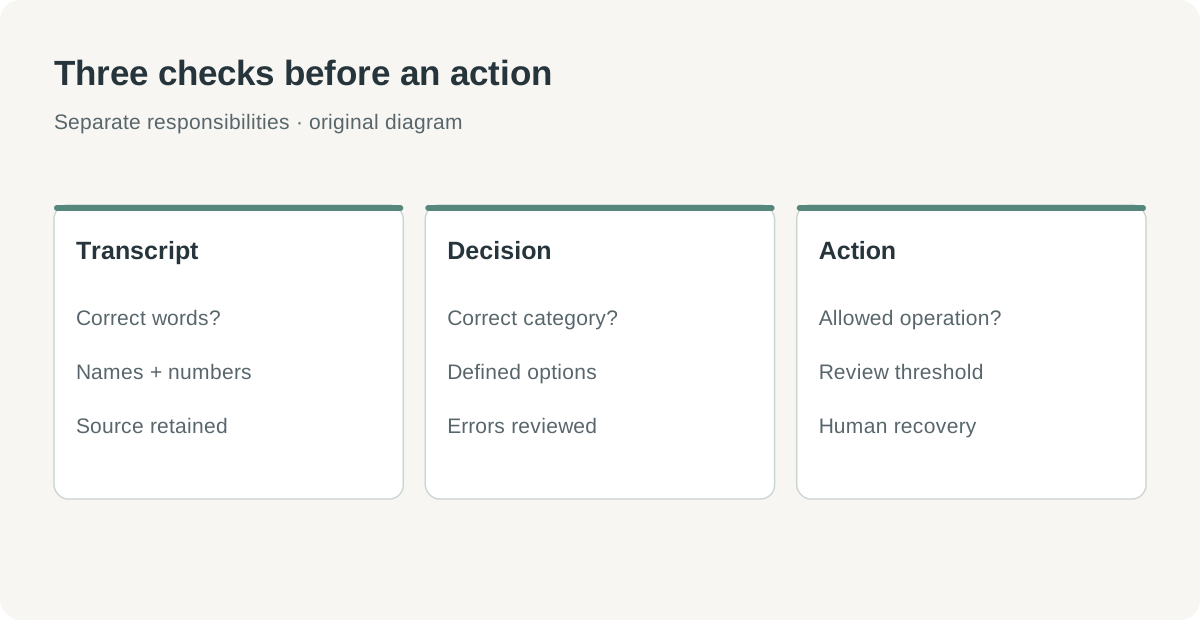 Diagramma originale: una forte preferenza non elimina la necessità di valutare la correttezza o definire una politica d'azione. Confidenza e accuratezza rispondono a domande diverse.
Il funzionamento locale cambia il lavoro di cui risponde il team
Eseguire un modello sul dispositivo può essere interessante per una casella vocale o uno strumento di consultazione offline. Il team può progettare intorno a input conservati localmente e a un confine di rete prevedibile. Ma scaricamento dei modelli, hardware supportato, memoria e preparazione iniziale diventano parti visibili dell'esperienza utente. Una promessa di riservatezza dovrebbe descrivere l'intero percorso, compresa qualsiasi fase ospitata aggiunta in seguito.
Un sistema decisionale ospitato trasferisce parte del lavoro operativo a un servizio, introducendo al contempo rete, credenziali e disponibilità del servizio nel flusso. L'utente ha bisogno di uno stato comprensibile quando una richiesta fallisce o rimane in sospeso. Riprovare dovrebbe conservare la trascrizione originale e non ripetere accidentalmente un'azione a valle già completata.
La documentazione attuale distingue anche compatibilità verificata e verifica di un servizio attivo. AnyDecisionModel afferma che i test di compatibilità del protocollo per Jev e Ollama usano dati di prova. È una copertura preziosa, ma un'app da distribuire dovrebbe comunque verificare da un capo all'altro la configurazione del servizio scelto. README di AnyDecisionModel, controllo del 2 novembre.
Evita di promettere prestazioni identiche fra il Mac di uno sviluppatore e il telefono minimo supportato. Un obiettivo di distribuzione indica dove si intende eseguire il codice; non fornisce prove di latenza, batteria o memoria per ogni dispositivo. Un'app può iniziare elaborando file su una macchina qualificata, poi ampliare il supporto dopo che l'interazione prevista supera le prove su altro hardware.
Inizia con un flusso su file che si possa esaminare
Una prima prova pilota dovrebbe rendere facile esaminare gli errori. Una piccola applicazione basata su file è spesso un punto di partenza più chiaro di un assistente dal vivo, perché lo stesso audio autorizzato può essere riascoltato e confrontato. L'obiettivo è dimostrare le fasi e il loro passaggio prima di aggiungere l'interazione in tempo reale.
- Definisci un compito con un breve elenco di decisioni ammesse e una regola scritta per i casi ambigui. Includi un'opzione di revisione nella politica applicativa.
- Controlla i requisiti attuali e aggiungi la dipendenza del pacchetto Swift pertinente. Seleziona un motore di riconoscimento e un sistema decisionale, anziché qualificare tutte le combinazioni insieme.
- Importa un piccolo insieme di registrazioni autorizzate. Conserva file originali, trascrizioni attese e decisioni dei revisori in registrazioni separate.
- Installa o prepara esplicitamente i materiali del modello richiesti, seguendo la documentazione. Mostra preparazione ed elaborazione come stati distinti dell'interfaccia.
- Esegui il riconoscimento, conserva il testo finale e poni le domande circoscritte su quel testo. Mostra il risultato accanto alla fonte anziché eseguire subito un'azione esterna.
- Esamina gli errori per fase, poi valuta un insieme separato di registrazioni dopo le modifiche. Registra la configurazione con ogni risultato.
- Aggiungi comportamenti per annullamento, modello indisponibile ed errore di rete prima di passare ad acquisizione dal vivo o instradamento automatico.
Il criterio di successo dovrebbe essere comprensibile a un responsabile di prodotto. Per esempio, una prova di casella vocale potrebbe richiedere che un revisore trovi la registrazione originale, corregga la trascrizione e cambi la coda suggerita senza perdere materiale originale. È un risultato utile del flusso anche prima di decidere se automatizzare qualcosa.
Anche le piccole decisioni meritano un progetto di prodotto completo
Questi pacchetti propongono un'architettura interessante: un componente per ascoltare, un altro per scegliere e codice applicativo per far rispettare l'azione consentita. Si creano punti in cui misurare la qualità e recuperare dagli errori. Diventa anche più facile discutere i limiti di una risposta numerica con le persone che devono fidarsene.
L'aspettativa da verificare è la manutenibilità. Un team può sostituire un riconoscitore senza riscrivere tutta l'app? Può valutare un nuovo sistema decisionale senza fingere che le vecchie soglie restino valide? Gli utenti possono correggere il risultato nel punto in cui si è realmente verificato l'errore?
Un piccolo modello diventa utile quando il suo compito è chiaro e il risultato ha un responsabile. L'astrazione Swift aiuta a collegare le parti; la politica decisionale del prodotto dà loro uno scopo.
Fonti
- Mattt: presentazione di AnySpeechRecognizer e AnyDecisionModel, 29 ottobre 2026.
- AnySpeechRecognizer: requisiti, confronto fra motori ed esempi, consultato il 2 novembre 2026.
- AnyDecisionModel: sistemi supportati, calibrazione e limiti, consultato il 2 novembre 2026. Le licenze del codice dei pacchetti e quelle dei singoli modelli richiedono considerazioni separate.
- Mattt: documentazione e schermata di Emoji Magnet, documentazione Apache-2.0; consultata il 2 novembre 2026.
Mantieni una decisione di implementazione collegata alla fonte
Telli.sh è un'opzione per conservare il materiale di partenza autorizzato e gli appunti alla base di una decisione di implementazione. Crea uno spazio per gli appunti.