AnyDecisionModel et AnySpeechRecognizer séparent l’écoute des choix dans une app Swift
Deux packages Swift tiers relient moteurs vocaux et décisions typées. L’intérêt de l’inférence locale, le besoin de calibrer la confiance et les étapes d’un pilote applicatif délimité.
Un enregistrement d’assistance contient deux problèmes distincts. L’application doit d’abord retrouver ce qu’a dit l’appelant. Elle doit ensuite décider si la demande relève de la facturation, de l’assistance technique ou d’une autre équipe. Traiter les deux comme une conversation ouverte rend moins visibles les responsabilités de l’application.
Le développeur Mattt a présenté AnySpeechRecognizer et AnyDecisionModel le 29 octobre 2026. Ce sont des packages Swift tiers destinés aux développeurs des plateformes Apple : l’un propose plusieurs moteurs de reconnaissance vocale, l’autre renvoie des choix typés et des distributions de probabilités. Ils reposent sur des modèles de conception Swift familiers sans constituer des annonces de produits Apple. La présentation de Mattt explique les deux tâches avec le même exemple d’appel d’assistance.
L’évolution intéressante est de pouvoir choisir et évaluer ces tâches séparément. Ce guide explique l’apport des packages, l’effet des moteurs locaux et hébergés sur la conception d’une app et la raison pour laquelle une confiance numérique exige toujours une politique produit.
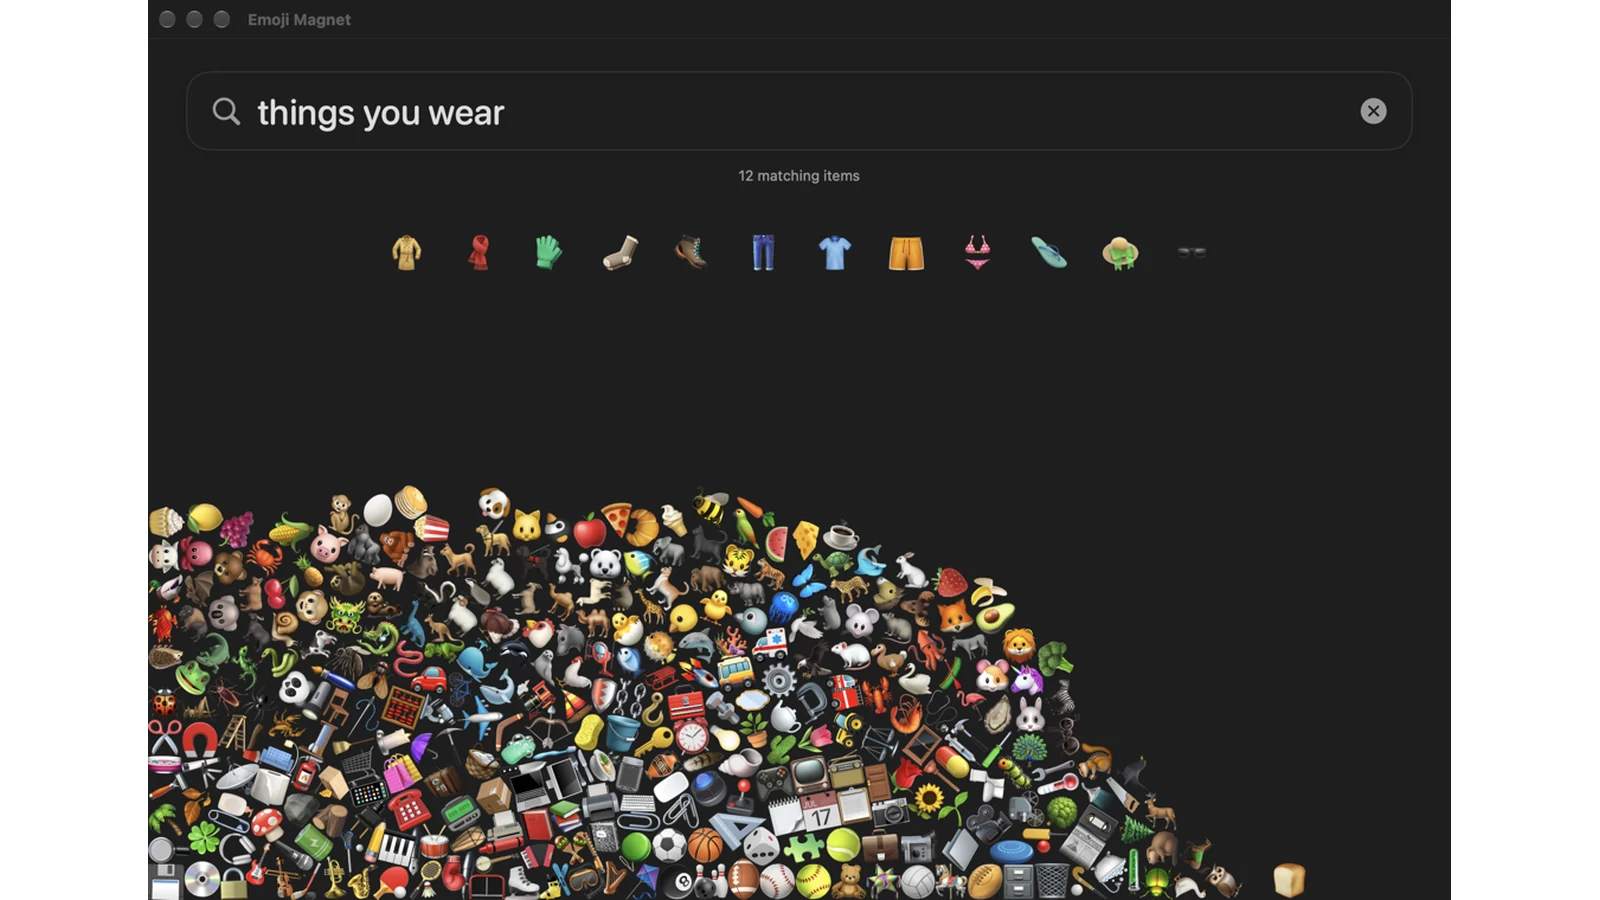 L’application d’exemple Emoji Magnet de Mattt utilise AnyDecisionModel pour classer des emoji. Capture de documentation fournie par l’auteur, Apache 2.0 ; redimensionnée avec des marges. Source de l’image · Licence et précisions sur l’image.
Transcription et orientation exigent des tests d’acceptation distincts
Imaginons qu’un appelant dise : « La facture est fausse et je n’arrive pas à me connecter pour la télécharger. » La transcription peut reproduire correctement cette phrase tandis que la politique d’orientation échoue. L’entreprise transmet-elle la demande à la facturation à cause de la facture, à l’assistance technique à cause de la connexion ou à une file générale parce que les deux sont présents ?
La réponse dépend de la politique du service. Un modèle ne peut pas fournir une règle de responsabilité manquante simplement en privilégiant fortement une étiquette. Avant d’évaluer un moteur, définissez par écrit chaque option autorisée et ce qui doit se passer lorsque plusieurs conviennent. Cela donne à l’app un objectif plus utile que « la sortie semblait raisonnable ».
Séparer les étapes facilite aussi le diagnostic des erreurs. Si la reconnaissance modifie un nom de produit, conservez cette transcription et vérifiez si la décision aurait changé avec les bons mots. Si la transcription est exacte mais l’équipe choisie incorrecte, examinez les définitions des choix et le modèle de décision. Ce sont des réparations différentes ; les réunir cache la source de l’échec.
Notre avis est que l’abstraction la plus précieuse est ici la frontière entre entendre et choisir. Chaque étape doit produire un élément inspectable par la suivante. L’équipe produit peut alors déterminer quelles étapes méritent une exécution automatique et lesquelles doivent rester des suggestions pour une personne.
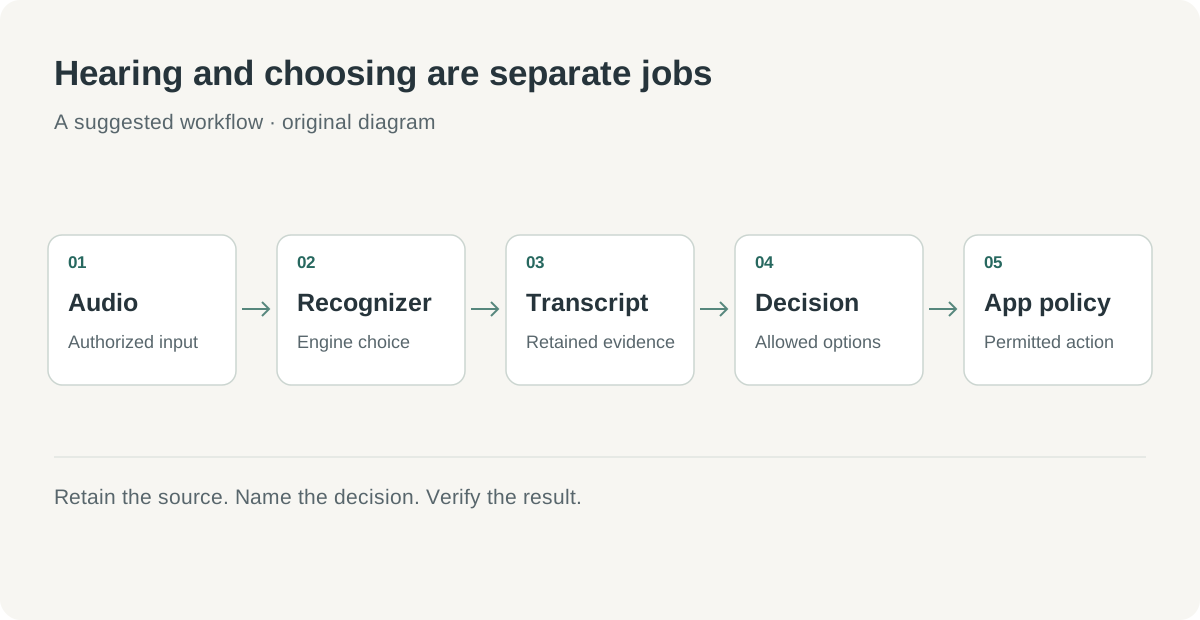 Schéma de processus original : la reconnaissance fournit des éléments probants ; une décision délimitée fournit une distribution ; l’application détermine l’action autorisée.
Le choix du moteur compte lorsque l’audio de l’app change
Le README d’AnySpeechRecognizer, consulté le 2 novembre, décrit une API inspirée du framework Speech moderne d’Apple, avec des options Apple, Parakeet et Qwen3-ASR. Les capacités diffèrent : la comparaison publiée indique des résultats provisoires en direct et un minutage par mot pour certains parcours, tandis que Qwen3-ASR fournit des résultats par segment sans minutage par mot. Le package nécessite Swift 6.2 ou version ultérieure et macOS ou iOS 26 ou version ultérieure, avec des exigences matérielles supplémentaires pour certains modèles.
Cette différence est visible dans la conception du produit. Un affichage de sous-titres en direct bénéficie de l’arrivée du texte avant la fin de la prise de parole, mais doit signaler que les mots provisoires peuvent changer. Un parcours d’importation peut privilégier le résultat final et laisser l’utilisateur attendre la fin du traitement. Le même écran de transcription ne doit pas faire croire que les deux modes suivent un rythme identique.
Dans une app d’entretien illustrative, le minutage par mot peut être essentiel : toucher une phrase doit déplacer la lecture vers le passage correspondant de l’enregistrement. Dans une messagerie vocale illustrative, une transcription par segment peut suffire, car la tâche principale consiste à vérifier un court message. Choisissez le moteur après avoir défini cette interaction, puis testez les langues, accents et conditions d’enregistrement réels du public.
La prise en charge des langues mérite le même traitement. Une liste de langues est un contrôle d’éligibilité ; un enregistrement client bruyant est un test d’acceptation. Gardez l’audio original accessible aux personnes autorisées et prévoyez la correction des noms ou chiffres importants. Ces corrections aident à décider si le moteur nécessite une autre configuration ou si le produit doit offrir un meilleur parcours de récupération.
Le package laisse également la capture audio à l’application. Cette frontière de responsabilité est utile : l’app conserve la gestion de l’autorisation d’enregistrement, du choix de la source et du cycle de capture. Une bibliothèque de reconnaissance ne constitue pas une fonction d’enregistrement complète, surtout lorsque l’interface doit gérer interruptions, annulation et arrêt anticipé par l’utilisateur.
Les décisions typées réduisent l’analyse de texte, pas la responsabilité
Le README d’AnyDecisionModel, consulté le 2 novembre, documente des probabilités binaires, des choix parmi des options autorisées et des scores sur des échelles ordonnées. Il propose des parcours locaux MLX, Core AI et llama.cpp, ainsi que des moteurs Jev et Ollama. L’API renvoie des résultats structurés au lieu d’obliger l’application à retrouver une étiquette dans un paragraphe explicatif.
Cela peut simplifier considérablement une app. Lorsque le résultat autorisé est un service, le code peut traiter explicitement chaque service. Lorsque la question est de savoir si un message nécessite un contrôle, le résultat peut alimenter une politique comportant un état de vérification. L’app doit toujours définir ce que signifie ce contrôle et qui est responsable de la file.
Une app illustrative de rapport de maintenance rend la distinction claire. Un salarié enregistre une description, la reconnaissance produit du texte et la couche de décision suggère une catégorie d’équipement parmi plusieurs. L’application peut afficher la suggestion avec la transcription avant l’enregistrement. Elle ne doit pas transformer silencieusement une catégorie proposée en jugement de sécurité, ordre de réparation ou autorisation d’utilisation d’un équipement.
Les scores ordonnés nécessitent des définitions tout aussi concrètes. Si l’équipe demande une urgence sur trois niveaux, chaque niveau doit décrire une action ou une attente de service. « Faible », « moyenne » et « élevée » sont faciles à afficher mais difficiles à évaluer lorsque les personnes les interprètent différemment. Une courte grille écrite révèle les désaccords avant qu’ils ne deviennent des problèmes d’entraînement ou de seuil.
| Approche | Ce que reçoit l’application | Utile lorsque | Question principale d’évaluation |
|---|---|---|---|
| Génération ouverte | Texte pouvant inclure une justification | L’utilisateur a besoin d’une explication ou d’un brouillon | Le contenu est-il correct et utilisable ? |
| Choix délimité | Option autorisée sélectionnée et distribution | L’app possède des catégories définies | Le choix suit-il la politique de catégorisation ? |
| Score ordonné | Distribution sur des niveaux définis | L’app dispose d’une grille de classement significative | Les niveaux correspondent-ils à l’action prévue ? |
| Vérification humaine | Décision enregistrée d’une personne | Le contexte est incomplet ou les conséquences exigent un jugement | La personne dispose-t-elle de preuves suffisantes ? |
Cette comparaison porte sur la conception de l’interface, sans affirmer qu’une technique gagne toujours. Certains écrans nécessitent à la fois un choix délimité et une explication concise. Distinguez l’explication des preuves et gardez la décision modifiable lorsque le processus le permet.
La confiance décrit une distribution, pas une garantie d’exactitude
Le README d’AnyDecisionModel établit une distinction particulièrement utile : la confiance locale mesure la concentration de la distribution des réponses, pas la probabilité que la réponse choisie soit correcte. Il déconseille aussi de comparer les valeurs de confiance de moteurs différents comme si elles partageaient une formule. La calibration doit être ajustée séparément des données d’évaluation. Documentation du projet, consultée le 2 novembre 2026.
Supposons qu’un test illustratif attribue à un service une probabilité de 0.90 et répartisse le reste entre les autres. Cela indique que le modèle a favorisé ce service avec la question et les options reçues. Cela n’établit pas un taux historique de réussite de 90% pour ce type de message client. Les catégories peuvent être mal définies, l’entrée peut omettre un contexte crucial ou le modèle favoriser systématiquement une option.
Une politique produit utile exige donc un parcours explicite « en attente de vérification ». Commencez par rendre toutes les décisions visibles aux réviseurs et recueillez les corrections. Évaluez ensuite si un sous-ensemble est assez fiable pour une action automatique strictement définie. Le seuil découle des erreurs observées et de leur coût, plutôt que d’un chiffre choisi parce qu’il semble exprimer de la confiance.
Le jeu d’évaluation doit contenir des messages ambigus, des noms inconnus et des cas où aucun service disponible ne convient. Un système peut paraître performant lorsque chaque exemple correspond à une catégorie nette, puis échouer sur les demandes mixtes qui dominent le travail réel d’assistance. Faites noter aux réviseurs pourquoi ils ont modifié un choix, pour distinguer une mauvaise réponse du modèle d’une politique manquante.
Examinez aussi le coût de chaque sens d’erreur. Envoyer une demande courante en vérification consomme du temps ; orienter silencieusement une demande sensible vers le mauvais public peut avoir d’autres conséquences. Un score moyen unique cache cette différence. Présentez les cas importants aux responsables du produit, puis choisissez une politique d’action qu’ils peuvent expliquer aux utilisateurs et à la maintenance.
C’est aussi pourquoi changer de moteur est une modification produit. Le même appel Swift peut masquer des comportements, des significations numériques et des dépendances opérationnelles différents. Rejouez l’évaluation avant de transporter un ancien seuil dans une nouvelle configuration. Conservez identifiant du modèle, configuration et définitions des options avec le résultat pour expliquer ultérieurement la décision.
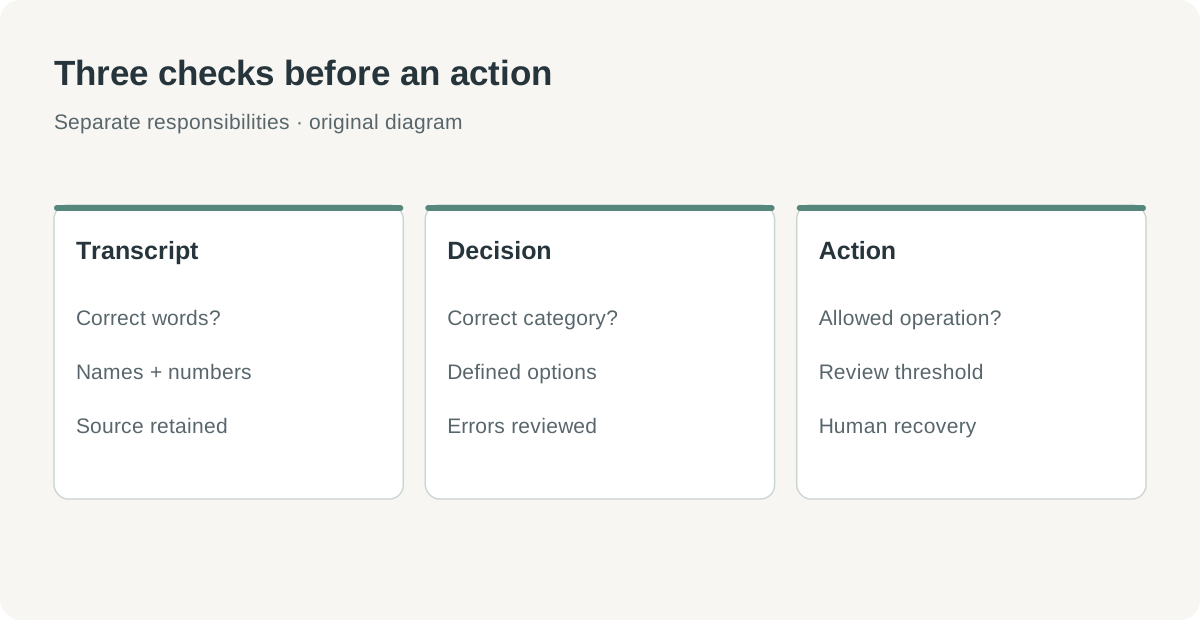 Schéma original : une forte préférence ne dispense ni d’évaluer l’exactitude ni de définir une politique d’action. Confiance et exactitude répondent à des questions différentes.
Le fonctionnement local change les responsabilités de l’équipe
Exécuter un modèle sur l’appareil peut séduire pour une messagerie vocale ou un outil de référence hors ligne. L’équipe peut concevoir autour d’entrées conservées localement et d’une frontière réseau prévisible. Mais téléchargement des modèles, compatibilité matérielle, mémoire et préparation au premier lancement deviennent des éléments visibles de l’expérience. Une promesse de confidentialité doit décrire tout le parcours, y compris une éventuelle étape hébergée ajoutée ensuite.
Un moteur de décision hébergé transfère une partie du travail opérationnel à un service, tout en introduisant réseau, identifiants et disponibilité du service dans le parcours. L’utilisateur doit comprendre l’état d’une requête échouée ou en attente. Une nouvelle tentative doit préserver la transcription originale et ne pas répéter accidentellement une action en aval déjà terminée.
La documentation actuelle distingue aussi les tests de compatibilité de la vérification d’un service actif. AnyDecisionModel précise que les tests de compatibilité des échanges Jev et Ollama utilisent des données de test. C’est une couverture utile, mais une application livrée doit encore vérifier sa configuration de service de bout en bout. README d’AnyDecisionModel, vérifié le 2 novembre.
Évitez de promettre des performances identiques entre un Mac de développement et le plus petit téléphone pris en charge. Une cible de déploiement indique où le code est censé fonctionner ; elle ne fournit pas les preuves de latence, d’autonomie ou de mémoire pour chaque appareil. L’app peut commencer par du traitement de fichiers sur une machine qualifiée, puis élargir sa compatibilité après validation de l’interaction sur d’autres matériels.
Commencez par un traitement de fichiers facile à vérifier
Un premier pilote doit rendre les erreurs faciles à inspecter. Une petite application fondée sur des fichiers offre souvent un point de départ plus clair qu’un assistant en direct, car le même audio autorisé peut être rejoué et comparé. L’objectif est de démontrer les étapes et leur transmission avant d’ajouter le temps réel.
- Définissez une tâche avec une courte liste de décisions autorisées et une règle écrite pour les cas ambigus. Incluez une option de vérification dans la politique applicative.
- Vérifiez les exigences actuelles des packages et ajoutez la dépendance Swift pertinente. Choisissez un moteur de reconnaissance et un moteur de décision plutôt que de qualifier toutes les combinaisons à la fois.
- Importez quelques enregistrements autorisés. Conservez séparément les fichiers originaux, les transcriptions attendues et les décisions des réviseurs.
- Installez ou préparez explicitement les ressources de modèle nécessaires en suivant la documentation. Présentez préparation et traitement comme deux états distincts de l’interface.
- Exécutez la reconnaissance, conservez le texte final et posez les questions délimitées sur ce texte. Affichez le résultat près de la source plutôt que d’effectuer immédiatement une action externe.
- Examinez les erreurs par étape, puis évaluez un ensemble distinct d’enregistrements après les modifications. Conservez la configuration avec chaque résultat.
- Ajoutez la gestion de l’annulation, des modèles indisponibles et des pannes réseau avant de passer à la capture en direct ou à l’orientation automatique.
Le critère de réussite doit être compréhensible par un responsable produit. Un pilote de messagerie vocale pourrait, par exemple, exiger qu’une personne retrouve l’enregistrement source, corrige la transcription et change la file proposée sans perdre d’élément original. C’est un résultat de processus utile avant même de décider d’automatiser quoi que ce soit.
Les petites décisions méritent elles aussi une conception produit complète
Ces packages proposent une architecture séduisante : un composant pour entendre, un autre pour choisir et du code applicatif pour imposer l’action autorisée. Cela crée des points de mesure de qualité et de récupération des erreurs. Les limites d’une réponse numérique deviennent aussi plus faciles à discuter avec les personnes qui doivent lui faire confiance.
L’attente à tester est la maintenabilité. Une équipe peut-elle remplacer la reconnaissance sans réécrire toute l’app ? Peut-elle évaluer un nouveau moteur de décision sans prétendre que les anciens seuils restent valables ? Les utilisateurs peuvent-ils corriger le résultat au point précis où l’erreur s’est produite ?
Un petit modèle devient utile lorsque sa tâche est claire et que sa sortie a un responsable. L’abstraction Swift relie les composants ; la politique de décision du produit leur donne un objectif.
Sources
- Mattt : présentation d’AnySpeechRecognizer et AnyDecisionModel, 29 octobre 2026.
- AnySpeechRecognizer : exigences, comparaison des moteurs et exemples, consulté le 2 novembre 2026.
- AnyDecisionModel : moteurs, calibration et limites, consulté le 2 novembre 2026. Les licences du code des packages et celles des modèles individuels doivent être examinées séparément.
- Mattt : documentation et capture d’Emoji Magnet, documentation Apache-2.0 ; consultée le 2 novembre 2026.
Garder une décision d’implémentation reliée à sa source
Telli.sh est une option pour conserver des sources dont l’utilisation est autorisée et les notes qui fondent une décision d’implémentation. Créer un espace de notes.