AnyDecisionModel y AnySpeechRecognizer separan lo que escucha una app Swift de lo que decide
Dos paquetes Swift de terceros conectan motores de voz y decisiones tipadas. Dónde ayuda la inferencia local, por qué hay que calibrar la confianza y cómo iniciar un piloto acotado.
Una grabación de soporte contiene dos problemas distintos. Primero, la aplicación debe recuperar lo que dijo quien llamó. Después debe decidir si la petición corresponde a facturación, soporte técnico u otro equipo. Tratar ambos como una conversación abierta dificulta identificar las responsabilidades de la aplicación.
El desarrollador Mattt presentó AnySpeechRecognizer y AnyDecisionModel el 29 de octubre de 2026. Son paquetes Swift de terceros para desarrolladores de plataformas Apple: uno permite elegir motores de reconocimiento de voz y el otro devuelve elecciones tipadas y distribuciones de probabilidad. Aprovechan patrones conocidos de Swift sin ser anuncios de productos de Apple. La presentación de Mattt explica ambos trabajos con el mismo ejemplo de una llamada de soporte.
Lo interesante es poder elegir y evaluar esos trabajos por separado. Esta guía explica qué aportan los paquetes, cómo cambia el diseño al usar servicios locales o alojados y por qué una confianza numérica sigue necesitando una política de producto.
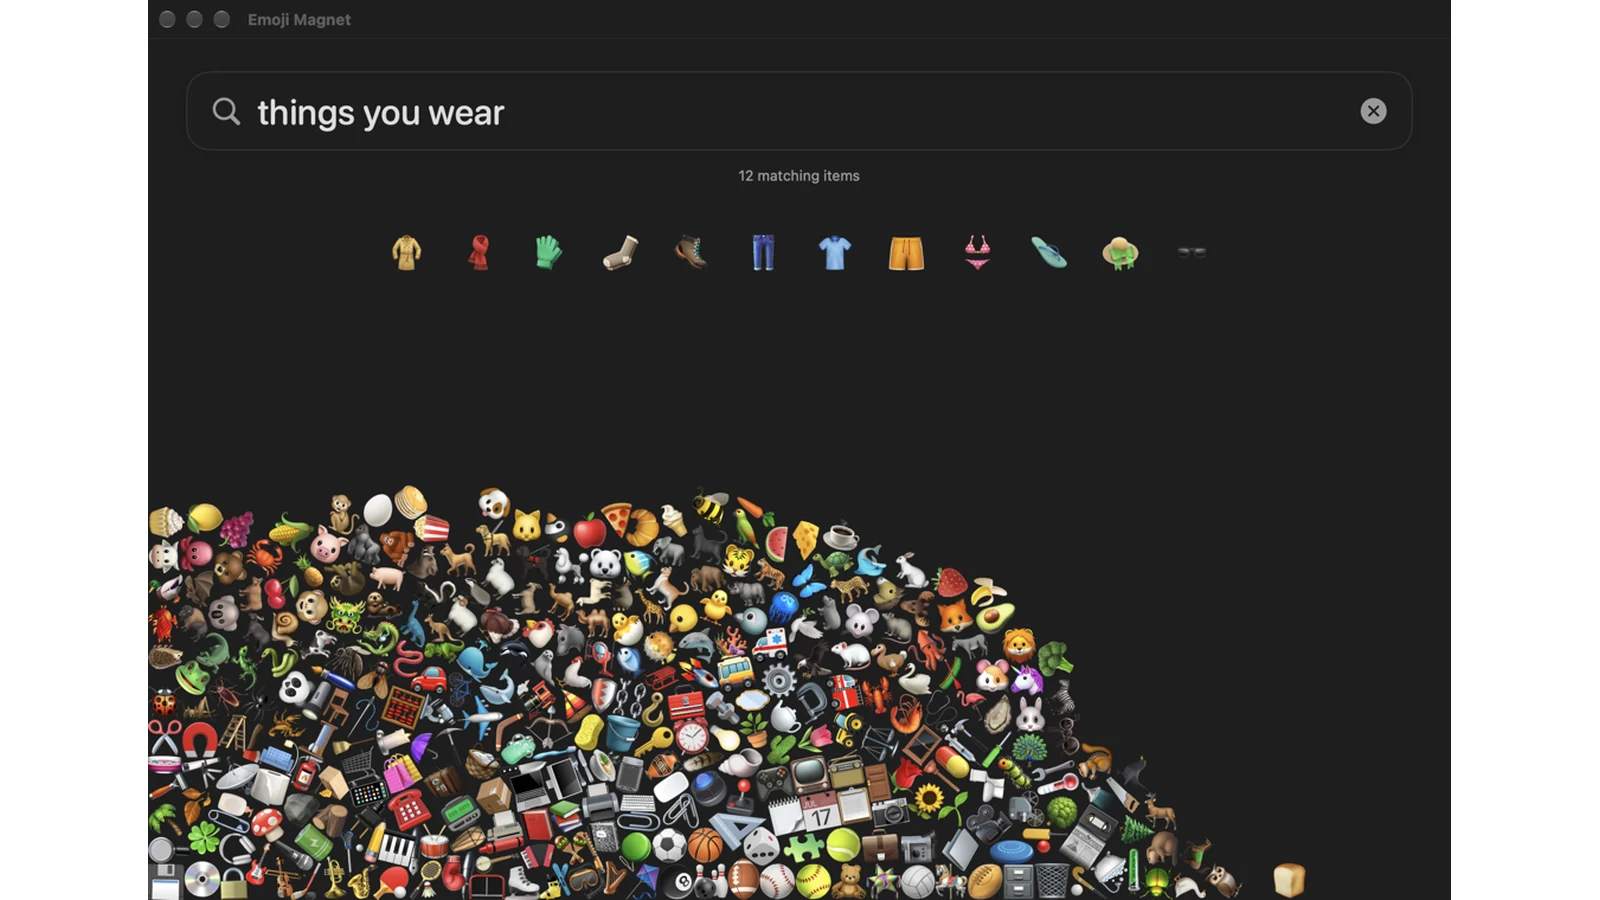 La aplicación de ejemplo Emoji Magnet de Mattt utiliza AnyDecisionModel para clasificar emojis. Captura documental facilitada por el autor, Apache 2.0; redimensionada con márgenes. Fuente de la imagen · Licencia y notas de la imagen.
Una transcripción y una decisión de asignación necesitan pruebas separadas
Imagina que alguien dice: «La factura está mal y no puedo iniciar sesión para descargarla». La transcripción puede reproducirlo correctamente mientras falla la política de asignación. ¿La empresa lo envía a facturación por la factura, a soporte técnico por el acceso o a una cola general porque aparecen ambos problemas?
La respuesta depende de la política del servicio. Un modelo no puede suplir una regla de responsabilidad ausente devolviendo una etiqueta con mucha preferencia. Antes de evaluar un motor, escribe qué significa cada opción permitida y qué sucede si encajan varias. Eso da a la aplicación un objetivo más útil que «el resultado parecía razonable».
Separar etapas también facilita diagnosticar errores. Si el reconocedor cambia el nombre de un producto, conserva la transcripción y comprueba si las palabras correctas habrían cambiado la decisión. Si la transcripción es exacta pero el equipo elegido es incorrecto, inspecciona las opciones y el modelo de decisión. Son reparaciones distintas; combinarlas oculta el origen del fallo.
Nuestra opinión es que la abstracción más valiosa es el límite entre escuchar y elegir. Cada etapa debería producir un resultado inspeccionable por la siguiente. El equipo puede decidir entonces cuáles merecen ejecución automática y cuáles deberían seguir siendo sugerencias para una persona.
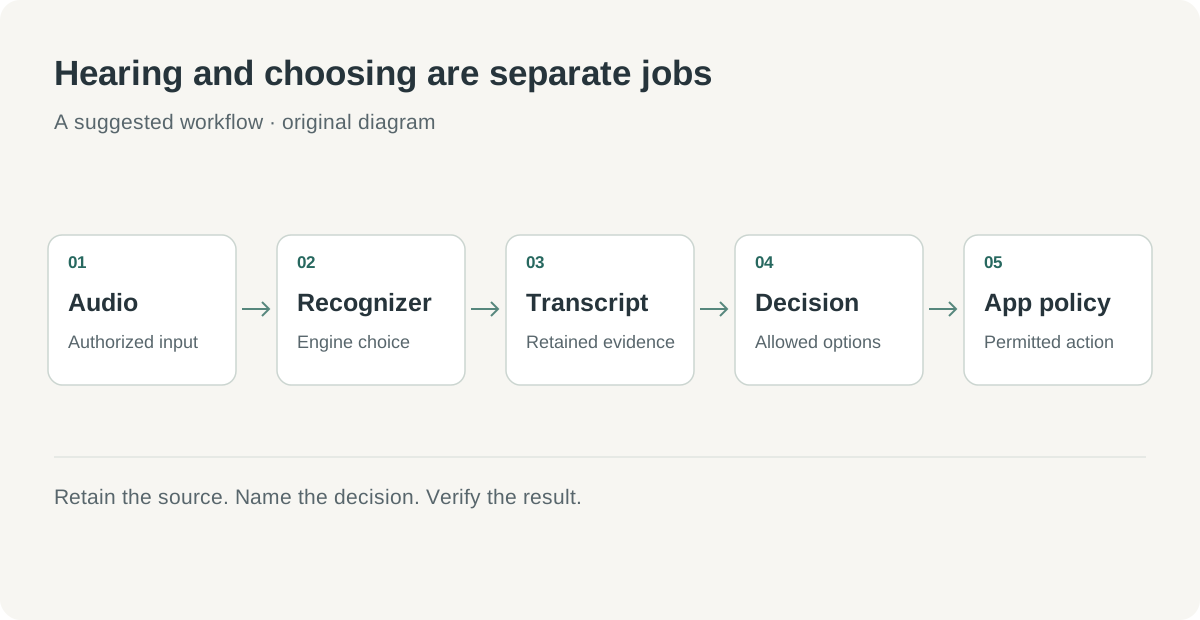 Diagrama original: el reconocimiento aporta evidencia; una decisión acotada aporta una distribución; la aplicación decide qué acción está permitida.
La elección del motor importa cuando cambia el audio de la aplicación
El README de AnySpeechRecognizer, consultado el 2 de noviembre, describe una API inspirada en el framework moderno Speech de Apple, con opciones Apple, Parakeet y Qwen3-ASR. Sus capacidades difieren: la comparación publicada ofrece resultados provisionales en directo y tiempos por palabra en algunas vías, mientras Qwen3-ASR proporciona segmentos sin tiempos por palabra. Requiere Swift 6.2 o posterior y macOS o iOS 26 o posteriores, además de requisitos de hardware para determinados modelos.
La diferencia es visible en el diseño. Los subtítulos en directo se benefician de recibir texto antes de terminar de hablar, pero deben mostrar que las palabras provisionales pueden cambiar. Importar archivos permite priorizar resultados definitivos y esperar a que termine el procesamiento. La misma pantalla no debería fingir que ambos modos tienen tiempos idénticos.
En una aplicación ilustrativa de entrevistas, los tiempos por palabra pueden ser esenciales para que pulsar una frase lleve al punto correspondiente de la grabación. En un buzón de voz ilustrativo, una transcripción por segmentos puede bastar para revisar mensajes breves. Define primero esa interacción y elige después el motor, probándolo con idiomas, acentos y condiciones reales del público.
Aplica lo mismo al soporte de idiomas. La lista de lenguas es una comprobación de compatibilidad; una grabación ruidosa de un cliente es una prueba de aceptación. Mantén el audio disponible para revisores autorizados y permite corregir nombres o cifras importantes. Las correcciones ayudan a decidir si cambiar la configuración o mejorar la recuperación dentro del producto.
El paquete también deja la captura de audio a la aplicación. Es un límite útil de responsabilidad: la aplicación responde de permisos de grabación, selección de fuente y ciclo de captura. Una biblioteca de reconocimiento no equivale a una función completa de grabación, especialmente si la interfaz debe gestionar interrupciones, cancelaciones y una parada anticipada.
Las decisiones tipadas reducen el trabajo de análisis, no la responsabilidad
El README de AnyDecisionModel, consultado el 2 de noviembre, documenta probabilidades binarias, elección entre opciones permitidas y puntuaciones en escalas ordenadas. Ofrece vías locales MLX, Core AI y llama.cpp, además de Jev y Ollama. Devuelve resultados estructurados sin obligar a extraer una etiqueta de un párrafo explicativo.
Eso puede simplificar considerablemente la aplicación. Si el resultado permitido es un departamento, el código puede tratar cada uno explícitamente. Si la pregunta es si un mensaje necesita revisión, el resultado puede alimentar una política con ese estado. La aplicación sigue necesitando definir qué significa revisar y quién responde de la cola.
Una aplicación ilustrativa de partes de mantenimiento aclara la diferencia. Un trabajador graba una descripción, el reconocedor produce texto y la capa de decisión sugiere una categoría de equipo. La aplicación puede mostrarla junto a la transcripción antes de guardar. No debería convertir silenciosamente la sugerencia en una determinación de seguridad, una orden de reparación o un permiso de uso.
Las puntuaciones ordenadas necesitan definiciones igual de concretas. Si se pide urgencia en tres niveles, cada uno debería describir una acción o expectativa de servicio. «Baja», «media» y «alta» son etiquetas fáciles de mostrar, pero difíciles de evaluar si los revisores las interpretan de manera distinta. Una rúbrica breve hace visibles los desacuerdos antes de que sean problemas de entrenamiento o umbrales.
| Enfoque | Qué recibe la aplicación | Cuándo sirve | Pregunta principal de evaluación |
|---|---|---|---|
| Generación abierta | Texto que puede incluir una justificación | El usuario necesita una explicación o un borrador | ¿El contenido es correcto y utilizable? |
| Elección acotada | Opción permitida seleccionada y distribución | La aplicación tiene categorías definidas | ¿La elección sigue la política de categorías? |
| Puntuación ordenada | Distribución entre niveles definidos | Existe una rúbrica significativa | ¿Los niveles corresponden a la acción prevista? |
| Revisión humana | Decisión registrada por una persona | Falta contexto o las consecuencias exigen criterio | ¿Tiene el revisor evidencia suficiente? |
La comparación trata del diseño de interfaz, no afirma que una técnica gane siempre. Algunas pantallas necesitan una elección acotada y una explicación breve. Distingue la explicación de la evidencia y mantén editable la decisión cuando el proceso lo permita.
La confianza describe una distribución, no garantiza exactitud
El README de AnyDecisionModel establece una distinción especialmente útil: la confianza local mide lo concentrada que está la distribución de respuestas, no la probabilidad de que la respuesta elegida sea correcta. También advierte contra comparar valores de motores distintos como si compartieran fórmula. La calibración debe ajustarse con datos separados de los de evaluación. Documentación, consultada el 2 de noviembre de 2026.
Supongamos que una prueba ilustrativa devuelve un departamento con probabilidad 0.90 y reparte el resto entre otros. Eso dice que el modelo favoreció ese departamento con la pregunta y opciones recibidas. No establece un 90% histórico de acierto para esos mensajes. Las categorías pueden estar mal definidas, faltar contexto esencial o existir preferencia sistemática por una opción.
Por tanto, una política útil necesita una vía explícita de «pendiente de revisión». Empieza mostrando todas las decisiones a los revisores y recoge correcciones. Después evalúa si algún subconjunto es suficientemente fiable para una acción automática muy acotada. El umbral debe derivarse de errores observados y sus costes, no de un número que parezca seguro.
El conjunto de evaluación debería incluir mensajes ambiguos, nombres desconocidos y casos donde no encaje ningún departamento. Un sistema puede parecer sólido si todos los ejemplos pertenecen limpiamente a una categoría y fallar en peticiones mixtas habituales. Pide registrar por qué se cambió una elección para distinguir una mala respuesta de una política ausente.
Examina también el coste de cada dirección del error. Enviar una petición rutinaria a revisión consume tiempo; asignar silenciosamente una petición sensible al público equivocado tiene otras consecuencias. Una media oculta esa diferencia. Informa de los casos importantes para los responsables y elige una política explicable a usuarios y mantenedores.
Por eso cambiar de motor también cambia el producto. La misma llamada Swift puede ocultar comportamientos, semánticas numéricas y dependencias operativas distintos. Repite la evaluación antes de trasladar un umbral antiguo a otra configuración. Guarda identificador del modelo, configuración y opciones con el resultado para poder explicar después cómo se decidió.
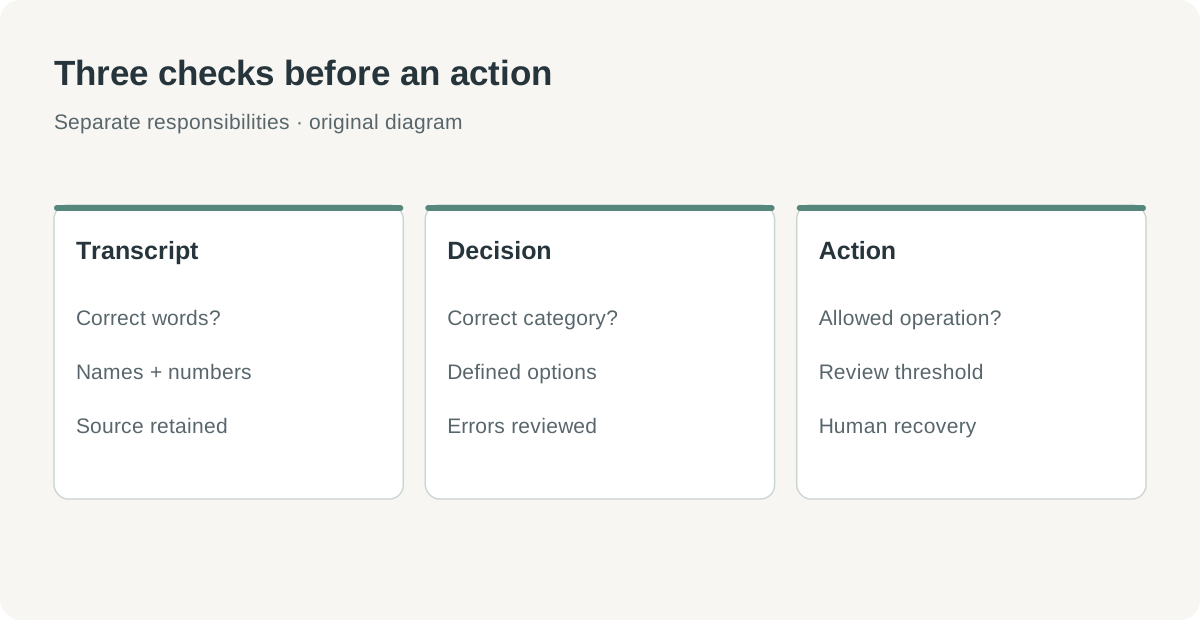 Diagrama original: una preferencia fuerte no elimina la necesidad de evaluar la corrección ni de definir una política de acción. Confianza y exactitud responden a preguntas distintas.
La operación local cambia el trabajo que asume el equipo
Ejecutar el modelo en el dispositivo puede atraer para un buzón de voz o una herramienta de consulta sin conexión. Permite diseñar alrededor de entradas conservadas localmente y un límite de red predecible. Pero las descargas, el hardware, la memoria y la preparación inicial se vuelven visibles para el usuario. Una promesa de privacidad debería describir todo el recorrido, incluida cualquier etapa alojada añadida después.
Un motor alojado traslada parte de la operación a un servicio e introduce red, credenciales y disponibilidad. El usuario necesita un estado comprensible cuando una petición falla o queda pendiente. Reintentar debería conservar la transcripción original y evitar repetir accidentalmente una acción posterior ya completada.
La documentación actual también distingue compatibilidad probada de verificación de servicios reales. AnyDecisionModel indica que las pruebas de compatibilidad de protocolo de Jev y Ollama utilizan datos de prueba. Es una cobertura valiosa, pero la aplicación que se distribuye debe verificar de extremo a extremo su configuración elegida. README de AnyDecisionModel, consulta del 2 de noviembre.
Evita prometer rendimiento idéntico en el Mac del desarrollador y el teléfono mínimo compatible. Un objetivo de despliegue indica dónde está previsto ejecutar código; no aporta evidencia de latencia, batería o memoria en cada dispositivo. Puede empezarse procesando archivos en una máquina validada y ampliar después de comprobar la interacción en más hardware.
Empieza con archivos que se puedan revisar
El primer piloto debería facilitar inspeccionar errores. Una aplicación pequeña basada en archivos suele ser más clara que un asistente en directo porque permite reproducir y comparar el mismo audio autorizado. El objetivo es demostrar las etapas y su conexión antes de añadir interacción en tiempo real.
- Define una tarea con una lista breve de decisiones permitidas y una regla escrita para ambigüedades. Incluye la revisión en la política.
- Comprueba los requisitos actuales y añade la dependencia Swift correspondiente. Elige un reconocedor y un motor de decisión en vez de validar todas las combinaciones a la vez.
- Importa unas pocas grabaciones autorizadas. Conserva por separado archivos originales, transcripciones esperadas y decisiones de revisores.
- Instala o prepara explícitamente los recursos del modelo siguiendo la documentación. Muestra preparación y procesamiento como estados distintos.
- Ejecuta el reconocimiento, conserva el texto final y formula las preguntas acotadas sobre él. Muestra el resultado junto a la fuente en vez de actuar externamente de inmediato.
- Revisa errores por etapa y, tras cambiar algo, evalúa otro conjunto de grabaciones. Registra la configuración con cada resultado.
- Añade cancelación, modelo no disponible y fallo de red antes de ampliar a captura en directo o asignación automática.
Un responsable de producto debería entender el criterio de éxito. Por ejemplo, el piloto de buzón podría exigir encontrar la grabación original, corregir la transcripción y cambiar la cola sugerida sin perder material. Es un resultado útil incluso antes de decidir automatizar.
Las decisiones pequeñas también merecen un diseño completo
Estos paquetes plantean una arquitectura atractiva: un componente escucha, otro elige y el código de aplicación impone la acción permitida. Así hay lugares donde medir calidad y recuperarse de fallos. También facilita discutir los límites de una respuesta numérica con quienes deben confiar en ella.
La expectativa que merece probarse es la mantenibilidad. ¿Puede el equipo sustituir el reconocedor sin reescribirlo todo? ¿Puede evaluar otro motor sin fingir que siguen valiendo los umbrales antiguos? ¿Puede el usuario corregir el resultado donde realmente se produjo el error?
Un modelo pequeño resulta útil cuando tiene un trabajo claro y su salida tiene un responsable. La abstracción Swift conecta las piezas; la política de decisión del producto les da propósito.
Fuentes
- Mattt: presentación de AnySpeechRecognizer y AnyDecisionModel, 29 de octubre de 2026.
- AnySpeechRecognizer: requisitos, comparación de motores y ejemplos, consultado el 2 de noviembre de 2026.
- AnyDecisionModel: motores, calibración y limitaciones, consultado el 2 de noviembre de 2026. Las licencias del código y de cada modelo requieren consideración separada.
- Mattt: documentación y captura de Emoji Magnet, documentación Apache-2.0; consultada el 2 de noviembre de 2026.
Mantén una decisión de implementación vinculada a su fuente
Telli.sh es una opción para conservar material autorizado y las notas que sustentan una decisión de implementación. Crea un espacio de notas.