Strata i Qwen3.8-Flash-Next: jak model klasy 180B działa na komputerze osobistym
Przewodnik oparty na źródłach: architektura Strata, konfiguracja w Windows i Linux, osobna ścieżka dla Maca z Apple Silicon, opublikowane benchmarki i ograniczenia lokalnej AI.
Uruchomienie modelu o około 180 miliardach parametrów na komputerze stacjonarnym z kartą graficzną wyposażoną w 12 GB pamięci brzmi jak sprzeczność. Strata czyni taki scenariusz wiarygodnym, ale nie przez upchnięcie wszystkich parametrów na karcie. Ciekawsze osiągnięcie polega na tym, że różne części rzadkiego modelu korzystają z różnych rodzajów pamięci i mocy obliczeniowej, a każdy generowany token nie staje się przez to wąskim gardłem transferu danych.
Oficjalna nazwa modelu to Qwen3.8-Flash-Next, a nie Qwen3.8-Next-Flash. Według Qwen rdzeń ma 125B parametrów, z czego aktywowanych jest 6B; dodatkowo model zawiera komponent osadzeń n-gramowych o wielkości 51B oraz 4B przeznaczone na Multi-Token Prediction. Zaokrąglona suma 180B opisuje przechowywane komponenty, a nie ilość obliczeń gęstych wykonywanych dla każdego tokena. Karta modelu Qwen
Opis konfiguracji i wydajności poniżej dotyczy wersji Strata z commita fb58e0dbc8399662c0e47c76578c6e878b14f6cf. Wyniki benchmarków to pomiary opublikowane przez projekt; rezultaty na Twoim sprzęcie mogą się różnić w zależności od promptu, kontekstu i wariantu modelu.
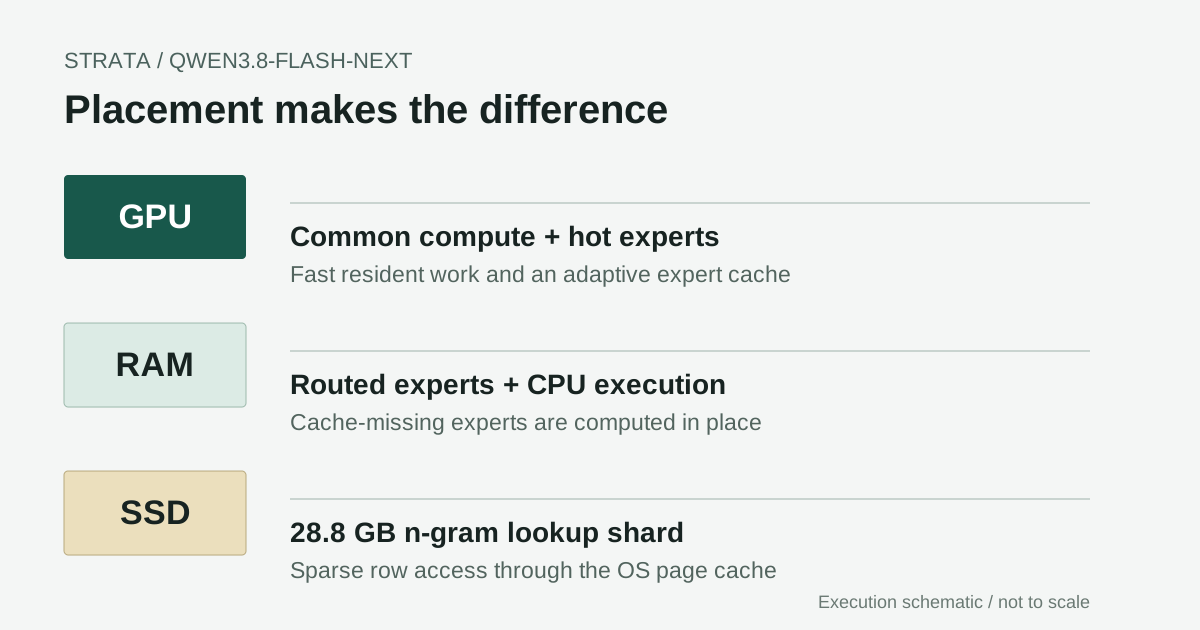
Oryginalny schemat oparty na udokumentowanym projekcie wykonywania. Warstwy nie są narysowane w skali: rozmiar pobieranych plików, użycie RAM i rezydencja w GPU to różne wielkości.
Przełom dotyczy rozmieszczenia, a nie mniejszego modelu
W przypadku każdego wyjątkowo dużego modelu lokalnego warto zadać trzy pytania: ile trzeba przechowywać, ile parametrów jest aktywnych dla jednego tokena i gdzie wykonywana jest aktywna praca. Mała liczba aktywnych parametrów odpowiada tylko na drugie pytanie. Nie znosi konieczności zapewnienia dostępu do pozostałych wag.
Strata to opracowany przez społeczność silnik inferencyjny i aplikacja do lokalnego serwowania modeli w repozytorium Niko1221. Dokumentacja opisuje instalację w Windows i Linux, lokalny interfejs czatu, zgodne interfejsy API oraz opcjonalne wejście obrazowe. To osobny projekt społeczności, a nie oficjalny produkt Qwen na komputery stacjonarne. Repozytorium Strata
Przydatna zmiana perspektywy technicznej polega na tym, by nie traktować komputera jako GPU z niewystarczającą pamięcią. Komputer stacjonarny ma również pamięć systemową, jednostki wektorowe CPU i pamięć podręczną stron systemu operacyjnego. Przy niektórych operacjach zasoby te są wolniejsze od pamięci GPU, ale nie są równie nieodpowiednie do każdej pracy. Duże wyszukiwanie w tabeli i gęste mnożenie macierzy nie wymagają tej samej strategii rozmieszczania danych.
To właśnie sprawia, że główna teza jest interesująca. Model nadal jest duży; środowisko uruchomieniowe zmienia to, jaka jego część musi w danej chwili znajdować się w najszybszej pamięci. Otwiera to praktyczną drogę do lokalnej inferencji, ale nie dowodzi, że każdy zwykły laptop będzie dobrze sobie z nią radził.
Rzadka architektura stwarza taką możliwość
Architektura Qwen łączy bloki Gated DeltaNet o charakterze rekurencyjnym z Qwen Sparse Attention, routowanymi ekspertami i osadzeniami n-gramowymi. Raport techniczny wyjaśnia, dlaczego te komponenty zaprojektowano z myślą o wydajniejszym skalowaniu. Strata nie stworzyła tych elementów modelu; buduje strategię wykonywania dostosowaną do ich różnych wzorców dostępu. Raport o architekturze Qwen
Szczegóły routingu mają znaczenie. Każda z 48 warstw zawiera 512 routowanych ekspertów; w każdej warstwie aktywowanych jest 10 routowanych ekspertów, a ponadto jeden ekspert współdzielony. Oznacza to, że w warstwach przechowywanych jest łącznie 24,576 routowanych ekspertów. Nie oznacza to, że dla jednego tokena w całym modelu używa się zaledwie 10 z tych 24,576 ekspertów. Konfiguracja architektury Qwen
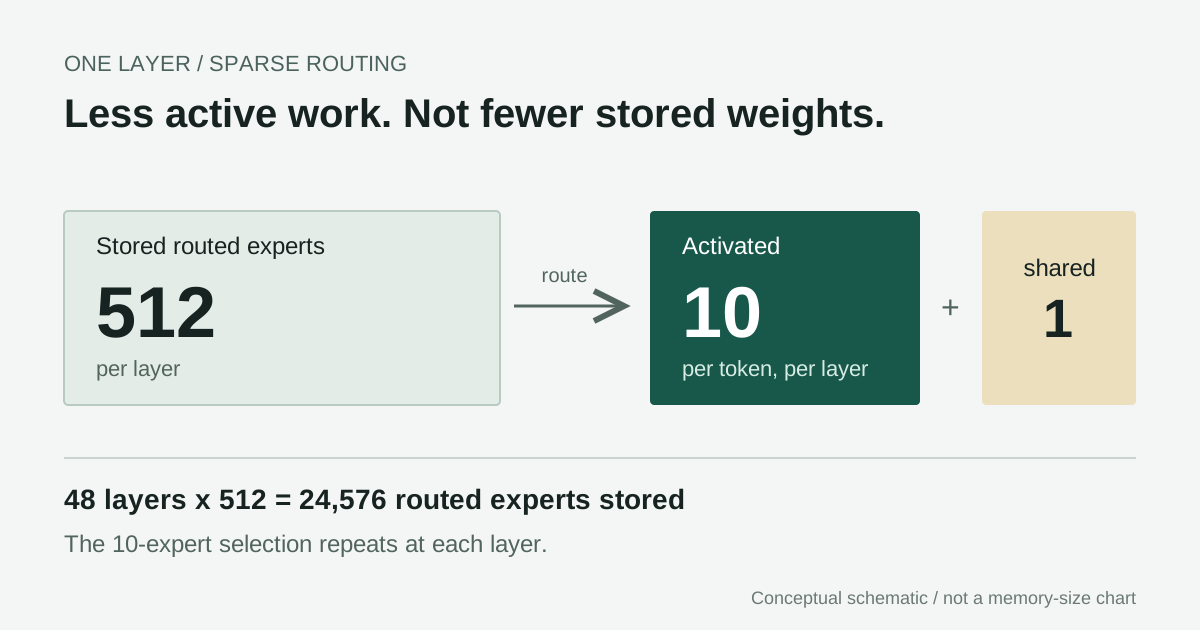
Wybór ogranicza aktywną pracę, a nie liczbę przechowywanych elementów. Schemat przedstawia jedną warstwę, nie cały model złożony z 48 warstw.
Rozważmy konsekwencje niezależnie od jakichkolwiek deklaracji szybkości. Jeśli ekspert jest wybierany rzadko, stałe zajmowanie nim kosztownej pamięci akceleratora może być słabym wykorzystaniem jej pojemności. Jeśli inny komponent jest używany w każdym kroku, wielokrotne przenoszenie go prawdopodobnie będzie kosztowne. Dobry scheduler musi rozróżniać takie przypadki, a następnie zarządzać brakami w pamięci podręcznej, których nie da się uniknąć.
Dlatego rzadkiego modelu klasy 180B nie należy porównywać z gęstym modelem 180B wyłącznie na podstawie liczby parametrów. Z kolei określenie go jako „modelu 6B” ukrywa wymagania dotyczące przechowywania, routing, stan kontekstu i koszt dostępu do rozproszonych wag. Oba uproszczenia przesłaniają rzeczywisty problem techniczny.
GPU, RAM i SSD pełnią różne role
W udokumentowanej konfiguracji bazowej GPU przechowuje typowe obliczenia i pamięć podręczną często używanych routowanych ekspertów. Pamięć systemowa zawiera wagi routowanych ekspertów, a CPU oblicza na miejscu tych ekspertów, których brakuje w pamięci podręcznej GPU. Osobna tabela n-gramowa, mapowana do pamięci, pozostaje na SSD; potrzebne wiersze są udostępniane przez pamięć podręczną systemu operacyjnego. Przegląd wykonywania w Strata
Ścieżka CPU ma większe znaczenie, niż sugeruje ogólna etykieta „offload”. Podczas dekodowania brak w pamięci podręcznej nie oznacza, że przed kontynuacją trzeba po prostu skopiować każdy brakujący element do GPU. Praca CPU i GPU może przebiegać równolegle. Kompromis polega na tym, że wydajność CPU i przepustowość pamięci systemowej bezpośrednio wpływają teraz na szybkość generowania.
Komponent n-gramowy ma jeszcze inny wzorzec dostępu. Odczyt kilku wierszy nie jest tym samym obciążeniem co skanowanie całej tabeli. Dlatego pozostawienie na SSD skwantyzowanego fragmentu n-gramowego o rozmiarze 28.8 GB może być praktyczne, ale nie oznacza, że cały model jest odczytywany z dysku przy każdym generowanym tokenie. Wolny dysk lub duża presja na pamięć podręczną stron nadal mogą pogorszyć responsywność.
Prefill różni się również od dekodowania. Przetwarzanie początkowego promptu pozwala tworzyć większe partie i nakładać transfer ekspertów na pracę innych warstw. Generowanie kolejnego tokena jest wrażliwe na opóźnienia. Szczegółowa dokumentacja projektu opisuje osobne kernele, harmonogramowanie i zachowanie pamięci podręcznej dla tych faz. Jedna liczba dotycząca przepustowości nie podsumuje ich obu. Szczegóły implementacji Strata
Moim zdaniem innowacją jest skoordynowany system, a nie pojedynczy trik kompresji. Kwantyzacja ogranicza rozmiar przechowywanych wag; buforowanie ogranicza powtarzane dostępy do często używanych wag; CPU obsługuje braki; rzadkie odczyty pozwalają uniknąć ładowania całej ogromnej tabeli. Bez dowolnego z tych atutów komputer o umiarkowanej pamięci byłby znacznie mniej przekonującym środowiskiem.
Spekulacja oszczędza pracę tylko wtedy, gdy weryfikacja zaakceptuje propozycję
Strata wykorzystuje także komponent Multi-Token Prediction modelu do proponowania krótkich kontynuacji i weryfikowania ich za pomocą modelu docelowego. Zamiast wykonywać pełny przebieg modelu docelowego dla każdego pojedynczego tokena wyjściowego, udana propozycja może pozwolić zaakceptować kilka tokenów w jednym przebiegu. Repozytorium opisuje propozycje do trzech tokenów w ścieżce MTP. Projekt i implementacja MTP
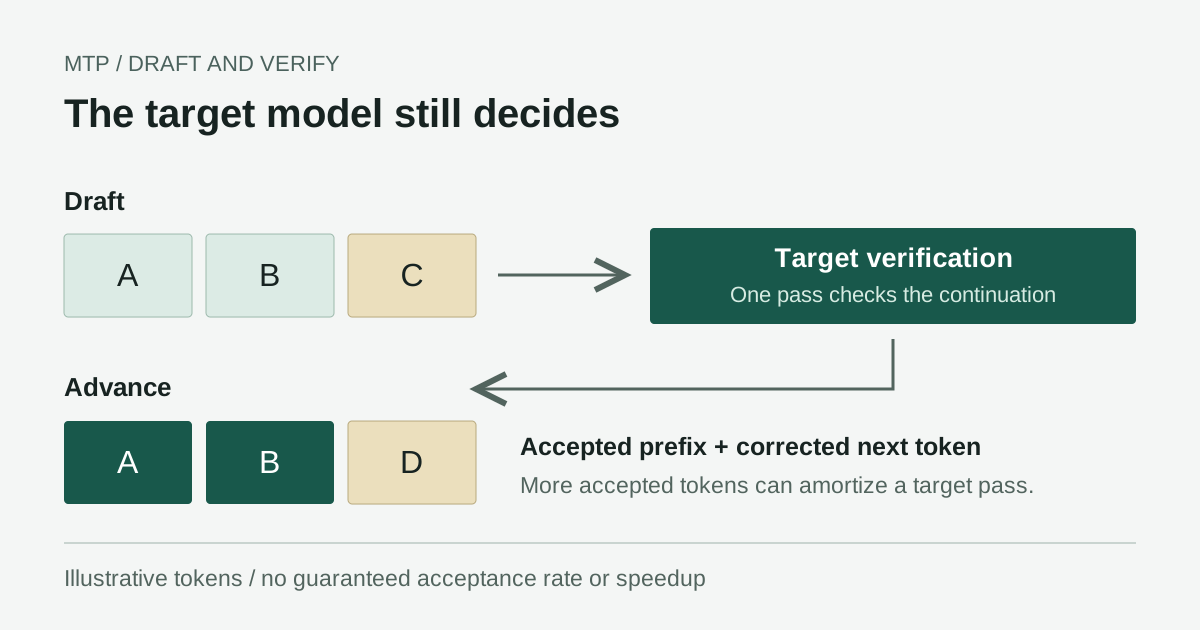
Przykład ilustruje weryfikację, a nie gwarantowany współczynnik akceptacji ani zmierzony wzrost szybkości.
Przyspieszenie jest warunkowe. Przewidywalny kod lub powtarzający się tekst mogą być łatwiejsze do przewidzenia niż nieznane przejście w rozumowaniu. Sformułowanie promptu, próbkowanie, długość odpowiedzi i wariant modelu mogą zmieniać współczynnik akceptacji. Wyniku zmierzonego na jednym prompcie nie należy więc automatycznie przypisywać innemu językowi lub zadaniu.
Weryfikacja dotyczy faktycznie uruchamianego modelu. Nie odzyskuje informacji utraconych podczas kwantyzacji ani nie dowodzi równoważności z oryginalnymi wagami BF16. Należy rozdzielać te kwestie: wykonywanie spekulatywne i jakość modelu o obniżonej precyzji odpowiadają na różne pytania.
Kolejne rozróżnienie dotyczy ponownego użycia pamięci podręcznej. Niezmieniony prefiks rozmowy może oszczędzić powtarzanej pracy, ale kontynuacja z rozgrzaną pamięcią podręczną i nowy, długi prompt nie są równoważnymi testami. Porównując lokalne wyniki, odnotuj, czy prefiks został ponownie użyty. Projekt wprost dokumentuje buforowanie na granicach wiadomości. Zachowanie pamięci podręcznej prefiksu
„GPU 12 GB” nie oznacza „instalacji 12 GB”
Opublikowane kwantyzacje GGUF dzielą model na główny fragment i stały fragment n-gramowy o rozmiarze 28.8 GB. Podane niżej rozmiary plików są wyrażone w dziesiętnych GB i oznaczają rozmiary pobieranych danych, a nie wymagania dotyczące pamięci GPU. Opcjonalny projektor wizyjny dodaje około 0.91 GB; dodatkowe pliki i tymczasowe dane konwersji wymagają kolejnego miejsca. Pliki kwantyzacji ISTA-DASLab
| Wariant | Średnia liczba bitów na wagę rdzenia | Główny fragment | Fragment n-gramowy | Łączny rozmiar pobierania |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
Sama nazwa formatu nie opisuje precyzyjnie każdego tensora. Główny fragment korzysta z mieszanych formatów, a fragment n-gramowy używa IQ4_NL. Określenie „model dwubitowy” jest wygodnym skrótem, ale wprowadza w błąd, jeśli sugeruje, że cały pakiet zajmuje dokładnie dwa bity na parametr. Metodyka kwantyzacji
Przy pierwszej próbie z pełnym modelem bardziej wiarygodną podstawą do planowania niż sama informacja o GPU jest obsługiwana karta z co najmniej 12 GB oraz 64 GB pamięci systemowej. Repozytorium omawia również ścieżki o mniejszym zapotrzebowaniu na RAM i przycięty wariant Coder. To odrębne konfiguracje, a nie dowód, że komputer z 32 GB zapewni takie same wrażenia z pełnym modelem. Wybór modelu Strata
Przed eksperymentami zarezerwowałbym 100-150 GB wolnego miejsca na SSD. To ostrożny zapas planistyczny, a nie stałe wymaganie producenta: rzeczywista suma zależy od wybranej kwantyzacji, pomocniczego modelu MTP, opcjonalnych plików wizyjnych oraz pamięci podręcznych kompilacji i konwersji. Niektóre ścieżki optymalizacji Q2 dla CPU mogą wymagać znacznej dodatkowej kopii ekspertów. Sprawdź wybraną ścieżkę, zamiast zakładać jedną uniwersalną wartość miejsca na dysku.
Zanim wybierzesz sprzęt, określ potrzebną konfigurację: pełny czy przycięty model, krótki czy długi kontekst, obraz czy tekst, stała przepustowość czy okazjonalne użycie. Te wybory wpływają na położenie wąskiego gardła, a poniższy benchmark opisuje konkretny system.
Najpierw zainstaluj przypiętą konfigurację bazową, potem ją dostrajaj
Udokumentowana standardowa ścieżka obejmuje Windows 10/11 i Ubuntu 22.04/24.04 oraz obsługiwane karty NVIDIA i wybrane karty AMD. Instrukcje NVIDIA wymagają sterownika w wersji 580 lub nowszej. macOS i inne backendy budowane ze źródeł mają odrębne wymagania; poniższe polecenia nie są uniwersalną ścieżką instalacji. Oficjalny przewodnik instalacji
W Windows najpierw sprawdź, dopiero potem pobieraj
Jeśli Git nie jest zainstalowany, pobierz go z oficjalnej dystrybucji. W PowerShell sklonuj repozytorium upstream i przypnij wersję sprawdzoną w tym artykule:
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
Kontrola pozwala uniknąć pobierania dużego modelu, ale program uruchamiający może skonfigurować Pythona i prywatne środowisko potrzebne do jej przeprowadzenia. Działanie kontroli konfiguracji
Przeczytaj raport sprzętowy, sprawdź skrypty instalacyjne i upewnij się, że jest dość wolnego miejsca, zanim przejdziesz dalej. Następnie uruchom interaktywną konfigurację:
.\START-HERE.bat
Na pierwszą próbę z 64 GB rozsądnym punktem wyjścia wśród udokumentowanych opcji jest IQ2_XS. Ustaw 32,768 tokenów kontekstu, używaj wyłącznie tekstu i pozostaw Experimental Speed Projection wyłączone. Taka mniejsza konfiguracja bazowa ułatwia diagnozowanie błędów w porównaniu z rozpoczęciem od maksymalnego kontekstu, obrazów i wszystkich włączonych optymalizacji.
Spodziewaj się pobierania plików i instalowania zależności, a nie małego, samodzielnego pliku wykonywalnego. Zależnie od ścieżki GPU konfiguracja używa przygotowanego silnika lub narzędzi kompilacyjnych. Sprawdzaj monity dotyczące sterowników, kompilatorów i uprawnień administratora; nie wyłączaj antywirusa ani zabezpieczeń przeglądarki, żeby wymusić instalację. Wymagany sterownik pobierz od producenta sprzętu.
Przy kolejnych uruchomieniach korzystaj z tego samego programu uruchamiającego. Aby ponownie otworzyć konfigurację lub uniknąć konfliktu portu:
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
W Ubuntu użyj udokumentowanego skryptu konfiguracji
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
Wybierz backend odpowiedni dla GPU. Ścieżki AMD ROCm i NVIDIA CUDA nie są wymienne. Monity menedżera pakietów lub instalatora kompilatora traktuj jako zmiany na własnym komputerze, które wymagają sprawdzenia. Przypięta wersja zapewnia odtwarzalność artykułu; nowsze wydania mogą poprawiać obsługę, dlatego przed świadomą aktualizacją przeczytaj ich informacje o wydaniu.
Potwierdź odpowiedź, zanim podłączysz agenta
Po zakończeniu ładowania otwórz w lokalnej przeglądarce http://127.0.0.1:8080 lub wybrany inny port. Wyślij krótkie, niesensytywne pytanie i sprawdź, czy odpowiedź zostanie wygenerowana do końca. Dopiero potem wypróbuj dłuższy prompt, ponowne użycie pamięci podręcznej dla kontynuacji i docelowy język. Podczas pierwszego ładowania obserwuj użycie pamięci i logi serwera.
Udokumentowane zgodne API obejmuje GET /v1/models i POST /v1/chat/completions. Ustal identyfikator udostępnianego modelu, zamiast wpisywać do innego klienta zgadywany alias:
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
Użyj zwróconego identyfikatora podczas konfiguracji zgodnego klienta. Pomyślne pobranie listy modeli potwierdza ich wykrycie, a nie jakość generowania; istotnym pierwszym testem jest ukończona odpowiedź na czacie. Podczas tej początkowej próby pozostaw agentom wyłączone narzędzia zapisujące pliki lub wykonujące polecenia powłoki.
Jeśli zabraknie pamięci karty, najpierw zmniejsz kontekst i wyłącz obsługę obrazów. Jeśli proces zostanie zabity albo komputer intensywnie używa pliku wymiany, zbadaj pamięć systemową, a nie tylko VRAM. W razie brakujących bibliotek uruchomieniowych sprawdź instrukcje właściwe dla backendu zamiast instalować przypadkowe pliki DLL. Projekt zawiera wskazówki uporządkowane według objawów. Rozwiązywanie problemów ze Strata
Na Macu oddziel obsługę modelu od obsługi Strata
Apple Silicon korzysta ze wspólnej pamięci zamiast odrębnego układu VRAM GPU i RAM systemowego użytego w benchmarku komputera stacjonarnego. Przypięty instalator Strata nie dokumentuje obsługiwanej ścieżki macOS; zgłoszenie prośby o obsługę Maca nie oznacza ukończonego portu. Zgłoszenie dotyczące Maca upstream
Użytkownik Maca może mieć na myśli dwa różne eksperymenty. Społecznościowy fork Strata-macOS zachowuje interfejs i API Pythona oraz dodaje backend Metal dla mniejszych modeli GGUF; udokumentowane testy wykorzystują Qwen2.5, a nie pierwotną konfigurację Flash-Next. Fork wyraźnie nie przenosi strumieniowania ekspertów CUDA ani ścieżki MTP w Strata. Nie traktuj go jako instalacji jednym kliknięciem omawianego tu modelu. Społecznościowy fork i jego zakres
W przypadku samego Qwen3.8-Flash-Next odrębną eksperymentalną ścieżką jest zgodna kompilacja llama.cpp z Metalem i podzielonymi plikami GGUF wydawcy. To nie jest Strata na Macu, a poniższa tabela szybkości dla Windows nie ma tu zastosowania.
Zbuduj osobne środowisko uruchomieniowe Metal
Potrzebny jest Mac z Apple Silicon, natywny terminal ARM64, narzędzia deweloperskie Apple dla wiersza poleceń, Git i CMake. Jeśli brakuje CMake, zainstaluj go z oficjalnej dystrybucji lub z zaufanego menedżera pakietów. Sprawdzona dokumentacja budowania llama.cpp domyślnie włącza Metal w macOS. Przypięcie wersji silnika zapobiega też cichej zmianie przykładu przez przyszłą, ruchomą gałąź. Instrukcje budowania llama.cpp z Metalem
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
Pobierz oba fragmenty IQ2_XS z listy plików wydawcy do jednego katalogu i zachowaj ich oryginalne nazwy. Drugi fragment jest potrzebny również wtedy, gdy jego wiersze wyszukiwania pozostają na dysku. Zastąp poniższą przykładową ścieżkę modelu rzeczywistą ścieżką pierwszego fragmentu na swoim Macu:
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
Wydawca dokumentuje ładowanie podzielonych plików oraz flagi mmap/lazy; sprawdzony silnik udostępnia te opcje. Pozwalają one udostępniać tabelę n-gramową na żądanie, zamiast wymagać jej pełnej rezydencji w pamięci. Są to opcje llama.cpp, a nie opcje programu uruchamiającego Strata. Przykład ładowania GGUF
Pojemność nadal ma znaczenie: główny fragment IQ2_XS ma 39.2 GB, jeszcze przed uwzględnieniem stanu środowiska uruchomieniowego i narzutu macOS. Mac z 16 GB lub 24 GB nie jest zatem wiarygodną konfiguracją bazową dla pełnej rezydencji tego przykładu; nawet 64 GB to punkt wyjścia do planowania, nie gwarancja powodzenia. Sprawdź w Monitorze aktywności presję na pamięć i użycie pliku wymiany, zacznij od kontekstu 4K i przerwij, jeśli presja na pamięć pozostaje wysoka. Nie zmieniaj limitów pamięci jądra, aby wymusić nieudaną konfigurację.
Przed dalszymi eksperymentami potwierdź, że logi wskazują Metal i że tekstowa odpowiedź została wygenerowana do końca. Następnie sprawdź dłuższe prompty, zanim dodasz dekodowanie spekulatywne lub obsługę obrazów. Ta ścieżka nie obejmuje komputerów Mac z Intelem, rozproszonej pracy wielu Maców ani konwersji MLX. Nie podajemy tu wyników przepustowości dla Maca; zależą one od konkretnego układu, wielkości pamięci wspólnej, silnika, kwantyzacji i kontekstu.
Opublikowana szybkość zachęca, ale opóźnienie do pierwszego tokena opowiada inną historię
Na potrzeby odtwarzalnego porównania tabela wykorzystuje benchmark z 29 września 2026 r., silnik 0.1.26, zamiast mieszać go z późniejszymi nagłówkami w README. Komputer testowy miał RTX 5070 z 12 GB, podłączoną przez PCIe 5.0 x16, sześciordzeniowy procesor Ryzen 5 7600, 64 GB DDR5-5200 i Windows 10. Testy używały generowania zachłannego, włączonego MTP, wyłączonych obrazów i 256 generowanych tokenów. Warunki benchmarku
| Wariant | Dekodowanie krótkiego promptu, tokeny/s | Dekodowanie długiego promptu, tokeny/s | Prefill średniego promptu, tokeny/s | Pierwszy token długiego promptu, sekundy |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
Krótkie, średnie i długie poziomy zawierają odpowiednio 3,562, 31,566 i 128,478 tokenów promptu. Każda komórka przedstawia jeden przebieg, a nie średnią z przedziałem ufności. W przebiegu IQ2_XS zastosowano udokumentowane dostrajanie Swift 1.5, nie jest to więc kontrolowane porównanie z modelem bazowym, w którym zmienia się wyłącznie kwantyzacja. Wartości przepisano z opublikowanej macierzy wyników. Pomiary w formacie czytelnym maszynowo
W przypadku Q2_0 z długim promptem na pierwszy token czeka się 62.48 sekundy, mimo że późniejsze dekodowanie osiąga 73.73 tokena/s. Dla osoby czekającej na nowe opracowanie ta pierwsza minuta ma znaczenie. W kontynuowanej rozmowie, w której można ponownie wykorzystać kontekst, wrażenia mogą być inne. Żadnego z tych aspektów nie należy ukrywać za maksymalną deklaracją liczby tokenów na sekundę.
Wartości uzasadniają wąski, lecz użyteczny wniosek: na komputerze stacjonarnym wskazanym przez autora wybrane konfiguracje skwantyzowane osiągnęły interaktywną szybkość generowania. Nie dowodzą jednak takich samych wyników na maszynie o niższej przepustowości, w języku koreańskim, przy próbkowanym rozumowaniu, z włączoną obsługą obrazów ani przy jednoczesnym użyciu przez wiele osób. Tokeny to nie słowa, a tokenizacja zależna od języka dodatkowo utrudnia pobieżne porównania.
Natywna długość kontekstu modelu wynosząca 262,144 tokenów i deklaracje obsługi rozszerzonego kontekstu również nie gwarantują, że wybrana konfiguracja Strata będzie wygodnie obsługiwać taką długość. Nadal liczą się stan środowiska uruchomieniowego, rozmieszczenie pamięci podręcznej i dostępny RAM. Zacznij od małego kontekstu i zwiększaj go dopiero wtedy, gdy obciążenie uzasadnia dodatkowe opóźnienie i zużycie pamięci.
Jakość i funkcje „szybkości” należy sprawdzać osobno
Wydawca kwantyzacji publikuje użyteczne porównania jakości, ale nie są to benchmarki Strata obejmujące cały proces. Przykładowo wynik LiveCodeBench v6 wynosi 87.43 dla BF16 i 81.14 dla Q2_0. To powód, by przetestować istotne dla siebie zadania, a nie powód, by uznać wszystkie wyniki o niskiej precyzji za bezużyteczne albo wszystkie warianty za równoważne. Opublikowana ewaluacja kwantyzacji
Experimental Speed Projection wymaga szczególnej ostrożności. Projekt opisuje opcjonalną funkcję wektora sterującego, która zmienia zachowanie modelu; nie jest to po prostu niewidoczna optymalizacja arytmetyczna. W konfiguracji bazowej pozostaw ją wyłączoną, a przy porównaniach ujawnij, jeśli była używana. Szybsza odpowiedź wynikająca ze zmienionej treści nie jest tym samym pomiarem co szybsze wykonanie równoważnej pracy. Szczegóły funkcji eksperymentalnej
Na potrzeby własnej ewaluacji zapisuj commit repozytorium, wersję silnika, kwantyzację i dostrojenie, GPU i VRAM, CPU, szybkość RAM, SSD, sterownik, ustawienie kontekstu i przełączniki funkcji. Następnie zmierz co najmniej trzy nowe prompty i trzy kontynuacje z pamięcią podręczną, podając medianę i zakres, zamiast wybierać najlepszy przebieg. Zapisuj liczbę tokenów promptu i odpowiedzi wraz z czasem do pierwszego tokena, szybkością dekodowania i całkowitym czasem.
Połącz pomiary szybkości z testami poprawności dla konkretnych zadań: skompiluj i przetestuj kod, porównaj odpowiedź dotyczącą dokumentu z jego treścią, a w wynikach wielojęzycznych sprawdź wymagany język i terminologię. Zapisuj błędy, przekroczenia czasu i wyczerpanie pamięci obok udanych przebiegów.
Lokalne wykonywanie daje kontrolę, ale nie usuwa wszystkich zagrożeń bezpieczeństwa
Pozostaw domyślny adres loopback. Udostępnienie lokalnego serwera modelu w sieci LAN lub Internecie zmienia jego model zagrożeń, a zgodne API nie jest automatycznie usługą uwierzytelnioną. Polityka bezpieczeństwa Strata opisuje lokalne wiązanie i zakres zabezpieczeń, ale nie deklaruje niezależnego zewnętrznego audytu bezpieczeństwa. Polityka bezpieczeństwa Strata
Lokalne generowanie może ograniczyć zależność od hostowanego dostawcy inferencji, ale prywatność wciąż zależy od całego przepływu pracy. Logi czatu, aplikacje klienckie, wyszukiwanie w sieci, narzędzia zewnętrzne i kopie zapasowe mogą wysyłać lub przechowywać dane poza procesem modelu. Zanim przekażesz agentowi poufne dokumenty, sprawdź te ścieżki. „Działa lokalnie” to użyteczna cecha architektury, a nie pełna certyfikacja prywatności.
Licencjonowanie również ma kilka warstw. Licencja kodu Strata nie zastępuje warunków qwen-community-1.0 dotyczących modelu. Kwantyzacja wag nie znosi zobowiązań związanych z pierwotnym modelem. Przed redystrybucją lub komercyjnym wdrożeniem przeczytaj odpowiednie licencje, zamiast zakładać, że otwarte repozytorium oznacza nieograniczone użycie. Licencja modelu Qwen
Wniosek: inny rodzaj osobistego komputera AI
Najważniejszy wniosek nie jest taki, że inferencja w chmurze stała się przestarzała. Komputer stacjonarny nadal ma ograniczenia dotyczące obsługi wielu użytkowników, czasu do pierwszego tokena, zużycia energii, utrzymania i jakości modelu. System hostowany może wciąż być lepszym wyborem, gdy dostępność lub duża liczba zapytań jest ważniejsza niż kontrola nad środowiskiem wykonywania.
Strata sugeruje, że inferencję konsumencką może ograniczać koordynacja w takim samym stopniu jak pojemność GPU. Lepsze wykorzystanie CPU, RAM i rzadkiego dostępu do pamięci masowej może otworzyć drogę klasie modeli, którą odrzuciłyby uproszczone obliczenia zakładające pełną rezydencję w GPU. Przepustowość pamięci systemowej staje się częścią specyfikacji komputera AI, a nie kwestią drugorzędną.
To wniosek wynikający z architektury i opublikowanych rezultatów, a nie gwarancja dotycząca każdego przyszłego modelu. Zależy od tego, czy modele udostępniają rzadkie, buforowalne lub zorientowane na wyszukiwanie komponenty, które środowisko uruchomieniowe potrafi wykorzystać. Gęsty model o innych wzorcach dostępu nie odziedziczy tej samej korzyści tylko dlatego, że ma podobną liczbę parametrów.
Dla indywidualnego badacza lub programisty realistycznym kolejnym krokiem jest ograniczony pilotaż: przypięta wersja, krótki kontekst, obsługiwana maszyna, kilka reprezentatywnych zadań oraz rzetelny zapis jakości i opóźnień. Etap ten jest wartościowy właśnie wtedy, gdy opisuje się go w ten sposób. Bardzo duży model stał się wiarygodnym obciążeniem dla komputera stacjonarnego dzięki starannemu rozmieszczeniu i weryfikacji, a nie zniknięciu ograniczeń sprzętowych.
Zapisuj decyzje konfiguracyjne razem z notatkami badawczymi
Porównując lokalne konfiguracje AI, przechowuj razem odnośniki do źródeł, szczegóły sprzętu, obserwacje i nierozstrzygnięte pytania. Telli.sh może pomóc uporządkować te notatki i podsumowania, nie sugerując wbudowanej integracji ze Strata. Utwórz konto Telli.sh