Strata와 Qwen3.8-Flash-Next: 180B급 모델을 개인용 PC에서 실행하는 방법
Strata의 아키텍처, Windows와 Linux 설정, 별도의 Apple Silicon Mac 경로, 공개 벤치마크와 로컬 AI의 한계를 출처와 함께 살펴봅니다.
약 1,800억 개의 파라미터를 가진 모델이 12GB 그래픽카드가 장착된 데스크톱에서 실행된다고 하면 모순처럼 들립니다. Strata는 그 가능성을 보여주지만, 모든 파라미터를 그래픽카드에 욱여넣는 방식은 아닙니다. 더 흥미로운 성과는 희소 모델의 서로 다른 부분이 각기 다른 메모리와 연산 자원을 사용하게 하면서, 생성되는 토큰마다 저장장치 전송이 병목이 되지 않도록 한 데 있습니다.
공식 모델 이름은 Qwen3.8-Next-Flash가 아니라 Qwen3.8-Flash-Next입니다. Qwen은 1,250억 개 파라미터에 60억 개 활성 파라미터를 사용하는 코어, 추가로 510억 개의 n-gram 임베딩 구성요소, 그리고 멀티 토큰 예측용 40억 개 파라미터를 명시합니다. 반올림한 총 1,800억이라는 수치는 저장된 구성요소의 규모이지, 토큰마다 수행되는 밀집 연산의 양이 아닙니다. Qwen 모델 카드
아래 설정 및 성능 정보는 Strata 리비전 fb58e0dbc8399662c0e47c76578c6e878b14f6cf를 기준으로 합니다. 벤치마크 수치는 프로젝트가 공개한 측정값이며, 하드웨어·프롬프트·컨텍스트·모델 변형에 따라 결과가 달라질 수 있습니다.
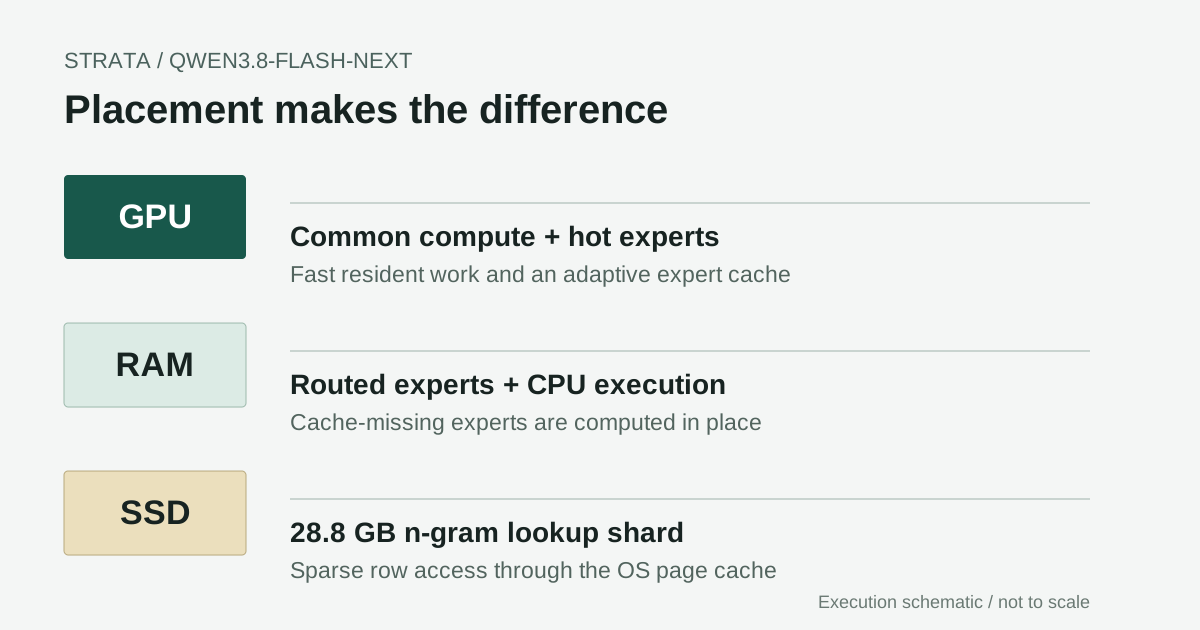
문서화된 실행 설계를 바탕으로 만든 원본 개념도입니다. 각 계층은 축척에 맞춰 그리지 않았습니다. 다운로드 크기, RAM 사용량, GPU 상주량은 서로 다른 값입니다.
돌파구는 더 작은 모델이 아니라 배치 방식입니다
이례적으로 큰 로컬 모델을 볼 때는 세 가지를 물어야 합니다. 저장해야 할 양은 얼마인지, 토큰 하나를 처리할 때 실제로 활성화되는 양은 얼마인지, 그리고 활성 작업은 어디에서 실행되는지입니다. 활성 파라미터 수가 작다는 것은 두 번째 질문에만 답합니다. 나머지 가중치를 접근 가능한 어딘가에 보관해야 한다는 요구까지 없애지는 못합니다.
Strata는 Niko1221 저장소의 커뮤니티 개발 추론 엔진이자 로컬 서빙 애플리케이션입니다. 문서화된 설정은 Windows와 Linux 설치, 로컬 채팅 인터페이스, 호환 API, 선택적 이미지 입력을 제공합니다. 공식 Qwen 데스크톱 제품이 아닌 별도의 커뮤니티 프로젝트입니다. Strata 저장소
유용한 엔지니어링 관점의 전환은 PC를 메모리가 부족한 GPU로만 보지 않는 것입니다. 데스크톱에는 시스템 RAM, CPU 벡터 연산 장치, 운영체제 페이지 캐시도 있습니다. 일부 작업에서는 이 자원이 GPU 메모리보다 느리지만, 모든 작업에 똑같이 부적합한 것은 아닙니다. 대규모 테이블 조회와 밀집 행렬 곱셈에 같은 배치 정책을 적용할 필요는 없습니다.
이 차이가 핵심을 흥미롭게 만듭니다. 모델 자체는 여전히 크지만, 런타임이 특정 순간에 가장 빠른 메모리에 두어야 하는 양을 바꿉니다. 덕분에 일반 노트북마다 원활히 실행된다는 증명 없이도 실용적인 로컬 추론 경로가 열립니다.
희소 아키텍처가 가능성을 만듭니다
Qwen 아키텍처는 순환 방식의 Gated DeltaNet 블록과 Qwen Sparse Attention, 라우팅되는 전문가, n-gram 임베딩을 결합합니다. 기술 보고서는 이 구성요소들이 더 효율적으로 확장되도록 설계된 이유를 설명합니다. Strata가 이 모델 구성요소를 발명한 것은 아닙니다. 각 구성요소의 서로 다른 접근 패턴에 맞춘 실행 전략을 구축합니다. Qwen 아키텍처 보고서
라우팅 세부사항은 중요합니다. 48개 각 레이어에는 라우팅 전문가가 512개 있고, 레이어마다 라우팅 전문가 10개와 공유 전문가 하나가 활성화됩니다. 따라서 레이어 전체에 걸쳐 저장되는 라우팅 전문가는 24,576개입니다. 그렇다고 토큰 하나를 처리할 때 모델 전체의 라우팅 전문가 24,576개 중 단 10개만 사용된다는 뜻은 아닙니다. Qwen 아키텍처 구성
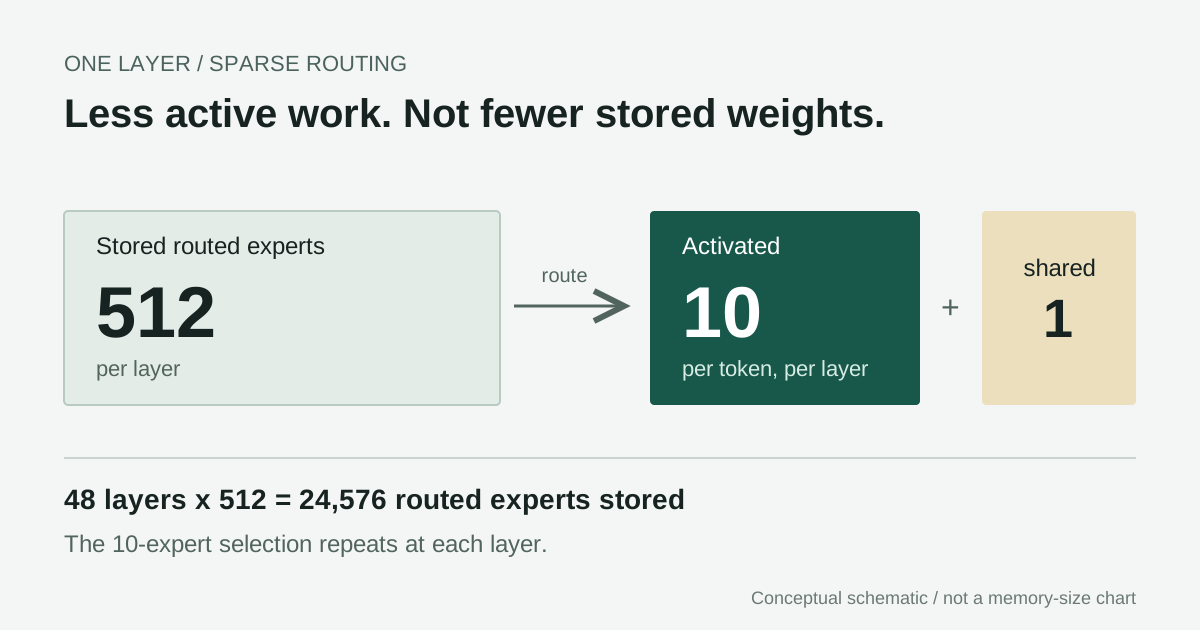
선택은 활성 작업을 줄일 뿐, 저장된 전체 전문가를 줄이지 않습니다. 이 그림은 48개 전체 레이어가 아니라 단일 레이어를 나타냅니다.
속도 주장을 떠나 이 구조의 결과를 생각해 보겠습니다. 거의 선택되지 않는 전문가를 값비싼 가속기 메모리에 계속 두는 것은 용량을 비효율적으로 쓰는 방법일 수 있습니다. 반대로 매 단계마다 사용되는 구성요소를 계속 옮기면 비용이 커집니다. 유용한 스케줄러는 두 경우를 구분하고, 피할 수 없는 캐시 미스를 관리해야 합니다.
따라서 희소한 180B급 모델을 파라미터 수만으로 밀집 180B 모델과 비교해서는 안 됩니다. 반대로 이를 “6B 모델”이라고 부르면 저장 공간, 라우팅, 컨텍스트 상태, 분산된 가중치 접근 비용이 가려집니다. 두 가지 단순화 모두 실제 엔지니어링 문제를 흐립니다.
GPU, RAM, SSD는 서로 다른 일을 맡습니다
문서화된 기본 구성에서 GPU는 공통 연산과 자주 쓰이는 라우팅 전문가 캐시를 담당합니다. 시스템 RAM에는 라우팅 전문가 가중치를 두고, CPU가 GPU 캐시에 없는 전문가를 그 자리에서 계산합니다. 별도의 메모리 매핑 n-gram 테이블은 SSD에 두며, 필요한 행은 운영체제 캐시를 통해 제공합니다. Strata 실행 개요
이 CPU 경로는 일반적인 “오프로딩”이라는 말보다 중요합니다. 디코딩 중 캐시 미스가 발생해도 계속 진행하기 전에 누락된 전문가를 전부 GPU로 복사할 필요는 없습니다. CPU와 GPU 작업을 겹쳐 실행할 수 있습니다. 대신 CPU 성능과 시스템 메모리 대역폭이 출력 속도에 직접 영향을 줍니다.
n-gram 구성요소는 또 다른 접근 패턴을 갖습니다. 몇 개의 행을 조회하는 작업과 테이블 전체를 훑는 작업은 같지 않습니다. 따라서 양자화된 28.8GB 조회 샤드를 SSD에 두는 방식은 실용적일 수 있으며, 토큰을 생성할 때마다 모델 전체를 디스크에서 읽는다는 뜻은 아닙니다. 다만 느린 드라이브나 페이지 캐시에 대한 과도한 압박은 반응성을 떨어뜨릴 수 있습니다.
프리필(prefill)과 디코딩도 다릅니다. 최초 프롬프트를 처리할 때는 더 큰 배치를 사용하고 전문가 전송을 다른 레이어 작업과 겹칠 여지가 있습니다. 반면 다음 토큰을 반복해서 생성하는 작업은 지연시간에 민감합니다. 프로젝트의 상세 문서는 각 단계의 서로 다른 커널, 스케줄링, 캐시 동작을 설명합니다. 하나의 처리량 수치로 두 단계를 모두 요약할 수는 없습니다. Strata 구현 상세
요약하면 각 계층이 담당하는 역할은 분명합니다. 양자화는 가중치의 저장 크기를 줄이고, 캐싱은 자주 쓰이는 가중치의 반복 접근을 줄이며, CPU 실행은 캐시 미스를 처리하고, 희소 조회는 방대한 테이블 전체를 한꺼번에 메모리에 올리지 않게 합니다. 이 이점 중 하나라도 빠지면 메모리가 넉넉하지 않은 데스크톱은 훨씬 덜 설득력 있는 실행 환경이 됩니다.
추측은 검증이 받아들일 때만 작업을 줄입니다
Strata는 모델의 멀티 토큰 예측 구성요소를 사용해 짧은 연속 토큰을 제안하고 대상 모델로 검증하기도 합니다. 출력 토큰마다 대상 모델의 전체 패스를 수행하는 대신, 초안이 맞으면 한 번의 패스에서 여러 토큰을 승인할 수 있습니다. 저장소는 MTP 경로에서 최대 세 토큰의 초안을 설명합니다. MTP 설계 및 구현
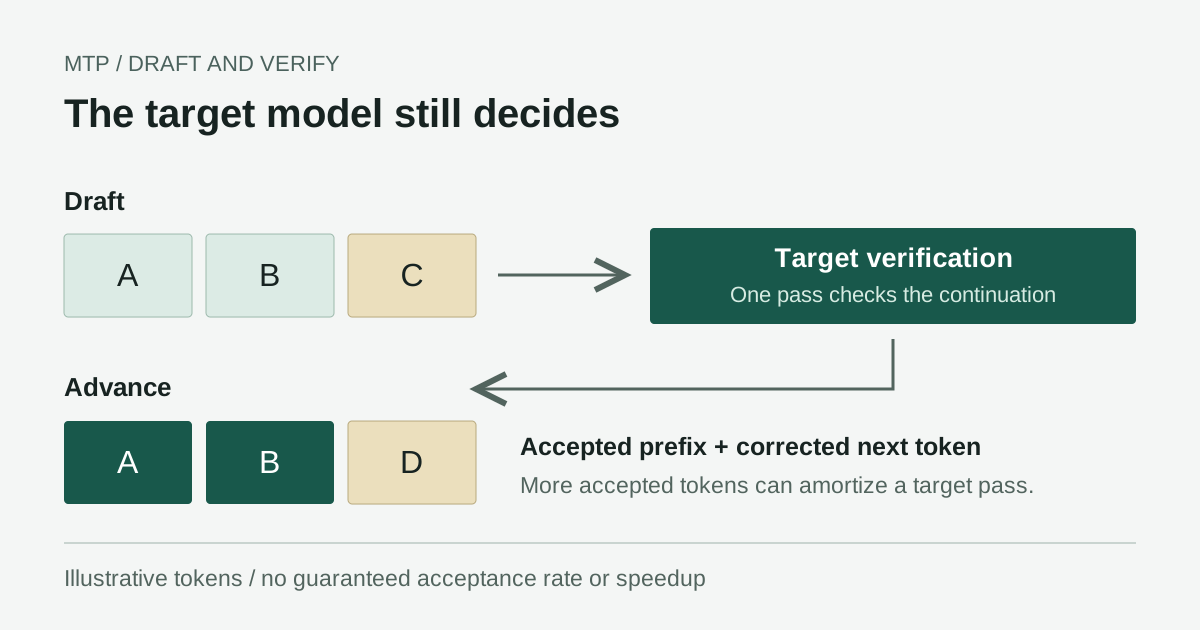
이 예시는 검증 과정을 보여줄 뿐, 승인율이나 속도 향상을 보장하거나 측정한 결과가 아닙니다.
이는 조건부 가속입니다. 예측 가능한 코드나 반복 문장은 낯선 추론 전환보다 초안으로 만들기 쉽습니다. 프롬프트 문구, 샘플링, 출력 길이, 모델 변형에 따라 승인율이 달라질 수 있습니다. 따라서 한 프롬프트에서 측정한 대표 수치를 다른 언어나 작업에도 그대로 적용해서는 안 됩니다.
검증은 실제 실행 중인 모델을 대상으로 합니다. 양자화로 손실된 정보를 되돌리지 않으며, 원본 BF16 가중치와 동등하다는 점도 입증하지 않습니다. 두 문제를 구분해야 합니다. 추측 실행과 낮은 정밀도의 모델 품질은 서로 다른 질문에 답합니다.
캐시 재사용도 별도로 봐야 합니다. 바뀌지 않은 대화 앞부분을 재사용하면 반복 작업을 줄일 수 있지만, 캐시가 따뜻한 후속 질문과 새로 시작하는 긴 프롬프트는 동등한 테스트가 아닙니다. 로컬 결과를 비교할 때 앞부분을 재사용했는지 기록하세요. 프로젝트 문서는 메시지 경계 캐시를 명시적으로 설명합니다. 접두부 캐시 동작
“12GB GPU”가 설치 용량 12GB를 뜻하지는 않습니다
공개 GGUF 양자화 파일은 메인 샤드와 고정 크기 28.8GB n-gram 샤드로 나뉩니다. 아래 파일 크기는 십진 GB 기준 다운로드 크기이지 GPU 메모리 요구량이 아닙니다. 선택형 비전 프로젝터는 약 0.91GB를 추가하며, 보조 다운로드와 임시 변환 파일을 위한 공간도 필요합니다. ISTA-DASLab 양자화 파일
| 변형 | 코어 가중치당 평균 비트 수 | 메인 샤드 | n-gram 샤드 | 전체 다운로드 |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
형식 이름만으로 모든 텐서를 정확히 설명할 수는 없습니다. 메인 샤드는 혼합 형식을 사용하고, n-gram 샤드는 IQ4_NL을 사용합니다. “2비트 모델”은 편리한 약칭이지만, 전체 다운로드가 파라미터당 정확히 2비트를 사용한다고 이해하면 오해를 부릅니다. 양자화 방법론
첫 전체 모델 테스트를 계획한다면 지원되는 12GB 이상 GPU와 시스템 RAM 64GB를 GPU 용량만 보는 것보다 현실적인 기준으로 삼으세요. 저장소는 RAM을 줄이는 경로와 가지치기된 Coder 변형도 설명합니다. 이는 별도의 구성이지, 32GB 시스템에서도 동일한 전체 모델 사용 경험을 제공한다는 증거는 아닙니다. Strata 모델 선택
실험 전에 SSD 여유 공간을 100~150GB 확보하는 편이 좋습니다. 이는 고정된 공급업체 요구사항이 아니라 보수적인 계획치입니다. 실제 총량은 선택한 양자화, MTP 보조 모델, 선택형 비전 파일, 빌드 및 변환 캐시에 따라 달라집니다. 일부 Q2 CPU 최적화 경로는 전문가 가중치 사본을 상당량 추가로 요구할 수 있습니다. 하나의 디스크 용량이 모든 경우에 통한다고 가정하지 말고 선택한 경로를 확인하세요.
하드웨어를 고르기 전에 필요한 구성을 정하세요. 전체 모델인지 가지치기 모델인지, 짧은 컨텍스트인지 긴 컨텍스트인지, 비전을 쓸지 텍스트만 쓸지, 지속적인 처리량이 필요한지 간헐적 사용인지가 중요합니다. 이 선택에 따라 병목이 달라지며, 아래 벤치마크는 특정 시스템 하나의 결과입니다.
튜닝하기 전에 버전을 고정한 기본 구성을 설치하세요
문서화된 기본 경로는 Windows 10/11과 Ubuntu 22.04/24.04, 지원되는 NVIDIA 및 일부 AMD GPU를 대상으로 합니다. NVIDIA 안내는 드라이버 580 이상을 지정합니다. macOS와 소스 빌드 백엔드에는 별도 요구사항이 있으므로, 아래 명령이 모든 환경에 통용되는 설정 방법은 아닙니다. 공식 설치 안내
Windows에서는 내려받기 전에 확인하세요
Git이 없다면 공식 배포본에서 설치합니다. PowerShell에서 업스트림 저장소를 복제하고 여기서 검토한 리비전을 고정합니다.
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
이 확인 단계에서는 대용량 모델을 내려받지 않지만, 런처가 Python과 별도 환경을 준비할 수 있습니다. 설정 확인 동작
하드웨어 보고서를 읽고, 설정 스크립트를 살펴보고, 계속하기 전에 여유 공간을 확인합니다. 그런 다음 대화형 설정을 시작합니다.
.\START-HERE.bat
첫 64GB 시스템 테스트에는 문서에서 선택 가능한 IQ2_XS가 합리적인 출발점입니다. 컨텍스트는 32,768토큰, 텍스트 전용으로 설정하고 Experimental Speed Projection은 끄세요. 이 작은 기본 구성으로 시작하면 최대 컨텍스트, 비전, 모든 최적화를 처음부터 켜는 것보다 문제를 분리하기 쉽습니다.
작은 독립 실행 파일 하나가 아니라 다운로드와 의존성 설치가 필요합니다. GPU 경로에 따라 준비된 엔진이나 빌드 도구를 사용할 수 있습니다. 드라이버, 컴파일러, 관리자 권한에 관한 안내는 검토하세요. 설치를 강행하려고 바이러스 백신이나 브라우저 보호를 끄지 마세요. 필요한 드라이버는 하드웨어 제조업체에서 받으세요.
이후 실행에도 같은 런처를 사용합니다. 설정을 다시 열거나 포트 충돌을 피하려면 다음 명령을 사용합니다.
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
Ubuntu에서는 문서화된 설정 스크립트를 사용하세요
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
GPU에 맞는 백엔드를 선택하세요. AMD ROCm 경로와 NVIDIA CUDA 경로는 서로 바꿔 쓸 수 없습니다. 패키지 관리자나 컴파일러 설치 안내는 자신의 시스템을 변경하는 작업이므로 검토해야 합니다. 고정된 리비전은 이 글을 재현할 수 있게 합니다. 이후 버전에서 지원이 개선될 수 있으니 의도적으로 업그레이드하기 전에 릴리스 노트를 읽으세요.
에이전트를 연결하기 전에 응답을 확인하세요
모델 로딩이 끝나면 로컬 브라우저에서 http://127.0.0.1:8080 또는 선택한 대체 포트를 엽니다. 민감하지 않은 짧은 질문을 보내고 답변이 완료되는지 확인하세요. 그런 다음 긴 프롬프트, 후속 질문의 캐시 재사용, 실제 사용 언어를 시험합니다. 첫 로딩 중에는 메모리 사용량과 서버 로그를 확인하세요.
문서화된 호환 API에는 GET /v1/models와 POST /v1/chat/completions가 포함됩니다. 다른 클라이언트에 추측한 별칭을 입력하지 말고, 실제 제공되는 모델 식별자를 확인하세요.
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
호환 클라이언트를 설정할 때 반환된 식별자를 사용합니다. 모델 목록 조회 성공은 모델을 찾았다는 뜻이지 생성 품질이 확인됐다는 뜻은 아닙니다. 실제로 완료된 채팅 응답이 첫 번째로 의미 있는 확인입니다. 초기 테스트에서는 파일 쓰기나 셸 실행이 가능한 에이전트 도구를 비활성화하세요.
GPU 메모리가 부족하면 먼저 컨텍스트를 줄이고 비전을 끄세요. 프로세스가 종료되거나 시스템이 과도하게 스와핑한다면 VRAM만이 아니라 시스템 RAM도 살펴보세요. 런타임 라이브러리가 없다면 임의의 DLL을 설치하는 대신 백엔드별 안내를 확인하세요. 프로젝트는 증상별 문제 해결 안내를 제공합니다. Strata 문제 해결
Mac에서는 모델 실행 가능성과 Strata 지원을 구분해야 합니다
Apple Silicon은 데스크톱 벤치마크의 GPU 전용 VRAM과 시스템 RAM 구성 대신 통합 메모리를 사용합니다. 고정된 Strata 설치 프로그램에는 지원되는 macOS 경로가 문서화되어 있지 않으며, Mac 지원 요청은 포팅이 완료됐다는 뜻이 아닙니다. 업스트림 Mac 요청
Mac 사용자가 말하는 실험은 서로 다른 두 가지일 수 있습니다. 커뮤니티 Strata-macOS 포크는 더 작은 GGUF 모델을 위한 Metal 백엔드와 함께 인터페이스 및 Python API를 유지합니다. 문서화된 테스트는 원래 Flash-Next 구성이 아니라 Qwen2.5를 사용합니다. 이 포크는 Strata의 CUDA 전문가 스트리밍이나 MTP 경로를 이식하지 않았다고 명시합니다. 이를 이 글에서 다루는 모델의 원클릭 설치 방법으로 여기지 마세요. 커뮤니티 포크와 범위
Qwen3.8-Flash-Next 자체를 위한 별도의 실험 경로는 게시자의 분할 GGUF 파일을 사용하는 호환 llama.cpp Metal 빌드입니다. 이는 Mac의 Strata가 아니며, 아래 Windows 속도 표도 적용되지 않습니다.
별도의 Metal 런타임을 빌드하세요
Apple Silicon Mac, 네이티브 ARM64 터미널, Apple 명령줄 개발자 도구, Git, CMake가 필요합니다. CMake가 없다면 공식 배포본이나 신뢰하는 패키지 관리자를 통해 설치합니다. 검토한 llama.cpp 빌드 문서에 따르면 macOS에서는 기본적으로 Metal을 활성화합니다. 엔진 리비전을 고정하면 예제가 이후의 가변 브랜치 변경으로 조용히 달라지는 일도 방지할 수 있습니다. llama.cpp Metal 빌드 안내
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
게시자의 파일 목록에서 IQ2_XS 샤드 두 개를 모두 내려받아 하나의 디렉터리에 원래 파일 이름을 유지한 채 둡니다. 조회 행을 디스크에 둔다고 해도 두 번째 샤드가 필요합니다. 아래 예시 모델 경로를 Mac에 있는 실제 첫 번째 샤드의 경로로 바꾸세요.
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
게시자는 분할 파일 로딩과 mmap/lazy 플래그를 문서화했으며, 검토한 엔진은 해당 옵션을 제공합니다. 이 옵션을 사용하면 n-gram 테이블 전체를 상주시키지 않고 필요할 때 접근할 수 있습니다. 이 옵션은 llama.cpp 옵션이지 Strata 런처 옵션이 아닙니다. GGUF 로딩 예시
메모리 용량은 여전히 중요합니다. IQ2_XS의 메인 샤드는 런타임 상태와 macOS 오버헤드를 더하기 전에도 39.2GB입니다. 따라서 16GB 또는 24GB Mac은 이 예시에서 전체 모델을 상주시킬 현실적인 기준이 아닙니다. 64GB도 계획 수립을 위한 출발점일 뿐, 성공을 보장하지 않습니다. 활성 상태 보기에서 메모리 압력과 스왑을 확인하고 4K 컨텍스트로 시작하세요. 메모리 압력이 계속 높으면 중단하세요. 실행되지 않는 모델을 억지로 맞추려고 커널 메모리 제한을 바꾸지 마세요.
로그에서 Metal이 선택되고 텍스트 전용 답변이 일관되게 완료되는지 확인한 뒤 추가 실험을 진행하세요. 이후 프롬프트를 늘려 시험하고, 추측 디코딩이나 비전을 추가하세요. 이 경로는 Intel Mac, 여러 Mac의 분산 실행, MLX 변환을 다루지 않습니다. Mac 처리량 수치는 제시하지 않습니다. 결과는 칩, 통합 메모리 용량, 엔진, 양자화, 컨텍스트에 따라 달라집니다.
공개된 생성 속도는 고무적이지만 첫 토큰 지연은 다른 이야기를 들려줍니다
재현 가능한 비교를 위해 이후 README에 나온 수치를 섞지 않고 2026년 9월 29일자 엔진 0.1.26 벤치마크를 사용합니다. 테스트 장비는 PCIe 5.0 x16 연결 RTX 5070 12GB, 6코어 Ryzen 5 7600, DDR5-5200 64GB, Windows 10이었습니다. 테스트는 greedy 생성, MTP 켬, 이미지 끔, 생성 토큰 256개 조건이었습니다. 벤치마크 조건
| 변형 | 짧은 프롬프트 디코딩, 토큰/초 | 긴 프롬프트 디코딩, 토큰/초 | 중간 프롬프트 프리필, 토큰/초 | 긴 프롬프트 첫 토큰, 초 |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
짧음, 중간, 김 단계에는 각각 프롬프트 토큰 3,562개, 31,566개, 128,478개가 포함됩니다. 각 칸은 신뢰구간을 포함한 평균이 아니라 한 번의 실행 결과입니다. IQ2_XS 실행에는 문서화된 Swift 1.5 파인튜닝 버전을 사용했으므로 기본 모델과 양자화만 통제한 비교가 아닙니다. 값은 공개된 결과 매트릭스에서 옮겼습니다. 기계 판독 가능한 측정값
Q2_0의 긴 프롬프트 사례는 이후 디코딩 속도가 초당 73.73토큰인데도 첫 토큰을 받기까지 62.48초가 걸립니다. 새 문서의 답을 기다리는 사용자에게는 그 첫 1분이 중요합니다. 컨텍스트를 재사용하는 대화는 체감이 다를 수 있습니다. 토큰/초 최대치만 앞세워 어느 쪽도 감춰서는 안 됩니다.
이 수치가 뒷받침하는 결론은 제한적이지만 유용합니다. 저자가 명시한 데스크톱에서 일부 양자화 구성이 대화형 생성 속도를 보였습니다. 하지만 대역폭이 더 낮은 시스템, 한국어, 샘플링을 사용하는 추론, 비전을 켠 상태, 동시 사용자 환경에서도 같은 결과가 난다는 뜻은 아닙니다. 토큰은 단어와 다르며, 언어별 토큰화도 단순 비교를 어렵게 합니다.
모델의 기본 262,144토큰 컨텍스트와 확장 컨텍스트 관련 주장도 선택한 Strata 구성에서 그 길이를 무리 없이 제공할 수 있다는 보장은 아닙니다. 런타임 상태, 캐시 배치, 가용 RAM이 여전히 중요합니다. 추가 지연과 메모리가 필요한 만큼의 작업인지 확인하면서 짧은 컨텍스트부터 시작하세요.
품질과 ‘속도’ 기능은 따로 확인해야 합니다
양자화 게시자는 유용한 품질 비교를 공개하지만, 이는 Strata 종단 간 벤치마크가 아닙니다. 예를 들어 LiveCodeBench v6 점수는 BF16 87.43, Q2_0 81.14입니다. 이는 관심 있는 작업으로 직접 시험해야 할 이유이지, 모든 저비트 출력이 쓸 수 없다거나 모든 변형이 동등하다고 단정할 이유가 아닙니다. 공개된 양자화 평가
Experimental Speed Projection은 특히 주의해서 다뤄야 합니다. 프로젝트 설명에 따르면 모델 동작을 바꾸는 선택형 제어 벡터 기능이지, 눈에 보이지 않는 단순 연산 최적화가 아닙니다. 기본 비교에서는 끄고, 사용한다면 공개하세요. 콘텐츠가 바뀌어서 답변이 빨라진 것은 동등한 작업을 더 빨리 실행한 측정과 다릅니다. 실험 기능 세부사항
직접 평가할 때는 저장소 커밋, 엔진 버전, 양자화와 파인튜닝 버전, GPU와 VRAM, CPU, RAM 속도, SSD, 드라이버, 컨텍스트 설정, 기능 토글을 기록하세요. 캐시가 없는 새 프롬프트 세 개 이상과 캐시된 후속 질문 세 개 이상을 측정하고, 가장 좋은 실행 결과 하나를 고르는 대신 중앙값과 범위를 보고하세요. 프롬프트와 출력 토큰 수를 첫 토큰까지의 시간, 디코딩 속도, 전체 경과 시간과 함께 남기세요.
속도 점검과 함께 작업별 정확성도 확인하세요. 코딩 답변은 컴파일하고 테스트하며, 문서 답변은 원문과 대조하고, 다국어 출력은 요청한 언어와 용어가 맞는지 검증합니다. 성공 사례와 함께 실패, 시간 초과, 메모리 부족도 기록하세요.
로컬 실행은 통제력을 높여도 모든 보안 위험을 없애지는 않습니다
기본 루프백 주소를 유지하세요. 로컬 모델 서버를 LAN이나 인터넷에 노출하면 위협 모델이 달라집니다. 호환 API가 자동으로 인증되는 서비스인 것도 아닙니다. Strata 보안 정책은 로컬 바인딩과 보안 범위를 설명하지만, 독립적인 외부 보안 감사를 받았다고 주장하지 않습니다. Strata 보안 정책
로컬 생성은 호스팅 추론 제공업체에 대한 의존도를 낮출 수 있지만, 개인정보 보호는 전체 작업 흐름에 달려 있습니다. 채팅 로그, 클라이언트 애플리케이션, 웹 검색, 외부 도구, 백업은 모델 프로세스 외부로 데이터를 전송하거나 보관할 수 있습니다. 기밀 문서를 에이전트에 넣기 전에 이러한 경로를 확인하세요. “로컬에서 실행된다”는 것은 유용한 아키텍처 정보일 뿐, 완전한 개인정보 보호 인증은 아닙니다.
라이선스도 여러 겹입니다. Strata 코드 라이선스가 모델의 qwen-community-1.0 약관을 대체하지 않습니다. 양자화 가중치에도 원본 모델의 의무가 적용됩니다. 재배포하거나 상업적으로 배포하기 전에 해당 라이선스를 읽으세요. 공개 저장소라고 해서 제한 없이 사용할 수 있다고 가정하지 마세요. Qwen 모델 라이선스
개인용 AI 컴퓨터의 의미가 달라지고 있습니다
가장 중요한 시사점은 클라우드 추론이 쓸모없어졌다는 것이 아닙니다. 데스크톱에는 동시 서빙, 첫 토큰 지연, 전력 사용량, 유지관리, 모델 품질의 한계가 남아 있습니다. 실행 환경에 대한 통제보다 가용성이나 높은 요청량이 더 중요하다면 호스팅 시스템이 계속 더 나은 선택일 수 있습니다.
Strata가 보여주는 가능성은 소비자용 추론이 GPU 용량만큼이나 자원 오케스트레이션의 영향을 받을 수 있다는 점입니다. CPU와 RAM, 희소 저장소 접근을 더 잘 활용하면 단순히 모든 것을 GPU에 올린다는 계산으로는 배제했을 모델을 실행할 수 있습니다. 시스템 메모리 대역폭은 AI 컴퓨터 사양의 부차적인 항목이 아니라 일부가 됩니다.
이는 아키텍처와 공개 결과에서 도출한 추론이지, 앞으로 나올 모든 모델에 대한 보장은 아닙니다. 런타임이 활용할 수 있는 희소 구성요소, 캐시 가능한 구성요소, 조회 중심 구성요소를 모델이 제공해야 합니다. 접근 패턴이 다른 밀집 모델은 파라미터 수가 비슷하다는 이유만으로 같은 이점을 얻지 못합니다.
개별 연구자나 개발자에게 현실적인 다음 단계는 범위를 제한한 파일럿입니다. 버전을 고정하고, 짧은 컨텍스트와 지원되는 장비를 사용해 대표 작업 몇 가지를 수행하고, 품질과 지연 시간을 솔직하게 기록하세요. 이 이정표는 그런 방식으로 설명할 때 의미가 있습니다. 매우 큰 모델이 데스크톱에서 실행 가능한 작업이 된 것은 하드웨어 제약이 사라져서가 아니라, 신중한 배치와 검증 덕분입니다.
설정 결정과 연구 기록을 함께 보관하세요
로컬 AI 구성을 비교할 때 출처 링크, 하드웨어 세부사항, 관찰 결과, 해결되지 않은 질문을 한곳에 모아두세요. Telli.sh는 내장 Strata 연동 기능을 내세우지 않으면서 관련 메모와 요약을 정리하는 데 도움을 줄 수 있습니다. Telli.sh 계정 만들기