Strata e Qwen3.8-Flash-Next: come gira su un PC personale un modello di classe 180B
Una guida verificata sulle fonti all'architettura di Strata, alla configurazione su Windows e Linux, al percorso separato per Mac Apple Silicon, ai benchmark pubblicati e ai limiti dell'IA locale.
Far funzionare su un PC desktop con una scheda grafica da 12 GB un modello da circa 180 miliardi di parametri sembra una contraddizione. Strata rende plausibile questa possibilità, ma non comprimendo tutti i parametri nella scheda. Il suo risultato più interessante è distribuire diverse parti di un modello sparso tra tipi diversi di memoria e di calcolo, senza trasformare ogni token generato in un trasferimento di dati che fa da collo di bottiglia.
Il nome ufficiale del modello è Qwen3.8-Flash-Next, non Qwen3.8-Next-Flash. Qwen indica un nucleo da 125B parametri, di cui 6B attivati, un componente aggiuntivo di embedding n-gram da 51B e 4B per la predizione multi-token. Il totale arrotondato di 180B descrive i componenti memorizzati; non è la quantità di calcolo denso eseguita per ogni token. Scheda del modello Qwen
La configurazione e i dati prestazionali seguenti si riferiscono alla revisione Strata fb58e0dbc8399662c0e47c76578c6e878b14f6cf. I dati del benchmark sono misurazioni pubblicate dal progetto; hardware, prompt, contesto e variante del modello possono produrre risultati diversi.
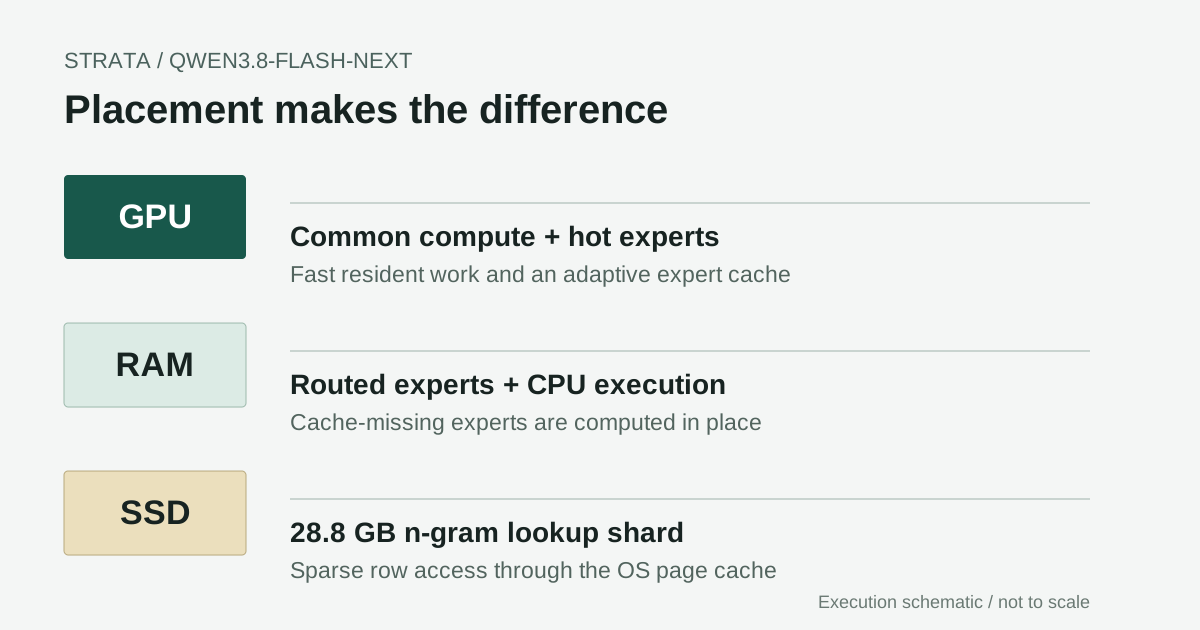
Schema originale basato sul progetto di esecuzione documentato. I livelli non sono in scala: dimensione del download, uso della RAM e presenza nella memoria GPU sono grandezze diverse.
Il passo avanti è il posizionamento, non un modello più piccolo
Per qualsiasi modello locale insolitamente grande occorre porsi tre domande: quanto bisogna memorizzare, quanto è attivo per un token e dove viene eseguito il lavoro attivo? Un numero ridotto di parametri attivi risponde solo alla seconda domanda. Non elimina la necessità di conservare gli altri pesi in una posizione accessibile.
Strata è un motore di inferenza e un'applicazione di serving locale sviluppati dalla community e disponibili nel repository Niko1221. La configurazione documentata offre installazione per Windows e Linux, un'interfaccia di chat locale, API compatibili e input di immagini facoltativo. È un progetto community indipendente, non un prodotto desktop ufficiale di Qwen. Repository Strata
Il cambiamento ingegneristico utile consiste nello smettere di considerare il PC come una GPU con memoria insufficiente. Un desktop dispone anche di RAM di sistema, unità vettoriali della CPU e cache delle pagine del sistema operativo. Queste risorse sono più lente della memoria GPU per alcune operazioni, ma non sono tutte ugualmente inadatte a ogni operazione. Una ricerca in una grande tabella e una moltiplicazione matriciale densa non richiedono la stessa strategia di posizionamento.
È questa distinzione a rendere interessante il dato principale. Il modello resta grande; il runtime cambia la quantità che deve trovarsi nella memoria più veloce in un dato momento. Si apre così un percorso pratico per l'inferenza locale, senza dimostrare che ogni normale laptop possa gestirla bene.
Un'architettura sparsa crea l'opportunità
L'architettura di Qwen combina blocchi Gated DeltaNet di tipo ricorrente con Qwen Sparse Attention, esperti instradati ed embedding n-gram. Il rapporto tecnico spiega perché questi componenti sono progettati per scalare con maggiore efficienza. Strata non ha inventato i componenti del modello: costruisce una strategia di esecuzione adatta ai loro diversi schemi di accesso. Rapporto sull'architettura Qwen
Il dettaglio dell'instradamento è importante. Ognuno dei 48 layer contiene 512 esperti instradati; 10 esperti instradati vengono attivati per layer, insieme a un esperto condiviso. Ciò significa che nei layer sono memorizzati 24.576 esperti instradati. Non significa che per un token vengano usati solo 10 dei 24.576 esperti nell'intero modello. Configurazione dell'architettura Qwen
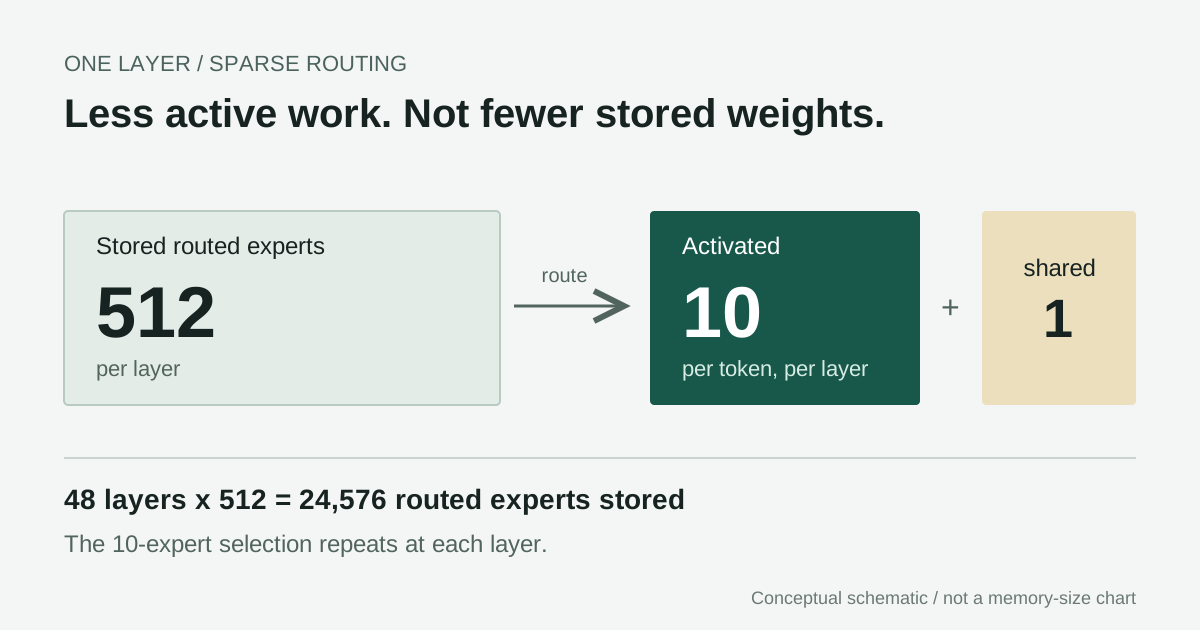
La selezione riduce il lavoro attivo, non l'inventario memorizzato. Questo diagramma rappresenta un layer, non tutti i 48 layer del modello.
Consideriamo la conseguenza a prescindere da qualsiasi affermazione sulla velocità. Se un esperto viene selezionato raramente, riservargli in permanenza costosa memoria dell'acceleratore può essere uno spreco di capacità. Se un altro componente viene usato a ogni passaggio, spostarlo ripetutamente può costare caro. Un pianificatore efficace deve distinguere questi casi e gestire poi gli inevitabili cache miss.
È anche per questo che un modello sparso di classe 180B non va confrontato con un modello denso da 180B soltanto in base al numero di parametri. Al contrario, definirlo un «modello 6B» nasconde i requisiti di memoria, l'instradamento, lo stato del contesto e il costo di accesso ai pesi distribuiti. Entrambe le scorciatoie oscurano il vero problema ingegneristico.
GPU, RAM e SSD svolgono compiti diversi
Nella configurazione di riferimento documentata, la GPU mantiene i calcoli comuni e una cache degli esperti instradati più utilizzati. La RAM di sistema contiene i pesi degli esperti instradati e la CPU calcola in loco gli esperti assenti dalla cache GPU. Una tabella n-gram separata e mappata in memoria resta sull'SSD; le righe necessarie vengono fornite tramite la cache del sistema operativo. Panoramica dell'esecuzione di Strata
Il percorso CPU è più significativo di quanto suggerisca l'etichetta generica «offload». Durante la decodifica, un cache miss non richiede semplicemente di copiare ogni esperto mancante sulla GPU prima di continuare. Il lavoro della CPU e quello della GPU possono sovrapporsi. Di conseguenza, le capacità della CPU e la larghezza di banda della memoria di sistema incidono direttamente sulla velocità di generazione.
Anche il componente n-gram ha uno schema di accesso diverso. Consultare poche righe non equivale a scorrere tutta la tabella. Lasciare su SSD un segmento di ricerca quantizzato da 28.8 GB può quindi essere pratico, senza implicare che a ogni token generato venga letto dal disco l'intero modello. Un'unità lenta o una forte pressione sulla cache delle pagine possono comunque compromettere la reattività.
Anche il prefill è diverso dalla decodifica. Elaborare il prompt iniziale consente batch più grandi e offre opportunità di sovrapporre i trasferimenti degli esperti al lavoro degli altri layer. Generare ripetutamente il token successivo è invece sensibile alla latenza. La documentazione dettagliata del progetto descrive kernel, pianificazione e comportamento della cache distinti per queste fasi. Un unico dato di throughput non può riassumerle entrambe. Dettagli dell'implementazione di Strata
A mio avviso, l'innovazione è un sistema coordinato, non un singolo trucco di compressione. La quantizzazione riduce l'ingombro dei pesi memorizzati; la cache riduce gli accessi ripetuti ai pesi più richiesti; l'esecuzione CPU gestisce i cache miss; la ricerca sparsa evita di caricare per intero una tabella enorme. Togliete uno qualsiasi di questi vantaggi e un desktop con memoria modesta diventa un host molto meno convincente.
La speculazione risparmia lavoro solo quando la verifica accetta il risultato
Strata usa anche il componente di predizione multi-token del modello per proporre brevi continuazioni e verificarle con il modello target. Invece di pagare un passaggio completo del modello target per ciascun token di output, una proposta accettata può consentire a quel passaggio di convalidarne più d'uno. Il repository descrive proposte fino a tre token nel percorso MTP. Progettazione e implementazione MTP
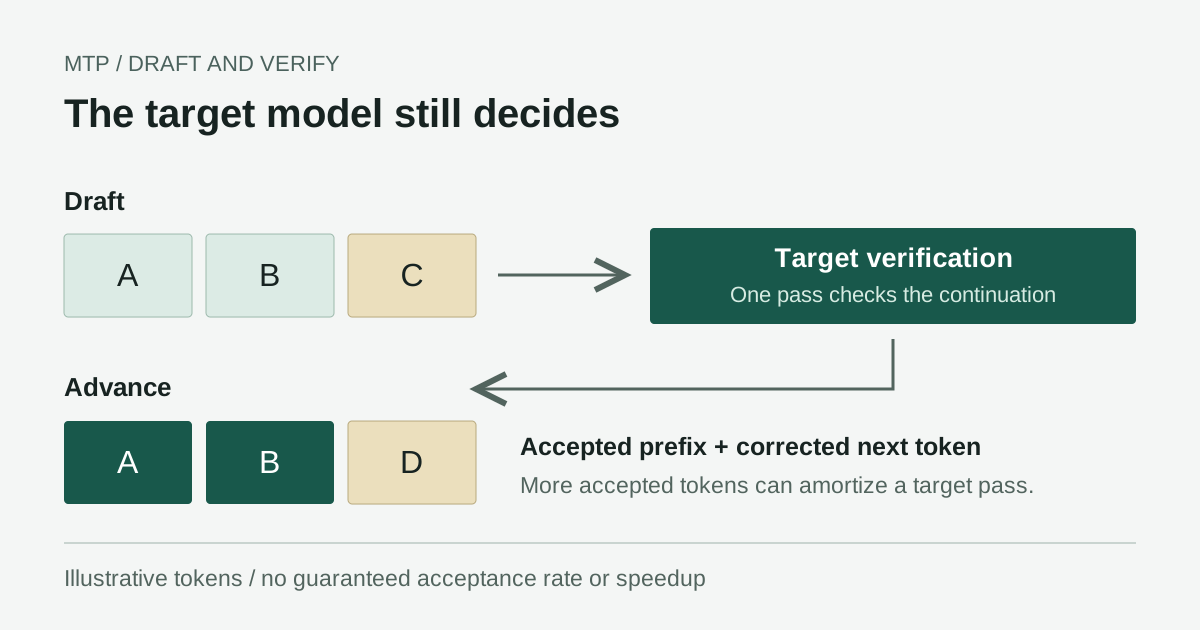
L'esempio illustra la verifica, non garantisce un tasso di accettazione né un aumento misurato della velocità.
Questa accelerazione è condizionata. Il codice prevedibile o il testo ripetitivo possono essere più facili da proporre rispetto a un passaggio di ragionamento inedito. Formulazione del prompt, campionamento, lunghezza dell'output e variante del modello possono modificare l'accettazione. Non si deve quindi presumere che un dato di riferimento misurato su un prompt descriva anche un'altra lingua o attività.
La verifica riguarda il modello effettivamente in esecuzione. Non recupera le informazioni perse con la quantizzazione e non dimostra l'equivalenza con i pesi BF16 originali. È essenziale tenere distinti i due aspetti: esecuzione speculativa e qualità del modello a precisione ridotta rispondono a domande diverse.
Una seconda distinzione riguarda il riutilizzo della cache. Un prefisso di conversazione invariato può evitare calcoli ripetuti, ma un seguito con cache già calda e un lungo prompt nuovo non sono test equivalenti. Nelle comparazioni locali annotate se il prefisso è stato riutilizzato. Il progetto documenta esplicitamente la cache ai confini dei messaggi. Comportamento della cache dei prefissi
«GPU da 12 GB» non significa «installazione da 12 GB»
Le quantizzazioni GGUF pubblicate suddividono il modello in uno shard principale e uno shard n-gram fisso da 28.8 GB. Le dimensioni qui sotto sono in GB decimali e indicano i download, non i requisiti di memoria GPU. Il proiettore di visione opzionale aggiunge circa 0.91 GB; i download ausiliari e i file temporanei di conversione richiedono spazio aggiuntivo. File di quantizzazione ISTA-DASLab
| Variante | Bit medi per peso del nucleo | Shard principale | Shard n-gram | Download totale |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
Il nome del formato non descrive con precisione ogni tensore. Lo shard principale usa formati misti, mentre quello n-gram usa IQ4_NL. «Modello a due bit» è una comoda abbreviazione, ma è fuorviante se suggerisce che l'intero download usi esattamente due bit per parametro. Metodologia di quantizzazione
Per un primo tentativo con il modello completo, una GPU supportata da almeno 12 GB e 64 GB di RAM di sistema costituiscono una base di pianificazione più credibile del solo dato della GPU. Il repository descrive anche percorsi con RAM ridotta e una variante Coder potata. Sono configurazioni diverse, non la prova che una macchina da 32 GB offra la stessa esperienza con il modello completo. Scelta del modello Strata
Prima di fare prove, riserverei 100-150 GB di spazio SSD libero. È una stima prudenziale per la pianificazione, non un requisito fisso del fornitore: il totale effettivo dipende dalla quantizzazione scelta, dall'assistente MTP, dai file di visione opzionali e dalle cache di compilazione/conversione. Alcuni percorsi di ottimizzazione CPU Q2 possono richiedere una copia aggiuntiva considerevole degli esperti. Controllate il percorso scelto, invece di dare per scontata un'unica capacità disco universale.
Prima di scegliere l'hardware, stabilite la configurazione di cui avete bisogno: modello completo o potato, contesto breve o lungo, visione o solo testo, throughput sostenuto o uso occasionale. Queste scelte spostano il collo di bottiglia, e il benchmark seguente descrive un sistema specifico.
Fissate una configurazione di riferimento prima di ottimizzare
Il percorso standard documentato copre Windows 10/11 e Ubuntu 22.04/24.04, con GPU NVIDIA supportate e alcuni modelli AMD selezionati. Le istruzioni NVIDIA indicano il driver 580 o successivo. macOS e gli altri backend compilati dai sorgenti hanno requisiti distinti; i comandi seguenti non costituiscono una configurazione universale. Guida ufficiale all'installazione
Su Windows, controllate prima di scaricare
Se Git non è presente, installatelo dalla distribuzione ufficiale. In PowerShell, clonate il repository upstream e fissate la revisione esaminata qui:
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
Il controllo evita il download di grandi dimensioni del modello, ma il launcher può predisporre Python e un ambiente privato. Comportamento del controllo di configurazione
Leggete il rapporto sull'hardware, esaminate gli script di configurazione e verificate lo spazio libero prima di continuare. Avviate quindi la configurazione interattiva:
.\START-HERE.bat
Per una prima prova su una macchina con 64 GB, IQ2_XS è un punto di partenza ragionevole tra le opzioni documentate. Usate un contesto di 32.768 token, solo testo, e lasciate disattivato Experimental Speed Projection. Questa base più contenuta rende più semplice isolare eventuali problemi rispetto a partire con contesto massimo, visione e tutte le ottimizzazioni attive.
Aspettatevi download e installazione di dipendenze, non un piccolo eseguibile autonomo. A seconda del percorso GPU, la configurazione usa un motore già preparato o strumenti di compilazione. Esaminate le richieste relative a driver, compilatori o privilegi di amministratore; non disattivate antivirus o protezioni del browser per forzare l'installazione. Procuratevi i driver necessari dal produttore dell'hardware.
Gli avvii successivi usano lo stesso launcher. Per ripetere la configurazione o evitare un conflitto di porta:
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
Su Ubuntu, usate lo script di configurazione documentato
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
Scegliete il backend corrispondente alla GPU. Il percorso ROCm di AMD e quello CUDA di NVIDIA non sono intercambiabili. Considerate le richieste del gestore pacchetti o del compilatore come modifiche alla vostra macchina che richiedono una verifica. La revisione fissata rende riproducibile questo articolo; le versioni più recenti potrebbero migliorare il supporto, quindi leggete le relative note di rilascio prima di decidere consapevolmente di aggiornare.
Verificate una risposta prima di collegare un agente
Al termine del caricamento, aprite http://127.0.0.1:8080 nel browser locale, oppure la porta alternativa scelta. Inviate una domanda breve e non sensibile e verificate che venga completata una risposta. Solo dopo provate un prompt più lungo, il riutilizzo della cache nei messaggi successivi e la lingua che vi interessa. Durante il primo caricamento, monitorate l'uso della memoria e i log del server.
L'API compatibile documentata comprende GET /v1/models e POST /v1/chat/completions. Individuate l'identificatore del modello effettivamente servito invece di copiare in un altro client un alias ipotizzato:
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
Usate l'identificatore restituito per configurare un client compatibile. Una richiesta riuscita di elenco dei modelli dimostra che il modello viene rilevato, non la qualità della generazione; la prima verifica significativa resta una risposta di chat completata. Per questo test iniziale, lasciate disattivati gli strumenti agente che scrivono file o eseguono comandi shell.
Se la scheda esaurisce la memoria, riducete prima il contesto e disattivate la visione. Se il processo viene terminato o la macchina usa intensamente lo swap, verificate la RAM di sistema e non solo la VRAM. In caso di librerie runtime mancanti, consultate le istruzioni specifiche del backend anziché installare DLL a caso. Il progetto mantiene una guida per sintomi. Risoluzione dei problemi di Strata
Su Mac, distinguete il supporto del modello da quello di Strata
Apple Silicon usa memoria unificata, invece della separazione tra VRAM e RAM di sistema presente nel benchmark desktop. L'installer Strata fissato non documenta un percorso macOS supportato; una richiesta di supporto per Mac non equivale a un port completato. Richiesta Mac upstream
Chi usa un Mac potrebbe riferirsi a due esperimenti distinti. Un fork comunitario Strata-macOS mantiene l'interfaccia e l'API Python con un backend Metal per modelli GGUF più piccoli; le verifiche documentate usano Qwen2.5, non la configurazione Flash-Next originale. Il fork non porta esplicitamente su Mac né lo streaming degli esperti CUDA di Strata né il percorso MTP. Non consideratelo un'installazione con un clic del modello trattato in questo articolo. Fork comunitario e ambito
Per Qwen3.8-Flash-Next stesso, esiste un percorso sperimentale separato: una build compatibile di llama.cpp con Metal e i file GGUF suddivisi del publisher. Questo non è Strata su Mac e la tabella delle velocità Windows riportata più avanti non è applicabile.
Compilate il runtime Metal separato
Usate un Mac Apple Silicon, un terminale ARM64 nativo, gli strumenti per sviluppatori a riga di comando di Apple, Git e CMake. Se CMake non è presente, installatelo dalla distribuzione ufficiale o tramite il gestore di pacchetti di fiducia. La documentazione di build di llama.cpp esaminata attiva Metal per impostazione predefinita su macOS. Fissare anche questo motore evita che un branch mobile modifichi silenziosamente l'esempio in futuro. Istruzioni di build Metal di llama.cpp
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
Scaricate entrambi gli shard IQ2_XS dall'elenco dei file del publisher nella stessa cartella, mantenendo i nomi originali. Il secondo shard è necessario anche quando le righe di ricerca rimangono sul disco. Sostituite il percorso d'esempio qui sotto con il percorso effettivo del primo shard sul vostro Mac:
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
Il publisher documenta il caricamento dei file suddivisi e i flag mmap/lazy; il motore esaminato espone queste opzioni. Mantengono la tabella n-gram disponibile su richiesta, senza richiedere la residenza completa in memoria. Sono opzioni di llama.cpp, non opzioni del launcher Strata. Esempio di caricamento GGUF
La capacità resta importante: lo shard principale IQ2_XS è da 39.2 GB, prima dello stato runtime e dell'overhead di macOS. Un Mac da 16 o 24 GB non è quindi una base credibile per mantenere in memoria l'intero modello di questo esempio; anche 64 GB sono soltanto un punto di partenza per la pianificazione, non una garanzia di riuscita. Controllate pressione della memoria e swap in Monitoraggio Attività, iniziate con contesto 4K e interrompete se la pressione resta alta. Non modificate i limiti di memoria del kernel per forzare un caricamento che non riesce.
Verificate nei log che sia stato selezionato Metal e che venga completata una risposta coerente di solo testo prima di proseguire. Poi provate prompt più lunghi prima di aggiungere decodifica speculativa o visione. Questo percorso non copre i Mac Intel, l'esecuzione distribuita su più Mac né le conversioni MLX. Qui non sono disponibili dati di throughput per Mac: i risultati dipendono dal chip esatto, dalla memoria unificata, dal motore, dalla quantizzazione e dal contesto.
La velocità pubblicata è promettente; la latenza al primo token racconta un'altra storia
Per un confronto riproducibile, la tabella usa il benchmark del motore 0.1.26 del 29 settembre 2026, senza mescolare dati di riferimento più recenti del README. La macchina era dotata di RTX 5070 da 12 GB su PCIe 5.0 x16, Ryzen 5 7600 a sei core, 64 GB DDR5-5200 e Windows 10. I test usavano generazione greedy, MTP attivo, immagini disattivate e 256 token generati. Condizioni del benchmark
| Variante | Decodifica con prompt breve, token/s | Decodifica con prompt lungo, token/s | Prefill con prompt medio, token/s | Primo token con prompt lungo, secondi |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
Le fasce breve, media e lunga contengono rispettivamente 3.562, 31.566 e 128.478 token di prompt. Ogni cella rappresenta una singola esecuzione, non una media con intervallo di confidenza. L'esecuzione IQ2_XS usa il fine-tuning Swift 1.5 documentato, quindi non è un confronto controllato tra sole quantizzazioni rispetto al modello base. I valori sono copiati dalla matrice dei risultati pubblicata. Misurazioni leggibili da macchina
Il caso Q2_0 con prompt lungo impiega 62.48 secondi prima del primo token, nonostante la successiva decodifica a 73.73 token/s. Per chi aspetta una risposta su un nuovo documento, quel primo minuto conta. In una conversazione in corso con contesto riutilizzabile l'esperienza può essere diversa. Nessuno dei due aspetti va nascosto dietro un dato massimo di token al secondo.
Questi numeri supportano una conclusione circoscritta ma utile: sul desktop specificato dall'autore, alcune configurazioni quantizzate hanno raggiunto velocità di generazione interattive. Non dimostrano lo stesso risultato su una macchina con minore larghezza di banda, in coreano, con ragionamento campionato, con la visione attiva o con utenti simultanei. I token non sono parole e la tokenizzazione delle diverse lingue rende più complicati anche i confronti approssimativi.
La finestra di contesto nativa da 262.144 token del modello e le sue dichiarazioni sul contesto esteso non garantiscono che la configurazione Strata scelta possa gestire comodamente quella lunghezza. Contano ancora lo stato runtime, il posizionamento della cache e la RAM disponibile. Iniziate in piccolo e aumentate il contesto solo quando il carico di lavoro giustifica la latenza e la memoria aggiuntive.
Qualità e funzioni di «velocità» vanno verificate separatamente
Il publisher della quantizzazione riporta confronti di qualità utili, ma non sono benchmark end-to-end di Strata. Per esempio, il suo punteggio LiveCodeBench v6 è 87.43 per BF16 e 81.14 per Q2_0. È un motivo per testare le attività che vi interessano, non per dichiarare inutilizzabile ogni output a pochi bit o equivalenti tutte le varianti. Valutazione pubblicata della quantizzazione
Experimental Speed Projection richiede particolare cautela. Il progetto descrive una funzione facoltativa basata su un vettore di controllo che modifica il comportamento del modello; non è una semplice ottimizzazione aritmetica invisibile. Lasciatela disattivata nella configurazione di riferimento e dichiaratela se la usate nei confronti. Una risposta più rapida dovuta a contenuti modificati non misura la stessa cosa di un'esecuzione più rapida di un lavoro equivalente. Dettagli della funzione sperimentale
Per la vostra valutazione, registrate il commit del repository, la versione del motore, la quantizzazione e il fine-tuning, GPU e VRAM, CPU, velocità della RAM, SSD, driver, impostazione del contesto e opzioni attive. Misurate quindi almeno tre prompt nuovi e tre follow-up con cache, riportando mediana e intervallo invece di scegliere il risultato migliore. Annotate insieme i conteggi dei token di input e output, il tempo al primo token, la velocità di decodifica e il tempo complessivo.
Affiancate ai test di velocità verifiche di correttezza specifiche per attività: compilate e testate le risposte di programmazione, confrontate le risposte sui documenti con la fonte e verificate lingua e terminologia degli output multilingue. Registrate errori, timeout ed esaurimenti di memoria insieme alle esecuzioni riuscite.
L'esecuzione locale cambia il controllo, non tutti i rischi di sicurezza
Mantenete l'indirizzo di loopback predefinito. Esporre un server di modelli locale alla LAN o a Internet ne cambia il modello di minaccia, e un'API compatibile non è automaticamente un servizio autenticato. La policy di sicurezza di Strata descrive il binding locale e il relativo ambito di sicurezza; non afferma che sia stato svolto un audit di sicurezza esterno indipendente. Policy di sicurezza di Strata
La generazione locale può ridurre la dipendenza da un servizio di inferenza ospitato, ma la privacy dipende ancora dall'intero flusso di lavoro. Log delle chat, applicazioni client, ricerca sul Web, strumenti esterni e backup possono inviare o conservare dati al di fuori del processo del modello. Esaminate questi percorsi prima di affidare documenti riservati a un agente. «Funziona in locale» è un dato architetturale utile, non una certificazione completa della privacy.
Anche le licenze operano su più livelli. La licenza del codice di Strata non sostituisce i termini qwen-community-1.0 del modello. I pesi quantizzati non cancellano gli obblighi legati al modello originale. Leggete le licenze applicabili prima di ridistribuire il modello o usarlo commercialmente, senza presumere che un repository aperto consenta qualsiasi uso. Licenza del modello Qwen
L'implicazione è un diverso tipo di computer personale per l'IA
La conclusione più importante non è che l'inferenza cloud sia diventata obsoleta. Un desktop ha ancora limiti nel serving simultaneo, nella latenza al primo token, nei consumi, nella manutenzione e nella qualità del modello. Un sistema ospitato può restare la scelta migliore quando disponibilità o volume elevato di richieste contano più del controllo sull'ambiente di esecuzione.
Ciò che Strata suggerisce è che l'inferenza consumer può essere limitata tanto dall'orchestrazione quanto dalla capacità della GPU. Un uso migliore di CPU, RAM e accesso sparso allo storage può rendere disponibili modelli che un calcolo semplicistico basato sull'esecuzione interamente su GPU scarterebbe. La larghezza di banda della memoria di sistema diventa parte delle specifiche di un computer per l'IA, non un dettaglio secondario.
È una deduzione basata sull'architettura e sui risultati pubblicati, non una garanzia per ogni futuro modello. Dipende dalla presenza di componenti sparsi, memorizzabili in cache o orientati alla ricerca che un runtime possa sfruttare. Un modello denso con schemi di accesso diversi non eredita lo stesso vantaggio solo perché ha un numero simile di parametri.
Per un ricercatore o uno sviluppatore, il passo successivo realistico è un progetto pilota circoscritto: una versione fissata, contesto breve, una macchina supportata, alcune attività rappresentative e un resoconto onesto di qualità e latenza. Il traguardo è significativo proprio se descritto così. Un modello molto grande è diventato un carico di lavoro plausibile per un desktop grazie a un attento posizionamento e alla verifica, non perché i vincoli hardware siano scomparsi.
Tenete le decisioni di configurazione insieme agli appunti di ricerca
Quando confrontate configurazioni di IA locale, tenete insieme link alle fonti, dettagli dell'hardware, osservazioni e questioni irrisolte. Telli.sh può aiutare a organizzare questi appunti e riepiloghi senza suggerire che esista un'integrazione Strata incorporata. Crea un account Telli.sh