Strata et Qwen3.8-Flash-Next : comment un modèle de classe 180B fonctionne sur un PC personnel
Un guide vérifié à partir des sources sur l'architecture de Strata, son installation sous Windows et Linux, la voie distincte pour Mac Apple Silicon, les benchmarks publiés et les limites de l'IA locale.
Faire tourner sur un ordinateur de bureau équipé d'une carte graphique de 12 Go un modèle d'environ 180 milliards de paramètres semble contradictoire. Strata rend cette proposition plausible, mais pas en faisant tenir tous les paramètres sur la carte. Son apport le plus intéressant consiste à répartir différentes parties d'un modèle clairsemé entre plusieurs types de mémoire et de calcul, sans transformer chaque jeton généré en transfert de données qui bride les performances.
Le nom officiel du modèle est Qwen3.8-Flash-Next, et non Qwen3.8-Next-Flash. Qwen indique un cœur de 125B paramètres, dont 6B activés, un composant supplémentaire d'embeddings n-gram de 51B et 4B pour la prédiction multi-jetons. Le total arrondi de 180B décrit les composants stockés ; ce n'est pas la quantité de calcul dense effectuée pour chaque jeton. Fiche du modèle Qwen
Les détails d'installation et de performance ci-dessous concernent la révision fb58e0dbc8399662c0e47c76578c6e878b14f6cf de Strata. Les chiffres des benchmarks sont des mesures publiées par le projet ; votre matériel, votre prompt, le contexte et la variante du modèle peuvent produire des résultats différents.
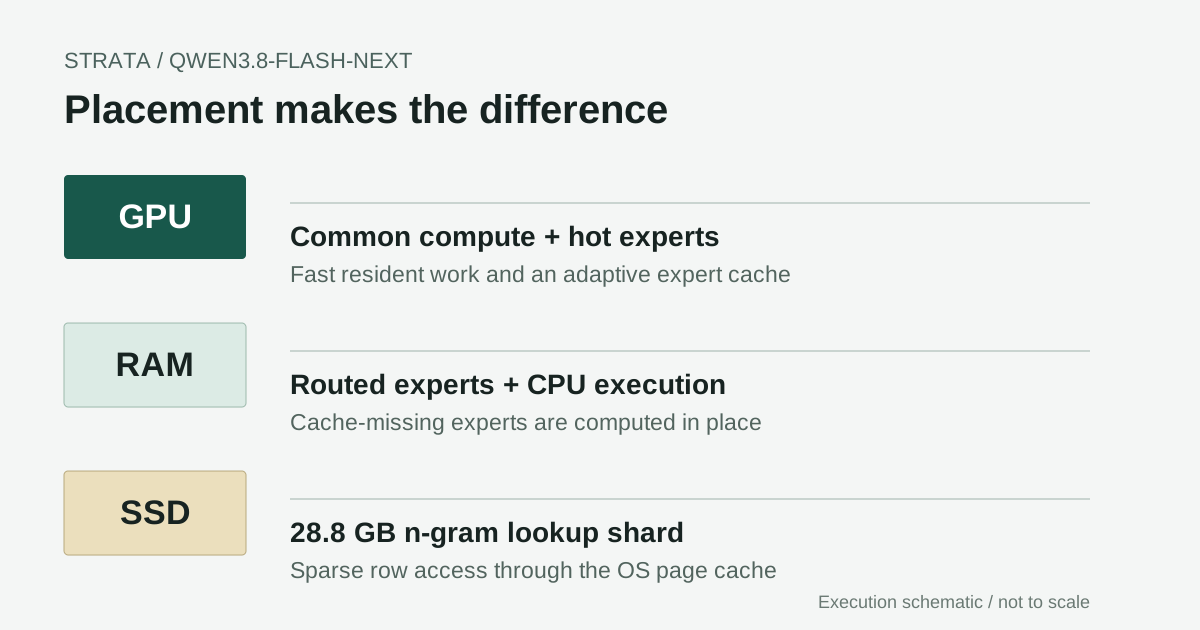
Schéma original fondé sur la conception d'exécution documentée. Les niveaux ne sont pas à l'échelle : taille du téléchargement, utilisation de la RAM et résidence sur le GPU sont des quantités différentes.
La percée tient au placement, pas à un modèle plus petit
Face à tout modèle local d'une taille inhabituelle, trois questions se posent : quelle quantité doit être stockée, quelle part est active pour un jeton et où s'exécute le travail actif ? Un faible nombre de paramètres actifs ne répond qu'à la deuxième question. Il ne supprime pas la nécessité de garder les autres poids quelque part où ils restent accessibles.
Strata est un moteur d'inférence et une application de service local développés par la communauté, dans le dépôt Niko1221. La configuration documentée propose une installation sous Windows et Linux, une interface de chat locale, des API compatibles et une entrée image facultative. C'est un projet communautaire distinct, pas un produit de bureau officiel de Qwen. Dépôt Strata
Le changement d'approche utile consiste à ne plus considérer le PC comme un GPU à la mémoire insuffisante. Un ordinateur de bureau dispose aussi de RAM système, d'unités vectorielles CPU et du cache de pages du système d'exploitation. Ces ressources sont plus lentes que la mémoire du GPU pour certaines opérations, mais elles ne sont pas toutes aussi inadaptées à chaque opération. Une recherche dans une grande table et une multiplication matricielle dense n'ont pas besoin de la même stratégie de placement.
C'est ce qui rend le chiffre phare intéressant. Le modèle reste volumineux ; l'environnement d'exécution change la part qui doit se trouver dans la mémoire la plus rapide à un instant donné. Cela ouvre une voie pratique à l'inférence locale sans prouver que chaque ordinateur portable ordinaire peut le faire tourner correctement.
Une architecture clairsemée ouvre la voie
L'architecture de Qwen combine des blocs Gated DeltaNet de type récurrent, Qwen Sparse Attention, des experts routés et des embeddings n-gram. Le rapport technique explique pourquoi ces composants sont conçus pour une montée en charge plus efficace. Strata n'a pas inventé ces composants du modèle ; il construit une stratégie d'exécution adaptée à leurs différents profils d'accès. Rapport sur l'architecture Qwen
Le détail du routage compte. Chacune des 48 couches comprend 512 experts routés ; 10 experts routés sont activés par couche, en plus d'un expert partagé. Cela représente 24 576 experts routés stockés dans l'ensemble des couches. Cela ne signifie pas que seuls 10 des 24 576 experts sont utilisés dans tout le modèle pour un jeton. Configuration de l'architecture Qwen
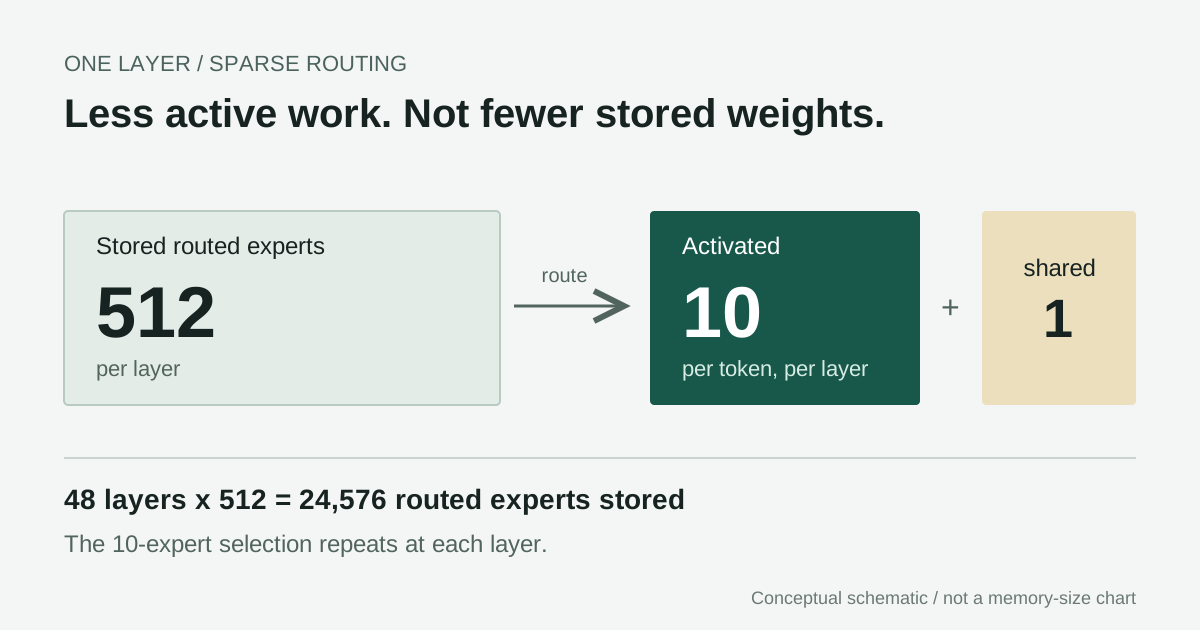
La sélection réduit le travail actif, pas l'inventaire stocké. Ce schéma représente une couche, et non les 48 couches du modèle entier.
Considérons la conséquence indépendamment de toute affirmation de vitesse. Si un expert est rarement sélectionné, lui réserver en permanence de la mémoire accélérateur coûteuse peut être un mauvais usage de la capacité. Si un autre composant intervient à chaque étape, le déplacer sans cesse risque de coûter cher. Un ordonnanceur efficace doit distinguer ces cas, puis gérer les défauts de cache inévitables.
C'est aussi pourquoi un modèle clairsemé de classe 180B ne doit pas être comparé à un modèle dense de 180B sur le seul nombre de paramètres. À l'inverse, le qualifier de « modèle 6B » masque les besoins de stockage, le routage, l'état du contexte et le coût d'accès aux poids répartis. Ces deux raccourcis obscurcissent le vrai problème d'ingénierie.
GPU, RAM et SSD ont des rôles différents
Dans la configuration de référence documentée, le GPU conserve les calculs courants et un cache des experts routés fréquemment utilisés. La RAM système contient les poids des experts routés, et le CPU calcule sur place les experts absents du cache GPU. Une table n-gram distincte, mappée en mémoire, reste sur le SSD ; les lignes nécessaires sont fournies par l'intermédiaire du cache du système d'exploitation. Vue d'ensemble de l'exécution de Strata
Cette voie CPU est plus importante que ne le laisse entendre l'étiquette générique « déchargement ». Pendant le décodage, un défaut de cache n'impose pas simplement de copier chaque expert manquant vers le GPU avant de continuer. Le travail du CPU et celui du GPU peuvent se chevaucher. En contrepartie, les capacités du CPU et la bande passante de la mémoire système influent désormais directement sur la vitesse de génération.
Le composant n-gram a encore un autre profil d'accès. Consulter quelques lignes n'est pas la même charge que parcourir toute la table. Laisser sur SSD un fragment de recherche quantifié de 28,8 Go peut donc être pratique, sans que cela signifie que le modèle entier est lu sur le disque pour chaque jeton généré. Un disque lent ou une forte pression sur le cache de pages peut toutefois nuire à la réactivité.
Le préremplissage diffère lui aussi du décodage. Le traitement d'un prompt initial offre des lots plus importants et des possibilités de chevaucher les transferts d'experts avec le travail des autres couches. Générer chaque jeton suivant à répétition est une opération sensible à la latence. La documentation détaillée du projet décrit des noyaux, une planification et un comportement du cache distincts pour ces phases. Un chiffre unique de débit ne peut pas résumer les deux. Détails de l'implémentation Strata
À mon sens, l'innovation réside dans un système coordonné, et non dans une seule astuce de compression. La quantification réduit l'empreinte des poids stockés ; la mise en cache limite les accès répétés aux poids les plus sollicités ; l'exécution CPU traite les défauts de cache ; la recherche clairsemée évite de charger toute une table gigantesque. Supprimez l'un de ces avantages et un ordinateur de bureau à mémoire modeste devient un hôte beaucoup moins convaincant.
La spéculation n'économise du travail que si la vérification valide le résultat
Strata utilise aussi le composant de prédiction multi-jetons du modèle pour proposer de courtes continuations et les vérifier avec le modèle cible. Au lieu de payer un passage complet du modèle cible pour chaque jeton de sortie, une proposition acceptée peut permettre à ce passage d'en valider plusieurs. Le dépôt indique des brouillons allant jusqu'à trois jetons dans son parcours MTP. Conception et implémentation du MTP
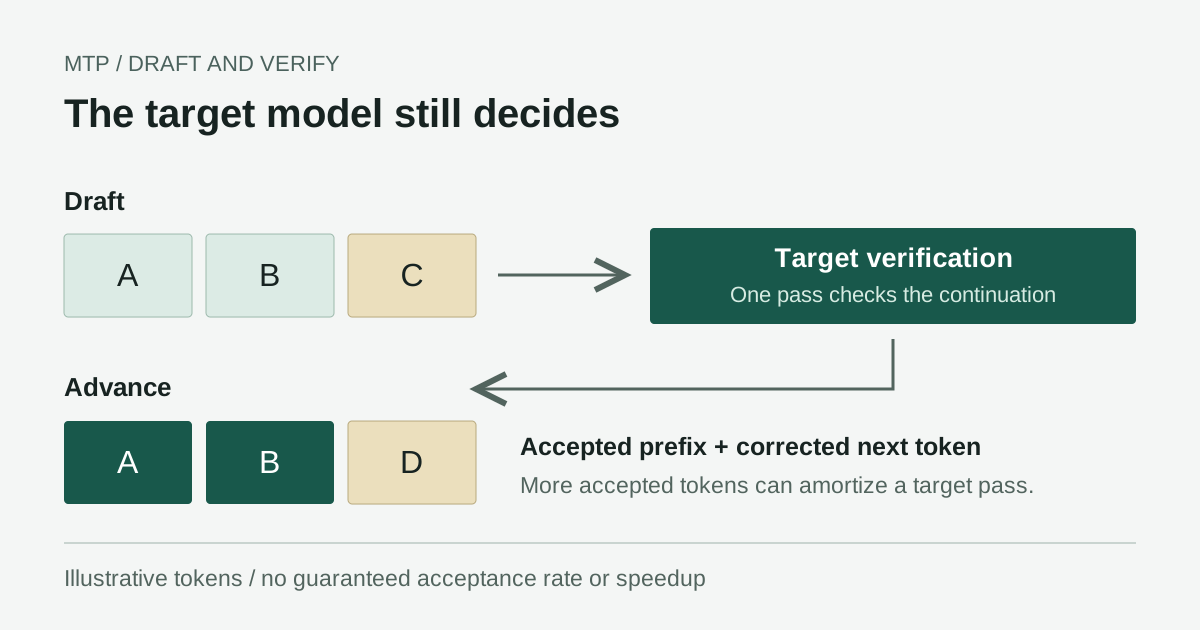
Cet exemple illustre la vérification ; il ne garantit ni un taux d'acceptation ni un gain de vitesse mesuré.
Cette accélération est conditionnelle. Du code prévisible ou un texte répétitif peut être plus facile à proposer qu'une transition de raisonnement inédite. La formulation du prompt, l'échantillonnage, la longueur de sortie et la variante du modèle peuvent modifier le taux d'acceptation. Un chiffre phare mesuré sur un prompt ne doit donc pas être supposé représentatif d'une autre langue ou tâche.
La vérification vise le modèle effectivement exécuté. Elle ne restaure pas les informations perdues par la quantification et n'établit pas l'équivalence avec les poids BF16 d'origine. Il est essentiel de distinguer ces deux questions : l'exécution spéculative et la qualité d'un modèle en précision réduite répondent à des problèmes différents.
Une deuxième distinction concerne la réutilisation du cache. Un préfixe de conversation inchangé peut éviter de répéter certains calculs, mais une relance à chaud et un long prompt inédit ne sont pas des tests équivalents. Notez si le préfixe a été réutilisé lors de vos comparaisons locales. Le projet documente explicitement la mise en cache aux frontières des messages. Comportement du cache de préfixe
« GPU de 12 Go » ne signifie pas « installation de 12 Go »
Les quantifications GGUF publiées répartissent le modèle entre un fragment principal et un fragment n-gram fixe de 28,8 Go. Les tailles ci-dessous sont en Go décimaux et correspondent aux téléchargements, pas aux besoins de mémoire GPU. Le projecteur de vision facultatif ajoute environ 0,91 Go ; les téléchargements auxiliaires et les fichiers temporaires de conversion nécessitent de l'espace supplémentaire. Fichiers de quantification ISTA-DASLab
| Variante | Bits moyens par poids du cœur | Fragment principal | Fragment n-gram | Téléchargement total |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
Le nom du format ne décrit pas précisément chaque tenseur. Le fragment principal utilise des formats mixtes, tandis que le fragment n-gram utilise IQ4_NL. « Modèle deux bits » est un raccourci pratique, mais trompeur s'il laisse entendre que l'ensemble du téléchargement utilise exactement deux bits par paramètre. Méthodologie de quantification
Pour un premier essai du modèle complet, un GPU pris en charge d'au moins 12 Go et 64 Go de RAM système constituent une base de planification plus crédible que le seul chiffre du GPU. Le dépôt présente aussi des parcours à RAM réduite et une variante Coder élaguée. Ce sont d'autres configurations, pas la preuve qu'une machine de 32 Go offre la même expérience avec le modèle complet. Choix du modèle Strata
Je réserverais 100 à 150 Go d'espace SSD libre avant de faire des essais. Il s'agit d'une marge de planification prudente, pas d'une exigence fixe du fournisseur : la quantification choisie, l'assistant MTP, les fichiers de vision facultatifs et les caches de compilation/conversion déterminent le total réel. Certains parcours d'optimisation CPU Q2 peuvent nécessiter une copie supplémentaire importante des experts. Vérifiez le parcours choisi au lieu de supposer qu'une seule valeur universelle s'applique au disque.
Avant de choisir votre matériel, déterminez la configuration dont vous avez besoin : modèle complet ou élagué, contexte court ou long, vision ou texte, débit soutenu ou usage ponctuel. Ces choix déplacent le goulot d'étranglement, et le benchmark ci-dessous décrit un système précis.
Épinglez une configuration de référence avant de régler les paramètres
Le parcours standard documenté couvre Windows 10/11 et Ubuntu 22.04/24.04, avec les GPU NVIDIA pris en charge et certains GPU AMD. Les instructions NVIDIA spécifient un pilote 580 ou plus récent. macOS et les autres backends compilés depuis les sources ont des exigences distinctes ; les commandes ci-dessous ne constituent pas une procédure universelle. Guide officiel d'installation
Sous Windows, vérifiez avant de télécharger
Installez Git depuis sa distribution officielle s'il n'est pas déjà présent. Dans PowerShell, clonez le dépôt amont et épinglez la révision examinée ici :
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
Cette vérification évite le téléchargement volumineux du modèle, mais son lanceur peut installer Python et un environnement privé. Comportement de la vérification de configuration
Lisez le rapport matériel, inspectez les scripts de configuration et vérifiez l'espace libre avant de poursuivre. Lancez ensuite la configuration interactive :
.\START-HERE.bat
Pour un premier essai sur une machine de 64 Go, IQ2_XS constitue un point de départ raisonnable parmi les choix documentés. Utilisez un contexte de 32 768 jetons, en mode texte uniquement, et laissez Experimental Speed Projection désactivé. Cette base réduite facilite le diagnostic des problèmes par rapport à un démarrage avec le contexte maximal, la vision et toutes les optimisations activées.
Attendez-vous à des téléchargements et à l'installation de dépendances, pas à un petit exécutable autonome. Selon le parcours GPU, la configuration utilise un moteur précompilé ou des outils de compilation. Examinez les demandes concernant les pilotes, les compilateurs ou les privilèges administrateur ; ne désactivez pas l'antivirus ni les protections du navigateur pour forcer l'installation. Procurez-vous les pilotes requis auprès du fabricant du matériel.
Les lancements suivants utilisent le même lanceur. Pour relancer la configuration ou éviter un conflit de port :
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
Sous Ubuntu, utilisez le script de configuration documenté
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
Choisissez le backend correspondant au GPU. Le parcours ROCm d'AMD et le parcours CUDA de NVIDIA ne sont pas interchangeables. Considérez les demandes d'installation de paquets ou de compilateurs comme des modifications de votre machine qui doivent être examinées. La révision épinglée rend cet article reproductible ; des versions plus récentes peuvent améliorer la prise en charge, alors lisez leurs notes de version avant de décider de mettre à niveau.
Vérifiez une réponse avant de connecter un agent
Une fois le chargement terminé, ouvrez http://127.0.0.1:8080 dans le navigateur local, ou utilisez le port alternatif choisi. Envoyez une question courte et non sensible et vérifiez qu'une réponse aboutit. Essayez ensuite un prompt plus long, la réutilisation du cache dans un échange de suivi et la langue qui vous intéresse. Surveillez l'utilisation de la mémoire et les journaux du serveur pendant le premier chargement.
L'API compatible documentée comprend GET /v1/models et POST /v1/chat/completions. Découvrez l'identifiant du modèle servi au lieu de copier un alias supposé dans un autre client :
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
Utilisez l'identifiant renvoyé pour configurer un client compatible. Une requête réussie de liste des modèles prouve qu'ils sont détectés, pas que la génération est de qualité ; le premier contrôle pertinent reste une réponse de chat complète. Lors de cet essai initial, laissez désactivés les outils d'agent capables d'écrire des fichiers ou d'exécuter des commandes shell.
Si la carte manque de mémoire, réduisez d'abord le contexte et désactivez la vision. Si le processus est interrompu ou si la machine échange massivement des pages mémoire, examinez la RAM système, pas seulement la VRAM. En cas de bibliothèques d'exécution manquantes, consultez les instructions propres au backend au lieu d'installer des DLL quelconques. Le projet maintient un guide organisé par symptômes. Dépannage Strata
Sur Mac, distinguez la prise en charge du modèle de celle de Strata
Apple Silicon utilise une mémoire unifiée, plutôt que la séparation entre VRAM et RAM système du benchmark sur ordinateur de bureau. L'installateur Strata épinglé ne documente pas de parcours macOS pris en charge ; une demande de prise en charge Mac ne constitue pas un portage achevé. Demande Mac en amont
Deux expériences différentes peuvent être visées par les utilisateurs Mac. Un fork communautaire Strata-macOS conserve l'interface et l'API Python avec un backend Metal pour des modèles GGUF plus petits ; les vérifications documentées utilisent Qwen2.5, pas la configuration Flash-Next d'origine. Il ne porte explicitement ni le streaming des experts CUDA de Strata ni le parcours MTP. Ne considérez pas ce fork comme une installation en un clic du modèle dont parle cet article. Fork communautaire et périmètre
Pour Qwen3.8-Flash-Next lui-même, une autre voie expérimentale consiste à utiliser une compilation Metal compatible de llama.cpp avec les fichiers GGUF scindés de l'éditeur. Ce n'est pas Strata sur Mac, et le tableau de vitesse Windows ci-dessous ne s'applique pas.
Compilez séparément l'environnement d'exécution Metal
Utilisez un Mac Apple Silicon, un terminal ARM64 natif, les outils de développement en ligne de commande d'Apple, Git et CMake. Si CMake est absent, installez-le depuis sa distribution officielle ou votre gestionnaire de paquets de confiance. La documentation de compilation llama.cpp examinée active Metal par défaut sous macOS. Épingler aussi ce moteur évite qu'une branche mouvante ne modifie silencieusement l'exemple. Instructions de compilation Metal de llama.cpp
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
Téléchargez les deux fragments IQ2_XS depuis la liste de fichiers de l'éditeur dans un même répertoire, en conservant leurs noms d'origine. Le second fragment est nécessaire même si ses lignes de recherche restent sur le disque. Remplacez le chemin d'exemple ci-dessous par le chemin réel du premier fragment sur votre Mac :
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
L'éditeur documente le chargement des fichiers scindés et les options mmap/lazy ; le moteur examiné expose ces options. Elles rendent la table n-gram accessible à la demande au lieu d'exiger qu'elle réside intégralement en mémoire. Ce sont des options llama.cpp, pas des options du lanceur Strata. Exemple de chargement GGUF
La capacité reste déterminante : le fragment principal IQ2_XS fait 39,2 Go avant l'état d'exécution et les besoins de macOS. Un Mac de 16 ou 24 Go n'est donc pas une base crédible pour faire résider intégralement ce modèle selon cet exemple ; même 64 Go ne constituent qu'un point de départ pour la planification, pas une garantie de réussite. Surveillez la pression mémoire et le swap dans Moniteur d'activité, commencez avec un contexte de 4K et arrêtez si la pression mémoire reste élevée. Ne modifiez pas les limites de mémoire du noyau pour forcer un chargement qui échoue.
Vérifiez que les journaux indiquent l'utilisation de Metal et qu'une réponse cohérente en texte seul aboutit avant d'aller plus loin. Testez ensuite des prompts plus longs avant d'ajouter le décodage spéculatif ou la vision. Cette voie ne couvre pas les Mac Intel, l'exécution distribuée sur plusieurs Mac ni les conversions MLX. Aucun débit Mac n'est disponible ici ; les résultats dépendent de la puce exacte, de la mémoire unifiée, du moteur, de la quantification et du contexte.
La vitesse publiée est prometteuse ; la latence du premier jeton raconte une autre histoire
Pour obtenir une comparaison reproductible, le tableau utilise le benchmark de moteur 0.1.26 du 29 septembre 2026, plutôt que de mélanger des chiffres phares plus récents du README. La machine était équipée d'une RTX 5070 12 Go sur PCIe 5.0 x16, d'un Ryzen 5 7600 à six cœurs, de 64 Go de DDR5-5200 et de Windows 10. Les tests utilisaient une génération gloutonne, MTP activé, les images désactivées et 256 jetons générés. Conditions du benchmark
| Variante | Décodage sur prompt court, jetons/s | Décodage sur prompt long, jetons/s | Préremplissage sur prompt moyen, jetons/s | Premier jeton sur prompt long, secondes |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
Les catégories courte, moyenne et longue contiennent respectivement 3 562, 31 566 et 128 478 jetons de prompt. Chaque cellule correspond à une exécution, et non à une moyenne assortie d'un intervalle de confiance. L'exécution IQ2_XS utilise le fine-tuning Swift 1.5 documenté : il ne s'agit donc pas d'une comparaison contrôlée portant uniquement sur la quantification avec le modèle de base. Les valeurs sont reprises de la matrice de résultats publiée. Mesures lisibles par machine
Le cas Q2_0 avec un prompt long attend 62,48 secondes avant le premier jeton, malgré un décodage ultérieur à 73,73 jetons/s. Pour quelqu'un qui attend une réponse sur un nouveau document, cette première minute compte. L'expérience peut être différente dans une conversation suivie dont le contexte est réutilisable. Il ne faut masquer ni l'un ni l'autre derrière un débit maximal en jetons par seconde.
Ces chiffres étayent une conclusion limitée mais utile : sur l'ordinateur de bureau spécifié par l'auteur, certaines configurations quantifiées ont atteint des vitesses de génération interactives. Ils n'établissent pas le même résultat sur une machine à bande passante plus faible, en coréen, avec un raisonnement échantillonné, avec la vision activée ou en présence d'utilisateurs simultanés. Les jetons ne sont pas des mots, et la tokenisation propre à chaque langue complique aussi les comparaisons approximatives.
Le contexte natif de 262 144 jetons du modèle et ses affirmations relatives au contexte étendu ne garantissent pas non plus que la configuration Strata choisie puisse servir confortablement une telle longueur. L'état d'exécution, le placement du cache et la RAM disponible comptent toujours. Commencez modestement et n'augmentez le contexte que si la charge de travail justifie la latence et la mémoire supplémentaires.
La qualité et les fonctions de « vitesse » doivent être évaluées séparément
L'éditeur de la quantification publie des comparaisons de qualité utiles, mais ce ne sont pas des benchmarks Strata de bout en bout. Par exemple, son score LiveCodeBench v6 est de 87.43 pour BF16 et 81.14 pour Q2_0. C'est une raison de tester les tâches qui vous importent, pas de déclarer inutilisable toute sortie à faible nombre de bits ni toutes les variantes équivalentes. Évaluation publiée de la quantification
Experimental Speed Projection mérite une prudence particulière. Le projet décrit une fonction facultative à vecteur de contrôle qui modifie le comportement du modèle ; ce n'est pas une simple optimisation arithmétique invisible. Laissez-la désactivée pour la configuration de référence et signalez son utilisation dans toute comparaison. Une réponse plus rapide due à un contenu modifié ne mesure pas la même chose qu'une exécution plus rapide d'un travail équivalent. Détails de la fonction expérimentale
Pour votre propre évaluation, consignez le commit du dépôt, la version du moteur, la quantification et le fine-tuning, le GPU et sa VRAM, le CPU, la vitesse de la RAM, le SSD, le pilote, le réglage du contexte et les options activées. Mesurez ensuite au moins trois prompts indépendants et trois relances avec cache, et indiquez la médiane et l'étendue au lieu de sélectionner la meilleure exécution. Notez le nombre de jetons d'entrée et de sortie avec le délai avant le premier jeton, le débit de décodage et le temps total.
Associez les tests de vitesse à des contrôles de justesse adaptés à la tâche : compilez et testez les réponses de programmation, comparez les réponses sur document à la source et vérifiez la langue et la terminologie des sorties multilingues. Consignez les échecs, les délais dépassés et les épuisements de mémoire en plus des exécutions réussies.
L'exécution locale change le contrôle, mais pas tous les risques de sécurité
Conservez l'adresse de bouclage par défaut. Exposer un serveur de modèle local à un réseau local ou à Internet change son modèle de menace, et une API compatible n'est pas automatiquement un service authentifié. La politique de sécurité de Strata décrit l'écoute locale et son périmètre de sécurité ; elle ne prétend pas qu'un audit de sécurité externe indépendant a été effectué. Politique de sécurité Strata
La génération locale peut réduire la dépendance envers un fournisseur d'inférence hébergé, mais la confidentialité dépend toujours de l'ensemble du flux de travail. Journaux de chat, applications clientes, recherche Web, outils externes et sauvegardes peuvent envoyer ou conserver des données hors du processus du modèle. Examinez ces chemins avant de confier des documents confidentiels à un agent. « Fonctionne en local » décrit utilement une architecture, mais ne constitue pas une certification complète de confidentialité.
Les licences forment elles aussi plusieurs couches. La licence du code de Strata ne remplace pas les conditions qwen-community-1.0 du modèle. Les poids quantifiés n'effacent pas les obligations liées au modèle d'origine. Lisez les licences applicables avant toute redistribution ou utilisation commerciale, au lieu de supposer qu'un dépôt ouvert autorise tous les usages. Licence du modèle Qwen
L'enjeu est une autre conception de l'ordinateur personnel dédié à l'IA
La conclusion la plus importante n'est pas que l'inférence dans le cloud soit devenue obsolète. Un ordinateur de bureau reste limité en matière de service simultané, de latence du premier jeton, de consommation électrique, de maintenance et de qualité du modèle. Un système hébergé peut rester préférable lorsque la disponibilité ou un volume élevé de requêtes prime sur le contrôle de l'environnement d'exécution.
Ce que Strata laisse entrevoir, c'est que l'inférence grand public peut être limitée autant par l'orchestration que par la capacité du GPU. Une meilleure utilisation du CPU, de la RAM et de l'accès clairsemé au stockage peut rendre accessibles des modèles qu'un calcul simpliste supposant une exécution entièrement sur GPU écarterait. La bande passante de la mémoire système devient un élément des spécifications d'un ordinateur dédié à l'IA, et non un détail secondaire.
C'est une déduction tirée de l'architecture et des résultats publiés, pas une garantie concernant tous les futurs modèles. Elle suppose que les modèles exposent des composants clairsemés, pouvant être mis en cache ou orientés vers la recherche, qu'un environnement d'exécution peut exploiter. Un modèle dense aux profils d'accès différents ne bénéficiera pas du même avantage simplement parce qu'il a un nombre de paramètres similaire.
Pour un chercheur ou un développeur, l'étape suivante réaliste est un essai limité : une version épinglée, un contexte court, une machine prise en charge, quelques tâches représentatives et un compte rendu honnête de la qualité et de la latence. Le jalon est utile précisément lorsqu'il est décrit ainsi. Un très grand modèle est devenu une charge de travail de bureau plausible grâce à un placement et à une vérification soignés, et non parce que les contraintes matérielles ont disparu.
Gardez les décisions de configuration avec vos notes de recherche
Lorsque vous comparez des configurations d'IA locale, rassemblez les sources, les détails matériels, les observations et les questions en suspens. Telli.sh peut vous aider à organiser ces notes et résumés, sans laisser entendre qu'une intégration Strata est intégrée au produit. Créer un compte Telli.sh