Strata y Qwen3.8-Flash-Next: cómo ejecutar un modelo de clase 180B en un PC personal
Guía contrastada con fuentes sobre la arquitectura de Strata, la configuración en Windows y Linux, la vía independiente para Mac con Apple Silicon, los benchmarks publicados y los límites de la IA local.
Que un modelo de aproximadamente 180.000 millones de parámetros funcione en un ordenador de sobremesa con una tarjeta gráfica de 12 GB parece una contradicción. Strata hace plausible esa posibilidad, pero no metiendo todos los parámetros en la tarjeta. Su logro más interesante consiste en hacer que distintas partes de un modelo disperso utilicen diferentes tipos de memoria y capacidad de cálculo, sin que cada token generado acabe bloqueado por las transferencias de almacenamiento.
El nombre oficial del modelo es Qwen3.8-Flash-Next, no Qwen3.8-Next-Flash. Qwen enumera un núcleo de 125B parámetros con 6B activos, un componente adicional de embeddings n-gram de 51B y 4B para la predicción de múltiples tokens. El total redondeado de 180B describe los componentes almacenados; no es la cantidad de cálculo denso que se realiza para cada token. Ficha del modelo Qwen
La configuración y los datos de rendimiento que siguen corresponden a la revisión de Strata fb58e0dbc8399662c0e47c76578c6e878b14f6cf. Las cifras del benchmark son mediciones publicadas por el proyecto; tu hardware, prompt, contexto y variante del modelo pueden dar resultados distintos.
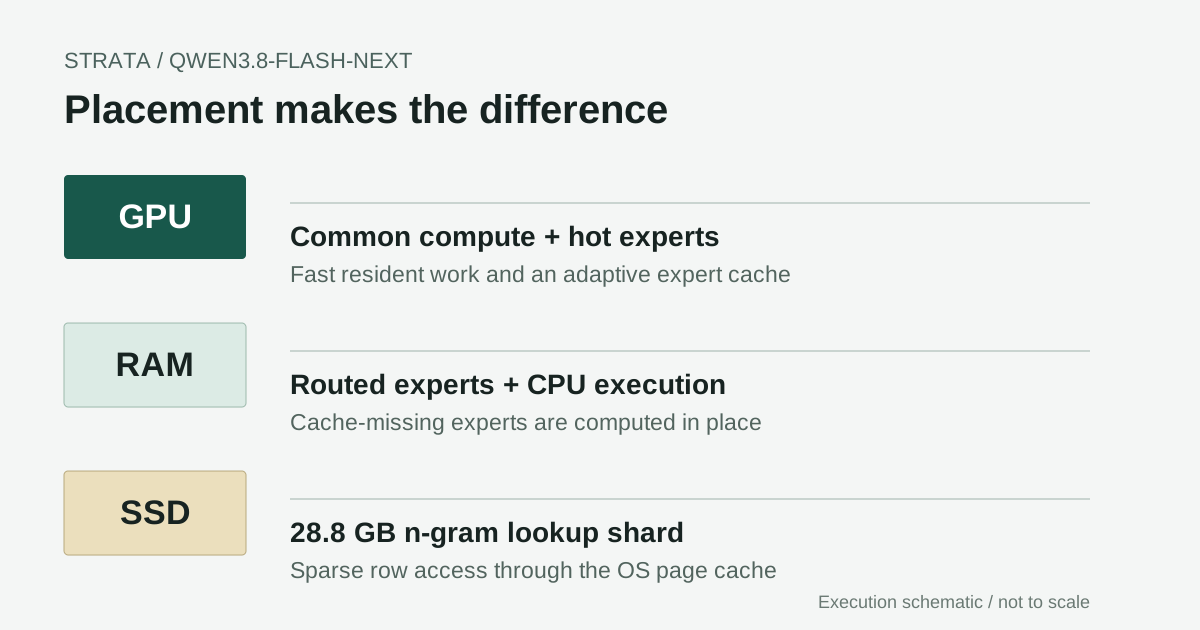
Esquema original basado en el diseño de ejecución documentado. Los niveles no están dibujados a escala: el tamaño de descarga, el uso de RAM y la residencia en GPU son magnitudes distintas.
El avance está en la ubicación, no en reducir el tamaño del modelo
Hay tres preguntas que conviene plantearse ante cualquier modelo local excepcionalmente grande: cuánto hay que almacenar, cuánto está activo para un token y dónde se ejecuta el trabajo activo. Una cifra pequeña de parámetros activos solo responde a la segunda pregunta. No elimina la necesidad de mantener accesibles en algún lugar los demás pesos.
Strata es un motor de inferencia y una aplicación de ejecución local desarrollados por la comunidad, disponibles en el repositorio Niko1221. Su configuración documentada ofrece instalación en Windows y Linux, una interfaz de chat local, API compatibles y entrada de imágenes opcional. Es un proyecto comunitario independiente, no un producto oficial de escritorio de Qwen. Repositorio de Strata
El cambio de enfoque útil consiste en dejar de tratar un PC como si fuera una GPU con memoria insuficiente. Un ordenador de sobremesa también dispone de RAM del sistema, unidades vectoriales de CPU y la caché de páginas del sistema operativo. Algunos procesos son más lentos en esos recursos que en la memoria de la GPU, pero no todos son igual de inadecuados para ejecutarse allí. Una búsqueda en una tabla grande y una multiplicación de matrices densas no necesitan la misma estrategia de ubicación.
Esa distinción es lo que hace interesante el titular. El modelo sigue siendo grande; lo que cambia es la manera en que el entorno de ejecución decide qué partes necesitan la memoria más rápida en cada momento. Esto abre una vía práctica para la inferencia local sin demostrar que cualquier portátil corriente vaya a ejecutarlo bien.
La arquitectura dispersa crea la oportunidad
La arquitectura de Qwen combina bloques Gated DeltaNet de estilo recurrente con Qwen Sparse Attention, expertos enrutados y embeddings n-gram. El informe técnico explica por qué estos componentes están diseñados para escalar de forma más eficiente. Strata no inventó esos componentes del modelo; construye una estrategia de ejecución adaptada a sus distintos patrones de acceso. Informe de arquitectura de Qwen
El detalle del enrutamiento importa. Cada una de las 48 capas tiene 512 expertos enrutados; se activan 10 expertos enrutados por capa, además de un experto compartido. Eso significa que se almacenan 24.576 expertos enrutados en el conjunto de las capas. No significa que para un token se utilicen solo 10 de esos 24.576 expertos en todo el modelo. Configuración de arquitectura de Qwen
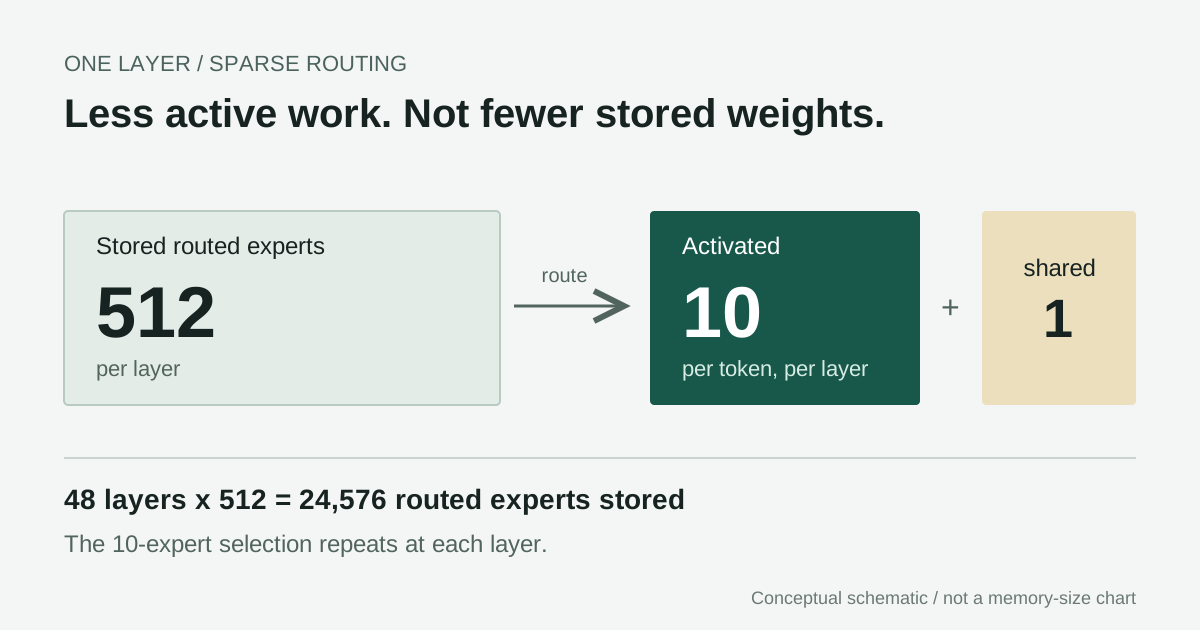
La selección reduce el trabajo activo, no el inventario almacenado. Este diagrama representa una capa, no el modelo completo de 48 capas.
Consideremos la consecuencia, al margen de cualquier afirmación sobre velocidad. Si un experto se selecciona pocas veces, ocupar permanentemente memoria costosa del acelerador puede ser un mal uso de la capacidad. Si otro componente se usa en cada paso, transferirlo una y otra vez probablemente salga caro. Un planificador útil debe distinguir estos casos y gestionar después los fallos de caché que no pueda evitar.
Por eso no se debería comparar un modelo disperso de clase 180B con uno denso de 180B basándose únicamente en el número de parámetros. A la inversa, llamarlo «un modelo de 6B» oculta el almacenamiento, el enrutamiento, el estado del contexto y el coste de acceder a pesos distribuidos. Ambos atajos difuminan el verdadero problema de ingeniería.
GPU, RAM y SSD cumplen funciones distintas
En la configuración base documentada, la GPU mantiene el cálculo común y una caché de los expertos enrutados que se usan con frecuencia. La RAM del sistema almacena los pesos de los expertos enrutados, y la CPU calcula in situ los expertos que no están en la caché de la GPU. Una tabla n-gram independiente, asignada a memoria, permanece en el SSD; las filas necesarias se sirven mediante la caché del sistema operativo. Descripción general de la ejecución de Strata
La ruta de CPU es más importante de lo que sugiere la etiqueta genérica «descarga». Durante la decodificación, un fallo de caché no obliga simplemente a copiar cada experto ausente a la GPU antes de continuar. El trabajo de CPU y GPU puede solaparse. La contrapartida es que la capacidad de la CPU y el ancho de banda de la memoria del sistema afectan directamente a la velocidad de generación.
El componente n-gram vuelve a presentar un patrón de acceso distinto. Su tabla es demasiado grande para mantenerla entera en la memoria normal, y cada búsqueda solo necesita filas concretas. En vez de leerla completa al arrancar, el proceso puede asignar el archivo a memoria y recurrir a la caché de páginas cuando hacen falta filas. Si el SSD o la memoria de trabajo son lentos, esa estrategia también tiene un coste. La paginación bajo demanda no hace que el almacenamiento sea gratuito: evita leer datos que nunca se necesitan.
La cuantización reduce aún más el tamaño de los pesos guardados. El repositorio documenta variantes cuantizadas de formato GGUF, pero cuantizar no es una compresión sin pérdida: se reduce la precisión y las distintas variantes implican compromisos diferentes entre tamaño y calidad. Además, los tamaños de archivo no predicen por sí solos la memoria pico del proceso ni la velocidad de los fallos de caché. Detalles de implementación de Strata
Mi lectura es que la innovación reside en un sistema coordinado, no en un único truco de compresión. La cuantización reduce el espacio que ocupan los pesos almacenados; la caché reduce el acceso repetido a los pesos más utilizados; la CPU gestiona los fallos; y las búsquedas dispersas evitan cargar de golpe una tabla enorme. Si se elimina cualquiera de estas ventajas, un ordenador de sobremesa con memoria modesta resulta mucho menos convincente como anfitrión.
La especulación ahorra trabajo solo cuando la verificación acepta
Strata también usa el componente de predicción de múltiples tokens del modelo para proponer continuaciones breves y verificarlas con el modelo objetivo. En lugar de pagar una pasada completa del modelo objetivo por cada token de salida, una propuesta acertada puede permitir que esa pasada acepte varios tokens. El repositorio describe propuestas de hasta tres tokens en su ruta MTP. Diseño e implementación de MTP
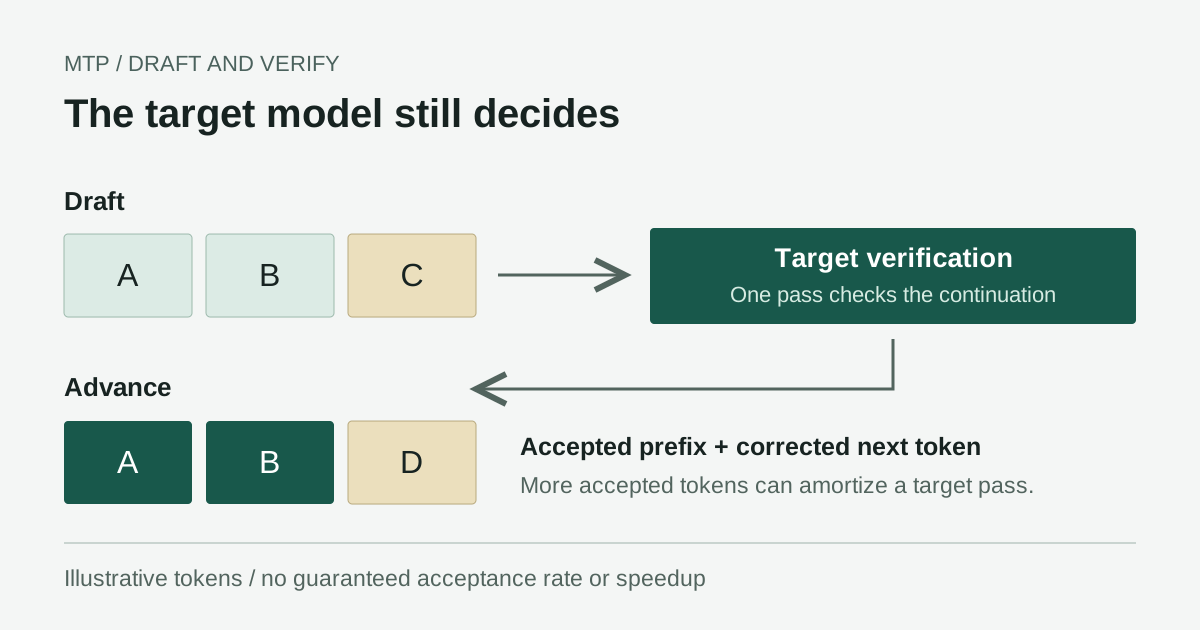
El ejemplo ilustra la verificación, no una tasa de aceptación garantizada ni una aceleración medida.
Esta aceleración es condicional. Puede ser más fácil proponer código predecible o texto repetido que una transición de razonamiento desconocida. La redacción del prompt, el muestreo, la longitud de la salida y la variante del modelo pueden cambiar el nivel de aceptación. Por tanto, no se debe asumir que un titular medido con un prompt describa otra tarea o idioma.
La verificación se hace con el modelo que realmente se está ejecutando. No recupera la información perdida por la cuantización ni demuestra equivalencia con los pesos BF16 originales. Es esencial mantener separadas estas dos cuestiones: la ejecución especulativa y la calidad de un modelo de precisión reducida responden a preguntas distintas.
Hay otra distinción relacionada con la reutilización de caché. Un prefijo de conversación que no ha cambiado puede ahorrar trabajo repetido, pero una continuación con caché activa y un prompt largo nuevo no son pruebas equivalentes. Al comparar resultados locales, registra si se reutilizó el prefijo. El proyecto documenta explícitamente el almacenamiento en caché de los límites de mensaje. Comportamiento de la caché de prefijos
«GPU de 12 GB» no significa una instalación de 12 GB
Las cuantizaciones GGUF publicadas dividen el modelo en un fragmento principal y otro fragmento n-gram fijo de 28.8 GB. Los tamaños de archivo de abajo están expresados en GB decimales y corresponden a descargas, no a requisitos de memoria de GPU. El proyector de visión opcional añade unos 0.91 GB; las descargas auxiliares y los archivos temporales de conversión necesitan espacio adicional. Archivos de cuantización de ISTA-DASLab
| Variante | Bits medios por peso del núcleo | Fragmento principal | Fragmento n-gram | Descarga total |
|---|---|---|---|---|
| Q2_0 | 2.40 | 37.6 GB | 28.8 GB | 66.4 GB |
| IQ2_XS | 2.50 | 39.2 GB | 28.8 GB | 68.0 GB |
| IQ3_XXS | 3.00 | 47.0 GB | 28.8 GB | 75.8 GB |
| IQ3_S | 3.50 | 54.8 GB | 28.8 GB | 83.6 GB |
El nombre del formato no describe con precisión todos los tensores. El fragmento principal usa formatos mixtos, mientras que el fragmento n-gram usa IQ4_NL. «Modelo de dos bits» es una abreviatura práctica, pero engañosa si da a entender que toda la descarga utiliza exactamente dos bits por parámetro. Metodología de cuantización
Para una primera prueba con el modelo completo, una GPU compatible de 12 GB o más y 64 GB de RAM del sistema constituyen una base de planificación más realista que fijarse solo en la GPU. El repositorio también analiza rutas que reducen el uso de RAM y una variante Coder podada. Son configuraciones distintas, no una prueba de que un equipo con 32 GB ofrezca la misma experiencia con el modelo completo. Selección de modelos de Strata
Yo reservaría 100-150 GB de espacio libre en SSD antes de experimentar. Es un margen de planificación prudente, no un requisito fijo del proveedor: la cuantización elegida, el modelo auxiliar MTP, los archivos de visión opcionales y las cachés de compilación o conversión determinan el total real. Algunas rutas de optimización de CPU para Q2 pueden necesitar una copia adicional considerable de los expertos. Comprueba la ruta seleccionada en vez de asumir que existe una única cifra de espacio en disco válida para todos.
Antes de elegir hardware, define la configuración que necesitas: modelo completo o podado, contexto corto o largo, visión o solo texto, rendimiento sostenido o uso ocasional. Esas decisiones cambian la ubicación del cuello de botella, y el benchmark siguiente describe un sistema concreto.
Instala una configuración base fijada antes de ajustar parámetros
La ruta estándar documentada cubre Windows 10/11 y Ubuntu 22.04/24.04, con GPU NVIDIA y algunos modelos AMD compatibles. Las instrucciones de NVIDIA especifican el controlador 580 o posterior. macOS y otros backends compilados desde el código fuente tienen requisitos propios; los comandos siguientes no son una configuración universal. Guía oficial de instalación
En Windows, comprueba todo antes de descargar
Si no tienes Git, instálalo desde su distribución oficial. En PowerShell, clona el repositorio upstream y fija la revisión analizada aquí:
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
.\START-HERE.bat --check
La comprobación evita descargar el modelo, que ocupa mucho espacio, pero el lanzador puede preparar Python y un entorno privado. Comportamiento de la comprobación de configuración
Lee el informe de hardware, inspecciona los scripts de configuración y confirma que tienes espacio suficiente antes de continuar. Después inicia la configuración interactiva:
.\START-HERE.bat
Para una primera prueba con 64 GB, IQ2_XS es un punto de partida razonable entre las opciones documentadas. Usa 32,768 tokens de contexto, solo texto y deja desactivada Experimental Speed Projection. Esta base más pequeña facilita aislar los problemas frente a empezar con el contexto máximo, visión y todas las optimizaciones activadas.
Cuenta con descargas e instalación de dependencias, no con un ejecutable diminuto que lo incluya todo. Según la ruta de GPU, la configuración utiliza un motor preparado o herramientas de compilación. Revisa cualquier solicitud relacionada con controladores, compiladores o privilegios de administrador; no desactives el antivirus ni las protecciones del navegador para forzar la instalación. Obtén los controladores necesarios del fabricante del hardware.
Los siguientes inicios se hacen con el mismo lanzador. Para volver a la configuración o evitar un conflicto de puertos:
.\START-HERE.bat --setup
.\START-HERE.bat --port 8081
En Ubuntu, utiliza el script de configuración documentado
git clone https://github.com/Niko1221/Strata.git
cd Strata
git checkout fb58e0dbc8399662c0e47c76578c6e878b14f6cf
./setup.sh
Elige el backend que corresponda a la GPU. Las rutas ROCm de AMD y CUDA de NVIDIA no son intercambiables. Trata las solicitudes para instalar paquetes o compiladores como cambios en tu propio equipo que debes revisar. La revisión fijada hace que el artículo sea reproducible; las versiones posteriores pueden mejorar la compatibilidad, así que lee sus notas de publicación antes de actualizar deliberadamente.
Comprueba una respuesta antes de conectar un agente
Cuando termine la carga, abre http://127.0.0.1:8080 en el navegador local, o en el puerto alternativo que hayas elegido. Envía una pregunta breve y no confidencial, y confirma que se completa una respuesta. Solo entonces prueba un prompt más largo, la reutilización de caché en una continuación y el idioma que tengas previsto usar. Vigila el uso de memoria y los registros del servidor durante la primera carga.
La API compatible documentada incluye GET /v1/models y POST /v1/chat/completions. Averigua el identificador del modelo que se está sirviendo en lugar de copiar un alias supuesto a otro cliente:
$base = "http://127.0.0.1:8080"
$models = Invoke-RestMethod "$base/v1/models"
$models.data | Select-Object id
Utiliza el identificador obtenido al configurar un cliente compatible. Que la solicitud para enumerar modelos tenga éxito solo demuestra que el modelo se detecta, no la calidad de la generación; la primera comprobación significativa es que finalice una respuesta de chat. Durante esta prueba inicial, mantén desactivadas las herramientas de agente que escriben archivos o ejecutan comandos de shell.
Si la tarjeta se queda sin memoria, reduce primero el contexto y desactiva la visión. Si el proceso se cierra o el equipo empieza a usar mucha memoria de intercambio, investiga la RAM del sistema, no solo la VRAM. Si faltan bibliotecas del entorno de ejecución, consulta las instrucciones específicas del backend en vez de instalar DLL arbitrarias. El proyecto mantiene una guía de problemas organizada por síntomas. Solución de problemas de Strata
En Mac, distingue la compatibilidad del modelo de la compatibilidad de Strata
Apple Silicon utiliza memoria unificada en vez de la distribución de VRAM independiente y RAM del sistema usada en el benchmark de sobremesa. El instalador de Strata fijado no documenta una ruta de macOS compatible; una solicitud de compatibilidad para Mac no equivale a un port terminado. Solicitud de compatibilidad con Mac upstream
Puede haber dos experimentos distintos detrás de lo que una persona usuaria de Mac quiere decir. Un fork comunitario de Strata para macOS conserva la interfaz y la API de Python con un backend Metal para modelos GGUF más pequeños; sus comprobaciones documentadas usan Qwen2.5, no la configuración original de Flash-Next. El fork indica expresamente que no porta el streaming de expertos CUDA ni la ruta MTP de Strata. No lo consideres una instalación con un clic del modelo de este artículo. Fork comunitario y alcance
Para Qwen3.8-Flash-Next propiamente dicho, existe una vía experimental aparte: una compilación compatible de llama.cpp con Metal y los archivos GGUF divididos del publicador. Esto no es Strata en Mac, y la tabla de velocidad de Windows que aparece más adelante no es aplicable.
Compila el entorno Metal independiente
Necesitas un Mac con Apple Silicon, una terminal ARM64 nativa, las herramientas de desarrollo de línea de comandos de Apple, Git y CMake. Si no tienes CMake, instálalo desde su distribución oficial o desde un gestor de paquetes de confianza. La documentación de compilación de llama.cpp revisada activa Metal de forma predeterminada en macOS. Fijar también este motor evita que una rama que avanza con el tiempo cambie silenciosamente el ejemplo. Instrucciones de compilación Metal de llama.cpp
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git checkout 71ad0590f4808b6202f9213d166913858c73b1bc
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build --config Release -j 4
./build/bin/llama-cli --version
Descarga los dos fragmentos IQ2_XS de la lista de archivos del publicador en un mismo directorio y conserva sus nombres originales. El segundo fragmento es necesario aunque las filas de búsqueda permanezcan en el disco. Sustituye la ruta de ejemplo de abajo por la ruta real del primer fragmento en tu Mac:
./build/bin/llama-cli \
  -m "/path/to/IQ2_XS/Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf" \
  -lm mmap --lazy-mode on -ngl 99 \
  --ctx-size 4096 --n-predict 128 \
  -p "Explain sparse expert routing in three sentences."
El publicador documenta la carga de archivos divididos y las opciones mmap/lazy; el motor revisado ofrece esos parámetros. Permiten disponer de la tabla n-gram bajo demanda, sin exigir que resida entera en memoria. Son opciones de llama.cpp, no del lanzador de Strata. Ejemplo de carga GGUF
La capacidad sigue importando: el fragmento principal IQ2_XS ocupa 39.2 GB antes del estado de ejecución y la sobrecarga de macOS. Por tanto, un Mac de 16 GB o 24 GB no es una base realista para ejecutar el ejemplo con toda su memoria residente; incluso 64 GB son un punto de partida para planificar, no una garantía de éxito. Comprueba la presión de memoria y el uso de intercambio en Monitor de Actividad, empieza con un contexto de 4K y detente si la presión de memoria sigue siendo alta. No uses cambios en los límites de memoria del kernel para forzar una carga que no cabe.
Confirma en los registros que se selecciona Metal y que termina una respuesta coherente solo con texto antes de seguir experimentando. Después, prueba consultas más largas antes de añadir decodificación especulativa o visión. Esta vía no cubre los Mac Intel, la ejecución distribuida entre varios Mac ni las conversiones MLX. Aquí no hay cifras de rendimiento en Mac: los resultados dependen del chip exacto, la memoria unificada, el motor, la cuantización y el contexto.
La velocidad publicada resulta prometedora; la latencia hasta el primer token cuenta otra historia
Para una comparación reproducible, la tabla utiliza el benchmark del 29 de septiembre de 2026 con el motor 0.1.26, en lugar de mezclar titulares posteriores del README. El equipo de prueba tenía una RTX 5070 de 12 GB en PCIe 5.0 x16, un Ryzen 5 7600 de seis núcleos, 64 GB de DDR5-5200 y Windows 10. Las pruebas usaron generación codiciosa, MTP activado, imágenes desactivadas y 256 tokens generados. Condiciones del benchmark
| Variante | Decodificación con prompt corto, tokens/s | Decodificación con prompt largo, tokens/s | Prefill con prompt medio, tokens/s | Primer token con prompt largo, segundos |
|---|---|---|---|---|
| Q2_0 | 92.97 | 73.73 | 2170.85 | 62.48 |
| IQ2_XS | 78.60 | 62.72 | 2092.02 | 74.85 |
| IQ3_XXS | 61.64 | 48.95 | 1745.16 | 81.71 |
| IQ3_S | 53.30 | 45.51 | 1624.07 | 90.72 |
Los niveles corto, medio y largo contienen 3,562, 31,566 y 128,478 tokens de prompt, respectivamente. Cada celda representa una ejecución, no una media con intervalo de confianza. La ejecución IQ2_XS usa el ajuste fino documentado Swift 1.5, por lo que no constituye una comparación controlada que varíe solo la cuantización respecto al modelo base. Los valores se han copiado de la matriz de resultados publicada. Mediciones legibles por máquina
El caso Q2_0 con prompt largo tarda 62.48 segundos en producir el primer token, pese a que después decodifica a 73.73 tokens/s. Para quien espera una respuesta a un documento nuevo, ese primer minuto importa. La experiencia puede ser distinta en una conversación en curso con contexto reutilizable. Ninguno de esos aspectos debería quedar oculto tras una cifra máxima de tokens por segundo.
Estas cifras respaldan una conclusión acotada y útil: en el ordenador de sobremesa especificado por el autor, algunas configuraciones cuantizadas seleccionadas alcanzaron velocidades de generación interactivas. No demuestran que se obtenga lo mismo en un equipo con menor ancho de banda, en coreano, con razonamiento basado en muestreo, con visión activada o con usuarios concurrentes. Los tokens no son palabras, y la tokenización de cada idioma también complica las comparaciones informales.
Del mismo modo, el contexto nativo de 262,144 tokens del modelo y sus afirmaciones sobre contexto extendido no garantizan que tu configuración de Strata pueda atender cómodamente esa longitud. El estado de ejecución, la ubicación de la caché y la RAM disponible siguen importando. Empieza con poco contexto y auméntalo solo cuando la tarea justifique la latencia y la memoria adicionales.
La calidad y las funciones de «velocidad» requieren comprobaciones por separado
El publicador de la cuantización ofrece comparaciones de calidad útiles, pero no son benchmarks de extremo a extremo de Strata. Por ejemplo, su puntuación LiveCodeBench v6 es 87.43 para BF16 y 81.14 para Q2_0. Es un motivo para probar las tareas que te importan, no para declarar inutilizable toda salida de pocos bits ni equivalentes todas las variantes. Evaluación de cuantización publicada
Experimental Speed Projection exige especial cautela. El proyecto describe una función opcional de vector de control que cambia el comportamiento del modelo; no es simplemente una optimización aritmética invisible. Déjala desactivada en la configuración base y declárala si la utilizas al comparar resultados. Una respuesta más rápida causada por un cambio en el contenido no equivale a ejecutar más deprisa el mismo trabajo. Detalles de la función experimental
Para tu propia evaluación, registra el commit del repositorio, la versión del motor, la cuantización y el ajuste fino, la GPU y su VRAM, la CPU, la velocidad de la RAM, el SSD, el controlador, el ajuste de contexto y los interruptores de funciones. Mide después al menos tres prompts nuevos y tres continuaciones con caché, e informa de la mediana y el intervalo en vez de elegir la mejor ejecución. Anota el número de tokens de entrada y salida junto con el tiempo hasta el primer token, la velocidad de decodificación y el tiempo total.
Combina las pruebas de velocidad con verificaciones de corrección específicas para cada tarea: compila y prueba las respuestas de programación, compara las respuestas sobre documentos con la fuente y verifica el idioma y la terminología de las salidas multilingües. Registra los fallos, los tiempos de espera agotados y el agotamiento de memoria junto con las ejecuciones correctas.
La ejecución local cambia el control, pero no elimina todos los riesgos de seguridad
Mantén la dirección loopback predeterminada. Exponer un servidor de modelos local a la LAN o a Internet cambia su modelo de amenazas, y una API compatible no es automáticamente un servicio autenticado. La política de seguridad de Strata describe la vinculación local y su ámbito de seguridad; no afirma que se haya sometido a una auditoría de seguridad externa independiente. Política de seguridad de Strata
La generación local puede reducir la dependencia de un proveedor de inferencia alojado, pero la privacidad sigue dependiendo del flujo de trabajo completo. Los registros de chat, las aplicaciones cliente, las búsquedas web, las herramientas externas y las copias de seguridad pueden enviar o conservar datos fuera del proceso del modelo. Revisa esas rutas antes de proporcionar documentos confidenciales a un agente. «Se ejecuta localmente» es un dato útil de arquitectura, no una certificación de privacidad completa.
Las licencias también tienen varias capas. La licencia del código de Strata no sustituye las condiciones qwen-community-1.0 del modelo. Los pesos cuantizados no eliminan las obligaciones asociadas al modelo original. Lee las licencias aplicables antes de redistribuir o desplegar comercialmente; no des por hecho que un repositorio abierto permite cualquier uso. Licencia del modelo Qwen
La implicación es un ordenador personal para IA de otra clase
La principal implicación no es que la inferencia en la nube haya quedado obsoleta. Un ordenador de sobremesa sigue teniendo limitaciones en el servicio concurrente, la latencia hasta el primer token, el consumo energético, el mantenimiento y la calidad del modelo. Un sistema alojado puede seguir siendo la mejor opción cuando la disponibilidad o un gran volumen de solicitudes importan más que controlar el entorno de ejecución.
Lo que sugiere Strata es que la inferencia para consumidores puede estar tan limitada por la orquestación como por la capacidad de la GPU. Aprovechar mejor la CPU, la RAM y el acceso disperso al almacenamiento puede desbloquear una clase de modelos que un cálculo simplista de «todo en GPU» descartaría. El ancho de banda de la memoria del sistema pasa a formar parte de las especificaciones del ordenador para IA, en vez de quedar como un detalle secundario.
Es una inferencia basada en la arquitectura y los resultados publicados, no una garantía sobre todos los modelos futuros. Depende de que los modelos expongan componentes dispersos, almacenables en caché o basados en búsquedas que el entorno de ejecución pueda aprovechar. Un modelo denso con otros patrones de acceso no heredará la misma ventaja por tener un número parecido de parámetros.
Para quienes investigan o desarrollan de forma independiente, el siguiente paso realista es una prueba acotada: una versión fijada, un contexto corto, un equipo compatible, unas cuantas tareas representativas y un registro honesto de calidad y latencia. El avance tiene valor precisamente si se describe así. Un modelo muy grande se ha convertido en una carga de trabajo de sobremesa plausible gracias a una ubicación y una verificación cuidadosas, no porque hayan desaparecido las limitaciones del hardware.
Guarda junto a tus notas de investigación las decisiones de configuración
Cuando compares configuraciones de IA local, reúne en un mismo sitio los enlaces a las fuentes, los detalles del hardware, tus observaciones y las preguntas pendientes. Telli.sh puede ayudarte a organizar esas notas y resúmenes, sin dar a entender que incluye una integración con Strata. Crea una cuenta de Telli.sh