[Notatki z terenu lokalnej AI 01] Kolejny sprawdzian Straty: duży model przydatny na Twoim komputerze
Beta Straty 0.2 stała się aplikacją komputerową. Trzy opublikowane przykłady sprzętu konsumenckiego pokazują, co działa, co zużywa pamięć i dokąd zmierza lokalna AI.
Najciekawsza demonstracja lokalnej AI to taka, z której nadal można korzystać w przyszłym tygodniu. Duży model udzielający błyskotliwej odpowiedzi na komputerze do gier to ważny krok; otwarcie jutro tej samej rozmowy, odnalezienie plików modelu i bezpieczne zlecenie mu zmian w projekcie to już początki użytecznego narzędzia.
Strata zbliżyła się do tej drugiej kategorii wraz z 0.2.0-beta z 19 października 2026 r.: aplikacją komputerową, interfejsem Terminal i osobno pakowanymi silnikami. Do 23 października ukazała się już 0.2.3. Faktyczna nazwa bety ma znaczenie przy pobieraniu: chodzi o linię wydań 0.2, a nie zapowiedzianą przyszłą wersję 2.0. Wydanie beta, wydanie z 23 października
Pierwsza część cyklu „Notatki z terenu lokalnej AI” sprawdza, co ta zmiana daje osobie, która chce wykorzystać posiadany komputer. Połączymy nowy interfejs z trzema opublikowanymi przykładami sprzętu, odróżnimy warianty modeli od różnych architektur i przyjrzymy się pracom, dzięki którym lokalne wnioskowanie może stać się niezawodną usługą na co dzień.
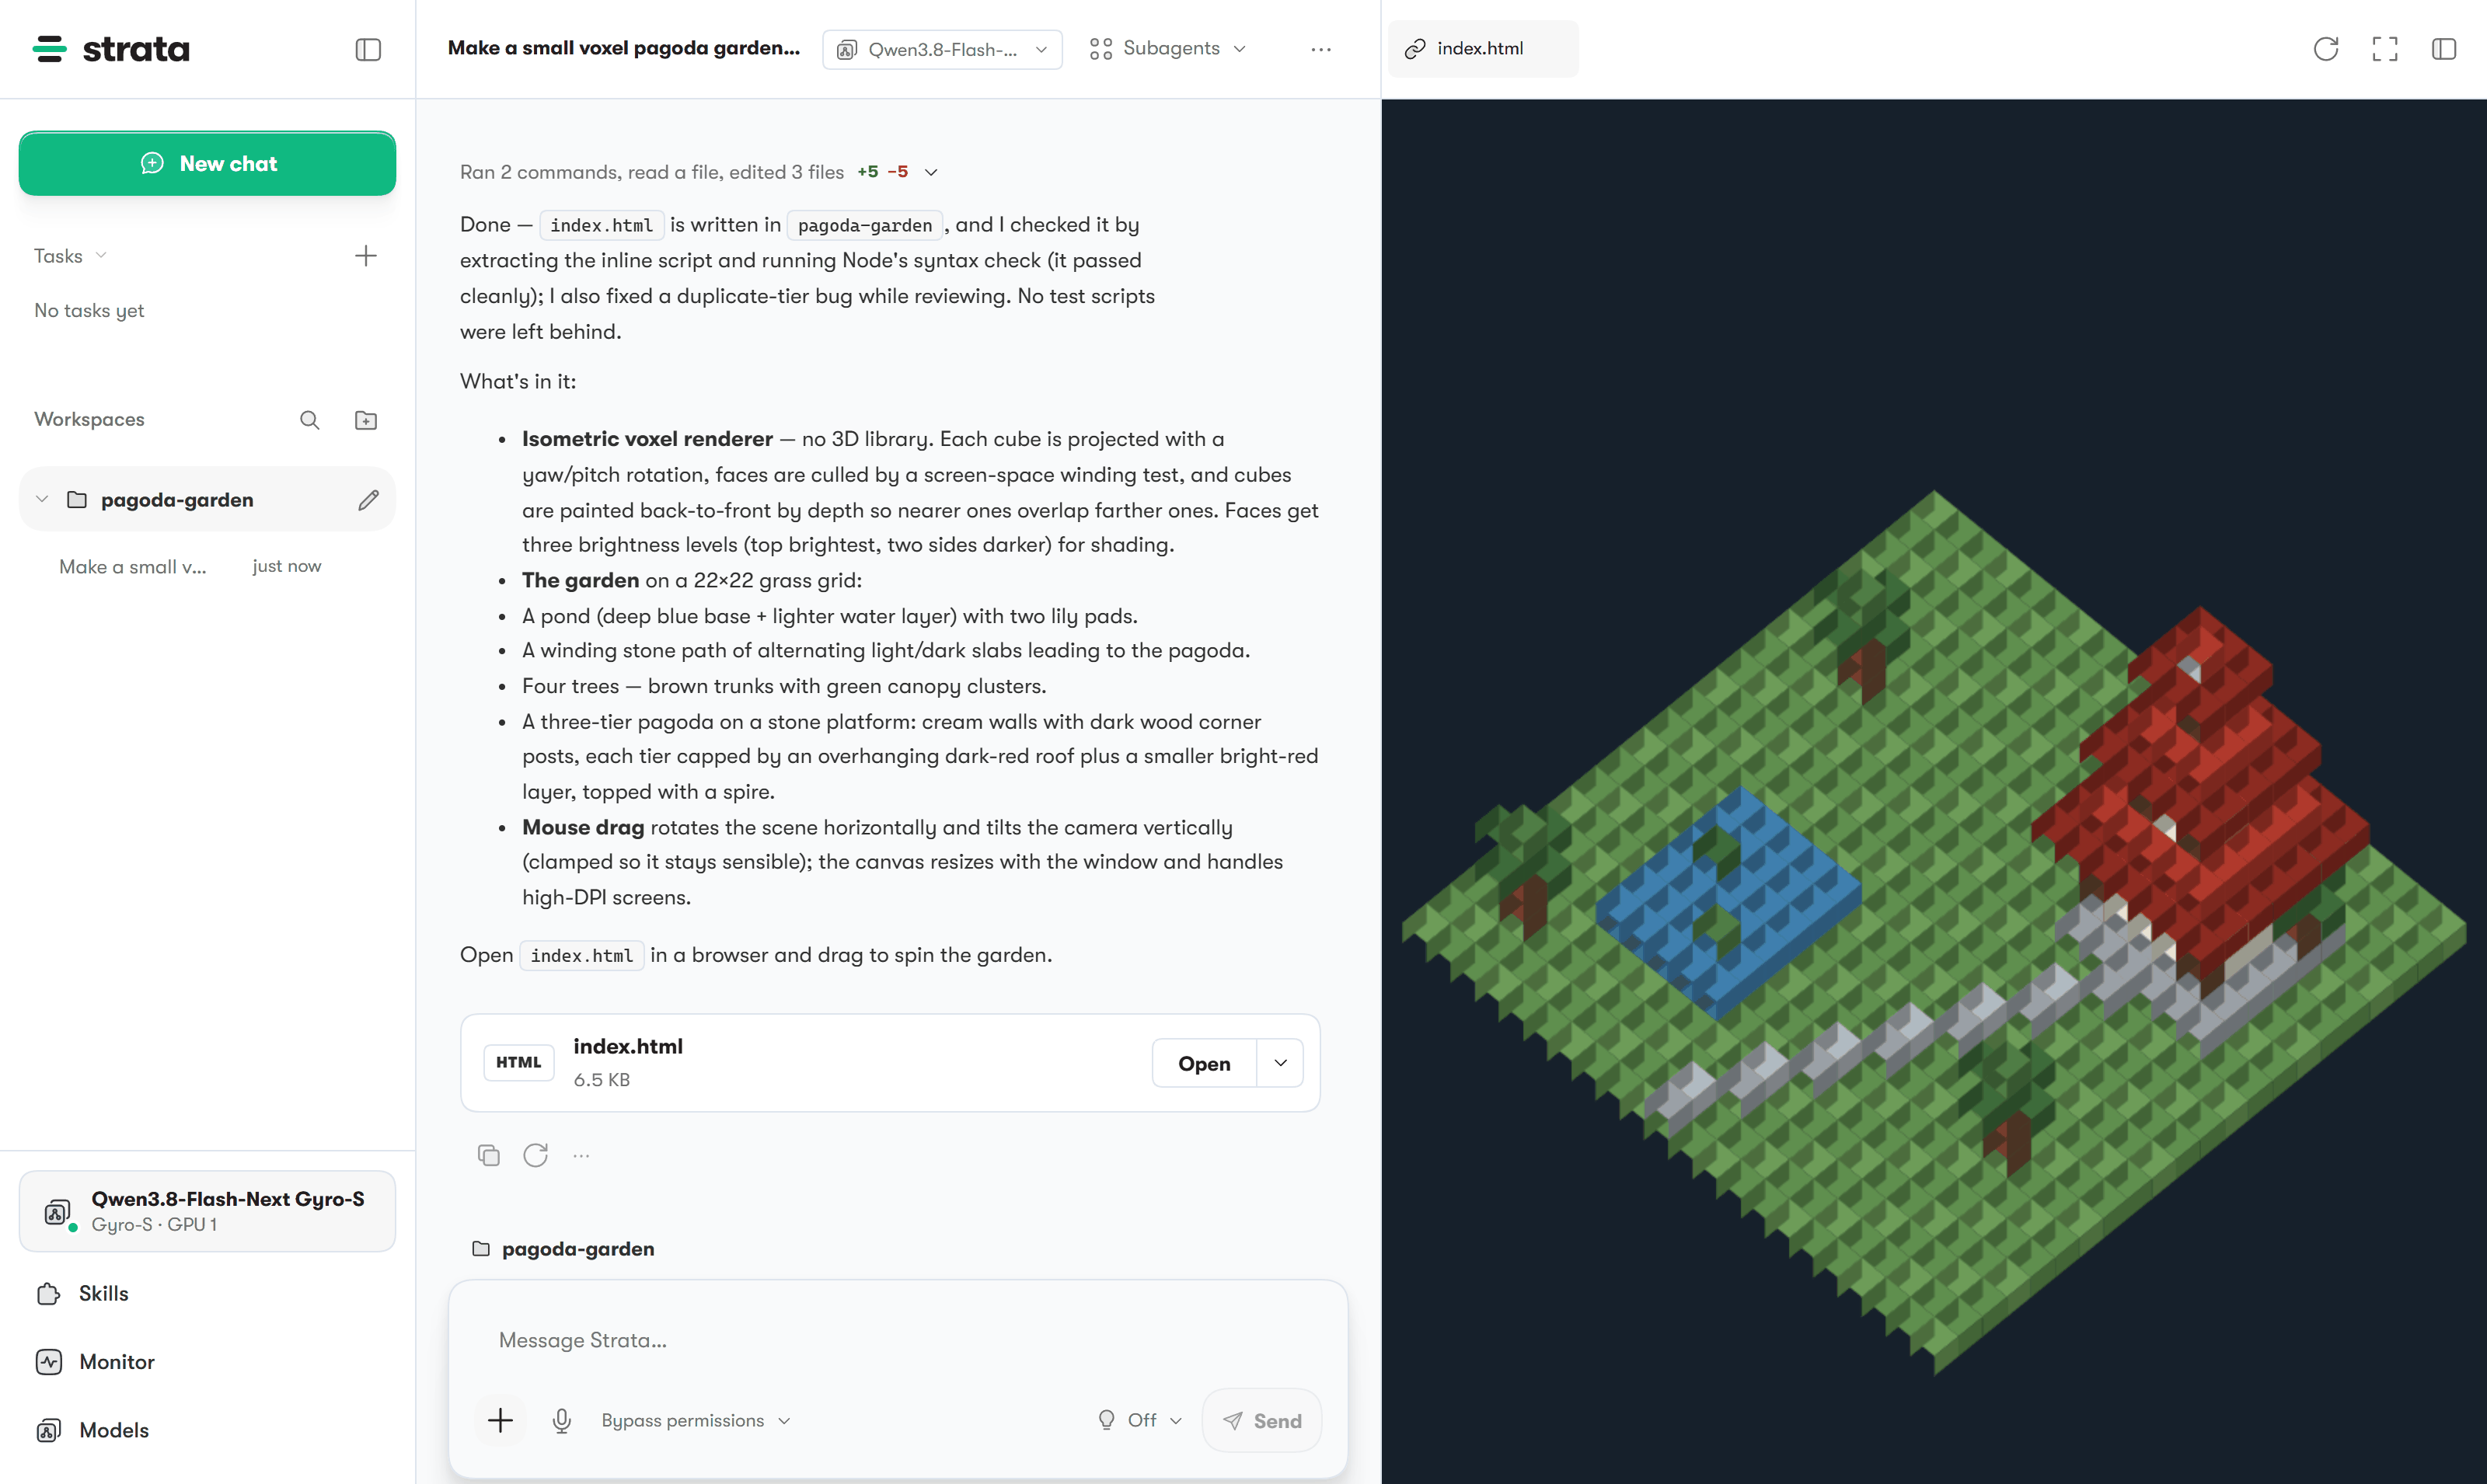
Oficjalny zrzut Straty z repozytorium 0.2.3, przedstawiający rozmowę o programowaniu i podgląd HTML. Ilustruje interfejs, a nie test wykonany na potrzeby tego artykułu. © 2026 Niko1221 and the Strata contributors; źródło, licencja MIT.

Beta zmieniła silnik w narzędzie, do którego można wracać
Aplikacja komputerowa łączy wybór modelu, zarządzanie miejscem na dysku, czat, monitorowanie sprzętu i przestrzeń do programowania. Tryb uprawnień Manual pyta o zgodę przed zmianami; bardziej liberalny Bypass daje agentowi większą swobodę. Terminal oferuje prowadzoną konfigurację strata launch i połączenia z klientami programistycznymi. Oba interfejsy korzystają z tego samego silnika. Funkcje 0.2.0-beta
Dla programisty tworzy to prosty przykładowy scenariusz: poprosić o niewielki parser w projekcie testowym, przejrzeć proponowane pliki, uruchomić testy i kontynuować rozmowę na przykładzie, który zawodzi. Dla osoby pracującej z dokumentami podobnym pierwszym zadaniem jest konkretne pytanie o dostarczony fragment, a następnie prośba o dokładny cytat potwierdzający odpowiedź. Żaden z tych scenariuszy nie wymaga przekształcenia modelu w samodzielnego pracownika.
Praktycznym usprawnieniem jest ciągłość. Graficzny wybór modelu zmniejsza ryzyko uruchomienia niezgodnej konfiguracji; monitor sprzętu pomaga wyjaśnić wpływ innej aplikacji na wydajność; zapisany profil pozwala powtórzyć udany eksperyment. Te funkcje nie zwiększają zdolności rozumowania modelu. Zmniejszają nakład pracy dzielący dostępność tych zdolności od ich odpowiedzialnego wykorzystania.
Naszym zdaniem to właśnie o ten dystans będzie toczyć się kolejna rywalizacja w lokalnej AI. Wygra doświadczenie, w którym łatwo zachować dobrą konfigurację, zrozumieć awarię i przejrzeć ryzykowne działanie.
Cały system pamięci komputera staje się częścią modelu
Głównym celem Straty jest Qwen3.8-Flash-Next, którego rdzeń ma 125 miliardów parametrów. Strategia wykonania wykorzystuje pamięć GPU do wspólnych obliczeń i często potrzebnych ekspertów, systemową pamięć RAM i CPU do pozostałych ekspertów oraz SSD do tablicy wyszukiwania n-gramów. Większa karta graficzna pomaga, ale RAM i dysk nadal uczestniczą we wnioskowaniu. Opis projektu, projekt wykonania
Wyobraź sobie komputer jako warsztat z kilkoma blatami roboczymi. Najszybszy ma ograniczoną powierzchnię, więc środowisko wykonawcze musi zdecydować, które zadania warto na nim zatrzymać. Lepsza decyzja pozwala lepiej wykorzystać posiadany sprzęt; nie sprawi jednak, że wszystkie blaty staną się równie szybkie.
Trzy wielkości wymagają osobnej uwagi. Pobierane pliki zajmują dysk. Załadowane wagi i bufory wykonawcze zużywają pamięć. Okno kontekstu dodaje stan roboczy w miarę rozrastania się rozmowy. Sam rozmiar pliku nie mówi zatem, ile VRAM potrzebujesz ani jak szybko zobaczysz pierwszą odpowiedź.
Aktualne zalecenie projektu na początek to co najmniej 32 GB RAM i VRAM łącznie oraz około 80 GB wolnego miejsca na dysku dla typowej konfiguracji. To wskazówki wejściowe, a nie obietnica, że każdy model, długość kontekstu i system operacyjny zmieszczą się w takim limicie. Podstawowego laptopa z 16 GB nie należy utożsamiać z opisanymi niżej komputerami stacjonarnymi. Wymagania sprzętowe
Więcej nazw modeli nie zawsze oznacza więcej architektur
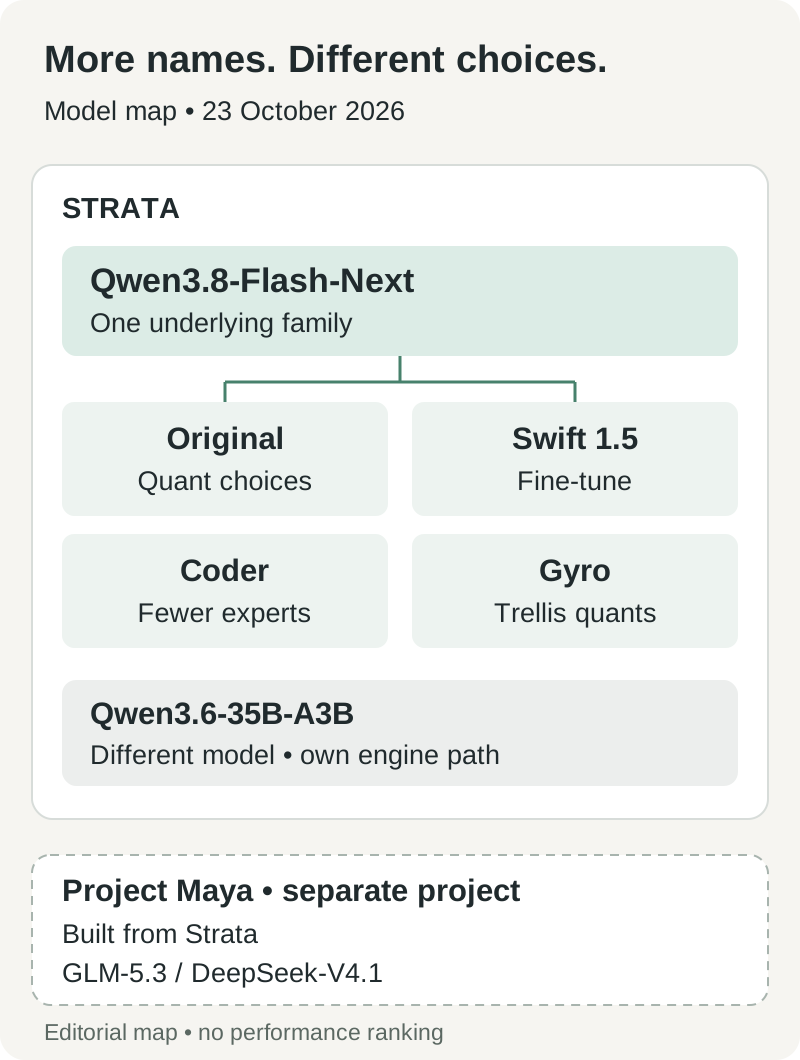
Autorska mapa redakcyjna udokumentowanych powiązań modeli, sprawdzona 23 października. Gałęzie pokazują pochodzenie i obsługę przez silnik, a nie jednakową jakość czy wymienność plików.
Oryginalny Flash-Next oraz warianty Swift 1.5, Coder i Gyro odpowiadają na różne potrzeby w obrębie tej samej rodziny. Swift zmienia zachowanie przez dostrajanie. Coder usuwa ekspertów uznanych za mniej przydatnych w zadaniach programistycznych. Gyro zmienia sposób reprezentacji wag. Traktowanie tych nazw jako czterech niezależnych modeli bazowych sprawia, że katalog wydaje się szerszy, niż jest naprawdę. Przewodnik po modelach
Te różnice mają konsekwencje. Coder zachowuje 256 z 512 ekspertów w każdej warstwie, a projekt ostrzega przed słabszymi wynikami ogólnymi i w językach innych niż angielski. Model wybrany dlatego, że mieści się na komputerze do programowania, nie powinien automatycznie stać się domyślnym wyborem do wielojęzycznych pytań o dokumenty. Krótsze rozumowanie Swifta może skrócić czas wykonania, choć sprzęt nie generuje każdego tokena szybciej. Kompromisy między wersjami
Gyro-S wymaga pobrania 58,5 GB, choć udokumentowane zapotrzebowanie wag na pamięć RAM i VRAM łącznie wynosi 27,6 GB. Tablica n-gramów pozostaje na SSD. W ocenie projektu jakość wypada słabiej niż w większych wariantach niskobitowych; zmieszczenie się w mniejszej pamięci ma swoją cenę. Dokumentacja Gyro
Jest też rzeczywiście drugi model: Qwen3.6-35B-A3B, model mixture-of-experts o 35 miliardach parametrów, z których 3 miliardy są aktywne, obsługiwany przez osobną ścieżkę silnika. Udokumentowane możliwości obejmują obrazy i równoległe żądania w obsługiwanych konfiguracjach NVIDIA i AMD; silnik dla Maca go nie uruchamia. To czyni go sensowną alternatywą do oceny, gdy największa liczba parametrów w nagłówku nie jest Twoim rzeczywistym wymaganiem. Obsługa Qwen3.6
Trzy opublikowane komputery pokazują trzy rodzaje użyteczności
Poniższe przykłady opublikowali członkowie społeczności lub sam projekt. To pomiary konkretnych konfiguracji, a nie testy wykonane na potrzeby tego artykułu. Mają pokazać możliwą pracę i jej koszt, zamiast ustawiać trzy komputery w rankingu na podstawie nieporównywalnych promptów.
| Opublikowany przykład | Model i warunki kontekstu | Raportowany wynik | W czym pomaga podjąć decyzję |
|---|---|---|---|
| Społeczność, 9 października: RTX 3060 12 GB, Core i7-12700, 64 GB DDR4-3200, NVMe, Windows 11 | Strata 0.1.41; oryginalny Q2_0; okno 131 072 tokenów; nowy prompt 4096 tokenów, 256 tokenów wyjściowych; rozumowanie i wizja wyłączone; trzy przebiegi | Mediana 42,9 tokena wyjściowego/s; 4,7 s do pierwszego tokena; 10,6 s łącznie | Starsza karta 12 GB pozwala na krótką pracę interaktywną, jeśli towarzyszy jej dużo systemowej pamięci RAM |
| Społeczność, 9–10 października: RX 9060 XT 16 GB, Ryzen 7 9800X3D, 64 GB DDR5-6000, Windows 11 | Silnik 0.1.40.3; IQ2_XS; okno 122 880 tokenów; prefill 8192; nowe wejście 8019 tokenów, niski poziom rozumowania; trzy przebiegi | Mediana 879,4 tokena promptu/s, 56,3 tokena wyjściowego/s, 11,212 s łącznie | Przy wejściach długości dokumentu konfiguracja promptu może mieć znaczenie równie duże jak szybsza karta |
| Pomiar projektu, udokumentowany do 23 października: M4 Mac mini, 32 GB pamięci zunifikowanej | Gyro-S; strumieniowanie ekspertów z SSD; obszar ekspertów 11–12 GB; bez warstwy draft; opowiadanie 120 tokenów; nie podano całkowitego okna | Mediana 9,14 tokena wyjściowego/s w pięciu przeplatanych parach; osobny prompt 4065 tokenów odczytywany z prędkością 109 tokenów/s | Kompaktowy komputer może uruchomić duży model, kosztem dłuższego oczekiwania |
Źródła: raport RTX 3060, raport RX 9060 XT, pomiary Maca. Raporty te poprzedzają dzisiejsze wydanie aplikacji lub różnią się od niego.
Przykład RTX 3060 jest przydatny, ponieważ obejmuje oczekiwanie przed rozpoczęciem odpowiedzi. Interfejs pokazujący około 43 tokenów na sekundę może mimo to zatrzymać się na czas odczytywania pytania. Raport odnotowuje również spowolnienie termiczne i niekontrolowaną aktywność w tle; jego wartością jest realistyczne określenie granic jednego komputera, a nie wyidealizowana specyfikacja GPU.
Dla użytkownika Radeona istnieje dowód konkretnego przepływu pracy wykraczający poza pętlę pomiaru prędkości. Autor uruchomił przez klienta programistycznego trzy syntetyczne zadania TypeScript, po trzy razy dla każdego modelu; zarówno IQ2_XS, jak i IQ3_XXS zaliczyły wszystkie dziewięć przebiegów. Konfiguracja IQ2 zakończyła te ograniczone zadania szybciej i zużyła mniej pamięci hosta. Zachęca to do sprawdzania zadań programistycznych z testowalnym wynikiem, ale nie dowodzi równej jakości w nieznanym repozytorium. Porównanie programistyczne i dane testowe
Przykład Maca odpowiada na inne pytanie: czy względnie niewielki system z 32 GB w ogóle może brać w tym udział? Tak, przy opublikowanej konfiguracji strumieniowania. Jednak osobny prompt IQ3_XXS o długości około 30 tys. tokenów w dokumentacji Maca wymagał 5,6 minuty do pierwszego wyjścia. Cierpliwie wykonywane zadanie wsadowe i asystent wrażliwy na przerwy mają różne budżety opóźnień. Pomiary strumieniowania na Macu
To właśnie ten wybór warto zapamiętać. Krótkim pytaniem sprawdź interaktywność, długim dokumentem koszt przetwarzania promptu, a zadaniem z weryfikowalnym wynikiem przydatność odpowiedzi. Jedna liczba nie zastąpi wszystkich trzech.
Październikowe poprawki pokazują, dlaczego wersje trzeba zapisywać w konfiguracji
Wydanie z 23 października raportuje wzrost prędkości odpowiedzi o 6–19% na testowym komputerze Windows Strix Halo z IQ3_S, zmierzony w trzech sparowanych przebiegach względem 0.2.2. Dostarcza też pakiet silnika Intel Arc Linux SYCL, testowany na karcie A750. Generowanie wstępne DFlash2 jest dostępne tylko w Terminalu i wymaga włączenia; Auto nadal wybiera MTP, ponieważ alternatywa nie wygrała we wszystkich obciążeniach. Pomiary i ograniczenia 0.2.3
Tym usprawnieniom towarzyszy zwykłe utrzymanie oprogramowania. Tag v0.2.1.2 z 20 października naprawiał uruchamianie Strix Halo w Windows. Przewodnik sprzętowy wyjaśnia wcześniejszy problem: rejestracja obszaru ekspertów wyczerpywała dostępną pamięć GPU, nie pozostawiając miejsc na cache. Obsługiwany układ i instalator nie wystarczały, dopóki nie poprawiono zarządzania pamięcią. v0.2.1.2, wyjaśnienie uruchamiania Strix Halo
Są też aktualne niedociągnięcia. Zgłoszenie #3810, otwarte 23 października, opisuje awarię konfiguracji CUDA w Windows związaną z dołączonymi metadanymi wizji. W chwili zamknięcia badań do artykułu był to oczekujący na rozwiązanie raport użytkownika, a nie dowód awarii każdej instalacji Windows. Jeśli dotyczy Twojej ścieżki instalacji, sprawdź zgłoszenie i kolejne informacje o wydaniach, zanim spędzisz godziny na ponownym strojeniu modelu. Raport konfiguracji Windows
Uwagę warto poświęcić także aktualizacjom: uwagi do 0.2.3 nakazują użytkownikom wersji od 0.2.0-beta do 0.2.1.2 ponownie uruchomić instalator Terminala, ponieważ te wersje nie potrafią samodzielnie przełączać komponentów Control. Instalator zachowuje modele i ustawienia. Na Macu sprawdź, czy pożądany podpisany pakiet faktycznie się pojawił: sekcja znanych ograniczeń tego samego wydania informuje, że w momencie publikacji kompilacje dla Maca były nadal podpisywane. Instrukcje aktualizacji
Zacznij od jednego przydatnego zadania i krótkiego kontekstu
Nie trzeba odtwarzać demonstracji z ogromnym kontekstem, by przekonać się, czy to ma sens. Mała, udana pętla pracy daje punkt odniesienia, wraz z błędami i poprawkami, zanim przeznaczysz więcej dysku lub pozwolisz agentowi działać szerzej.
- Wybierz udokumentowaną ścieżkę dla swojego sprzętu. Otwórz oficjalną stronę wydań i wybierz właściwy system operacyjny oraz pakiet GPU. Osobno zapisz wersję aplikacji i silnika. Zachowaj działającą instalację podczas oceny aktualizacji.
- Dobierz model do wolnej pamięci, języka i zadania. Przed pierwszą próbą zamknij ciężkie aplikacje. Zacznij od zalecanego rozmiaru, kontekstu około 8K i jednego równoczesnego żądania. Pliki modelu trzymaj na lokalnym SSD.
- Skorzystaj z prowadzonej konfiguracji. Graficzny wybór modelu lub
strata launchudostępnia ustawienia modelu, dysku, kontekstu, obrazów i dostępu. Przy pierwszym ćwiczeniu programistycznym zachowaj dostęp wyłącznie lokalny i uprawnienia Manual. Przewodnik po Terminalu - Zapytaj o coś, co możesz sprawdzić. Wypróbuj małą funkcję z testami, trzy pytania o dostarczony dokument lub zrzut ekranu ze znanymi etykietami. Zapisz prompt i porównaj odpowiedź z rzeczywistym źródłem lub wynikiem testu.
- Zmierz całe oczekiwanie. Zanotuj uruchamianie, czas do pierwszego wyjścia, całkowity czas zadania, szczytowe zużycie pamięci i poprawność. Następnie powtórz próbę raz z kolejnym pytaniem korzystającym z cache i raz z nowym promptem. Podczas porównania nie zmieniaj ustawień generowania wstępnego i rozumowania.
- Zwiększaj złożoność po jednej zmiennej. Wydłużaj kontekst tylko wtedy, gdy wymaga tego zadanie. Osobno oceniaj obrazy, inny model i połączenie z klientem programistycznym, aby ewentualna regresja miała konkretną przyczynę do sprawdzenia.
Do udostępniania raportów wydajności Strata zapewnia strata bench run. Jej ustandaryzowany protokół pozostawał 23 października projektem oczekującym na walidację pilotażową i jawnie oddziela ładowanie modelu od mierzonego wnioskowania. Ważny nawyk przydaje się już teraz: dołączaj sprzęt, kwantyzację, rzeczywiste ustawienia i wyniki zadań do pomiaru. Protokół benchmarku
Lokalne wnioskowanie nadal wymaga decyzji na obrzeżach
Dokumentacja prywatności Straty mówi, że nie zbiera telemetrii użytkowania i potrafi uruchamiać pobrane modele offline. Wyszukiwanie w sieci, otwierane strony, zdalne usługi modeli, tunele i skonfigurowane narzędzia tworzą połączenia zewnętrzne, gdy z nich korzystasz. Prywatna rozmowa z modelem wymaga więc także prywatnego otoczenia pracy. Zachowanie sieci i pobierania
To szczególnie istotne w przykładach dotyczących dokumentów i programowania. Asystent mogący czytać pliki i uruchamiać polecenia ma możliwości wykraczające poza generowanie tekstu. Przed przekazaniem poufnych materiałów przejrzyj folder roboczy, dokładne proponowane polecenie i każdy zewnętrzny endpoint narzędzia. Zachowuj oryginały i historię wersji, aby błędną edycję można było cofnąć.
Domyślny nasłuch wnioskowania korzysta z 127.0.0.1; otwarcie nasłuchu sieciowego zmienia krąg osób, które mogą się połączyć. Strata dokumentuje klucze API i osobny nasłuch udostępniania, ale za decyzję nadal odpowiada osoba włączająca dostęp. Zgodne API ułatwia podłączenie klienta, nie zapewnia jednak prywatności każdej możliwej konfiguracji klienta. Polityka bezpieczeństwa
Project Maya pokazuje zasięg pomysłu i jego koszty
Szersza zmiana polega na przenoszeniu tej strategii wykonania na inne rodziny modeli. Project Maya wyraźnie wskazuje Stratę jako punkt wyjścia dla swojego silnika, serwera i panelu, ze znaczną dodatkową pracą pod własne modele. Udokumentowane cele obejmują GLM-5.3-Flash, 321B oraz DeepSeek-V4.1-Flash-1017, 748B. To osobny projekt, a nie opcja w menu modeli Straty. Modele i podziękowania Mayi
Pobranie GLM Maya-S zajmuje 96,5 GB; wariant DeepSeek Maya-S zajmuje 340 GB wraz z tablicami Engram. Przykład społeczności łączy jedną RTX 5090 z Ryzenem 9 7950X i 96 GB RAM, raportując ponad 30 tokenów na sekundę dla GLM Maya-M. Te warunki wyjaśniają, dlaczego „jedna karta GPU” jest niepełnym opisem konfiguracji konsumenckiej. Pliki Mayi i raporty sprzętowe
Możliwość jest realna: komputer może łączyć kilka poziomów przechowywania i obliczeń, by obsługiwać model, którego pełne wagi przekraczają pamięć akceleratora. Rosną też koszty. Setki gigabajtów pobranych plików, kernele dopasowane do modeli, zapas RAM i eksperymentalna obsługa platform wymagają istotnego zaangażowania. Udany port dużego modelu nie oznacza uniwersalnego loadera dla każdej architektury.
Dla większości czytelników Maya to na razie kierunek do obserwowania, zanim stanie się polecanym zamiennikiem. Przydatne pytanie brzmi: czy inny model rozwiązuje zadanie, z którym obecny sobie nie radzi, dając korzyść uzasadniającą dodatkowy sprzęt i utrzymanie? Sama liczba parametrów nie odpowie na to pytanie.
Następnym krokiem jest niezawodna praca, a publiczne propozycje prowadzą w tę stronę
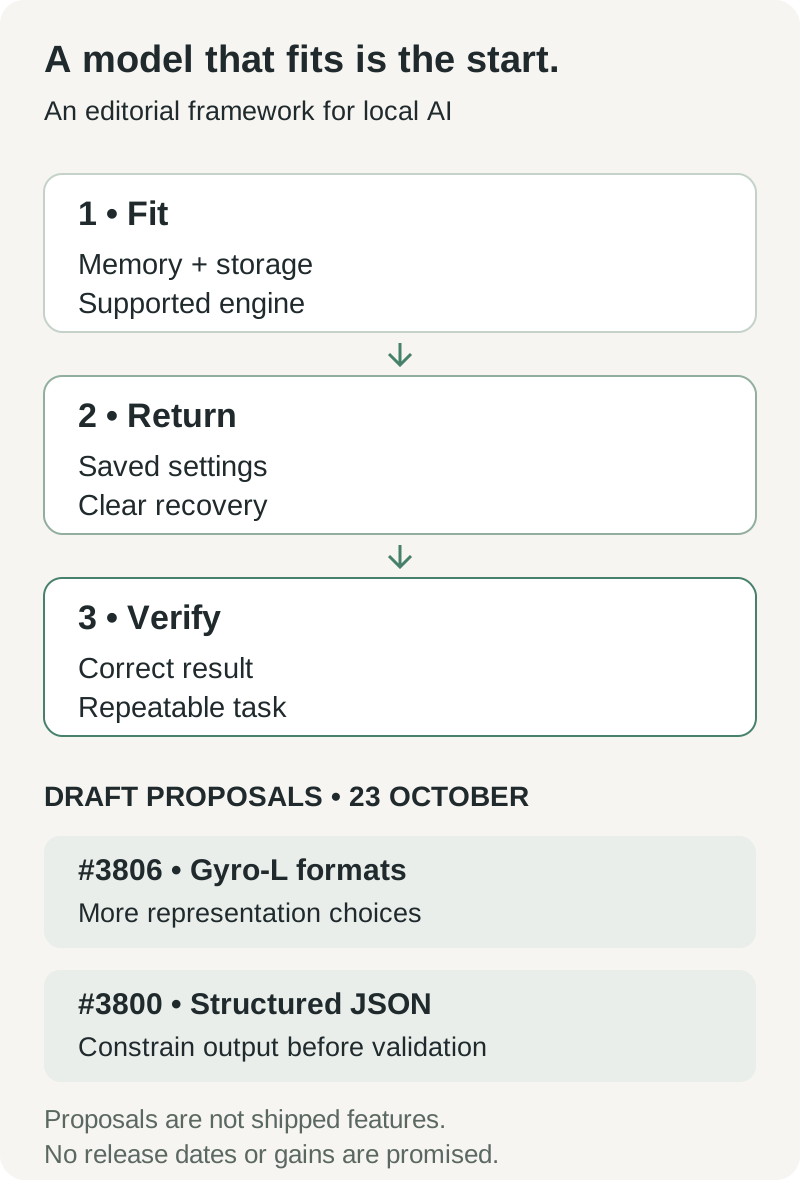
Autorski schemat redakcyjny. Górna sekwencja opisuje kryteria przyjęcia narzędzia; dolny wiersz wskazuje publiczne propozycje sprawdzone 23 października. To nie obiecany harmonogram wydań ani prognoza wydajności.
Dwa otwarte szkicowe pull requesty dają konkretniejsze sygnały niż wyobrażona mapa drogowa 2.0. #3806 proponuje obsługę obecnie nieobsługiwanych formatów trellis Gyro-L. #3800 proponuje maskowanie tokenów dla strukturalnych wyników JSON, aby nieprawidłowe generacje wymagały mniejszej liczby ponowień całego żądania. Oba były szkicami 23 października; żaden nie należy do listy już dostarczonych możliwości. Propozycja Gyro-L, propozycja wyjścia strukturalnego
Jeśli takie prace trafią do niezawodnego wydania, skorzystają dwa rodzaje lokalnych obciążeń. Lepsza obsługa formatów da więcej sposobów wymiany pamięci na jakość. Pewniejsze wyjście strukturalne pomoże ekstrakcji dokumentów, etykietowaniu i wywołaniom narzędzi wytwarzać dane, które inny program może bezpiecznie zweryfikować. Drugie usprawnienie jest mniej widowiskowe na filmie, ale potencjalnie cenniejsze w powtarzalnej pracy.
Nasze oczekiwanie jest warunkowe: osobiste wnioskowanie staje się przydatniejsze, gdy silniki zachowują działające konfiguracje, ograniczają zużycie pamięci i odzyskują sprawność po awarii. Więcej portów backendu i sprytniejsze generowanie wstępne pomaga dopiero wtedy, gdy czytelnik potrafi połączyć je z realnym zadaniem. Model na komputerze zasługuje na swoje miejsce, wykonując pracę, którą można sprawdzić i powtórzyć.
Pytanie o kolejny komputer do lokalnej AI jest więc proste: czy jutro można powierzyć mu to samo przydatne zadanie i ufać procesowi na tyle, by korzystać z niego dalej?
Źródła i uwagi do lektury
Stan badań na 23 października 2026 r. Status wydań, zgłoszeń i dostępnych pakietów może zmienić się po tej dacie. Powyższe pomiary zachowują pierwotne daty publikacji i konfiguracje; na potrzeby artykułu nie przeprowadzono nowego benchmarku wnioskowania.
- Strata 0.2.0-beta, v0.2.1.2 oraz informacje o wydaniu 0.2.3.
- Przewodnik po modelach Straty, obsługa Qwen3.6 oraz dokumentacja Gyro.
- Zbiór benchmarków społeczności, dokumentacja Maca oraz projekt protokołu benchmarku.
- Project Maya, oficjalny zrzut Straty oraz licencja repozytorium.
Zachowuj decyzje o lokalnej AI razem z dowodami
Porównując konfiguracje, trzymaj razem linki do źródeł, ustawienia sprzętu, wyniki zadań i poprawki. Telli.sh może pomóc uporządkować te notatki badawcze i podsumowania w miarę rozwoju Twojej konfiguracji. Utwórz konto Telli.sh