[Appunti sull’IA locale 01] La prossima prova di Strata: rendere utile un grande modello sul tuo PC
La beta 0.2 di Strata è diventata un’app desktop. Tre esempi pubblicati su hardware consumer mostrano cosa funziona, quanta memoria serve e dove va l’IA locale.
La dimostrazione di IA locale più interessante è quella che puoi ancora usare la settimana dopo. Un grande modello che produce una risposta brillante su un PC da gioco è un traguardo; riaprire la stessa conversazione domani, ritrovare i file del modello e lasciargli modificare un progetto in sicurezza sono i primi passi verso uno strumento utile.
Strata si è avvicinato a questa seconda categoria con 0.2.0-beta, il 19 ottobre 2026: un’app desktop, un’interfaccia Terminal e motori distribuiti in pacchetti separati. Il 23 ottobre era già arrivata 0.2.3. Il nome effettivo della beta conta quando scegli cosa scaricare: si tratta della linea 0.2, non dell’annuncio di una futura 2.0. Versione beta, versione del 23 ottobre
Questa prima puntata di Appunti sull’IA locale esamina cosa offre questo cambiamento a chi possiede già un computer. Collegheremo la nuova interfaccia a tre esempi di hardware pubblicati, distingueremo le varianti dei modelli dalle diverse architetture ed esamineremo gli sviluppi che potrebbero rendere l’inferenza locale un servizio quotidiano affidabile.
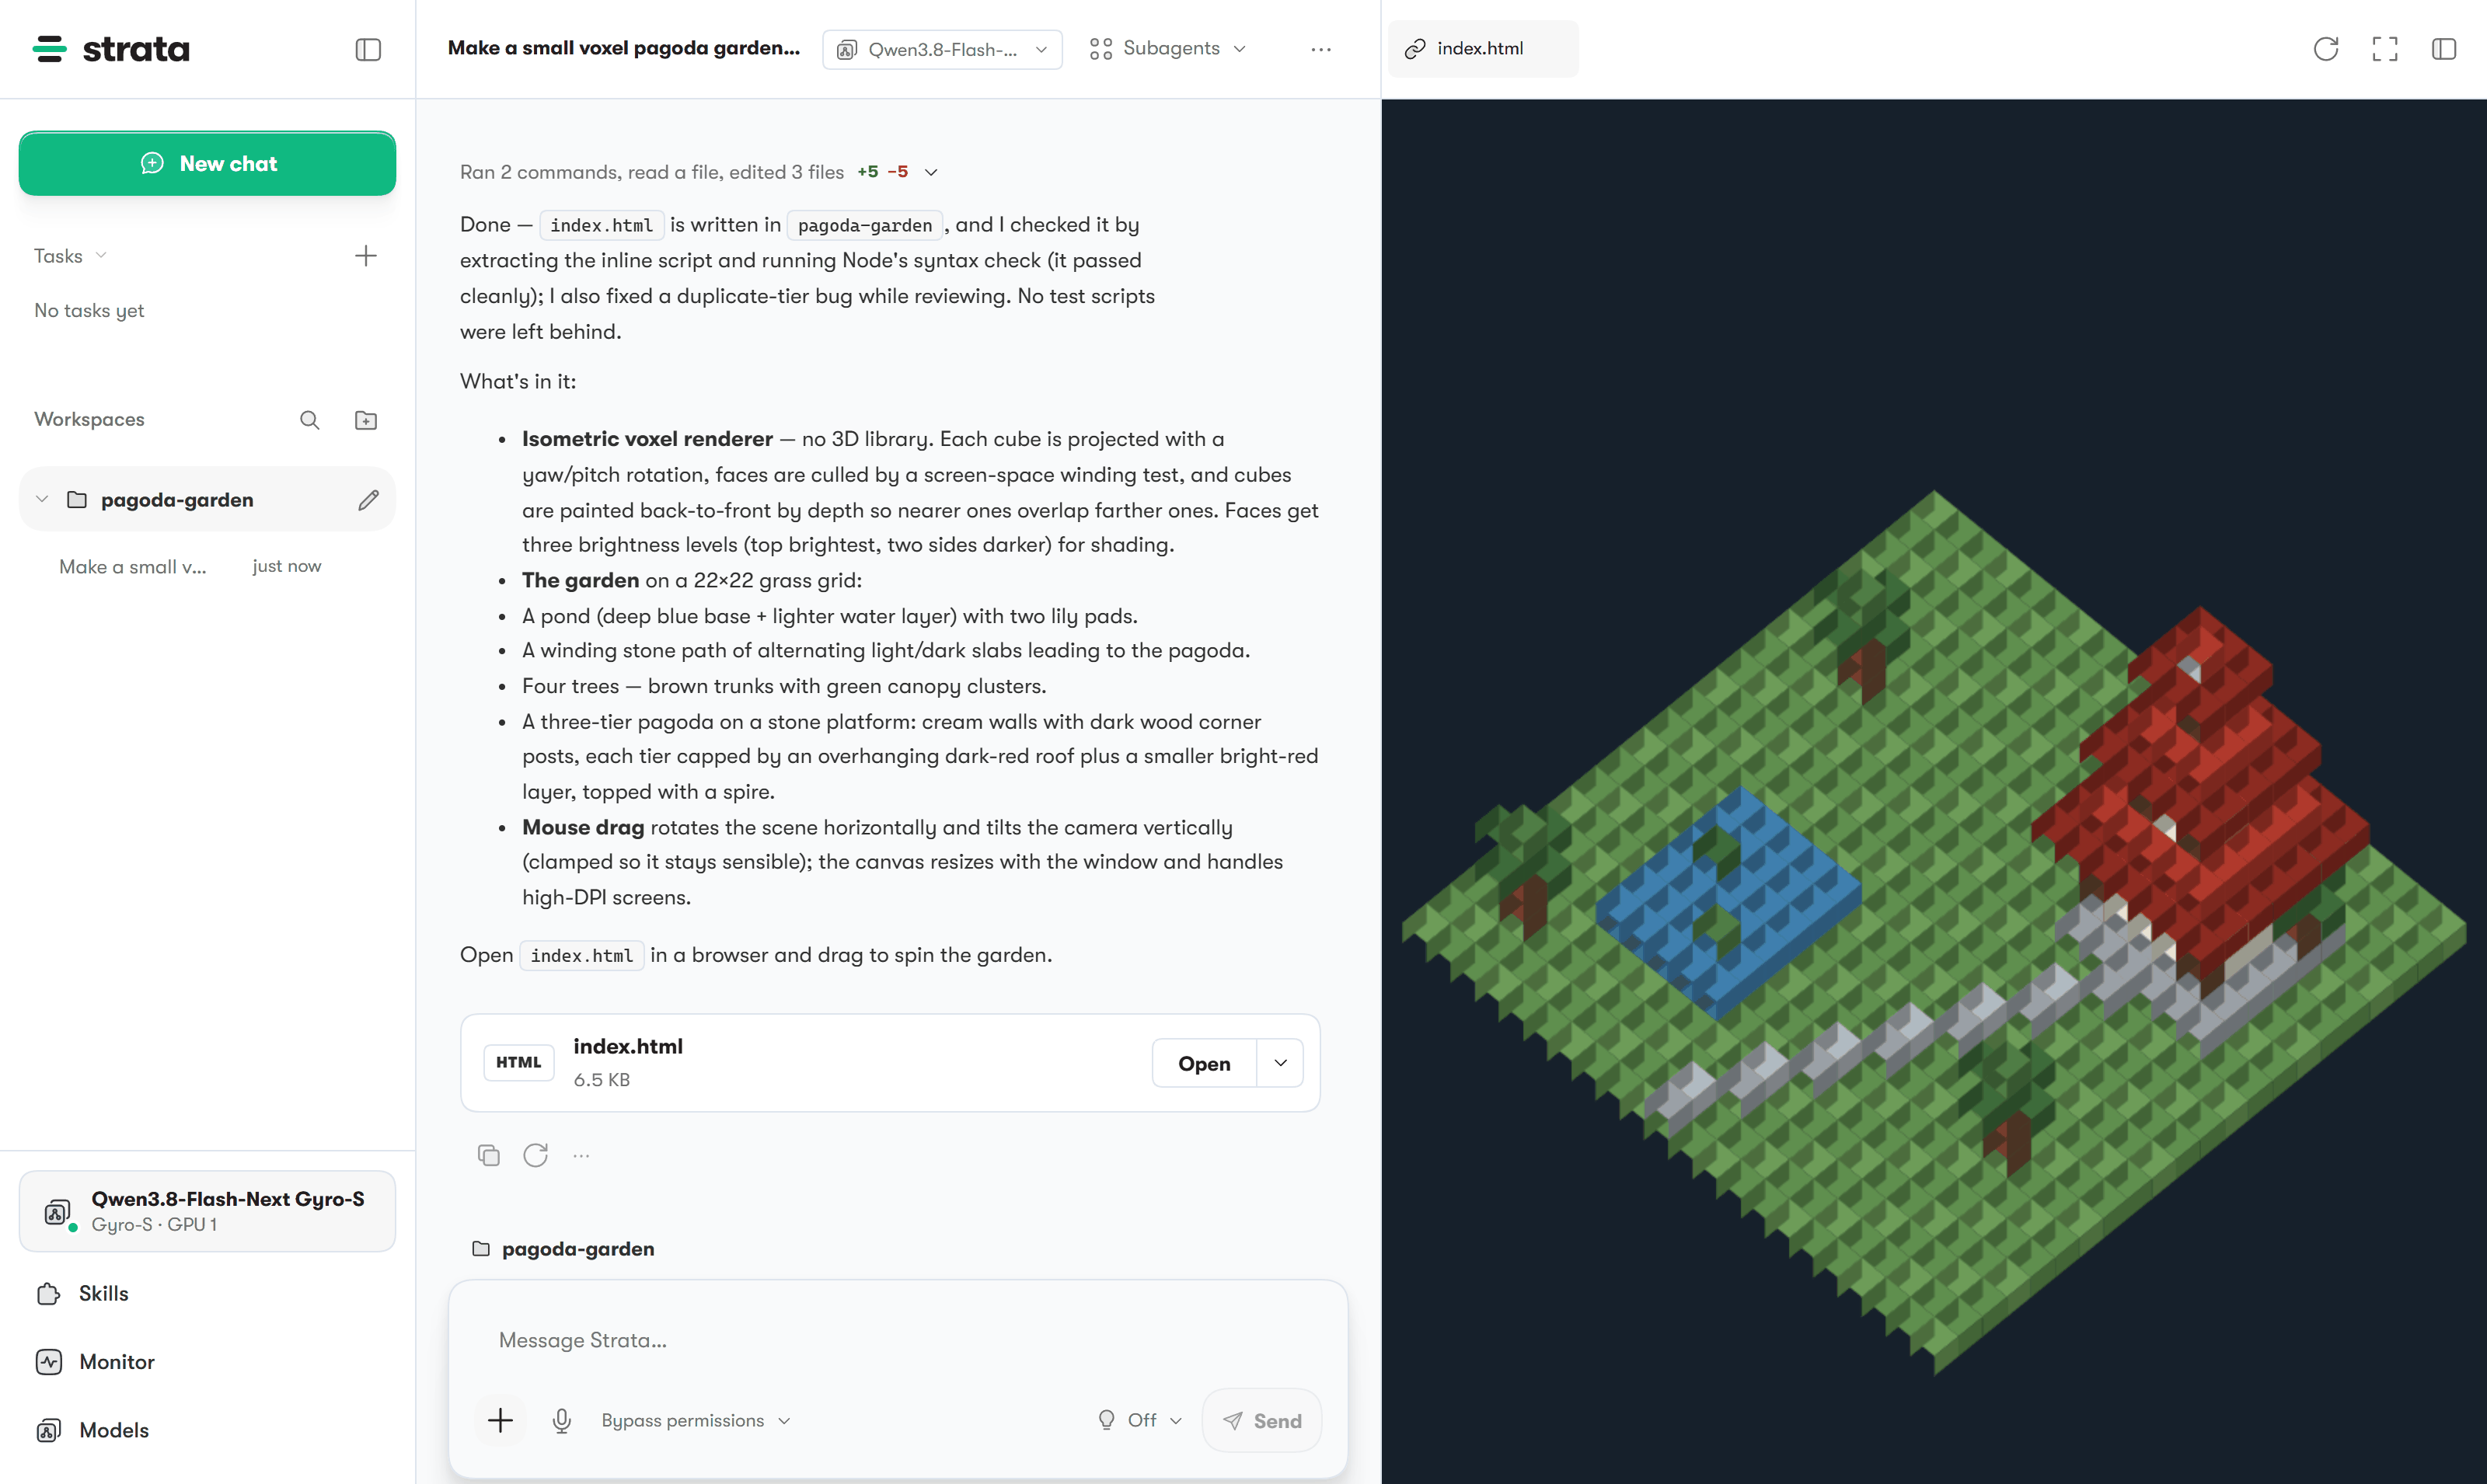
Schermata ufficiale di Strata dal repository 0.2.3, con una conversazione di programmazione e un’anteprima HTML. Illustra l’interfaccia, non una prova eseguita per questo articolo. © 2026 Niko1221 e i collaboratori di Strata; fonte, licenza MIT.

La beta ha trasformato il motore in qualcosa a cui puoi tornare
L’app desktop riunisce selezione dei modelli, gestione dello spazio, chat, monitoraggio hardware e un ambiente di lavoro per il codice. La modalità di autorizzazione Manual chiede conferma prima delle modifiche; la modalità Bypass, più permissiva, concede maggiore libertà all’agente. Terminal offre una procedura guidata strata launch e collegamenti ai client di programmazione. Entrambi condividono il motore sottostante. Funzioni di 0.2.0-beta
Per uno sviluppatore, questo suggerisce un esempio d’uso semplice: chiedere un piccolo parser in un progetto di prova, esaminare i file proposti, eseguire i test e proseguire la conversazione con un esempio che fallisce. Per chi lavora soprattutto con documenti, un primo compito analogo consiste in una domanda circoscritta su un brano fornito, seguita dalla richiesta della citazione esatta che sostiene la risposta. Nessuno dei due scenari richiede di trasformare il modello in un dipendente autonomo.
Il miglioramento pratico è la continuità. Un selettore grafico riduce il rischio di avviare una configurazione incompatibile; un monitor hardware aiuta a capire perché un’altra applicazione modifica le prestazioni; un preset salvato rende ripetibile un esperimento riuscito. Queste funzioni non aumentano la capacità di ragionamento del modello. Riducono il lavoro necessario per passare dalla disponibilità di quella capacità al suo uso responsabile.
La nostra lettura è questa: la prossima competizione nell’IA locale riguarda proprio tale distanza. L’esperienza migliore renderà facile conservare una buona configurazione, capire un errore e controllare un’azione rischiosa.
L’intero sistema di memoria del computer diventa parte del modello
L’obiettivo principale di Strata è Qwen3.8-Flash-Next, il cui nucleo conta 125 miliardi di parametri. La strategia di esecuzione usa la memoria GPU per i calcoli comuni e gli esperti più richiesti, la RAM di sistema e la CPU per gli altri esperti, e l’SSD per la tabella di ricerca degli n-grammi. Una scheda grafica più capiente aiuta, ma RAM e archiviazione rimangono parte del percorso di inferenza. Panoramica del progetto, progettazione dell’esecuzione
Pensa al PC come a un laboratorio con diversi banchi di lavoro. Quello più veloce ha spazio limitato, quindi il runtime deve decidere quali attività meritano di restarci. Migliorare questa decisione può rendere più utile l’hardware esistente; non può rendere tutti i banchi ugualmente veloci.
Tre quantità meritano attenzione distinta. Il download occupa spazio di archiviazione. I pesi caricati e i buffer del runtime consumano memoria. La finestra di contesto aggiunge stato di lavoro man mano che la conversazione cresce. La sola dimensione di un file, quindi, non indica né quanta VRAM serva né quanto rapidamente arriverà la prima risposta.
Le indicazioni iniziali attuali del progetto richiedono almeno 32 GB complessivi tra RAM e VRAM, con circa 80 GB di spazio libero su disco per la configurazione abituale. Sono requisiti di partenza, non la promessa che ogni modello, lunghezza del contesto o sistema operativo rientri in quei limiti. Un portatile essenziale con 16 GB non va considerato equivalente ai desktop qui sotto. Requisiti hardware
Più nomi di modelli non significano sempre più architetture
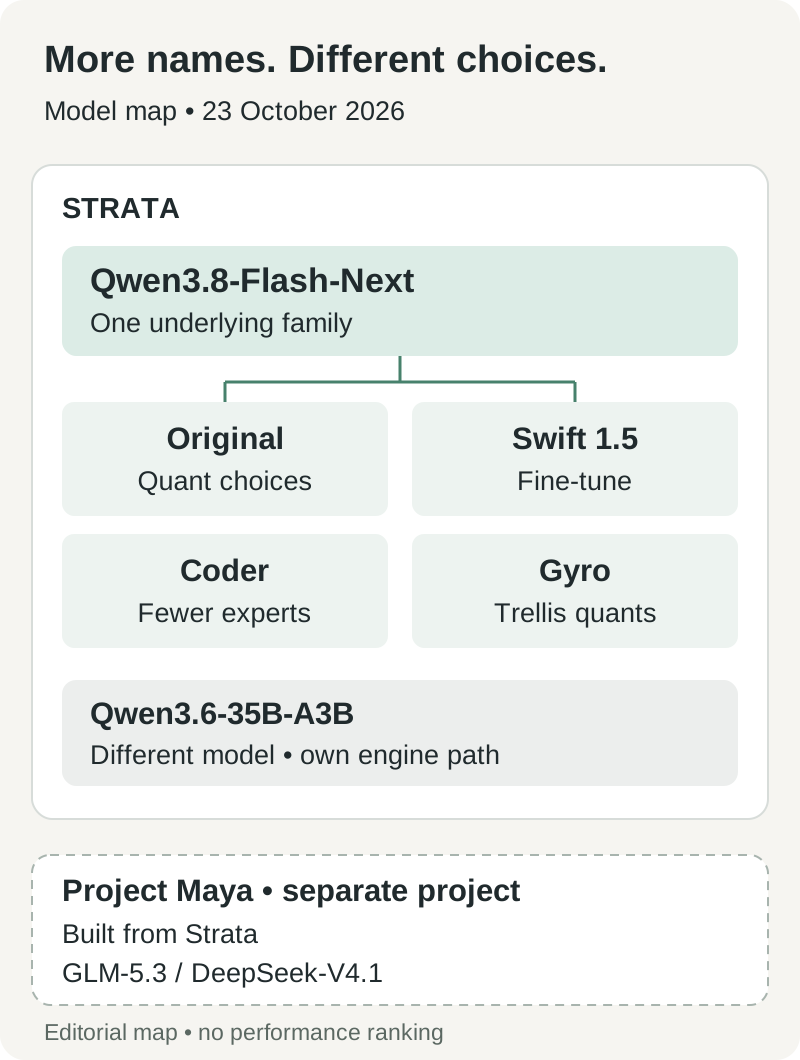
Mappa editoriale originale delle relazioni documentate tra i modelli, verificata il 23 ottobre. I rami indicano derivazione e supporto del runtime, non qualità equivalente o file intercambiabili.
Flash-Next originale, Swift 1.5, Coder e Gyro rispondono a esigenze diverse all’interno della stessa famiglia. Swift modifica il comportamento mediante fine-tuning. Coder rimuove esperti selezionati come meno utili per la sua specializzazione nel codice. Gyro cambia la rappresentazione dei pesi. Trattare questi nomi come quattro modelli di base indipendenti fa sembrare il catalogo più ampio di quanto sia. Guida ai modelli
Queste differenze hanno conseguenze. Coder conserva 256 dei 512 esperti di ogni strato e il progetto avverte di prestazioni inferiori nelle attività generali e nelle lingue diverse dall’inglese. Un modello scelto perché entra in un desktop da programmazione non dovrebbe diventare automaticamente quello predefinito per domande su documenti multilingue. Il ragionamento più breve di Swift può ridurre il tempo complessivo senza accelerare la generazione di ogni singolo token. Compromessi tra versioni
Gyro-S richiede un download di 58,5 GB, sebbene il requisito documentato di memoria per i pesi, tra RAM e VRAM, sia di 27,6 GB. La tabella degli n-grammi rimane sull’SSD. La valutazione del progetto colloca la sua qualità sotto quella delle varianti più grandi a bassa precisione; occupare meno memoria ha un prezzo. Documentazione di Gyro
C’è anche un secondo modello effettivo: Qwen3.6-35B-A3B, un modello mixture-of-experts da 35 miliardi di parametri, con 3 miliardi attivi, gestito da un percorso motore separato. Le opzioni documentate comprendono immagini e richieste simultanee sulle configurazioni NVIDIA e AMD supportate; il motore Mac non lo esegue. Questa distinzione lo rende un’alternativa utile da valutare quando il numero di parametri più appariscente non è il vero requisito. Supporto Qwen3.6
Tre macchine documentate mostrano tre forme diverse di utilità
Gli esempi seguenti sono stati pubblicati da collaboratori della community o dal progetto stesso. Sono misurazioni di configurazioni specifiche, non prove pratiche eseguite per questo articolo. Servono a mostrare attività plausibili e i loro costi, non a classificare tre computer con prompt incompatibili.
| Esempio pubblicato | Modello e condizioni del contesto | Risultato riportato | Quale decisione aiuta a prendere |
|---|---|---|---|
| Community, 9 ottobre: RTX 3060 12 GB, Core i7-12700, 64 GB DDR4-3200, NVMe, Windows 11 | Strata 0.1.41; Q2_0 originale; finestra di 131.072 token; nuovo prompt di 4.096 token, 256 token in uscita; ragionamento e visione disattivati; tre esecuzioni | Mediana di 42,9 token in uscita/s; 4,7 secondi al primo token; 10,6 secondi totali | Una vecchia scheda da 12 GB può sostenere brevi attività interattive se abbinata a molta RAM di sistema |
| Community, 9–10 ottobre: RX 9060 XT 16 GB, Ryzen 7 9800X3D, 64 GB DDR5-6000, Windows 11 | Motore 0.1.40.3; IQ2_XS; finestra di 122.880 token; prefill 8.192; nuovo input di 8.019 token, ragionamento basso; tre esecuzioni | Mediana di 879,4 token del prompt/s, 56,3 token in uscita/s, 11,212 secondi totali | Per input della lunghezza di un documento, la configurazione del prompt può contare quanto una scheda più veloce |
| Misurazione del progetto, documentata entro il 23 ottobre: Mac mini M4, 32 GB di memoria unificata | Gyro-S; streaming degli esperti dall’SSD; area esperti da 11–12 GB; nessuno strato di bozza; racconto di 120 token; finestra totale non specificata | Mediana di 9,14 token in uscita/s su cinque coppie alternate; un prompt separato di 4.065 token letto a 109 token/s | Una macchina compatta può eseguire un grande modello, accettando tempi di attesa maggiori |
Fonti: rapporto RTX 3060, rapporto RX 9060 XT, misurazioni Mac. Questi rapporti precedono la versione attuale dell’app o usano condizioni diverse.
L’esempio della RTX 3060 è utile perché include l’attesa prima dell’output. Un’interfaccia che mostra circa 43 token al secondo può comunque fermarsi mentre legge la domanda. Il rapporto registra anche rallentamenti termici e attività in background non controllate; il suo valore sta nel delimitare realisticamente una macchina, anziché descrivere specifiche GPU idealizzate.
Per l’utente Radeon esistono prove di un flusso di lavoro concreto oltre al semplice ciclo di velocità. Il collaboratore ha eseguito tre attività sintetiche TypeScript tre volte per modello tramite un client di programmazione: sia IQ2_XS sia IQ3_XXS hanno superato tutte e nove le esecuzioni. La configurazione IQ2 ha terminato più rapidamente quei compiti circoscritti, consumando meno memoria del sistema. Questo giustifica la prova di attività di programmazione verificabili; non dimostra qualità equivalente su un repository sconosciuto. Confronto di programmazione e casi di prova
L’esempio Mac risponde a una domanda diversa: un sistema relativamente compatto da 32 GB può partecipare? Sì, con la configurazione di streaming pubblicata. Ma un altro prompt IQ3_XXS da circa 30.000 token nella documentazione Mac ha richiesto 5,6 minuti prima del primo output. Un’attività batch senza urgenza e un assistente sensibile alle interruzioni hanno esigenze di latenza diverse. Misurazioni dello streaming Mac
È questa la scelta da tenere a mente. Usa una domanda breve per scoprire il comportamento interattivo, un documento lungo per capire il costo del prompt e un compito verificato per capire se le risposte sono utili. Nessun singolo numero rappresenta tutte e tre le cose.
Le correzioni di ottobre mostrano perché annotare i numeri di versione
La versione del 23 ottobre riporta un miglioramento del 6–19% nella velocità delle risposte sulla macchina di prova Windows Strix Halo con IQ3_S, misurato in tre esecuzioni appaiate rispetto alla 0.2.2. Include anche un pacchetto motore Intel Arc Linux SYCL, con A750 come scheda testata. La generazione di bozze DFlash2 è disponibile solo in Terminal e va attivata esplicitamente; Auto continua a scegliere MTP perché l’alternativa non ha prevalso su tutti i carichi di lavoro. Misurazioni e limiti di 0.2.3
Questi miglioramenti si affiancano alla normale manutenzione software. Il tag v0.2.1.2 del 20 ottobre ha corretto l’avvio su Strix Halo Windows. La guida hardware spiega il problema precedente: la registrazione dell’area degli esperti esauriva la memoria GPU disponibile, senza lasciare slot per la cache. Un chip supportato e un programma d’installazione non bastavano finché non è stata corretta la gestione della memoria. v0.2.1.2, spiegazione dell’avvio Strix Halo
Restano anche problemi aperti. La issue #3810, aperta il 23 ottobre, segnala un arresto durante la configurazione CUDA su Windows che coinvolge i metadati di visione inclusi nel pacchetto. Alla data limite della ricerca è una segnalazione utente in attesa di soluzione, non la prova che ogni installazione Windows fallisca. Se il tuo caso coincide, controlla la issue e le note delle versioni successive prima di passare ore a riconfigurare un modello. Segnalazione sull’installazione Windows
Anche gli aggiornamenti richiedono attenzione: le note di 0.2.3 indicano agli utenti da 0.2.0-beta a 0.2.1.2 di rieseguire il programma d’installazione Terminal, perché quelle versioni non possono cambiare autonomamente i componenti Control. Il programma conserva modelli e impostazioni. Su Mac, verifica che l’artefatto firmato desiderato sia effettivamente disponibile: la sezione dei limiti noti della stessa versione indicava che le build Mac erano ancora in fase di firma al momento della pubblicazione. Istruzioni di aggiornamento
Parti da un compito utile e da un contesto breve
Non serve riprodurre una dimostrazione con un contesto enorme per capire se ne vale la pena. Un piccolo ciclo riuscito offre un riferimento, inclusi errori e correzioni, prima di impegnare altro spazio o lasciare ampia libertà a un agente.
- Scegli il percorso documentato per il tuo hardware. Apri la pagina ufficiale delle versioni e seleziona il pacchetto adatto a sistema operativo e GPU. Annota separatamente le versioni dell’app e del motore. Conserva un’installazione già funzionante mentre valuti l’aggiornamento.
- Scegli il modello in base a memoria libera, lingua e compito. Chiudi le applicazioni pesanti per il primo tentativo. Parti dalla dimensione consigliata, da circa 8K di contesto e da una richiesta alla volta. Tieni i file del modello su un SSD locale.
- Usa la configurazione guidata. Il selettore dell’app desktop o
strata launchpresenta le impostazioni di modello, archiviazione, contesto, immagini e accesso. Per il primo esercizio di programmazione mantieni l’accesso solo locale e le autorizzazioni Manual. Guida Terminal - Chiedi qualcosa che puoi verificare. Prova una piccola funzione con test, tre domande su un documento fornito o una schermata con etichette note. Salva il prompt e confronta la risposta con la fonte effettiva o con l’output dei test.
- Misura l’intera attesa. Registra avvio, tempo al primo output, durata complessiva, picco di memoria e correttezza. Ripeti poi una volta con un seguito che sfrutta la cache e una volta con un nuovo prompt. Mantieni invariate le impostazioni di generazione delle bozze e ragionamento durante il confronto.
- Aggiungi complessità una variabile alla volta. Aumenta il contesto solo quando serve. Valuta separatamente immagini, un altro modello o il collegamento a un client di programmazione, così un peggioramento avrà una causa concreta da cercare.
Per rapporti sulle prestazioni condivisibili, Strata offre strata bench run. Il 23 ottobre il suo protocollo standardizzato era ancora una bozza in attesa della validazione pilota e separava esplicitamente il caricamento del modello dall’inferenza cronometrata. L’abitudine importante è già utile: accompagna il risultato con hardware, quantizzazione, impostazioni effettive ed esiti dei compiti. Protocollo di benchmark
Mantenere locale l’inferenza lascia comunque decisioni ai margini
La documentazione sulla privacy di Strata dichiara l’assenza di telemetria d’uso e la possibilità di eseguire offline i modelli scaricati. Ricerche web, pagine aperte, servizi di modelli remoti, tunnel e strumenti configurati creano connessioni esterne quando vengono usati. Una conversazione privata con il modello richiede quindi anche un flusso di lavoro circostante privato. Comportamento di rete e download
Questo riguarda soprattutto gli esempi con documenti e codice. Un assistente che può leggere file ed eseguire comandi ha capacità che vanno oltre la generazione di testo. Controlla la cartella di lavoro, il comando esatto proposto e gli eventuali endpoint di strumenti esterni prima di fornire materiale riservato. Conserva originali e cronologia delle versioni affinché una modifica sbagliata resti recuperabile.
Il listener di inferenza predefinito usa 127.0.0.1; aprirne uno di rete cambia chi può raggiungerlo. Strata documenta le chiavi API e il listener separato per la condivisione, ma la decisione resta di chi abilita l’accesso. Un’API compatibile rende comodo collegare un client, senza rendere privata ogni possibile configurazione di quel client. Politica di sicurezza
Project Maya mostra fin dove arriva l’idea e quanto costa
Lo sviluppo più ampio è l’adattamento della strategia di runtime ad altre famiglie di modelli. Project Maya cita esplicitamente Strata come punto di partenza per motore, server e dashboard, con un lavoro sostanziale per i propri modelli. Tra gli obiettivi documentati figurano GLM-5.3-Flash, 321B, e DeepSeek-V4.1-Flash-1017, 748B. È un progetto distinto, non un’opzione nel menu dei modelli di Strata. Modelli e riconoscimenti di Maya
Il download GLM Maya-S pesa 96,5 GB; l’opzione DeepSeek Maya-S occupa 340 GB incluse le tabelle Engram. Un esempio della community abbina una RTX 5090 a un Ryzen 9 7950X e 96 GB di RAM, riportando oltre 30 token al secondo per GLM Maya-M. Queste condizioni spiegano perché «una sola GPU» sia una descrizione incompleta di una configurazione consumer. File Maya e rapporti hardware
L’opportunità è concreta: una macchina può combinare diversi livelli di archiviazione e calcolo per servire un modello i cui pesi completi superano la memoria dell’acceleratore. Crescono anche i costi. Centinaia di gigabyte di download, kernel specifici del modello, RAM libera e supporto sperimentale delle piattaforme rappresentano impegni significativi. Il porting riuscito di un grande modello non dimostra l’esistenza di un caricatore universale per ogni architettura.
Per la maggior parte dei lettori, Maya è uno sviluppo da seguire prima di essere una sostituzione da consigliare. La domanda utile è se un modello diverso risolva un compito in cui quello attuale fallisce, con vantaggi sufficienti a giustificare hardware e manutenzione aggiuntivi. Il solo numero di parametri non può rispondere.
Il prossimo traguardo è il lavoro affidabile, e le proposte pubbliche indicano quella direzione
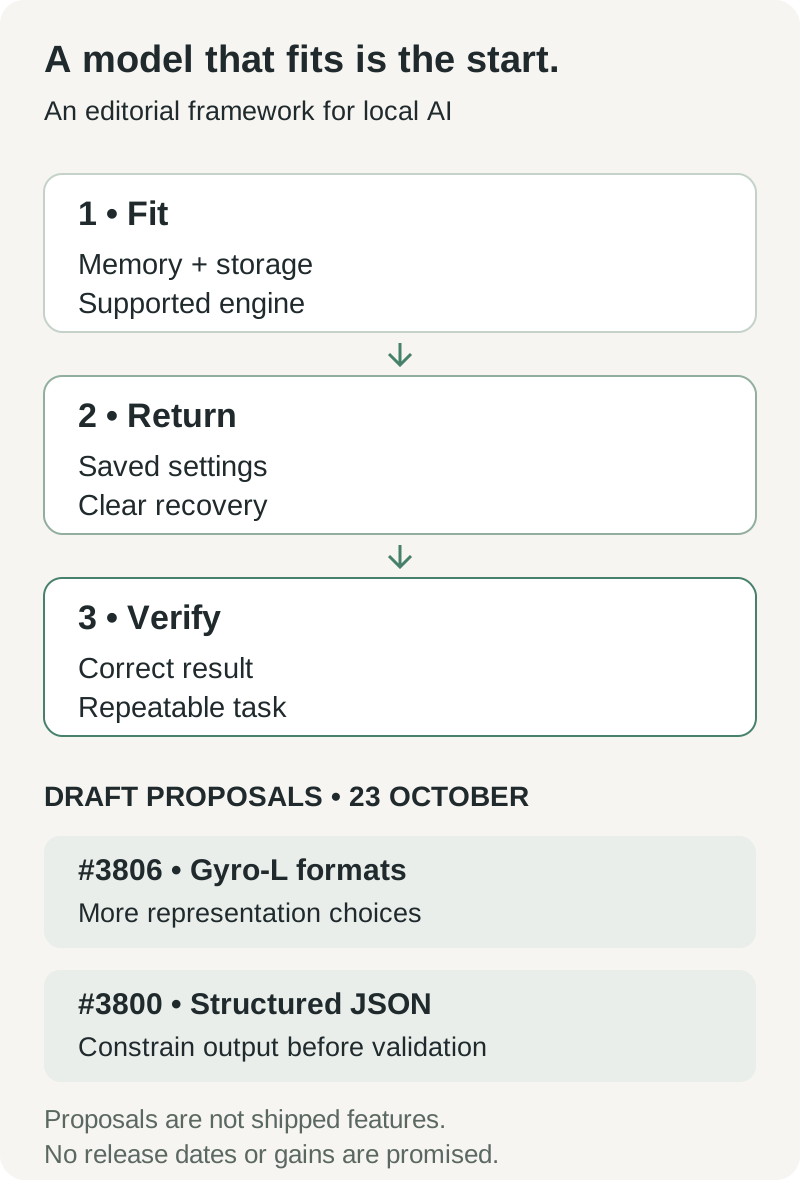
Schema editoriale originale. La sequenza superiore descrive criteri di adozione; la riga inferiore identifica proposte pubbliche verificate il 23 ottobre. Non è una tabella di marcia promessa né una previsione delle prestazioni.
Due pull request aperte in bozza offrono segnali più concreti di un’immaginaria roadmap 2.0. La #3806 propone il supporto ai formati trellis di Gyro-L, attualmente non supportati. La #3800 propone il mascheramento dei token per output JSON strutturati, affinché le generazioni non valide richiedano meno ripetizioni dell’intera richiesta. Entrambe erano bozze il 23 ottobre; nessuna appartiene all’elenco delle funzioni già distribuite. Proposta Gyro-L, proposta per output strutturati
Se interventi di questo tipo raggiungeranno una versione affidabile, ne beneficeranno due tipi di attività locali. Un migliore supporto dei formati offre più modi per bilanciare memoria e qualità. Un output strutturato più affidabile aiuta estrazione dai documenti, etichettatura e chiamate agli strumenti a produrre dati che un altro programma può validare in sicurezza. Il secondo miglioramento è meno spettacolare in video, ma potenzialmente più prezioso in un flusso ripetuto.
La nostra aspettativa è condizionata: l’inferenza personale diventa più utile quando i runtime conservano le configurazioni funzionanti, limitano l’uso della memoria e recuperano dagli errori. Più porting dei backend e una generazione di bozze più ingegnosa aiutano solo quando si possono collegare a un compito reale. Un modello desktop si guadagna il suo posto producendo lavoro verificabile e ripetibile.
La domanda per il prossimo computer con IA locale è quindi semplice: puoi affidargli domani lo stesso compito utile e fidarti abbastanza del processo da continuare a usarlo?
Fonti e note di lettura
Data limite della ricerca: 23 ottobre 2026. Lo stato di versioni e issue e gli artefatti disponibili possono cambiare dopo tale data. Le misurazioni sopra mantengono date di pubblicazione e configurazioni originali; per questo articolo non è stato eseguito alcun nuovo benchmark di inferenza.
- Strata 0.2.0-beta, v0.2.1.2 e note di rilascio 0.2.3.
- Guida ai modelli Strata, supporto Qwen3.6 e documentazione Gyro.
- Raccolta dei benchmark della community, documentazione Mac e bozza del protocollo di benchmark.
- Project Maya, schermata ufficiale di Strata e licenza del repository.
Conserva le decisioni sull’IA locale insieme alle prove
Quando confronti le configurazioni, tieni insieme link alle fonti, impostazioni hardware, risultati dei compiti e correzioni. Telli.sh può aiutarti a organizzare appunti di ricerca e riepiloghi mentre la configurazione evolve. Crea un account Telli.sh