[Carnet de terrain de l’IA locale 01] Le prochain défi de Strata : rendre un grand modèle utile sur votre PC
La bêta 0.2 de Strata est devenue une application de bureau. Trois exemples publiés sur du matériel grand public montrent les usages possibles, leur coût en mémoire et la suite pour l’IA locale.
La démonstration d’IA locale la plus intéressante est celle que l’on peut encore utiliser la semaine suivante. Un grand modèle qui produit une réponse ingénieuse sur un PC de jeu marque une étape ; rouvrir la même conversation le lendemain, retrouver les fichiers du modèle et lui laisser modifier un projet en toute sécurité, voilà le début d’un outil utile.
Strata s’est rapproché de cette deuxième catégorie avec 0.2.0-beta, le 19 octobre 2026 : une application de bureau, une interface Terminal et des moteurs distribués séparément. Au 23 octobre, 0.2.3 était déjà arrivé. Le nom exact de la bêta compte au moment de choisir les téléchargements : il s’agit de la branche 0.2, et non d’une future version 2.0 annoncée. Version bêta, version du 23 octobre
Ce premier volet de notre Carnet de terrain de l’IA locale examine ce que ce changement apporte à quelqu’un qui possède déjà un ordinateur. Nous relierons la nouvelle interface à trois exemples de matériel publiés, distinguerons les variantes de modèles des architectures différentes et examinerons les évolutions susceptibles de faire de l’inférence locale un service quotidien fiable.
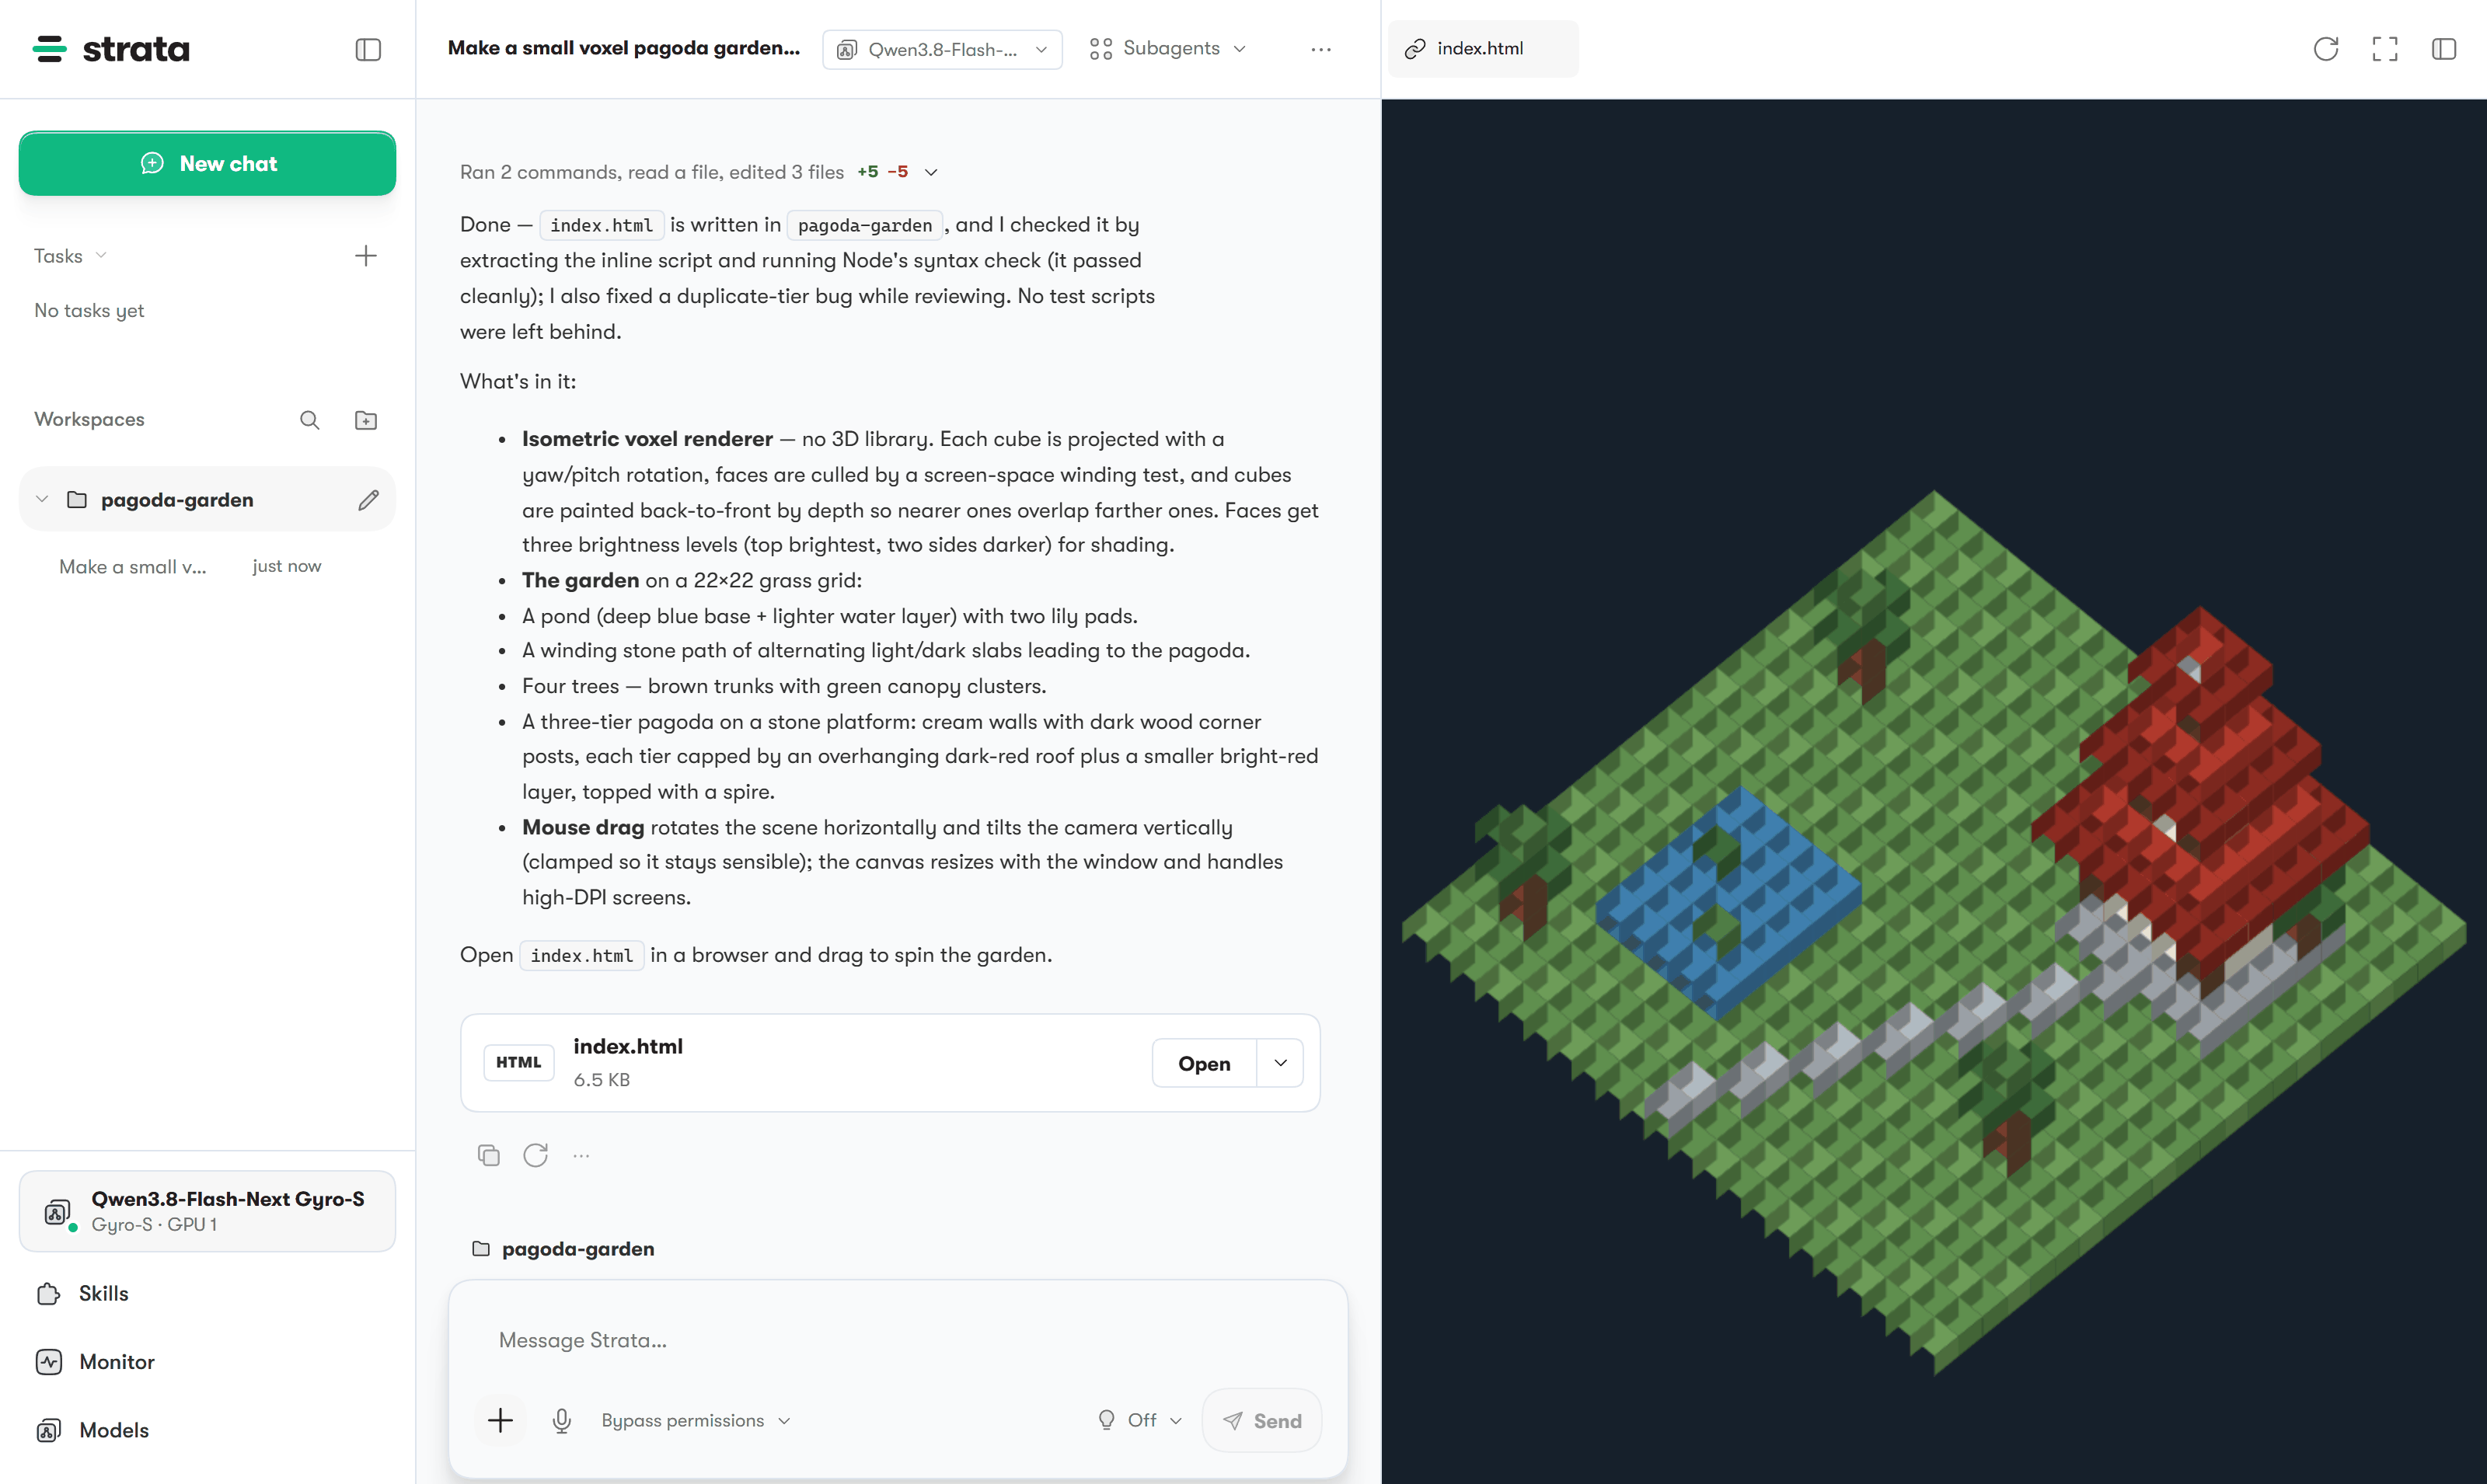
Capture officielle de Strata issue du dépôt 0.2.3, montrant une conversation de programmation et un aperçu HTML. Elle illustre l’interface et ne provient pas d’un test réalisé pour cet article. © 2026 Niko1221 et les contributeurs de Strata ; source, licence MIT.

La bêta a fait du moteur un outil que l’on peut retrouver
L’application de bureau réunit sélection du modèle, gestion du stockage, conversation, surveillance du matériel et espace de programmation. Son mode d’autorisation Manual demande confirmation avant les modifications ; le mode Bypass, plus permissif, accorde davantage de liberté à l’agent. Le Terminal propose un parcours guidé avec strata launch et des connexions à des clients de programmation. Les deux partagent le même moteur sous-jacent. Fonctionnalités de 0.2.0-beta
Pour un développeur, cela donne un exemple d’usage simple : demander un petit analyseur dans un projet jetable, examiner les fichiers proposés, exécuter les tests, puis poursuivre la conversation avec un cas qui échoue. Pour quelqu’un qui travaille beaucoup sur des documents, la première tâche équivalente consiste à poser une question précise sur un passage fourni, puis à demander la citation exacte qui étaye la réponse. Aucun des deux scénarios n’exige de transformer le modèle en employé autonome.
L’amélioration pratique tient à la continuité. Un sélecteur graphique réduit le risque de démarrer une configuration incompatible ; un moniteur matériel aide à comprendre pourquoi une autre application modifie les performances ; un préréglage sauvegardé transforme une expérience réussie en procédure reproductible. Ces fonctions n’augmentent pas les capacités de raisonnement du modèle. Elles réduisent le travail nécessaire entre disposer de cette capacité et l’utiliser de manière responsable.
Notre lecture est la suivante : la prochaine compétition de l’IA locale portera sur cette distance. L’expérience qui s’imposera permettra de conserver facilement une bonne configuration, de comprendre un échec et d’examiner une action risquée.
Tout le système mémoire de l’ordinateur devient une partie du modèle
La cible principale de Strata est Qwen3.8-Flash-Next, dont le cœur compte 125 milliards de paramètres. Sa stratégie d’exécution utilise la mémoire du GPU pour les calculs communs et les experts fréquemment sollicités, la RAM système et le CPU pour d’autres experts, ainsi que le SSD pour accéder à la table de recherche de n-grammes. Une carte graphique plus grande aide, mais la RAM et le stockage de la machine restent dans le chemin d’inférence. Présentation du projet, conception de l’exécution
Imaginez le PC comme un atelier doté de plusieurs plans de travail. La surface la plus rapide est limitée : le moteur doit donc décider quelles opérations méritent d’y rester. Améliorer cette décision peut rendre le matériel existant plus utile ; cela ne rend pas toutes les surfaces aussi rapides.
Trois quantités méritent une attention distincte. Le téléchargement occupe du stockage. Les poids chargés et les tampons d’exécution consomment de la mémoire. La fenêtre de contexte ajoute de l’état de travail à mesure que la conversation s’allonge. La taille d’un fichier ne suffit donc à déterminer ni la VRAM nécessaire ni la rapidité d’apparition de la première réponse.
Les recommandations actuelles du projet pour démarrer sont d’au moins 32 Go de RAM et de VRAM cumulées, avec environ 80 Go d’espace disque libre pour une installation habituelle. Ce sont des repères de départ, pas une promesse que tous les modèles, toutes les longueurs de contexte ou tous les systèmes d’exploitation tiendront dans cette enveloppe. Un portable de base doté de 16 Go ne doit pas être assimilé aux ordinateurs de bureau ci-dessous. Configuration matérielle requise
Davantage de noms de modèles ne signifie pas toujours davantage d’architectures
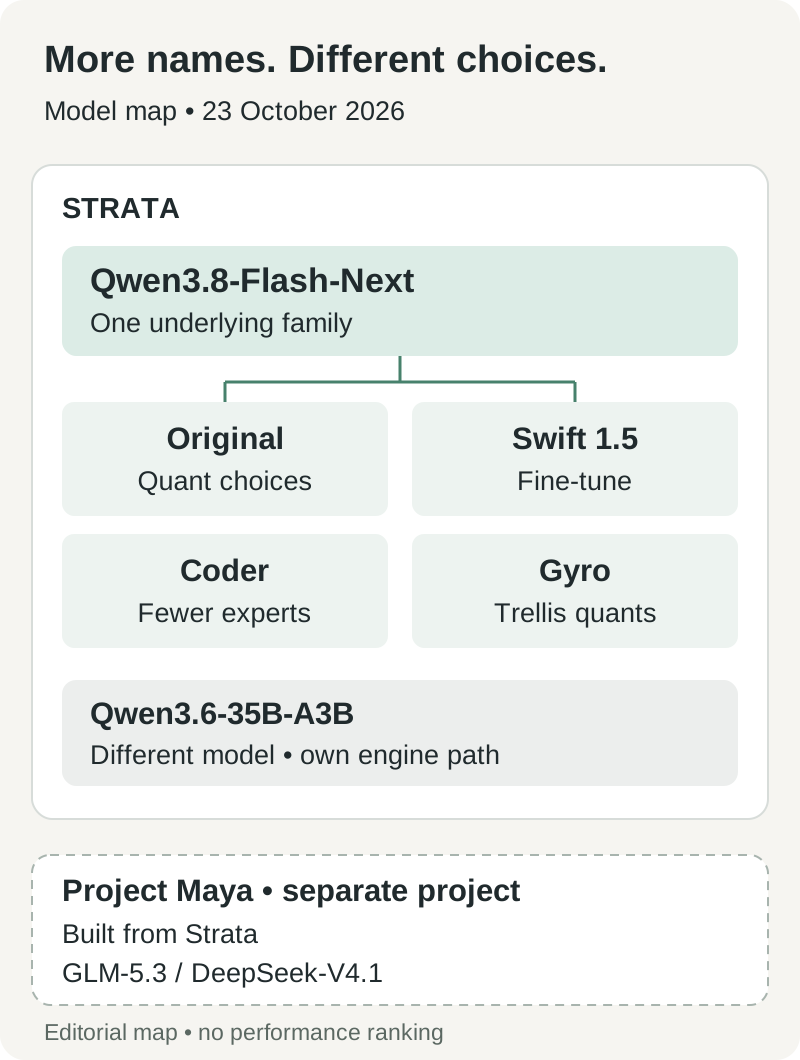
Carte éditoriale originale des relations documentées entre modèles, vérifiée le 23 octobre. Les branches représentent la filiation et la prise en charge par le moteur, pas une qualité égale ni des fichiers interchangeables.
Flash-Next original, Swift 1.5, Coder et Gyro répondent à des questions différentes au sein de la même famille. Swift modifie le comportement par ajustement fin. Coder retire des experts jugés moins utiles pour son orientation programmation. Gyro change la représentation des poids. Présenter ces noms comme quatre modèles de fondation sans rapport donne au catalogue une ampleur qu’il n’a pas. Guide des modèles
Ces différences ont des conséquences. Coder conserve 256 des 512 experts de chaque couche, et le projet avertit de performances plus faibles pour les tâches générales et les langues autres que l’anglais. Un modèle choisi parce qu’il convient à un PC de programmation ne devrait pas devenir automatiquement le choix par défaut pour interroger des documents multilingues. Le raisonnement plus court de Swift peut réduire la durée totale sans que le matériel génère chaque jeton plus vite. Compromis entre versions
Gyro-S nécessite un téléchargement de 58,5 Go, alors que son besoin documenté en mémoire pour les poids, RAM et VRAM réunies, est de 27,6 Go. Sa table de n-grammes reste sur le SSD. L’évaluation du projet situe sa qualité en dessous de celle des options plus volumineuses à faible nombre de bits ; réduire la mémoire a un prix. Documentation de Gyro
Il existe aussi un véritable deuxième modèle : Qwen3.6-35B-A3B, un modèle à mélange d’experts de 35 milliards de paramètres, dont 3 milliards actifs, pris en charge par un moteur distinct. Les options documentées comprennent les images et les requêtes simultanées sur les configurations NVIDIA et AMD prises en charge ; le moteur Mac ne l’exécute pas. Cette différence en fait une alternative intéressante à évaluer lorsque le plus grand nombre de paramètres annoncé ne correspond pas à votre besoin réel. Prise en charge de Qwen3.6
Trois machines publiées montrent trois formes d’utilité
Les exemples suivants ont été publiés par des contributeurs de la communauté ou par le projet lui-même. Ce sont des mesures de configurations précises, pas des essais réalisés pour cet article. Ils servent à montrer des usages plausibles et leur coût, plutôt qu’à classer trois ordinateurs au moyen de prompts incompatibles.
| Exemple publié | Modèle et conditions de contexte | Résultat rapporté | Ce qu’il aide à décider |
|---|---|---|---|
| Communauté, 9 octobre : RTX 3060 12 Go, Core i7-12700, 64 Go DDR4-3200, NVMe, Windows 11 | Strata 0.1.41 ; Q2_0 original ; fenêtre de 131 072 jetons ; nouveau prompt de 4 096 jetons, 256 jetons de sortie ; raisonnement et vision désactivés ; trois passages | Médiane de 42,9 jetons de sortie/s ; 4,7 secondes jusqu’au premier jeton ; 10,6 secondes au total | Une ancienne carte de 12 Go peut permettre des tâches courtes interactives avec suffisamment de RAM système |
| Communauté, 9–10 octobre : RX 9060 XT 16 Go, Ryzen 7 9800X3D, 64 Go DDR5-6000, Windows 11 | Moteur 0.1.40.3 ; IQ2_XS ; fenêtre de 122 880 jetons ; préremplissage 8 192 ; nouvelle entrée de 8 019 jetons, raisonnement faible ; trois passages | Médiane de 879,4 jetons de prompt/s, 56,3 jetons de sortie/s, 11,212 secondes au total | La configuration du prompt peut compter autant qu’une carte plus rapide pour des entrées de la taille d’un document |
| Mesure du projet, documentée au plus tard le 23 octobre : M4 Mac mini, 32 Go de mémoire unifiée | Gyro-S ; chargement des experts à la demande depuis le SSD ; arène d’experts de 11–12 Go ; aucune couche de brouillon ; récit de 120 jetons ; fenêtre totale non précisée | Médiane de 9,14 jetons de sortie/s sur cinq paires entrelacées ; un prompt distinct de 4 065 jetons lu à 109 jetons/s | Une machine compacte peut exécuter un grand modèle, au prix d’un temps d’attente plus long |
Sources : rapport RTX 3060, rapport RX 9060 XT, mesures Mac. Ces rapports sont antérieurs à la version actuelle de l’application ou portent sur des conditions différentes.
L’exemple RTX 3060 est utile parce qu’il inclut l’attente précédant la sortie. Une interface affichant environ 43 jetons par seconde peut tout de même marquer une pause pendant la lecture de la question. Le rapport mentionne aussi un ralentissement thermique et une activité en arrière-plan non contrôlée ; son intérêt est de donner les limites réalistes d’une machine, plutôt qu’une spécification GPU idéalisée.
Chez l’utilisateur Radeon, les éléments publiés décrivent un usage concret au-delà d’une boucle de mesure de vitesse. Le contributeur a exécuté trois tâches TypeScript synthétiques, trois fois par modèle, via un client de programmation ; IQ2_XS comme IQ3_XXS ont réussi les neuf exécutions. La configuration IQ2 a terminé ces tâches délimitées plus rapidement, tout en consommant moins de mémoire hôte. Cela encourage à essayer des travaux de programmation vérifiables ; cela ne démontre pas une qualité identique dans un dépôt inconnu. Comparaison en programmation et cas de test
L’exemple Mac répond à une autre question : un système relativement compact de 32 Go peut-il seulement participer ? Oui, avec la configuration de chargement à la demande publiée. Mais un autre prompt IQ3_XXS d’environ 30 000 jetons, décrit dans la documentation Mac, a demandé 5,6 minutes avant la première sortie. Une tâche par lots pour laquelle on peut patienter et un assistant sensible aux interruptions n’ont pas le même budget de latence. Mesures du chargement à la demande sur Mac
Voilà le choix à retenir. Utilisez une question courte pour découvrir le comportement interactif, un long document pour mesurer le coût du prompt et une tâche vérifiée pour savoir si les réponses sont utiles. Aucun chiffre ne remplace à lui seul ces trois vérifications.
Les correctifs d’octobre montrent pourquoi il faut noter les versions lors de l’installation
La version du 23 octobre annonce une amélioration de 6–19 % de la vitesse de réponse sur sa machine de test Windows Strix Halo avec IQ3_S, mesurée sur trois passages appariés face à 0.2.2. Elle fournit aussi un moteur SYCL pour Intel Arc sous Linux, testé sur une A750. Le mécanisme de brouillon DFlash2 reste réservé au Terminal et nécessite une activation volontaire ; Auto continue de choisir MTP, l’alternative n’ayant pas gagné sur toutes les charges de travail. Mesures et limites de 0.2.3
Ces améliorations accompagnent la maintenance ordinaire du logiciel. Le tag v0.2.1.2 du 20 octobre corrigeait le démarrage de Strix Halo sous Windows. Le guide matériel explique le problème antérieur : l’enregistrement de l’arène d’experts épuisait la mémoire GPU disponible, ne laissant aucun emplacement pour le cache. Une puce prise en charge et un installateur ne suffisaient pas tant que la gestion de la mémoire n’était pas corrigée. v0.2.1.2, explication du problème de démarrage Strix Halo
Il reste aussi des difficultés actuelles. Le ticket #3810, ouvert le 23 octobre, rapporte un plantage de l’installation CUDA sous Windows impliquant les métadonnées de vision fournies avec le logiciel. À la date de clôture des recherches, il s’agissait d’un signalement utilisateur en attente de résolution, pas d’une preuve que toutes les installations Windows échouent. Si votre cas correspond, consultez le ticket et les notes de version suivantes avant de passer des heures à régler à nouveau le modèle. Signalement d’installation Windows
Les mises à niveau demandent également de l’attention : les notes de 0.2.3 indiquent aux utilisateurs de 0.2.0-beta à 0.2.1.2 de relancer l’installateur Terminal, car ces versions ne peuvent pas remplacer elles-mêmes les composants Control. L’installateur conserve les modèles et les réglages. Sur Mac, vérifiez que le fichier signé souhaité est effectivement disponible : la section des limites connues de cette même version précise que les versions Mac étaient encore en cours de signature à la publication. Instructions de mise à niveau
Commencez par une tâche utile et un contexte court
Inutile de reproduire une démonstration de contexte gigantesque pour découvrir si l’expérience vaut la peine. Une petite boucle réussie fournit un point de référence, avec ses échecs et ses corrections, avant de mobiliser davantage de stockage ou d’accorder un large pouvoir d’action à un agent.
- Choisissez le parcours documenté pour votre matériel. Ouvrez la page officielle des versions et sélectionnez le paquet correspondant à votre système et à votre GPU. Notez séparément les versions de l’application et du moteur. Conservez une installation qui fonctionne déjà pendant l’évaluation d’une mise à niveau.
- Choisissez un modèle selon la mémoire libre, la langue et la tâche. Fermez les applications lourdes pour le premier essai. Commencez avec la taille recommandée, un contexte d’environ 8K et une seule requête simultanée. Conservez les fichiers du modèle sur un SSD local.
- Utilisez la configuration guidée. Le sélecteur de modèles de l’application ou
strata launchdonne accès aux réglages du modèle, du stockage, du contexte, des images et des accès. Gardez un accès local uniquement et les autorisations Manual pour le premier exercice de programmation. Guide Terminal - Demandez quelque chose que vous pouvez vérifier. Essayez une petite fonction accompagnée de tests, trois questions sur un document fourni ou une capture contenant des libellés connus. Enregistrez le prompt et comparez la réponse à la source réelle ou aux résultats des tests.
- Mesurez toute l’attente. Relevez le démarrage, le délai jusqu’à la première sortie, la durée totale, le pic de mémoire et la justesse du résultat. Recommencez ensuite une fois avec une relance utilisant le cache et une fois avec un nouveau prompt. Ne modifiez pas les réglages de brouillon et de raisonnement pendant cette comparaison.
- Ajoutez de la complexité une variable à la fois. N’augmentez le contexte que lorsque la tâche l’exige. Évaluez séparément les images, un autre modèle ou une connexion à un client de programmation, afin de pouvoir rattacher une régression à une cause concrète.
Pour des rapports de performances partageables, Strata propose strata bench run. Au 23 octobre, son protocole standardisé restait un brouillon en attente de validation pilote et séparait explicitement le chargement du modèle de l’inférence chronométrée. L’habitude importante est déjà utile : joindre au résultat le matériel, la quantification, les réglages effectifs et l’issue des tâches. Protocole de benchmark
Une inférence locale laisse encore des décisions aux frontières du système
La documentation de confidentialité de Strata indique qu’il n’utilise pas de télémétrie d’usage et que les modèles téléchargés peuvent fonctionner hors ligne. La recherche web, les pages ouvertes, les services de modèles distants, les tunnels et les outils configurés établissent des connexions externes lorsqu’on les utilise. Une conversation privée avec un modèle exige donc aussi un environnement de travail privé. Comportement réseau et téléchargements
Cela concerne particulièrement les exemples documentaires et de programmation. Un assistant capable de lire des fichiers et d’exécuter des commandes dispose de moyens qui dépassent la génération de texte. Examinez son dossier de travail, la commande exacte proposée et tout point d’accès d’outil externe avant de fournir des documents confidentiels. Conservez les originaux et l’historique des versions pour pouvoir récupérer une modification incorrecte.
Le service d’inférence écoute par défaut sur 127.0.0.1 ; ouvrir une écoute réseau change les personnes qui peuvent y accéder. Strata documente les clés API et son service d’écoute distinct pour le partage, mais la personne qui active l’accès reste responsable de cette décision. Une API compatible facilite la connexion d’un client ; elle ne rend pas privée toute configuration de client possible. Politique de sécurité
Project Maya montre jusqu’où l’idée peut aller — et ce qu’elle coûte
L’évolution plus large est l’adaptation de cette stratégie d’exécution à d’autres familles de modèles. Project Maya cite explicitement Strata comme point de départ de son moteur, de son serveur et de son tableau de bord, avec d’importants travaux pour ses propres modèles. Ses cibles documentées incluent GLM-5.3-Flash, 321B, et DeepSeek-V4.1-Flash-1017, 748B. Il s’agit d’un projet distinct, pas d’une option dans le menu des modèles de Strata. Modèles et crédits de Maya
Le téléchargement de GLM Maya-S représente 96,5 Go ; l’option DeepSeek Maya-S occupe 340 Go, tables Engram comprises. Un exemple communautaire associe une RTX 5090 à un Ryzen 9 7950X et à 96 Go de RAM, et rapporte plus de 30 jetons par seconde pour GLM Maya-M. Ces conditions expliquent pourquoi « un seul GPU » décrit incomplètement une configuration grand public. Fichiers de Maya et rapports matériels
La possibilité est réelle : une machine peut combiner plusieurs niveaux de stockage et de calcul pour servir un modèle dont les poids complets dépassent la mémoire de l’accélérateur. Le coût augmente lui aussi. Des centaines de gigaoctets à télécharger, des noyaux propres à chaque modèle, de la RAM système disponible et une prise en charge expérimentale des plateformes représentent de vrais engagements. Le portage réussi d’un grand modèle ne démontre pas l’existence d’un chargeur universel pour toutes les architectures.
Pour la plupart des lecteurs, Maya est une évolution à suivre avant d’être une solution de remplacement à recommander. La question utile est de savoir si un autre modèle résout une tâche qui met le modèle actuel en échec, avec un avantage suffisant pour justifier le matériel et la maintenance supplémentaires. Le seul nombre de paramètres ne permet pas d’y répondre.
La prochaine étape est un travail fiable, et les propositions publiques vont dans ce sens
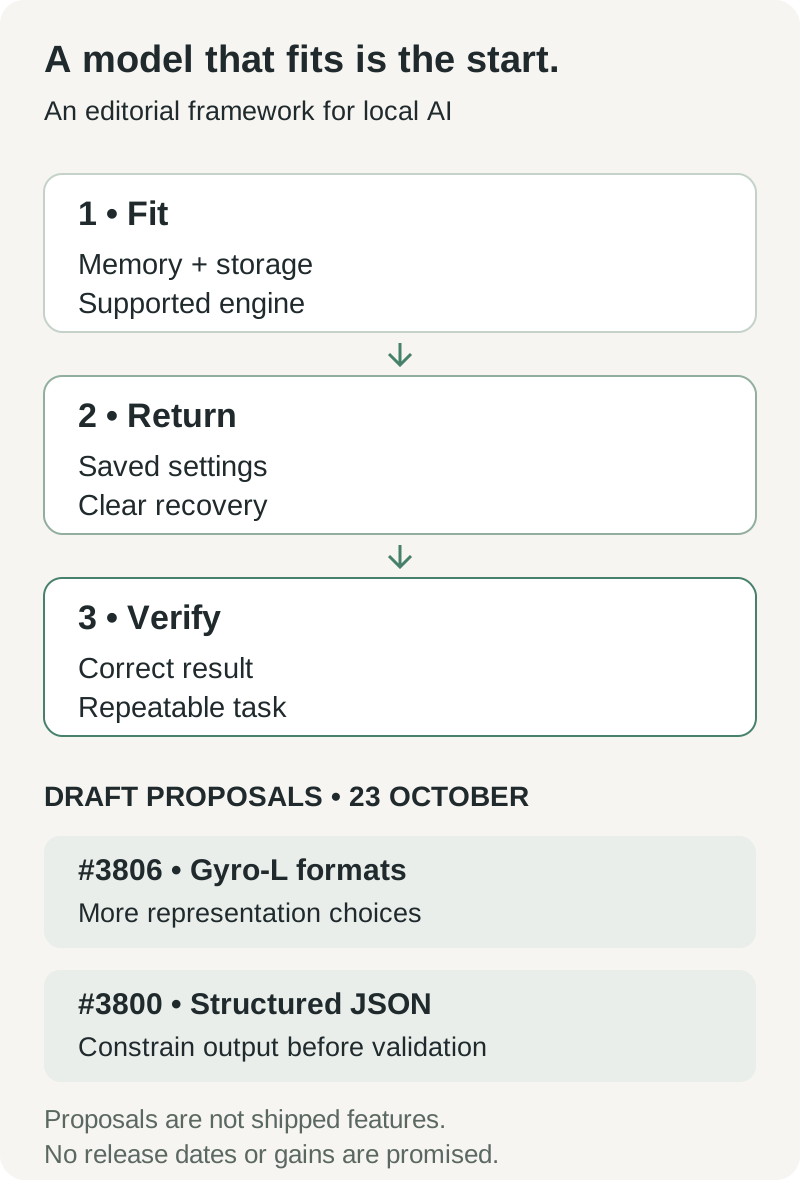
Cadre éditorial original. La séquence du haut décrit des critères d’adoption ; la ligne du bas identifie des propositions publiques vérifiées le 23 octobre. Ce n’est ni un calendrier de sortie promis ni une prévision de performances.
Deux pull requests ouvertes à l’état de brouillon donnent des indications plus concrètes qu’une feuille de route 2.0 imaginaire. #3806 propose la prise en charge des formats trellis de Gyro-L, actuellement non pris en charge. #3800 propose le masquage de jetons pour les sorties JSON structurées afin de réduire les relances complètes de requêtes dues à des générations invalides. Les deux étaient des brouillons le 23 octobre ; aucune ne figure parmi les capacités déjà livrées. Proposition Gyro-L, proposition de sorties structurées
Si de tels travaux aboutissent à une version fiable, deux types de tâches locales en profiteront. Une meilleure prise en charge des formats donne davantage de moyens d’arbitrer entre mémoire et qualité. Des sorties structurées plus fiables aident l’extraction documentaire, l’étiquetage et les appels d’outils à produire des données qu’un autre programme peut valider en sécurité. La deuxième amélioration est moins spectaculaire dans une vidéo, mais peut être plus précieuse dans un usage répété.
Notre attente est conditionnelle : l’inférence personnelle devient plus utile à mesure que les moteurs préservent les configurations fonctionnelles, limitent leur consommation de mémoire et se remettent des échecs. Davantage de portages et des mécanismes de brouillon plus ingénieux n’aident que si le lecteur peut les relier à une tâche réelle. Un modèle de bureau mérite sa place en produisant un travail que l’on peut vérifier et répéter.
La question pour le prochain ordinateur d’IA locale est donc simple : pourrez-vous lui confier demain la même tâche utile et avoir suffisamment confiance dans le processus pour continuer à l’utiliser ?
Sources et notes de lecture
Clôture des recherches : 23 octobre 2026. Le statut des versions, celui des tickets et les fichiers disponibles peuvent changer après cette date. Les mesures ci-dessus conservent leurs dates de publication et leurs configurations d’origine ; aucun nouveau benchmark d’inférence n’a été réalisé pour cet article.
- Strata 0.2.0-beta, v0.2.1.2 et notes de version 0.2.3.
- Guide des modèles Strata, prise en charge de Qwen3.6 et documentation de Gyro.
- Collection de benchmarks communautaires, documentation Mac et protocole de benchmark à l’état de brouillon.
- Project Maya, capture officielle de Strata et licence de son dépôt.
Conservez vos décisions sur l’IA locale avec les éléments qui les étayent
Lorsque vous comparez des configurations, gardez ensemble les liens sources, les réglages matériels, les résultats des tâches et les corrections. Telli.sh peut vous aider à organiser ces notes de recherche et ces résumés au fil de l’évolution de votre installation. Créer un compte Telli.sh