[Notas de campo sobre IA local 01] La próxima prueba de Strata: hacer útil un gran modelo en tu PC
La beta 0.2 de Strata se convirtió en una aplicación de escritorio. Tres ejemplos publicados con hardware de consumo muestran qué funciona, cuánta memoria cuesta y hacia dónde va la IA local.
La demostración de IA local más interesante es la que puedes seguir usando la semana que viene. Que un gran modelo produzca una respuesta ingeniosa en un PC para juegos es un hito; abrir mañana la misma conversación, encontrar los archivos del modelo y dejar que edite un proyecto con seguridad son los primeros pasos hacia una herramienta útil.
Strata avanzó hacia esa segunda categoría con 0.2.0-beta el 19 de octubre de 2026: una aplicación de escritorio, una interfaz Terminal y motores distribuidos por separado. Para el 23 de octubre ya había llegado 0.2.3. El nombre real de la beta importa al elegir las descargas: esta es la rama de versiones 0.2, no una futura 2.0 anunciada. Versión beta, versión del 23 de octubre
Esta primera entrega de Notas de campo sobre IA local examina qué aporta ese cambio a quien ya tiene un ordenador. Relacionaremos la nueva interfaz con tres ejemplos de hardware publicados, distinguiremos las variantes de modelos de las arquitecturas diferentes y examinaremos los avances que podrían convertir la inferencia local en un servicio cotidiano fiable.
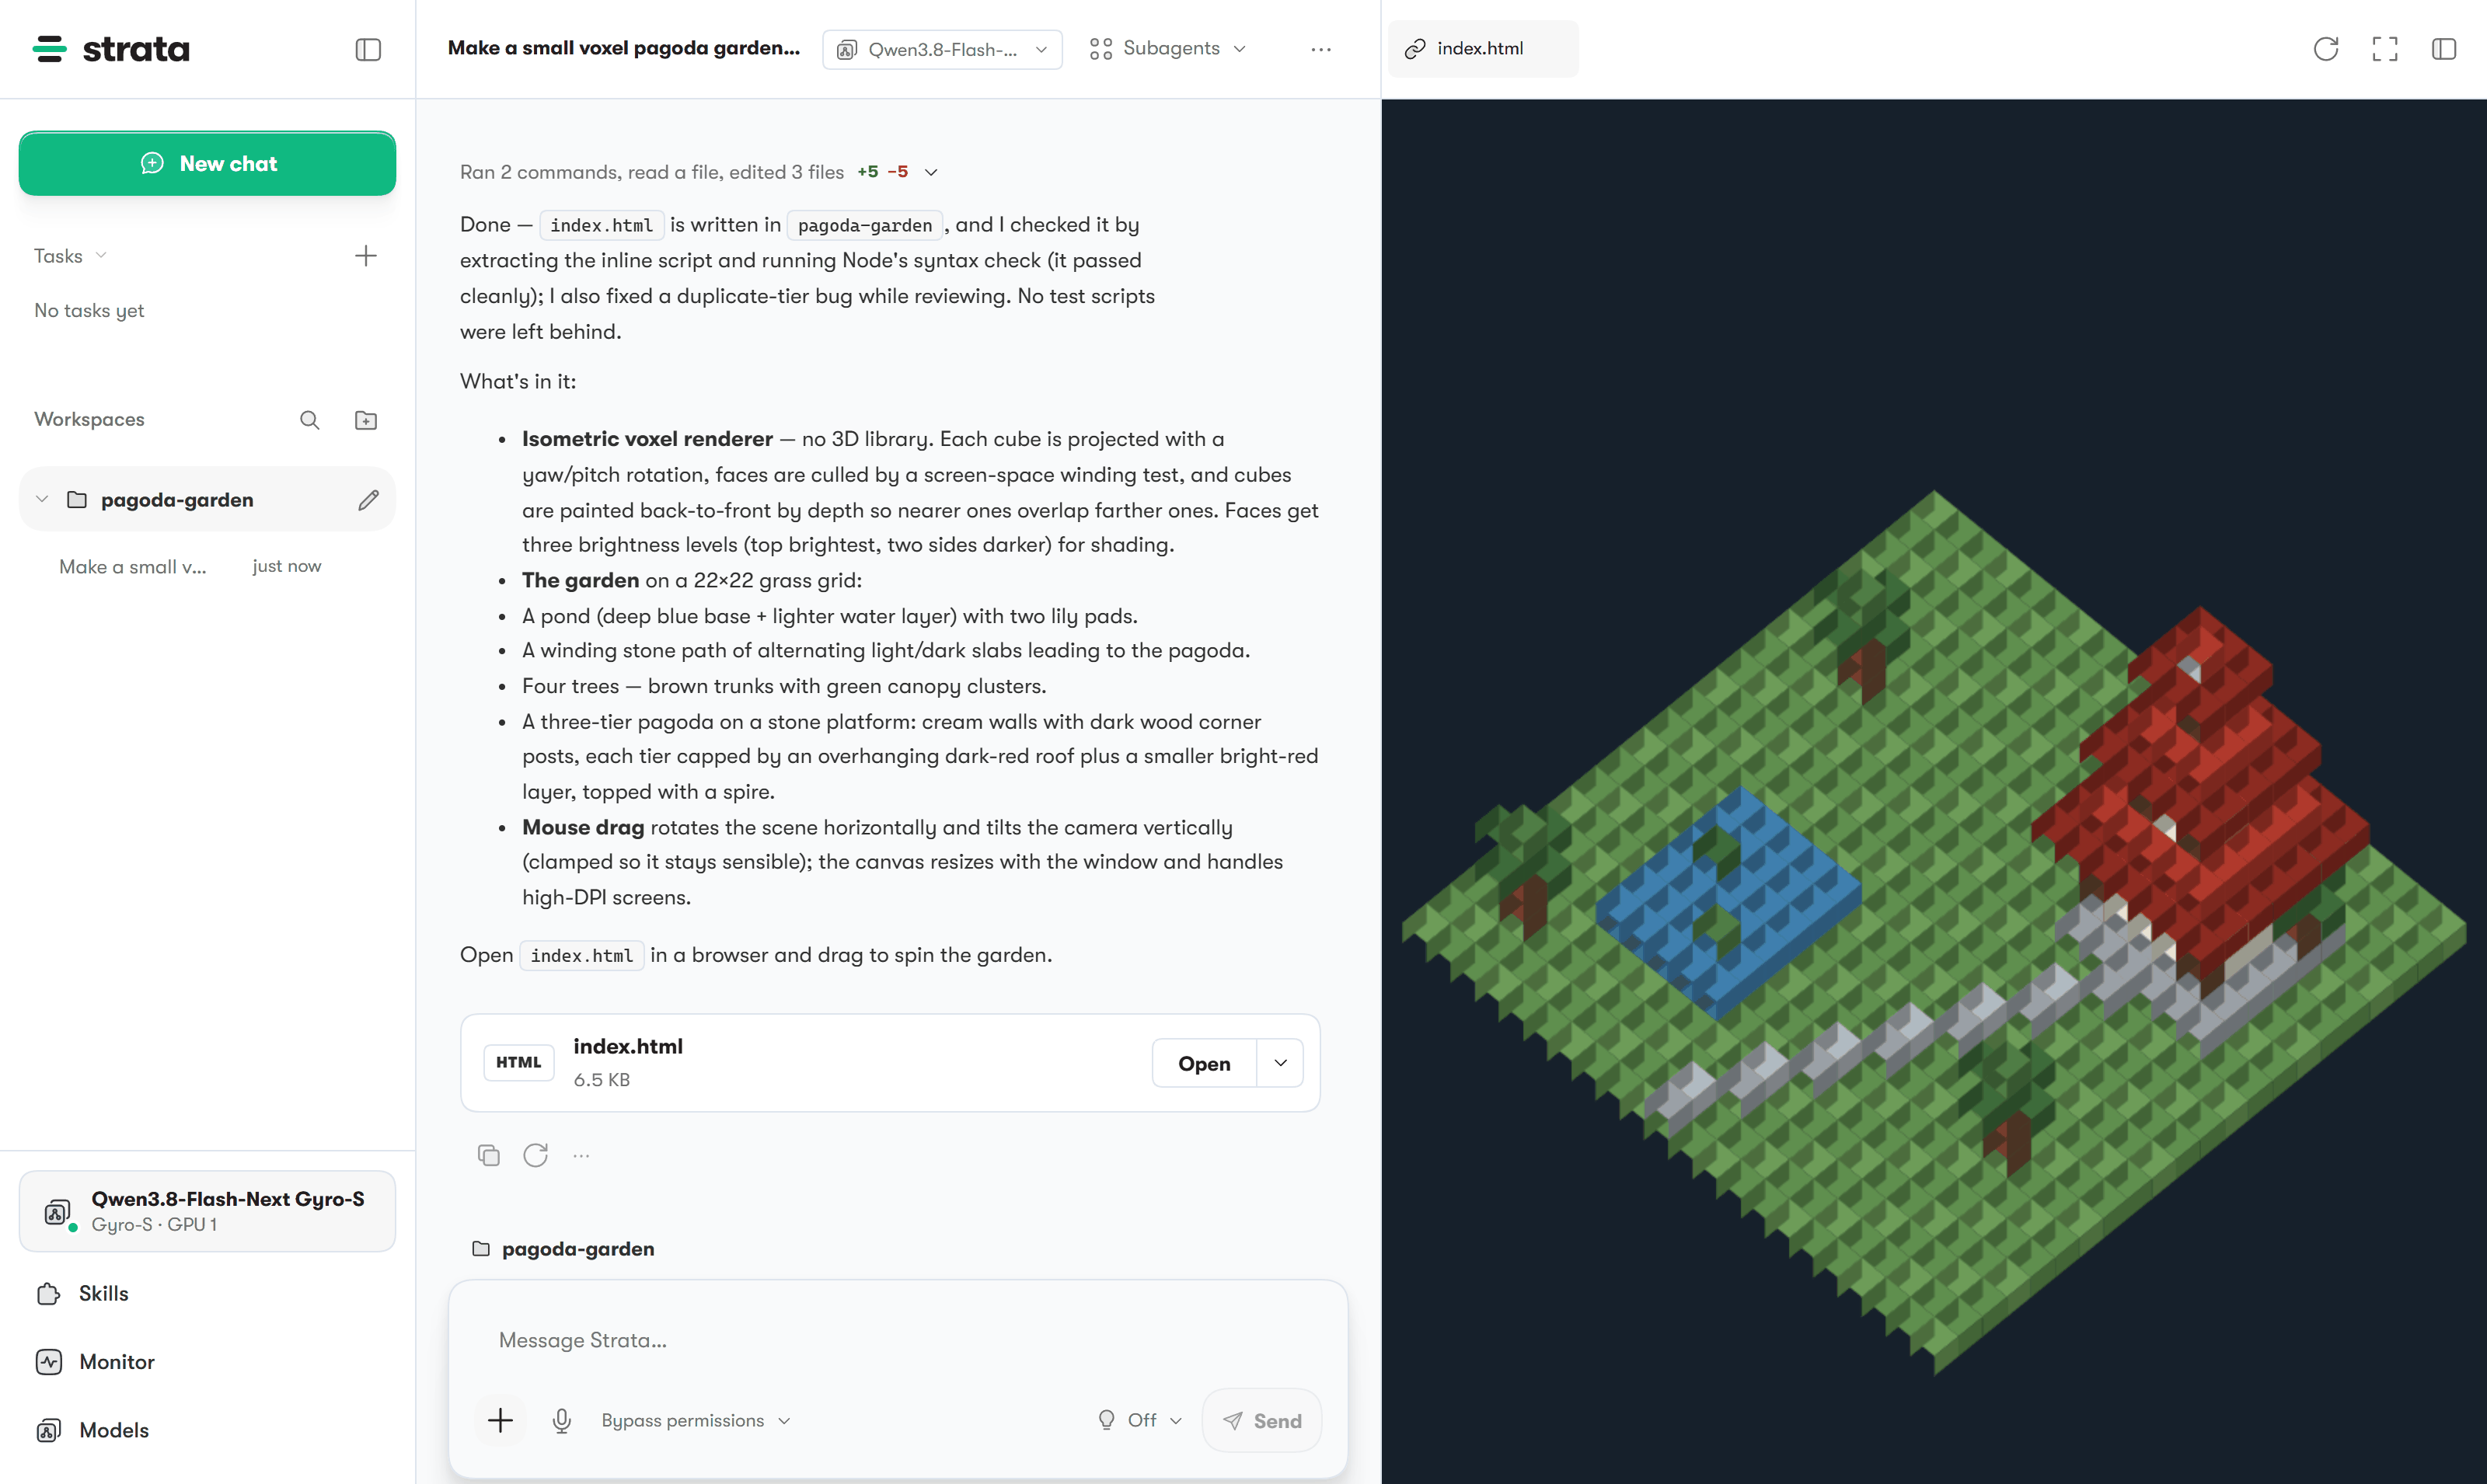
Captura oficial de Strata del repositorio de la versión 0.2.3, con una conversación de programación y una vista previa de HTML. Ilustra la interfaz; no corresponde a una prueba realizada para este artículo. © 2026 Niko1221 y los colaboradores de Strata; fuente, licencia MIT.

La beta convirtió el motor en una herramienta a la que puedes volver
La aplicación de escritorio reúne selección de modelos, gestión del almacenamiento, chat, supervisión del hardware y un espacio de programación. Su modo de permisos Manual pregunta antes de hacer cambios; el modo Bypass, más permisivo, da mayor libertad al agente. El Terminal ofrece un proceso guiado con strata launch y conexiones a clientes de programación. Ambos comparten el mismo motor subyacente. Funciones de 0.2.0-beta
Para un desarrollador, esto ofrece un ejemplo sencillo de uso: pedir un pequeño analizador en un proyecto desechable, inspeccionar los archivos propuestos, ejecutar las pruebas y continuar la conversación con un caso que falle. Para quien trabaja mucho con documentos, el primer encargo equivalente es una pregunta acotada sobre un pasaje proporcionado, seguida de una petición de la cita exacta que respalda la respuesta. Ninguno de estos escenarios exige convertir al modelo en un empleado autónomo.
La mejora práctica está en la continuidad. Un selector gráfico de modelos reduce el riesgo de iniciar una configuración incompatible; un monitor de hardware ayuda a explicar por qué otra aplicación cambia el rendimiento; un ajuste guardado transforma un experimento exitoso en algo repetible. Estas funciones no aumentan la capacidad de razonamiento del modelo. Reducen el trabajo entre tener esa capacidad disponible y usarla de forma responsable.
Nuestra lectura es esta: la próxima competición de la IA local gira en torno a esa distancia. La experiencia ganadora facilitará conservar una buena configuración, entender un fallo y revisar una acción arriesgada.
Todo el sistema de memoria del ordenador pasa a formar parte del modelo
El principal objetivo de Strata es Qwen3.8-Flash-Next, cuyo núcleo tiene 125.000 millones de parámetros. Su estrategia de ejecución utiliza la memoria de la GPU para los cálculos comunes y los expertos más frecuentes, la RAM del sistema y la CPU para otros expertos, y el acceso al SSD para la tabla de consulta de n-gramas. Una tarjeta gráfica de mayor capacidad ayuda, pero la RAM y el almacenamiento del equipo siguen formando parte de la ruta de inferencia. Descripción del proyecto, diseño de ejecución
Piensa en el PC como un taller con varias superficies de trabajo. La más rápida es limitada, por lo que el motor debe decidir qué trabajo merece permanecer allí. Mejorar esa decisión puede hacer más útil el hardware existente; no puede hacer que todas las superficies sean igual de rápidas.
Hay tres cantidades que conviene observar por separado. La descarga ocupa almacenamiento. Los pesos cargados y los búferes de ejecución consumen memoria. La ventana de contexto añade estado de trabajo conforme crece la conversación. Por tanto, el tamaño de un archivo no indica por sí solo cuánta VRAM necesitas ni cuánto tardará en aparecer la primera respuesta.
La recomendación inicial actual del proyecto es de al menos 32 GB de RAM y VRAM combinadas, con unos 80 GB de espacio libre en disco para su instalación habitual. Son pautas de entrada, no una promesa de que cualquier modelo, longitud de contexto o sistema operativo quepa en ese margen. Un portátil básico con 16 GB no debe considerarse equivalente a los equipos de sobremesa siguientes. Requisitos de hardware
Más nombres de modelos no siempre significan más arquitecturas
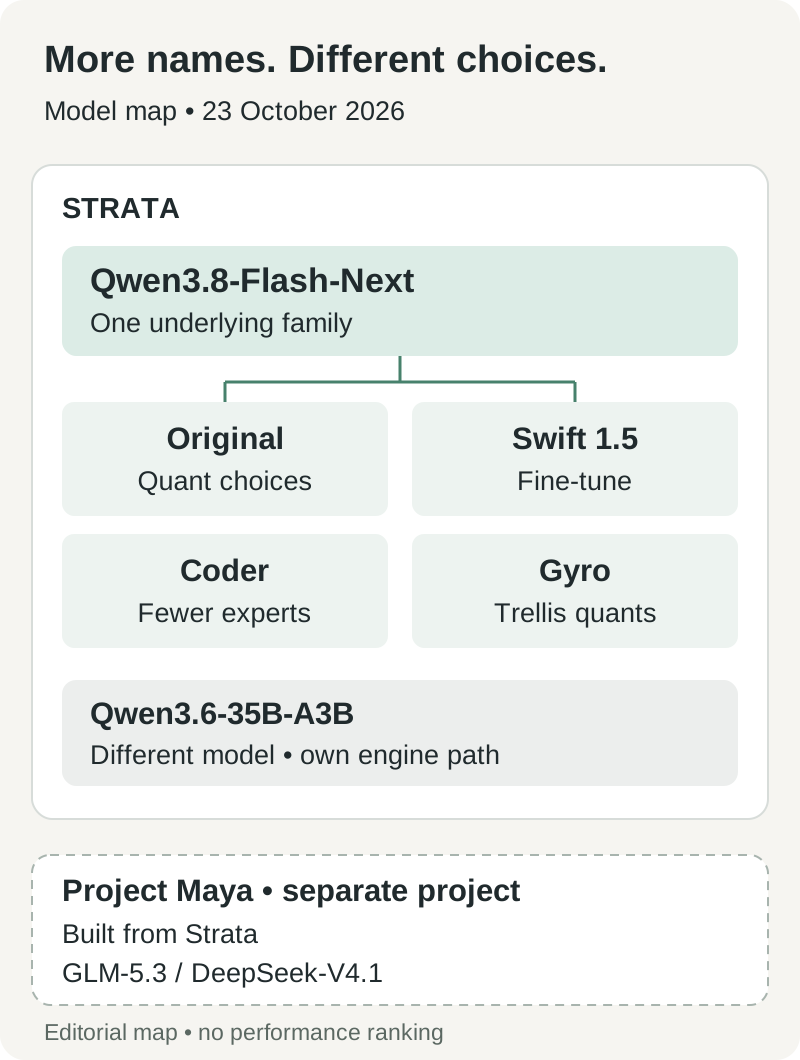
Mapa editorial original de las relaciones documentadas entre modelos, comprobado el 23 de octubre. Las ramas muestran el linaje y la compatibilidad del motor, no una calidad equivalente ni archivos intercambiables.
Flash-Next original, Swift 1.5, Coder y Gyro responden a preguntas distintas sobre la misma familia subyacente. Swift cambia el comportamiento mediante ajuste fino. Coder elimina expertos seleccionados por ser menos útiles para su enfoque en programación. Gyro cambia la representación de los pesos. Tratar esos nombres como cuatro modelos fundacionales sin relación hace que el catálogo parezca más amplio de lo que es. Guía de modelos
Estas diferencias tienen consecuencias. Coder conserva 256 de los 512 expertos de cada capa, y el proyecto advierte de un rendimiento más débil en tareas generales y en idiomas distintos del inglés. Un modelo elegido porque encaja en un equipo de programación no debería convertirse automáticamente en la opción predeterminada para consultas sobre documentos multilingües. El razonamiento más breve de Swift puede reducir el tiempo total sin que el hardware genere más deprisa cada token individual. Compromisos entre versiones
Gyro-S requiere una descarga de 58,5 GB, aunque su necesidad documentada de memoria para los pesos, sumando RAM y VRAM, es de 27,6 GB. Su tabla de n-gramas permanece en el SSD. La evaluación del proyecto sitúa su calidad por debajo de las opciones más grandes de pocos bits; ocupar menos memoria tiene un precio. Documentación de Gyro
También existe un segundo modelo real: Qwen3.6-35B-A3B, un modelo de mezcla de expertos de 35.000 millones de parámetros, con 3.000 millones activos, que utiliza una ruta de motor separada. Entre sus opciones documentadas están las imágenes y las solicitudes simultáneas en configuraciones NVIDIA y AMD compatibles; el motor de Mac no lo ejecuta. Esa distinción lo convierte en una alternativa útil para evaluar cuando la mayor cifra de parámetros anunciada no es tu necesidad real. Compatibilidad con Qwen3.6
Tres máquinas publicadas muestran tres formas distintas de utilidad
Los siguientes ejemplos fueron publicados por colaboradores de la comunidad o por el propio proyecto. Son mediciones de configuraciones concretas, no pruebas prácticas realizadas para este artículo. Su propósito es mostrar tareas plausibles y su coste, no clasificar tres ordenadores con instrucciones de entrada incompatibles.
| Ejemplo publicado | Modelo y condiciones de contexto | Resultado comunicado | Qué te ayuda a decidir |
|---|---|---|---|
| Comunidad, 9 de octubre: RTX 3060 12 GB, Core i7-12700, 64 GB DDR4-3200, NVMe, Windows 11 | Strata 0.1.41; Q2_0 original; ventana de 131.072 tokens; instrucción nueva de 4.096 tokens, 256 tokens de salida; razonamiento y visión desactivados; tres ejecuciones | Mediana de 42,9 tokens de salida/s; 4,7 segundos hasta el primer token; 10,6 segundos en total | Una tarjeta antigua de 12 GB permite tareas breves interactivas si se combina con abundante RAM del sistema |
| Comunidad, 9–10 de octubre: RX 9060 XT 16 GB, Ryzen 7 9800X3D, 64 GB DDR5-6000, Windows 11 | Motor 0.1.40.3; IQ2_XS; ventana de 122.880 tokens; prellenado 8.192; entrada nueva de 8.019 tokens, razonamiento bajo; tres ejecuciones | Mediana de 879,4 tokens de entrada/s, 56,3 tokens de salida/s, 11,212 segundos en total | La configuración de la entrada puede importar tanto como una tarjeta más rápida con textos del tamaño de un documento |
| Medición del proyecto, documentada a más tardar el 23 de octubre: M4 Mac mini, 32 GB de memoria unificada | Gyro-S; carga de expertos bajo demanda desde SSD; área de expertos de 11–12 GB; sin capa de borrador; relato de 120 tokens; ventana total no especificada | Mediana de 9,14 tokens de salida/s en cinco pares intercalados; una entrada separada de 4.065 tokens se leyó a 109 tokens/s | Una máquina compacta puede ejecutar un gran modelo, a cambio de un mayor tiempo de espera |
Fuentes: informe de RTX 3060, informe de RX 9060 XT, mediciones de Mac. Estos informes son anteriores a la versión actual de la aplicación o corresponden a condiciones diferentes.
El ejemplo de la RTX 3060 es útil porque incluye la espera anterior a la salida. Una interfaz que muestra unos 43 tokens por segundo puede detenerse mientras lee la pregunta. El informe también recoge ralentización térmica y actividad de fondo no controlada; su valor está en delimitar de forma realista una máquina concreta, no en ofrecer una especificación idealizada de la GPU.
En el caso del usuario de Radeon, hay pruebas de un flujo de trabajo concreto más allá de un bucle de medición de velocidad. El colaborador ejecutó tres tareas sintéticas de TypeScript tres veces por modelo mediante un cliente de programación, y tanto IQ2_XS como IQ3_XXS superaron las nueve ejecuciones. La configuración IQ2 terminó esas tareas acotadas más rápido y consumió menos memoria del equipo anfitrión. Esto respalda probar trabajos de programación verificables; no demuestra una calidad equivalente en un repositorio desconocido. Comparación de programación y casos de prueba
El ejemplo de Mac responde a otra pregunta: ¿puede participar siquiera un sistema relativamente compacto de 32 GB? Sí, con la configuración publicada de carga bajo demanda. Pero otra entrada IQ3_XXS de unos 30.000 tokens incluida en la documentación de Mac tardó 5,6 minutos hasta la primera salida. Una tarea por lotes que admite paciencia y un asistente sensible a las interrupciones tienen presupuestos de latencia distintos. Mediciones de carga bajo demanda en Mac
Esa es la distinción que conviene retener. Usa una pregunta corta para descubrir el comportamiento interactivo, un documento largo para descubrir el coste de procesar la entrada y una tarea verificada para saber si las respuestas son útiles. Ninguna cifra aislada representa las tres cosas.
Las correcciones de octubre muestran por qué hay que anotar las versiones al configurar
La versión del 23 de octubre comunica una mejora del 6–19 % en la velocidad de respuesta en su máquina de pruebas Windows Strix Halo con IQ3_S, medida en tres ejecuciones emparejadas frente a 0.2.2. También incluye un paquete de motor SYCL para Intel Arc en Linux, con la A750 como tarjeta probada. La generación de borradores DFlash2 solo está disponible en el Terminal y requiere activación voluntaria; Auto sigue eligiendo MTP porque la alternativa no ha ganado en todas las cargas de trabajo. Mediciones y límites de 0.2.3
Estas mejoras conviven con el mantenimiento habitual del software. La etiqueta v0.2.1.2 del 20 de octubre corrigió el inicio de Strix Halo en Windows. La guía de hardware explica el problema previo: registrar el área de expertos agotaba la memoria disponible de la GPU y no dejaba espacio para la caché. Un chip compatible y un instalador no bastaban hasta corregir la gestión de la memoria. v0.2.1.2, explicación del inicio de Strix Halo
También quedan dificultades actuales. La incidencia #3810, abierta el 23 de octubre, informa de un fallo durante la configuración de CUDA en Windows relacionado con los metadatos de visión incluidos en el paquete. Al cierre de la investigación de este artículo era un informe de usuario pendiente de resolución, no una prueba de que todas las instalaciones de Windows fallen. Si tu caso coincide, consulta la incidencia y las notas de versiones posteriores antes de dedicar horas a reajustar un modelo. Informe de configuración de Windows
Las actualizaciones también requieren atención: las notas de 0.2.3 indican a los usuarios de 0.2.0-beta a 0.2.1.2 que vuelvan a ejecutar el instalador del Terminal, porque esas versiones no pueden cambiar por sí mismas los componentes Control. El instalador conserva los modelos y los ajustes. En Mac, comprueba que el archivo firmado que buscas haya aparecido realmente: la sección de limitaciones conocidas de esa misma versión dice que las compilaciones de Mac seguían en proceso de firma al publicarse. Instrucciones de actualización
Empieza con una tarea útil y un contexto corto
No necesitas reproducir una demostración de contexto enorme para descubrir si merece la pena. Un pequeño ciclo exitoso te da una referencia inicial, incluidos los fallos y las correcciones, antes de dedicar más almacenamiento o permitir que un agente actúe con amplitud.
- Elige la ruta documentada para tu hardware. Abre la página oficial de versiones y selecciona el paquete correspondiente al sistema operativo y la GPU. Anota por separado las versiones de la aplicación y del motor. Conserva una instalación que ya funcione mientras evalúas una actualización.
- Selecciona un modelo según la memoria libre, el idioma y la tarea. Cierra las aplicaciones pesadas para el primer ensayo. Empieza con el tamaño recomendado, un contexto de unos 8K y una sola solicitud simultánea. Guarda los archivos del modelo en un SSD local.
- Utiliza la configuración guiada. El selector de modelos del escritorio o
strata launchexpone los ajustes de modelo, almacenamiento, contexto, imágenes y acceso. Mantén el acceso solo local y los permisos Manual para el primer ejercicio de programación. Guía del Terminal - Pide algo que puedas verificar. Prueba una pequeña función con tests, tres preguntas sobre un documento proporcionado o una captura con etiquetas conocidas. Guarda la instrucción y comprueba la respuesta con la fuente real o la salida de las pruebas.
- Mide toda la espera. Registra el inicio, el tiempo hasta la primera salida, la duración total de la tarea, el pico de memoria y la corrección del resultado. Repite después una vez con una consulta de seguimiento que aproveche la caché y otra con una entrada nueva. Mantén iguales los ajustes de borrador y razonamiento durante la comparación.
- Añade complejidad cambiando una variable cada vez. Aumenta el contexto solo cuando lo exija el trabajo. Evalúa por separado las imágenes, otro modelo o una conexión a un cliente de programación, para poder atribuir una regresión a algo concreto.
Para elaborar informes de rendimiento que se puedan compartir, Strata ofrece strata bench run. Su protocolo estandarizado seguía siendo un borrador pendiente de validación piloto el 23 de octubre y separa expresamente la carga del modelo de la inferencia cronometrada. El hábito importante ya resulta útil: adjuntar al resultado el hardware, la cuantización, los ajustes efectivos y los resultados de las tareas. Protocolo de pruebas de rendimiento
Mantener la inferencia en local deja decisiones en los límites
La documentación de privacidad de Strata afirma que no utiliza telemetría de uso y que puede ejecutar sin conexión los modelos descargados. Las búsquedas web, las páginas abiertas, los servicios de modelos remotos, los túneles y las herramientas configuradas crean conexiones externas al utilizarse. Por tanto, una conversación privada con un modelo también necesita un flujo de trabajo privado a su alrededor. Comportamiento de red y descargas
Esto es especialmente relevante en los ejemplos de documentos y programación. Un asistente capaz de leer archivos y ejecutar comandos tiene capacidades que van más allá de generar texto. Revisa su carpeta de trabajo, el comando exacto propuesto y cualquier punto de conexión de herramientas externas antes de aportar material confidencial. Conserva los originales y el historial de versiones para poder recuperar una edición incorrecta.
El servicio de inferencia escucha de forma predeterminada en 127.0.0.1; abrir la escucha a la red cambia quién puede acceder. Strata documenta las claves API y su servicio de escucha separado para compartir, pero quien habilita el acceso sigue siendo responsable de esa decisión. Una API compatible facilita conectar un cliente; no convierte en privada cualquier configuración posible de ese cliente. Política de seguridad
Project Maya muestra hasta dónde llega la idea y cuánto cuesta
El avance más amplio es que la estrategia de ejecución se está adaptando a otras familias de modelos. Project Maya reconoce expresamente a Strata como punto de partida de su motor, servidor y panel, con un trabajo considerable para sus propios modelos. Entre sus objetivos documentados están GLM-5.3-Flash, 321B, y DeepSeek-V4.1-Flash-1017, 748B. Es un proyecto independiente, no una opción del menú de modelos de Strata. Modelos y créditos de Maya
La descarga de GLM Maya-S es de 96,5 GB; la opción DeepSeek Maya-S ocupa 340 GB, incluidas las tablas Engram. Un ejemplo de la comunidad combina una RTX 5090 con un Ryzen 9 7950X y 96 GB de RAM, y comunica más de 30 tokens por segundo para GLM Maya-M. Esas condiciones explican por qué «una GPU» es una descripción incompleta de un equipo de consumo. Archivos de Maya e informes de hardware
La oportunidad es real: una máquina puede combinar varios niveles de almacenamiento y cómputo para servir un modelo cuyos pesos completos superan la memoria de su acelerador. El coste también crece. Cientos de gigabytes de descargas, kernels específicos de cada modelo, memoria RAM libre y compatibilidad experimental con plataformas son compromisos importantes. Adaptar con éxito un gran modelo no demuestra que exista un cargador universal para todas las arquitecturas.
Para la mayoría de los lectores, Maya es una evolución que conviene seguir antes de recomendarla como sustituto. La pregunta útil es si un modelo diferente resuelve una tarea en la que falla el actual, con un beneficio suficiente para justificar el hardware y el mantenimiento adicionales. El número de parámetros por sí solo no puede responderla.
El próximo hito es un trabajo fiable, y las propuestas públicas apuntan hacia él
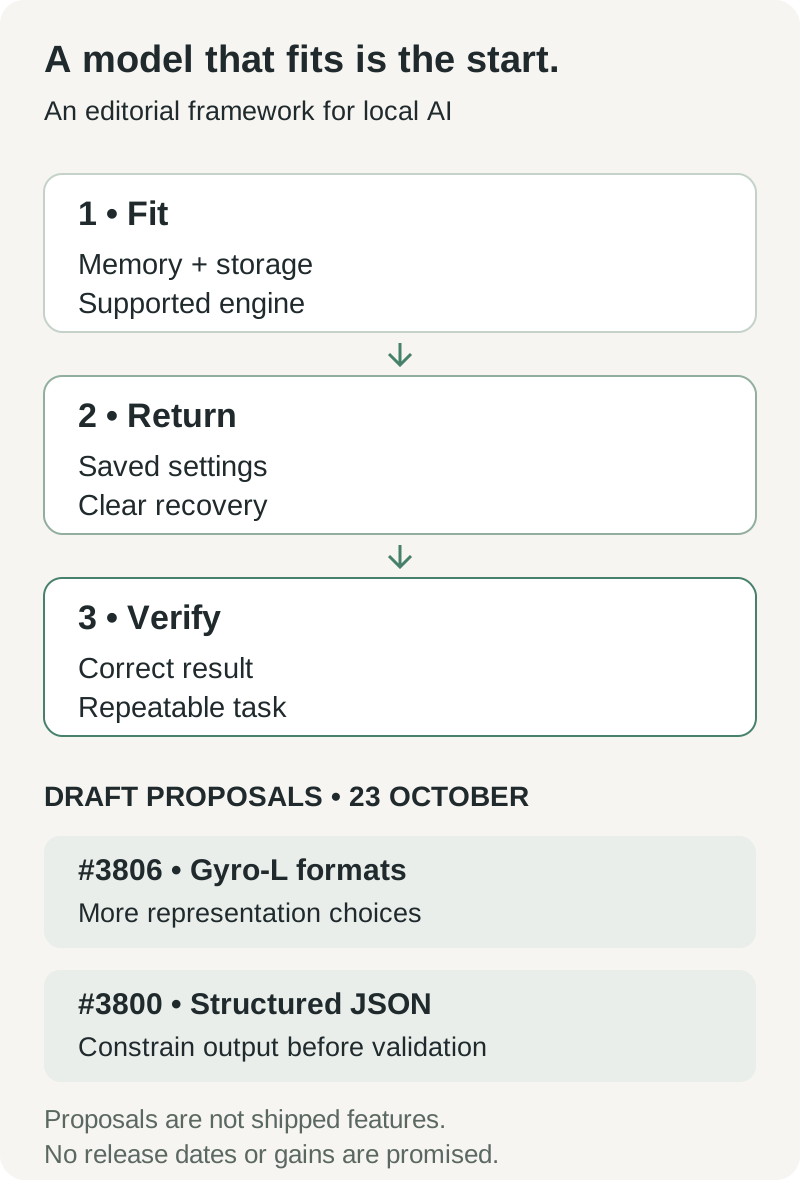
Marco editorial original. La secuencia superior describe criterios de adopción; la fila inferior identifica propuestas públicas comprobadas el 23 de octubre. No es un calendario de versiones prometido ni una previsión de rendimiento.
Dos pull requests abiertas en borrador ofrecen señales más concretas que una hoja de ruta imaginaria de 2.0. #3806 propone compatibilidad con los formatos trellis de Gyro-L que actualmente no se admiten. #3800 propone enmascarar tokens para generar JSON estructurado, de modo que las generaciones no válidas requieran menos reintentos completos de la solicitud. Ambas eran borradores el 23 de octubre; ninguna debe aparecer en una lista de capacidades ya publicadas. Propuesta de Gyro-L, propuesta de salidas estructuradas
Si trabajos como estos llegan a una versión fiable, se beneficiarán dos tipos de tareas locales. Una mejor compatibilidad de formatos ofrece más maneras de equilibrar memoria y calidad. Unas salidas estructuradas más fiables ayudan a que la extracción de documentos, el etiquetado y las llamadas a herramientas produzcan datos que otro programa pueda validar con seguridad. La segunda mejora resulta menos espectacular en un vídeo, pero puede ser más valiosa en un flujo de trabajo repetido.
Nuestra expectativa es condicional: la inferencia personal se vuelve más útil cuando los motores preservan las configuraciones que funcionan, acotan el uso de memoria y se recuperan de los fallos. Más adaptaciones de motores y mecanismos de borrador más ingeniosos solo ayudan si el lector puede vincularlos con una tarea real. Un modelo de escritorio se gana su sitio produciendo trabajo que puedas comprobar y repetir.
La pregunta para el próximo ordenador de IA local es, por tanto, sencilla: ¿puedes darle mañana la misma tarea útil y confiar lo suficiente en el proceso como para seguir usándolo?
Fuentes y notas de lectura
Cierre de la investigación: 23 de octubre de 2026. El estado de las versiones, el de las incidencias y los archivos disponibles pueden cambiar después de esa fecha. Las mediciones anteriores conservan sus fechas de publicación y configuraciones originales; no se realizó ninguna nueva prueba de inferencia para este artículo.
- Strata 0.2.0-beta, v0.2.1.2 y notas de la versión 0.2.3.
- Guía de modelos de Strata, compatibilidad con Qwen3.6 y documentación de Gyro.
- Colección de pruebas de la comunidad, documentación de Mac y borrador del protocolo de pruebas de rendimiento.
- Project Maya, captura oficial de Strata y licencia de su repositorio.
Guarda tus decisiones sobre IA local junto con sus pruebas
Al comparar configuraciones, conserva juntos los enlaces a las fuentes, los ajustes de hardware, los resultados de las tareas y las correcciones. Telli.sh puede ayudarte a organizar esas notas de investigación y esos resúmenes a medida que evoluciona tu configuración. Crear una cuenta de Telli.sh