Strata 0.2.17 chce więcej twojego RAM-u. Czy komputer do pracy powinien go oddać?
Nowy budżet pamięci Straty może ograniczyć odczyty z SSD, a osobne ustawienie domyślne chroni wierność działania modelu. Jak wybrać tryb dla komputera do pracy i sprawdzić ten kompromis.
Lokalny model może odpowiadać szybciej, a jednocześnie pogarszać komfort korzystania z reszty komputera. Na maszynie, która obsługuje także przeglądarkę, edytor i wideorozmowy, oba wyniki należą do tego samego porównania.
Strata 0.2.17, wydana 20 listopada 2026 roku, pokazuje ten kompromis wyjątkowo wyraźnie. W przypadku określonych plików modeli, których wszystkie wagi ekspertów nie mogą pozostać w RAM-ie, konfiguracja nastawiona na wydajność zwiększa przydział utrzymywany w pamięci. Wydanie wyłącza też osobną optymalizację po zgłoszeniach użytkowników o gorszych odpowiedziach.
Warto zapytać, czy twój PC jest maszyną przeznaczoną wyłącznie do inferencji, czy nadal komputerem do codziennej pracy. Ta aktualizacja daje powód, by sprawdzić tę różnicę, zamiast uznawać wyższą liczbę tokenów na sekundę za cały wynik.
Trzy ważne informacje: przykład z 64 GiB dotyczy konkretnych obsługiwanych plików Unsloth i podanej konfiguracji sprzętowej; aplikacja może zachować starszy budżet pozostawiający miejsce na pracę; utrzymywanie wag w pamięci i pomijanie ścieżek modelu to różne ustawienia.
Siedem dodatkowych GiB może oszczędzić zaskakująco dużo odczytów z SSD
Strata jest lokalnym środowiskiem wykonawczym modeli, które koordynuje zasoby komputera w celu uruchamiania obsługiwanych modeli. Po zmianie silnika opisanej w 0.2.16 nowa wersja aplikacji i Terminala ma numer 0.2.17. Silniki i moduł aktualizacji Control mają wersję 0.1.63. Dostępne są pliki do pobrania dla Windows, Linux, Mac i DGX Spark, ale obecność pakietu dla systemu operacyjnego nie oznacza, że każdy model i każda ścieżka wykonania działają na każdej maszynie.
Zmiana pamięci dotyczy plików Unsloth UD-Q4_K_XL i UD-IQ4_XS, gdy wszyscy ich eksperci nie mogą pozostać w RAM-ie. Nowa reguła konfiguracji odejmuje od całkowitej pamięci RAM 17 GiB oraz ewentualny strumieniowany bufor KV, określając, ile wag ekspertów zatrzymać w pamięci. Starsza reguła odejmowała 24 GiB. To budżet rezydencji dla konkretnej ścieżki wykonania, a nie obietnica, że w tej liczbie zmieszczą się cały model, bufor i system operacyjny.
Dlaczego kilka dodatkowych GiB może mieć tak duże znaczenie? Jeżeli potrzebna waga jest już w pamięci, środowisko wykonawcze nie musi ponownie pobierać jej z dysku. Wymagający prompt może korzystać z tej przewagi podczas wielu odwołań. Zależność jest więc bardziej złożona niż porównanie siedmiu GiB z rozmiarem jednego pliku wejściowego. Zależy też od ekspertów używanych przez obciążenie i od tego, co środowisko już zbuforowało.
Przykład opiekuna projektu wykorzystuje rzeczywisty limit pamięci 64 GiB, UD-Q4_K_XL, kartę RTX PRO 4500 Blackwell i prompt o długości około 65K tokenów. Tabela wydania podaje następujące wyniki. To pomiary projektu dla tej konfiguracji, a nie prognoza dla każdego komputera z 64GB.
| Budżet wag ekspertów utrzymywanych w pamięci | Odczyty z SSD dla wskazanego promptu | Tempo dekodowania | Podana wolna pamięć RAM | Program 8 GiB uruchomiony później |
|---|---|---|---|---|
| 40 GiB, starszy przykład | 97.7 GB | 57.7 tokena/s | 16.6 GiB | Działał dalej |
| 47 GiB, nowy przykład | 37.0 GB | 84.2 tokena/s | 9.3 GiB | Działał dalej |
| 52 GiB, dodatkowy test | 0.9 GB | 83.4–88.6 tokena/s | 6.6 GiB | Został zakończony |
Najciekawszy jest ostatni wiersz. Zmniejszenie ruchu dyskowego niemal do zera nie przyniosło równie radykalnego wzrostu tempa dekodowania, a inny program przestał działać. Tabela przemawia za budżetem dobranym pomiarowo, zamiast maksymalizowania ilości pamięci przeznaczonej na inferencję.
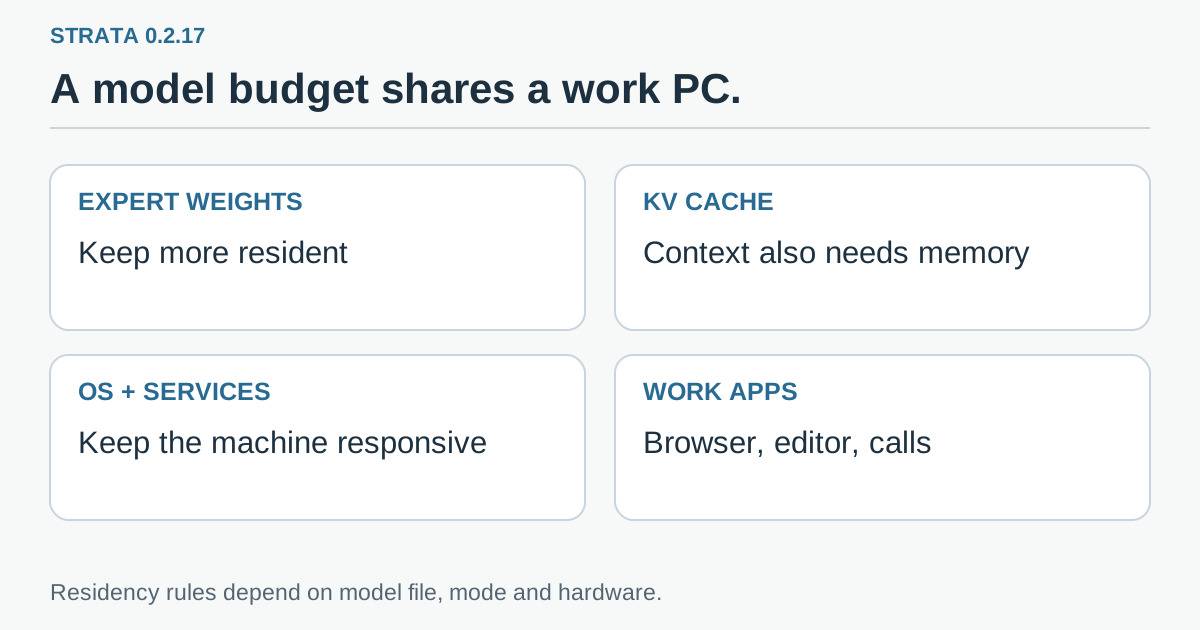 Autorska grafika wyjaśniająca: wagi ekspertów, zmieniający się bufor środowiska wykonawczego i codzienne aplikacje współdzielą pamięć maszyny. Reguła rezydencji z wydania dotyczy tylko wskazanych ścieżek modeli.
Rezerwa na pracę w aplikacji jest dobrym punktem wyjścia
Rozważmy przykładową stację roboczą programisty. W przeglądarce trwa długa sesja, IDE indeksuje repozytorium, a lokalny asystent przygotowuje odpowiedź na podstawie dużego dokumentu. Najszybsza w izolacji konfiguracja asystenta jest mniej przydatna, jeśli IDE zaczyna korzystać z pliku wymiany albo wideospotkanie traci stabilność. Właściwym punktem odniesienia jest cała sesja pracy.
Aplikacja Straty oferuje opcję „Leave 20% for my work”, czyli pozostawienie 20% na własną pracę. Zgodnie z opisem wydania zachowuje ona starszy budżet: 40 GiB w przykładzie z 64 GiB. Terminal, strata serve, Docker i tryb pełnej wydajności aplikacji używają nowego przydziału. Budżet podany przez użytkownika lub jawnie ustawiona rezerwa mają pierwszeństwo. Istniejące instalacje 0.2.16 mogą otrzymać jednorazową migrację budżetu przy pierwszej komendzie Straty po aktualizacji, bez osobnego ponawiania konfiguracji, chyba że użytkownik ustawił przydział samodzielnie.
Ta różnica ma znaczenie, gdy dwie osoby twierdzą, że testowały ustawienia domyślne. Jedna może korzystać z trybu rezerwy w aplikacji desktopowej, a druga uruchamiać serwer z Terminala. Ta sama wersja aplikacji może wtedy podejmować różne decyzje o utrzymywaniu wag w pamięci. Przed porównaniem zapisuj tryb uruchomienia razem z wersją.
Opis wydania wskazuje także wyjątki. Maszyny ze współdzieloną pamięcią CPU/GPU, takie jak Strix Halo, oraz ścieżka podziału warstw na dwie karty zachowują starszą rezerwę. Pozostałe wymienione pliki modeli — IQ2_XS, IQ3_XXS, IQ3_S i Q2_0 — nie otrzymują tego budżetu rezydencji w żadnej z obu wersji. Reguła pamięci skopiowana z jednego przykładu słabo zastępuje więc sprawdzenie dokładnej konfiguracji modelu.
W Windows nowy silnik dodatkowo ogranicza początkowy przydział do dostępnej wolnej pamięci pomniejszonej o 4.25 GiB. Obciążony komputer może zatem wystartować poniżej wskazywanych 47 GiB. Wydanie wyraźnie mówi, że tego zachowania Windows nie zmierzono w przykładzie. Zmienia też klasyfikację nominalnego komputera Windows z 64GB, gdy system zgłasza około 63.1 GiB. Te szczegóły pomagają zrozumieć inny zaobserwowany przydział; nie zamieniają opublikowanego testu w benchmark Windows.
Nasza praktyczna rada to rozpoczęcie od rezerwy na komputerze używanym interaktywnie. Sprawdź większy przydział w świadomym porównaniu przy działającym docelowym obciążeniu, zamiast zabierać pamięć aplikacjom zamkniętym wyłącznie na potrzeby testu.
Szybsze odpowiedzi i wierne wykonanie modelu potrzebują osobnych przełączników
Druga istotna zmiana dotyczy „Skip rarely used parts of the model”, czyli pomijania rzadko używanych części modelu: ustawienia w sekcji Expert, reprezentowanego przez STRATA_ROUTE_TAIL_SKIP. Nie jest to budżet RAM-u.
Opis wydania wyjaśnia, że w odpowiednim warunku routingu optymalizacja może pomijać pracę ekspertów, która normalnie zostałaby skopiowana i obliczona. Wcześniej działała domyślnie na ścieżkach NVIDIA i Radeon RX 9000. Opiekunowie projektu zmienili automatyczne zachowanie po zgłoszeniach o utracie jakości. W 0.2.17 jest wyłączona, o ile użytkownik nie włączył jej jawnie.
Istnieje ważna różnica między trzymaniem potrzebnej wagi bliżej procesora a rezygnacją z wykonania części pracy modelu. Pierwsze zmienia miejsce odczytu danych. Drugie zmienia obliczenia. Nawet gdy oba zwiększają przepustowość, ryzyka dla wyniku nie należy oceniać tak, jakby była to jedna technika.
W przykładzie opiekuna na RTX 5090 z UD-Q4_K_XL i DFlash2 pięć typów zapytań w dwóch rundach dało średnie tempo dekodowania 73.4 tokena/s przy wyłączonym pomijaniu ścieżek i 94.5 przy włączonym. Te same notatki obejmują pomiar rozbieżności przy wymuszonych tokenach. To porównanie konfiguracji opublikowane przez projekt, a nie ocena, czy powstałe odpowiedzi były użyteczne, bezpieczne lub poprawne w twojej aplikacji.
W codziennym użyciu aktualizacja może więc zmniejszyć przepustowość danej ścieżki, przywracając pełniejsze zachowanie routingu. To może być zamierzony rezultat. Jeśli sprawdzasz dokładne liczby, generujesz ustrukturyzowane wyniki lub wykonujesz trudną instrukcję, zachowanie pożądanego działania może być warte więcej niż szybszy strumień tekstu.
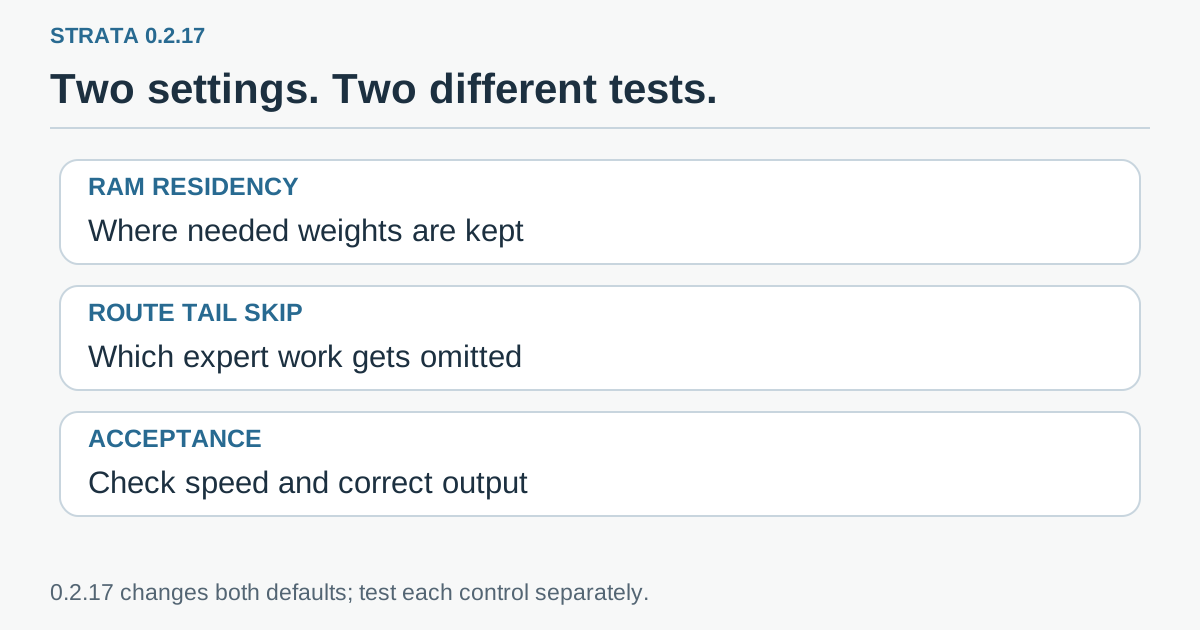 Autorska lista oceny: mierz presję na zasoby osobno od jakości odpowiedzi. Zmiana rezydencji pamięci i zmiana pomijania ścieżek to różne eksperymenty.
Własne ustawienia są częścią historii aktualizacji
Wartości automatyczne i jawne wybory nie migrują w ten sam sposób. Jeśli nigdy nie zmieniałeś ustawienia ścieżek albo korzystałeś z wartości automatycznej, nowe automatyczne zachowanie to wyłączenie. Jeśli jawnie wybrałeś rangę 7 lub inną, zgodnie z wydaniem wybór pozostaje. Jawnie ustawione zero nadal oznacza wyłączenie.
Chroni to świadomą konfigurację, ale oznacza również, że aktualizacja dwóch maszyn nie musi ujednolicić ich zachowania. Jedna może zachować wcześniejszy eksperyment włączony przez kogoś kilka miesięcy temu. Przed diagnozowaniem regresji sprawdź przeniesione ustawienia.
Wydanie dokumentuje strata launch --set STRATA_ROUTE_TAIL_SKIP=7 jako sposób włączenia zachowania rangi 7. Traktuj to jako dobrowolny eksperyment, a nie etap aktualizacji, który każdy powinien wykonać. Jeśli próbujesz rozwiązać problem niespójnych wyników, najpierw sprawdź, czy optymalizacja ścieżek jest wyłączona, zamiast włączać ją, by odzyskać wcześniejszą przepustowość.
W 0.2.17 zmieniają się też inne wartości domyślne, w tym zależne od sprzętu zmiany odczytu promptu i dekodowania. Niektóre mogą zmieniać generowany tekst. To kolejny powód, by nie zmieniać kilku ustawień naraz i nie przypisywać całej różnicy RAM-owi. Wersja, plik modelu, ścieżka sprzętowa i jawne nadpisania tworzą konfigurację, którą rzeczywiście przetestowano.
Porównuj z aplikacjami, które zamierzasz pozostawić otwarte
Użyteczny test nie wymaga laboratorium, ale potrzebuje powtarzalnego pytania. Dla komputera do pracy zapytaj, czy asystent kończy reprezentatywne zadanie, podczas gdy reszta maszyny pozostaje wygodna w użyciu. Dla dedykowanego serwera — czy wybrany budżet obsługuje planowane równoległe usługi bez błędów braku pamięci.
- Zapisz konfigurację początkową. Zanotuj wersje aplikacji i silnika, system operacyjny, RAM, GPU, dokładny plik modelu, tryb uruchomienia, wielkość kontekstu i jawne ustawienia pamięci lub ścieżek. Nie zmieniaj modelu ani kwantyzacji podczas porównania.
- Wybierz trzy reprezentatywne zadania. Na przykład krótkie pytanie, zapytanie do długiego dokumentu i ustrukturyzowaną ekstrakcję ze znanymi wymaganymi polami. To proponowane przypadki testowe, a nie zadania wykonane przez nas na potrzeby artykułu.
- Ustal punkt odniesienia z rezerwą na pracę. Pozostaw otwartą przeglądarkę, edytor i pozostałe codzienne aplikacje. Obserwuj wolną pamięć, aktywność dysku, opóźnienie pierwszej odpowiedzi, tempo generowania i responsywność tych programów.
- Zmień wyłącznie rezydencję. Porównaj przydział nastawiony na wydajność przy tym samym ustawieniu ścieżek. Obserwuj presję na pamięć w trakcie zadania i po późniejszym uruchomieniu innej zwykłej aplikacji.
- Oceń wynik. Sprawdź wymagane fakty, formatowanie, przestrzeganie instrukcji i spójność powtórzeń. Ekstrakcję poprawną składniowo, lecz pomijającą wymagany element, uznaj za niepowodzenie.
- W razie potrzeby osobno przetestuj pomijanie ścieżek. Zachowaj ustalony budżet rezydencji. Porównaj wyniki z przykładami odbiorczymi i zdecyduj, czy wzrost przepustowości jest wart zaobserwowanych zmian.
Dla długiego dokumentu zapisuj zarówno zimny start, jak i ponowione zapytanie. Buforowanie może sprawić, że drugi przebieg będzie zupełnie inny niż pierwszy. Nie mieszaj rozgrzanego wyniku jednej konfiguracji z pierwszym odczytem dokumentu w drugiej.
Zapisuj też niepowodzenia, zamiast ukrywać je w średnich. Szybka odpowiedź zakończona brakiem pamięci nie jest dobrym wynikiem dla usługi w tle. Nieprzerwana sesja edytora może być decydującym wynikiem dla laptopa do pracy, nawet gdy inne ustawienie wygrywa w kolumnie tempa dekodowania.
Lepsze ustawienie zostawia miejsce na twoją rzeczywistą pracę
Strata 0.2.17 sprawia, że lokalna inferencja przypomina mniej pojedynczy benchmark akceleratora, a bardziej zarządzanie małym współdzielonym komputerem. Pamięć jest wspólnym biurkiem: umieszczenie na nim większej ilości materiału modelu może ograniczyć wyprawy do dysku, ale praca nadal potrzebuje własnego miejsca.
Dla dedykowanej maszyny nowy przydział jest powodem, by zmierzyć, czy mniej odczytów poprawia obsługiwane obciążenie. Dla codziennej stacji roboczej rozsądnym początkiem jest rezerwa. W obu przypadkach zachowaj wierność wyników jako osobne kryterium odbioru. Szybsze ustawienie zasługuje na miejsce, gdy poprawia się całe zadanie, a nie tylko licznik tokenów.
Źródła i oficjalne materiały
- Strata 0.2.17 z 20 listopada 2026 roku: ustawienia, pomiary w określonych warunkach i zachowanie aktualizacji.
- Opis zmiany silnika w Strata 0.2.16.
- Oficjalna ilustracja interfejsu Straty. Link prowadzi do rzeczywistego produktu; dołączone grafiki są autorskimi wyjaśnieniami.
Powyższe pomiary są przypisane projektowi i zachowują jego warunki sprzętowe oraz modelowe. Procedura oceny jest propozycją działania dla czytelnika.
Rekomendacja Telli.sh: Przechowuj razem konfiguracje, reprezentatywne prompty i notatki porównawcze, aby kolejna aktualizacja zaczynała się od użytecznej podstawy. Utwórz pierwszą notatkę w Telli.sh.