Strata 0.2.17 vuole più RAM. Ha senso concedergliela sul PC di lavoro?
Il nuovo budget di memoria di Strata può ridurre le letture da SSD. Un’altra impostazione protegge la fedeltà delle risposte. Ecco come valutare entrambe sul PC di lavoro.
Un modello locale può rispondere più in fretta e, allo stesso tempo, rendere meno agevole l’uso del computer. Se sulla stessa macchina tieni aperti browser, editor e videochiamate, una prova utile deve tenere conto di entrambi gli effetti.
Strata 0.2.17, pubblicato il 20 novembre 2026, rende questo compromesso particolarmente visibile. Per determinati file di modello, i cui pesi degli esperti non possono restare tutti in RAM, la configurazione orientata alle prestazioni aumenta la quota residente. La versione disattiva anche un’altra ottimizzazione dopo le segnalazioni di utenti che avevano ottenuto risposte peggiori.
La domanda è se il tuo PC sia una macchina dedicata all’inferenza o il computer su cui continui a lavorare. L’aggiornamento offre un motivo per verificare questa distinzione, perché i token al secondo descrivono soltanto una parte dell’esperienza.
Tre aspetti da sapere: l’esempio con 64 GiB riguarda i file Unsloth supportati e una configurazione hardware precisa; l’app può mantenere il budget precedente per lasciare spazio alle altre attività; la residenza dei pesi e l’esclusione di alcuni percorsi del modello sono due impostazioni distinte.
Sette GiB in più possono risparmiare molte letture dall’SSD
Strata è un runtime per modelli locali. Coordina le risorse della macchina per eseguire i modelli compatibili. Dopo la transizione dei motori descritta per la 0.2.16, l’app e la versione per terminale passano alla 0.2.17. I motori e il programma di aggiornamento Control sono alla versione 0.1.63. Sono disponibili download per Windows, Linux, Mac e DGX Spark. I singoli modelli e le modalità di esecuzione hanno requisiti propri anche quando il sistema operativo è supportato.
La modifica riguarda i file Unsloth UD-Q4_K_XL e UD-IQ4_XS quando non è possibile mantenere tutti i pesi degli esperti in RAM. Per scegliere quanti pesi tenere in memoria, la nuova regola sottrae dal totale della RAM 17 GiB e l’eventuale cache KV trasferita in streaming. La regola precedente sottraeva 24 GiB. Il budget indica la memoria residente per uno specifico percorso di esecuzione. Modello, cache e sistema operativo hanno anche altre esigenze di memoria.
Perché può fare differenza qualche GiB in più? Quando un peso è già in memoria, il runtime può evitare di leggerlo di nuovo dall’unità di archiviazione. Una richiesta impegnativa può beneficiare di questa situazione nel corso di molti accessi. Per questo il rapporto tra RAM e letture è più complesso di un confronto tra sette GiB e la taglia di un singolo file. Contano anche gli esperti attivati durante il lavoro e ciò che il runtime ha già memorizzato nella cache.
Nell’esempio del manutentore, il limite effettivo è di 64 GiB. La prova usa UD-Q4_K_XL, una scheda RTX PRO 4500 Blackwell e un prompt di circa 65 mila token. La tabella della versione riporta i risultati seguenti. Sono misurazioni del progetto su quella configurazione e possono variare su altri computer con 64 GB.
| Budget residente per gli esperti | Letture da SSD per il prompt indicato | Velocità di generazione | RAM libera rilevata | Programma da 8 GiB avviato dopo |
|---|---|---|---|---|
| 40 GiB, esempio precedente | 97,7 GB | 57,7 token/s | 16,6 GiB | Ha continuato a funzionare |
| 47 GiB, nuovo esempio | 37,0 GB | 84,2 token/s | 9,3 GiB | Ha continuato a funzionare |
| 52 GiB, prova aggiuntiva | 0,9 GB | 83,4–88,6 token/s | 6,6 GiB | È stato terminato |
L’ultima riga merita attenzione. Con letture da SSD quasi azzerate, il miglioramento della velocità di generazione è stato molto più contenuto e un altro programma è stato terminato. La tabella aiuta a scegliere la quota da assegnare all’inferenza in base a ciò che riesce a funzionare insieme.
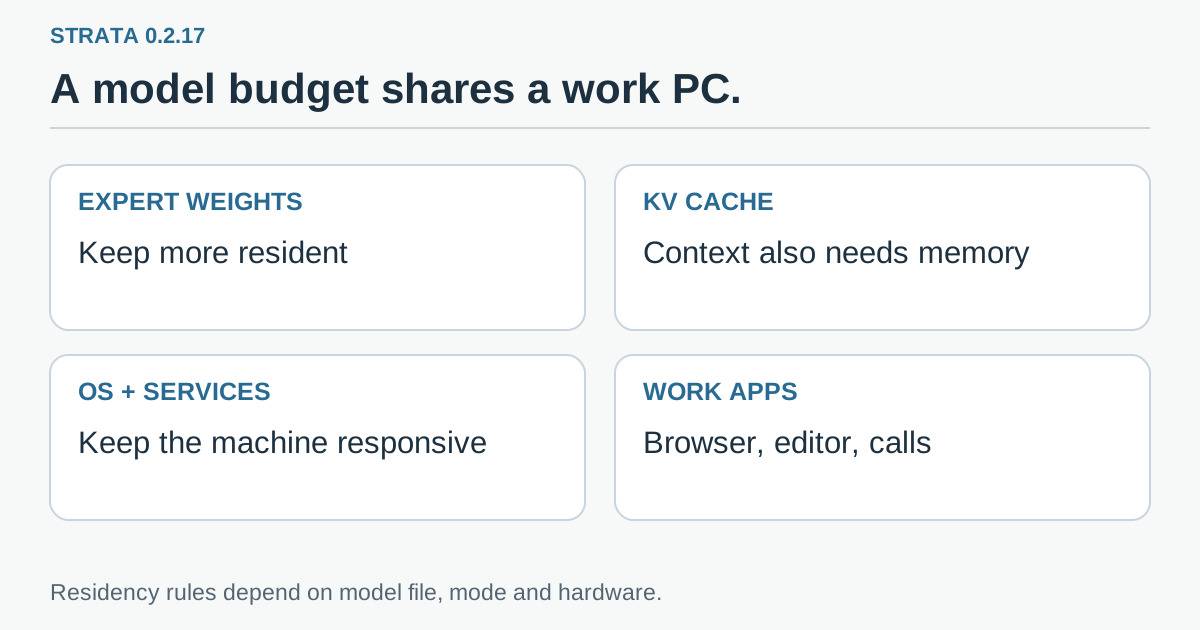 Grafica originale: i pesi degli esperti, la cache variabile del runtime e le applicazioni di tutti i giorni condividono la memoria della macchina. La regola della versione si applica alle modalità di esecuzione dei modelli indicati.
La riserva per lavorare è un buon punto di partenza
Prendiamo come esempio la postazione di uno sviluppatore. Ha una lunga sessione nel browser, un IDE che indicizza un repository e un assistente locale che prepara una risposta a partire da un documento voluminoso. La configurazione più veloce in una prova isolata è meno utile se l’IDE inizia a usare il disco come memoria o se la videochiamata diventa instabile. Per scegliere serve una prova dell’intera sessione di lavoro.
L’app Strata offre un’opzione chiamata “Leave 20% for my work”. Secondo le note della versione, mantiene il budget precedente: 40 GiB nell’esempio con 64 GiB. Terminale, strata serve, Docker e la modalità dell’app orientata alle prestazioni usano la nuova allocazione. Un budget esplicito o una riserva specificata dall’utente hanno la precedenza. Nelle installazioni 0.2.16, in assenza di un’allocazione impostata esplicitamente, la migrazione del budget può avvenire una sola volta al primo comando Strata dopo l’aggiornamento, senza ripetere la configurazione.
La distinzione conta quando due persone dicono di aver provato le impostazioni predefinite. Una potrebbe usare l’app desktop con la riserva per lavorare, mentre l’altra avvia il server dal terminale. Possono usare la stessa versione e avere quote residenti diverse. Prima di confrontare i risultati, annota anche la modalità di avvio.
Le note della versione descrivono alcune eccezioni. Le macchine con memoria condivisa tra CPU e GPU, come Strix Halo, e la ripartizione dei layer tra due schede conservano la riserva precedente. Gli altri file elencati, IQ2_XS, IQ3_XXS, IQ3_S e Q2_0, non usano questo budget di residenza in nessuna delle due versioni. Vale quindi la pena controllare la configurazione esatta del modello prima di applicare la regola di un esempio.
Su Windows il nuovo motore limita inoltre la richiesta iniziale alla RAM libera disponibile meno 4,25 GiB. Su una macchina già occupata la quota iniziale può quindi essere inferiore ai 47 GiB dell’esempio. Le note precisano che questo comportamento su Windows è rimasto fuori dalla prova. Cambia anche il modo in cui viene riconosciuta una macchina Windows da 64 GB nominali quando il sistema riporta circa 63,1 GiB. Questi dettagli possono spiegare perché il budget osservato è diverso e vanno letti separatamente dal benchmark pubblicato.
Su un computer che usi direttamente, comincia con l’opzione di riserva. Se vuoi provare la quota più alta, confrontala con quella iniziale mentre sono in esecuzione le attività abituali: chiudendo tutti gli altri programmi, misureresti una situazione diversa.
Velocità e fedeltà delle risposte hanno impostazioni separate
La seconda modifica riguarda “Skip rarely used parts of the model”, un’impostazione avanzata rappresentata da STRATA_ROUTE_TAIL_SKIP. Agisce su una parte diversa dal budget della RAM.
Secondo le note, quando ricorrono le condizioni di routing previste, l’ottimizzazione può saltare parte del lavoro degli esperti che altrimenti richiederebbe di copiare e calcolare dei dati. Prima era attiva per impostazione predefinita nei percorsi NVIDIA e Radeon RX 9000. I manutentori hanno cambiato il comportamento automatico dopo segnalazioni di cali di qualità. Nella 0.2.17 l’opzione resta disattivata finché l’utente non la abilita esplicitamente.
Conservare un peso necessario più vicino al processore cambia la posizione dei dati. Decidere di saltare una parte del lavoro cambia il calcolo effettuato. Entrambe le opzioni possono aumentare la velocità, con effetti sulle risposte da valutare separatamente.
Nell’esempio del manutentore su RTX 5090 con UD-Q4_K_XL e DFlash2, cinque tipi di richiesta in due turni hanno prodotto una media di 73,4 token/s a opzione disattivata e 94,5 token/s a opzione attiva. Nelle stesse note compare una misura della divergenza a token forzati. Il confronto del progetto mostra l’effetto delle configurazioni. Utilità, sicurezza e correttezza delle risposte per la tua applicazione richiedono riscontri specifici.
Dopo l’aggiornamento, un percorso può dunque generare testo più lentamente e tornare a eseguire il routing più esteso. Può essere proprio il risultato desiderato. Se devi controllare numeri esatti, produrre un output strutturato o seguire istruzioni complesse, il comportamento atteso può valere più della velocità con cui appaiono le parole.
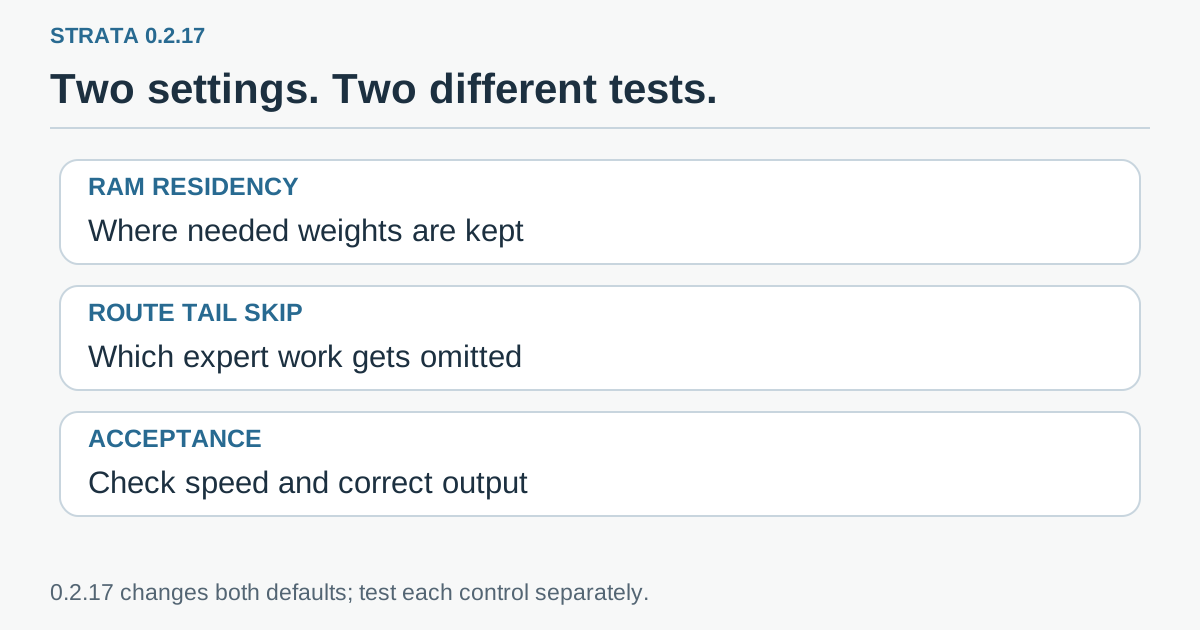 Grafica originale: misura la pressione sulle risorse separatamente dalla qualità delle risposte. Variare la residenza dei pesi e saltare parte del routing sono due prove diverse.
Le scelte personalizzate possono sopravvivere all’aggiornamento
Le impostazioni automatiche e le scelte esplicite seguono regole di migrazione diverse. Se non avevi modificato il routing o avevi selezionato il valore automatico, ora la funzione è disattivata. Le note precisano che un rango 7 o un altro rango impostato esplicitamente rimane valido. Anche un valore esplicito pari a zero rimane disattivato.
Questo tutela le configurazioni volute dall’utente. Allo stesso tempo, due macchine aggiornate possono comportarsi in modo diverso. Una potrebbe aver conservato un’impostazione sperimentale attivata mesi prima. Prima di attribuire un problema alla nuova versione, controlla quali impostazioni sono state mantenute.
Le note documentano strata launch --set STRATA_ROUTE_TAIL_SKIP=7 per attivare il comportamento con rango 7. È una prova facoltativa. Se stai cercando di risolvere risposte incoerenti, verifica prima che l’ottimizzazione del routing sia disattivata, invece di riattivarla per tornare a una velocità precedente.
La 0.2.17 modifica anche altre impostazioni predefinite, tra cui la lettura dei prompt e la generazione su determinati componenti hardware. Alcune modifiche possono cambiare il testo generato. Conviene quindi variare un’impostazione alla volta prima di attribuire alla RAM tutte le differenze. La configurazione effettivamente provata comprende la versione, il file del modello, il percorso hardware e le impostazioni esplicite.
Confronta le configurazioni con i programmi che tieni aperti
Una prova utile si può fare fuori da un laboratorio, purché la domanda sia ripetibile. Per un PC di lavoro, osserva se l’assistente completa un’attività rappresentativa mentre il resto della macchina resta utilizzabile. Per un server dedicato, verifica se il budget sostiene i servizi previsti in contemporanea senza esaurire la memoria.
- Annota la configurazione iniziale. Registra le versioni di app e motore, il sistema operativo, la RAM, la GPU, il file preciso del modello, la modalità di avvio, la dimensione del contesto e le eventuali impostazioni di memoria o di routing. Usa lo stesso modello e la stessa quantizzazione per tutto il confronto.
- Scegli tre attività rappresentative. Per esempio una domanda breve, una richiesta su un documento lungo e un’estrazione strutturata con campi obbligatori noti. Sono esempi di prova suggeriti al lettore. Non sono stati eseguiti per l’articolo.
- Misura le prestazioni con la riserva attiva. Lascia aperti browser, editor e altri programmi abituali. Osserva la memoria libera, l’attività del disco, il tempo di attesa della prima risposta, la velocità di generazione e la reattività delle altre applicazioni.
- Cambia solo la quota residente. Prova l’allocazione orientata alle prestazioni con lo stesso routing. Controlla la pressione sulla memoria durante l’attività e quando avvii successivamente un altro programma che usi di solito.
- Valuta i risultati. Controlla i fatti richiesti, la formattazione, il rispetto delle istruzioni e la coerenza tra le prove. Un’estrazione formalmente valida che omette un campo obbligatorio va registrata come fallimento.
- Se ti serve, prova separatamente l’esclusione dei percorsi. Mantieni invariata la quota residente scelta. Confronta le risposte con gli esempi che soddisfano i tuoi criteri e valuta se l’aumento di velocità ripaga le differenze osservate.
Per un documento lungo, registra sia il primo avvio a freddo sia una richiesta ripetuta. La cache può dare un risultato diverso alla seconda esecuzione. Confronta prove a freddo con prove a freddo e richieste ripetute con richieste ripetute.
Registra anche i fallimenti: una risposta veloce seguita dall’esaurimento della memoria può rendere inaffidabile un servizio in background. Su un portatile di lavoro può essere decisivo poter continuare a usare l’editor, anche quando nell’altra modalità la generazione è più rapida.
L’impostazione migliore lascia spazio al lavoro che fai davvero
Strata 0.2.17 invita a valutare l’inferenza locale come un’attività eseguita su un computer condiviso. La memoria è una scrivania comune. Tenerci a portata di mano più parti del modello può risparmiare letture dal disco e occupa anche parte dello spazio che serve alle altre attività.
Su una macchina dedicata, il nuovo budget permette di misurare se le minori letture migliorano il carico di lavoro servito. Su una postazione di tutti i giorni, la riserva è un buon punto di partenza. In entrambi i casi verifica la fedeltà delle risposte a parte. Una configurazione più veloce è utile quando aiuta a portare a termine l’attività nel suo insieme.
Fonti e materiali ufficiali
- Strata 0.2.17, 20 novembre 2026: impostazioni, condizioni delle prove e aggiornamento.
- Note sulla transizione dei motori in Strata 0.2.16.
- Illustrazione ufficiale dell’interfaccia Strata. Il link mostra il prodotto. Le grafiche dell’articolo sono originali.
Le misurazioni sono attribuite al progetto e riportano le condizioni del modello e dell’hardware. La procedura di confronto è un esempio per i lettori.
Suggerimento Telli.sh: conserva configurazioni, prompt rappresentativi e appunti delle prove nello stesso posto. Al prossimo aggiornamento avrai già un riferimento. Crea la tua prima nota con Telli.sh.