Strata 0.2.17 veut davantage de RAM. Faut-il lui en laisser sur votre PC de travail ?
Le nouveau budget mémoire de Strata peut réduire les accès au SSD, tandis qu'un autre réglage par défaut protège la fidélité des réponses. Comment choisir sur un PC partagé et tester ce compromis.
Un modèle local peut répondre plus vite tout en rendant le reste de l'ordinateur moins agréable à utiliser. Sur une machine qui fait aussi tourner votre navigateur, votre éditeur et vos visioconférences, ces deux résultats doivent figurer dans le même test.
Strata 0.2.17, publié le 20 novembre 2026, rend ce compromis particulièrement visible. Pour certains fichiers de modèles dont les poids des experts ne tiennent pas tous en RAM, sa configuration orientée performances augmente l'allocation résidente. La version désactive aussi une optimisation distincte après des signalements de réponses dégradées.
La question utile est de savoir si votre PC est dédié à l'inférence ou s'il reste votre ordinateur de travail. Cette mise à jour donne une bonne raison de tester cette différence, plutôt que de réduire le résultat à un nombre supérieur de tokens par seconde.
Trois points à retenir : l'exemple à 64 GiB concerne des fichiers Unsloth pris en charge et une configuration matérielle précise ; l'application peut conserver l'ancien budget adapté au travail quotidien ; et la résidence en mémoire et l'omission de routes du modèle sont deux commandes différentes.
Sept GiB de plus peuvent éviter beaucoup de lectures sur SSD
Strata est un moteur d'exécution local qui coordonne les ressources de la machine pour faire fonctionner les modèles pris en charge. Après la transition de moteur décrite dans la version 0.2.16, l'application et la version Terminal passent à 0.2.17. Les moteurs et l'outil de mise à jour Control sont en version 0.1.63. Des téléchargements sont proposés pour Windows, Linux, Mac et DGX Spark, mais la disponibilité pour un système d'exploitation ne signifie pas que tous les modèles et chemins d'exécution fonctionnent sur chaque machine.
Le changement mémoire concerne les fichiers Unsloth UD-Q4_K_XL et UD-IQ4_XS lorsque leurs experts ne peuvent pas tous rester en RAM. Pour déterminer combien de poids des experts conserver, la nouvelle règle soustrait 17 GiB et tout cache KV diffusé depuis le stockage à la RAM totale. L'ancienne règle soustrayait 24 GiB. Il s'agit d'un budget de résidence pour un chemin d'exécution précis, pas de la garantie que le modèle entier, le cache et le système d'exploitation tiendront dans cette quantité.
Pourquoi quelques GiB supplémentaires comptent-ils ? Si un poids nécessaire se trouve déjà en mémoire, le moteur évite de le récupérer à nouveau sur le stockage. Une requête exigeante peut bénéficier de cet avantage lors de nombreux accès. Le rapport est donc plus complexe qu'une comparaison entre sept GiB et la taille d'un fichier d'entrée. Il dépend aussi des experts sollicités par la tâche et des données déjà mises en cache.
L'exemple du mainteneur utilise une limite mémoire réelle de 64 GiB, UD-Q4_K_XL, une carte RTX PRO 4500 Blackwell et une requête d'environ 65K tokens. Le tableau de la version présente les résultats suivants. Ce sont les mesures du projet pour cette configuration, pas une prévision pour tous les ordinateurs de 64GB.
| Budget des experts résidents | Lectures SSD pour la requête indiquée | Débit de décodage | RAM libre annoncée | Programme de 8 GiB lancé ensuite |
|---|---|---|---|---|
| 40 GiB, ancien exemple | 97.7 GB | 57.7 tokens/s | 16.6 GiB | A continué à fonctionner |
| 47 GiB, nouvel exemple | 37.0 GB | 84.2 tokens/s | 9.3 GiB | A continué à fonctionner |
| 52 GiB, essai supplémentaire | 0.9 GB | 83.4–88.6 tokens/s | 6.6 GiB | A été arrêté de force |
La dernière ligne est la plus intéressante. Ramener presque à zéro les accès au stockage n'a pas produit une hausse aussi spectaculaire du débit de décodage, et un autre programme a échoué. Le tableau plaide pour un budget mesuré, plutôt que pour l'attribution du maximum de mémoire à l'inférence.
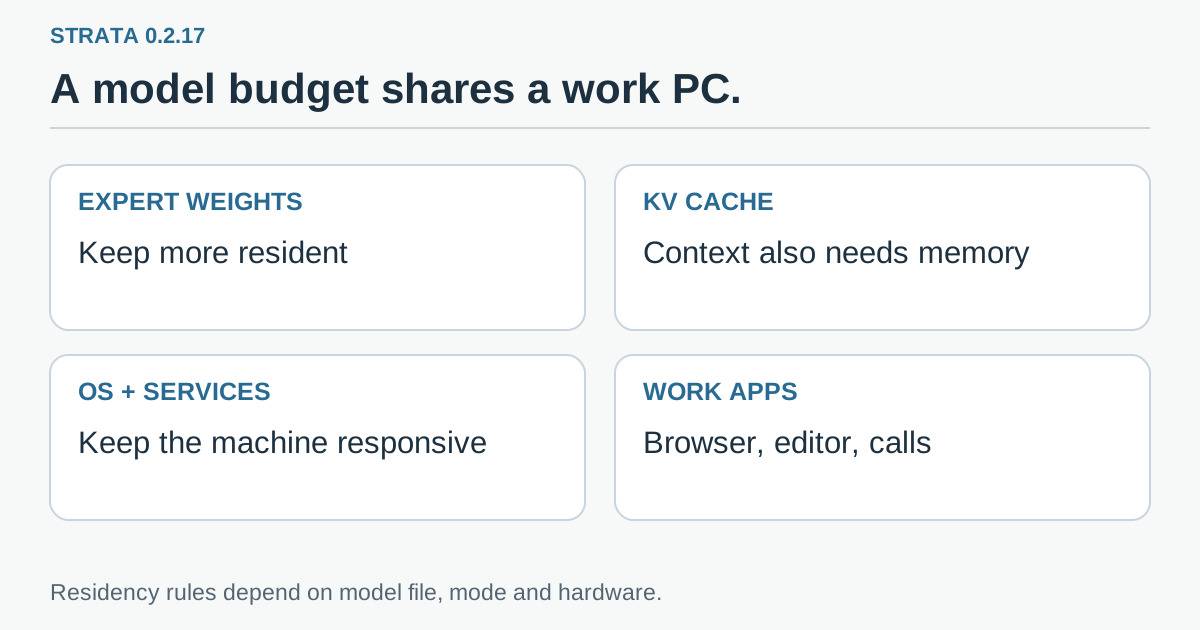 Schéma explicatif original : les poids des experts, le cache variable du moteur et les applications quotidiennes se partagent la mémoire. La règle de résidence de cette version concerne uniquement les chemins de modèles indiqués.
La réserve pour le travail est un bon point de départ
Prenons un poste de développement à titre d'exemple. Une longue session de navigateur est ouverte, l'IDE indexe un dépôt et un assistant local prépare une réponse à partir d'un document volumineux. La configuration isolée la plus rapide de l'assistant perd de son intérêt si l'IDE commence à utiliser intensément le fichier d'échange ou si une visioconférence devient instable. La bonne référence est la session de travail complète.
L'application Strata propose l'option « Leave 20% for my work ». Selon les notes de version, elle conserve l'ancien budget : 40 GiB dans l'exemple à 64 GiB. Le Terminal, strata serve, Docker et le mode performances maximales de l'application utilisent la nouvelle allocation. Un budget défini par l'utilisateur ou une réserve explicite est prioritaire. Après la mise à jour, les installations 0.2.16 existantes peuvent recevoir cette migration unique du budget dès la première commande Strata, sans nouvelle configuration séparée, sauf si l'utilisateur avait fixé l'allocation explicitement.
Cette différence compte lorsque deux personnes disent avoir testé les réglages par défaut. L'une peut utiliser le mode de réserve du bureau, l'autre démarrer un serveur depuis le Terminal. Une même version d'application peut donc prendre des décisions de résidence différentes. Notez le mode de lancement avec la version avant de comparer les résultats.
La version décrit aussi des exceptions. Les machines à mémoire CPU/GPU partagée, comme Strix Halo, et le chemin qui répartit les couches sur deux cartes conservent l'ancienne réserve. Les autres fichiers cités — IQ2_XS, IQ3_XXS, IQ3_S et Q2_0 — ne reçoivent ce budget de résidence dans aucune des deux versions. Copier la règle mémoire d'un exemple ne remplace donc pas la vérification de la configuration exacte du modèle.
Sous Windows, le nouveau moteur limite en outre son allocation initiale à la mémoire libre disponible moins 4.25 GiB. Une machine déjà occupée peut donc démarrer en dessous des 47 GiB annoncés. Les notes précisent que ce comportement Windows n'a pas été mesuré dans l'exemple. Elles ajustent également le classement d'une machine Windows vendue avec 64GB lorsque le système indique environ 63.1 GiB. Ces détails expliquent une allocation observée différente ; ils ne transforment pas l'essai publié en test Windows.
Notre recommandation pratique est de commencer par l'option de réserve sur un ordinateur utilisé de façon interactive. Essayez ensuite l'allocation supérieure dans une comparaison volontaire, avec votre charge de travail réelle, plutôt qu'en empruntant la mémoire d'applications fermées pour les besoins du test.
La vitesse et la fidélité des réponses ont besoin de réglages distincts
Le deuxième changement important concerne « Skip rarely used parts of the model », un réglage Expert représenté par STRATA_ROUTE_TAIL_SKIP. Ce n'est pas le budget RAM.
Les notes expliquent que, dans la condition de routage concernée, cette optimisation peut omettre du travail des experts qui serait autrement copié et calculé. Elle était auparavant active par défaut sur les chemins NVIDIA et Radeon RX 9000. Les mainteneurs ont changé le comportement automatique après des signalements de perte de qualité. Dans 0.2.17, elle est désactivée sauf activation explicite par l'utilisateur.
Conserver un poids nécessaire plus près du processeur et choisir de ne pas effectuer une partie du travail du modèle sont deux démarches très différentes. La première change l'endroit où l'on trouve les données. La seconde modifie le calcul. Même si les deux améliorent le débit, leurs risques pour les réponses ne doivent pas être évalués comme une seule et même technique.
Dans l'exemple du mainteneur sur RTX 5090 avec UD-Q4_K_XL et DFlash2, cinq types de requêtes sur deux séries ont donné des débits moyens de 73.4 tokens/s sans omission de routes et de 94.5 avec cette omission. Les mêmes notes présentent une mesure de divergence à tokens imposés. C'est une comparaison de configurations publiée par le projet, pas une évaluation de l'utilité, de la sûreté ou de l'exactitude des réponses dans votre application.
En pratique, une mise à jour peut donc réduire le débit sur un chemin donné tout en rétablissant un routage plus complet. Cela peut être le résultat recherché. Si vous vérifiez des nombres précis, produisez des données structurées ou suivez des consignes difficiles, préserver le comportement attendu peut valoir davantage qu'un flux de texte plus rapide.
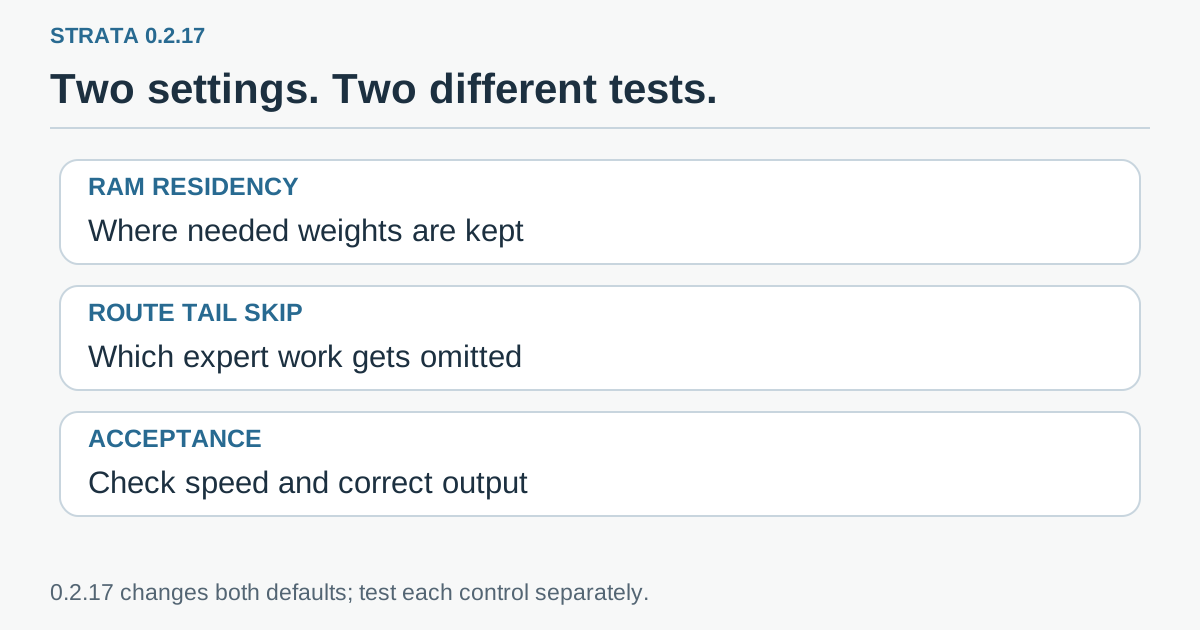 Liste d'évaluation originale : mesurez séparément la pression sur les ressources et la qualité des réponses. Modifier la résidence mémoire et modifier l'omission de routes sont deux expériences distinctes.
Les réglages personnalisés font partie de l'historique de mise à jour
Les valeurs automatiques et les choix explicites ne migrent pas de la même manière. Si vous n'avez jamais changé le réglage de routage, ou si vous utilisiez sa valeur automatique, le nouveau comportement automatique est désactivé. Si vous aviez explicitement choisi le rang 7 ou un autre rang, les notes indiquent que ce choix est conservé. Un zéro explicite reste désactivé.
Cela préserve une configuration volontaire, mais signifie aussi que mettre deux machines à jour ne rend pas nécessairement leur comportement identique. L'une peut conserver un ancien essai activé plusieurs mois auparavant. Avant de diagnostiquer une régression, vérifiez les paramètres hérités.
Les notes documentent strata launch --set STRATA_ROUTE_TAIL_SKIP=7 pour activer le comportement de rang 7. Considérez-le comme une expérience volontaire, pas comme une étape de mise à jour à effectuer systématiquement. Si vous cherchez à résoudre des réponses incohérentes, vérifiez d'abord que l'optimisation de routage est désactivée au lieu de la réactiver pour retrouver un ancien débit.
La version 0.2.17 comporte d'autres valeurs par défaut, notamment des changements de lecture des requêtes et de décodage propres au matériel. Certaines peuvent modifier le texte produit. C'est une raison supplémentaire de ne pas changer plusieurs paramètres à la fois en attribuant toute la différence à la RAM. La version, le fichier du modèle, le chemin matériel et les substitutions explicites constituent la configuration réellement testée.
Comparez en gardant ouvertes les applications que vous voulez utiliser
Un test utile n'exige pas de laboratoire, mais exige une question reproductible. Sur un PC de travail, demandez-vous si l'assistant termine une tâche représentative tout en laissant la machine utilisable. Sur un serveur dédié, vérifiez si le budget choisi permet aux services simultanés prévus de fonctionner sans échec mémoire.
- Notez la configuration de départ. Relevez les versions de l'application et du moteur, le système, la RAM, le GPU, le fichier exact du modèle, le mode de lancement, la taille du contexte et les paramètres explicites de mémoire ou de routage. Gardez le modèle et la quantification identiques pendant la comparaison.
- Choisissez trois tâches représentatives. Par exemple : une question courte, une demande sur un long document et une extraction structurée avec des champs obligatoires connus. Ce sont des cas suggérés, pas des tâches exécutées pour cet article.
- Établissez la référence avec réserve de travail. Laissez ouverts le navigateur, l'éditeur et les applications habituelles. Observez la mémoire libre, l'activité du stockage, le délai de première réponse, le débit de génération et la réactivité des autres applications.
- Ne changez que la résidence. Comparez l'allocation orientée performances avec le même réglage de routage. Surveillez la pression mémoire pendant la tâche et lorsqu'une autre application habituelle démarre ensuite.
- Évaluez les réponses. Vérifiez les faits requis, le format, le respect des consignes et la cohérence entre répétitions. Une extraction syntaxiquement valide qui omet un élément obligatoire doit être comptée comme un échec.
- Testez séparément l'omission de routes si nécessaire. Gardez le budget de résidence choisi. Comparez les résultats à vos exemples d'acceptation, puis décidez si le gain de débit justifie les changements observés.
Pour un long document, notez un démarrage à froid et une requête répétée. Le cache peut rendre la deuxième exécution très différente de la première. Ne comparez pas le résultat à chaud d'une configuration avec la première lecture du document dans une autre.
Notez également les échecs au lieu de les faire disparaître dans les moyennes. Une réponse rapide suivie d'un manque de mémoire n'est pas un bon résultat pour un service en arrière-plan. Une session d'édition ininterrompue peut être décisive sur un portable de travail, même si un autre réglage gagne dans la colonne du débit de décodage.
Le meilleur réglage laisse de la place à votre vrai travail
Strata 0.2.17 rapproche l'inférence locale de la gestion d'un petit ordinateur partagé, plutôt que d'un simple test d'accélérateur. La mémoire est un bureau commun : y déposer plus de données du modèle peut réduire les allers-retours vers le stockage, mais il faut encore de la place pour travailler.
Sur une machine dédiée, la nouvelle allocation donne une raison de mesurer si la réduction des lectures améliore votre charge. Sur un poste quotidien, la réserve est un point de départ raisonnable. Dans les deux cas, gardez la fidélité des réponses comme critère d'acceptation distinct. Un réglage plus rapide mérite sa place lorsque la tâche complète — et pas seulement le compteur de tokens — s'améliore.
Sources et médias officiels
- Version Strata 0.2.17 du 20 novembre 2026 : réglages, mesures contextualisées et comportement de mise à jour.
- Notes de transition du moteur Strata 0.2.16.
- Illustration officielle de l'interface Strata. Ce lien montre le sujet réel ; les graphiques fournis sont des explications originales.
Les mesures ci-dessus sont attribuées au projet et conservent leurs conditions matérielles et de modèle. La procédure d'évaluation est une méthode suggérée aux lecteurs.
Recommandation Telli.sh : Conservez ensemble configurations, requêtes représentatives et notes de comparaison pour disposer d'une référence utile à la prochaine mise à jour. Créez votre première note avec Telli.sh.