Strata 0.2.17 quiere más RAM. ¿Debería cedérsela tu PC de trabajo?
El nuevo presupuesto de memoria de Strata puede reducir las lecturas del SSD, mientras otro ajuste protege la fidelidad de las respuestas. Qué opción conviene en un PC compartido y cómo evaluar el equilibrio.
Un modelo local puede responder más rápido y hacer que el resto del ordenador resulte menos cómodo de usar. En una máquina que también ejecuta el navegador, el editor y las videollamadas, ambos resultados deben formar parte de la misma prueba.
Strata 0.2.17, publicado el 20 de noviembre de 2026, hace especialmente visible ese equilibrio. Para determinados archivos de modelos cuyos pesos de expertos no caben íntegramente en RAM, su configuración orientada al rendimiento aumenta la asignación residente. La versión también desactiva una optimización independiente después de que los usuarios notificaran respuestas de peor calidad.
La pregunta útil es si tu PC está dedicado a la inferencia o sigue siendo tu ordenador de trabajo. Esta actualización invita a comprobar esa diferencia, en vez de aceptar una cifra superior de tokens por segundo como resultado completo.
Tres cosas que conviene saber: el ejemplo de 64 GiB corresponde a archivos Unsloth compatibles y a una configuración concreta; la aplicación puede mantener el presupuesto anterior pensado para trabajar; y la residencia en memoria y la omisión de rutas del modelo son controles distintos.
Siete GiB más pueden ahorrar muchas lecturas del SSD
Strata es un entorno de ejecución local que coordina los recursos de la máquina para ejecutar modelos compatibles. Tras la transición de motor descrita en 0.2.16, la aplicación y la versión Terminal pasan a 0.2.17. Sus motores y el actualizador Control están en la versión 0.1.63. Se ofrecen descargas para Windows, Linux, Mac y DGX Spark, aunque disponer de una descarga para un sistema operativo no significa que todos los modelos y modos de ejecución funcionen en cualquier máquina.
El cambio de memoria afecta a los archivos Unsloth UD-Q4_K_XL y UD-IQ4_XS cuando todos sus expertos no pueden permanecer en RAM. La nueva regla resta 17 GiB y cualquier caché KV que se lea de forma continua desde el almacenamiento de la RAM total para decidir cuántos pesos de expertos conservar. La regla anterior restaba 24 GiB. Es un presupuesto de residencia para una vía de ejecución concreta, no una promesa de que el modelo completo, la caché y el sistema operativo quepan en esa cantidad.
¿Por qué pueden importar unos pocos GiB adicionales? Si un peso necesario ya está en memoria, el entorno evita recuperarlo de nuevo del almacenamiento. Una petición exigente puede aprovechar esta ventaja en numerosos accesos. La relación es, por tanto, más compleja que comparar siete GiB con el tamaño de un archivo de entrada. También depende de los expertos utilizados por la carga y de lo que ya se haya almacenado en caché.
El ejemplo del mantenedor utiliza un límite real de memoria de 64 GiB, UD-Q4_K_XL, una tarjeta RTX PRO 4500 Blackwell y una petición de unos 65K tokens. La tabla de la versión presenta los siguientes resultados. Son mediciones del proyecto para esa configuración, no una previsión para todos los ordenadores con 64GB.
| Presupuesto de expertos residentes | Lecturas del SSD para la petición indicada | Velocidad de decodificación | RAM libre indicada | Programa de 8 GiB iniciado después |
|---|---|---|---|---|
| 40 GiB, ejemplo anterior | 97.7 GB | 57.7 tokens/s | 16.6 GiB | Siguió funcionando |
| 47 GiB, nuevo ejemplo | 37.0 GB | 84.2 tokens/s | 9.3 GiB | Siguió funcionando |
| 52 GiB, prueba adicional | 0.9 GB | 83.4–88.6 tokens/s | 6.6 GiB | Fue terminado por el sistema |
La última fila es la interesante. Reducir casi a cero el tráfico de almacenamiento no produjo un aumento igual de espectacular en la velocidad de decodificación, y otro programa falló. La tabla respalda un presupuesto medido, en lugar de asignar la máxima memoria posible a la inferencia.
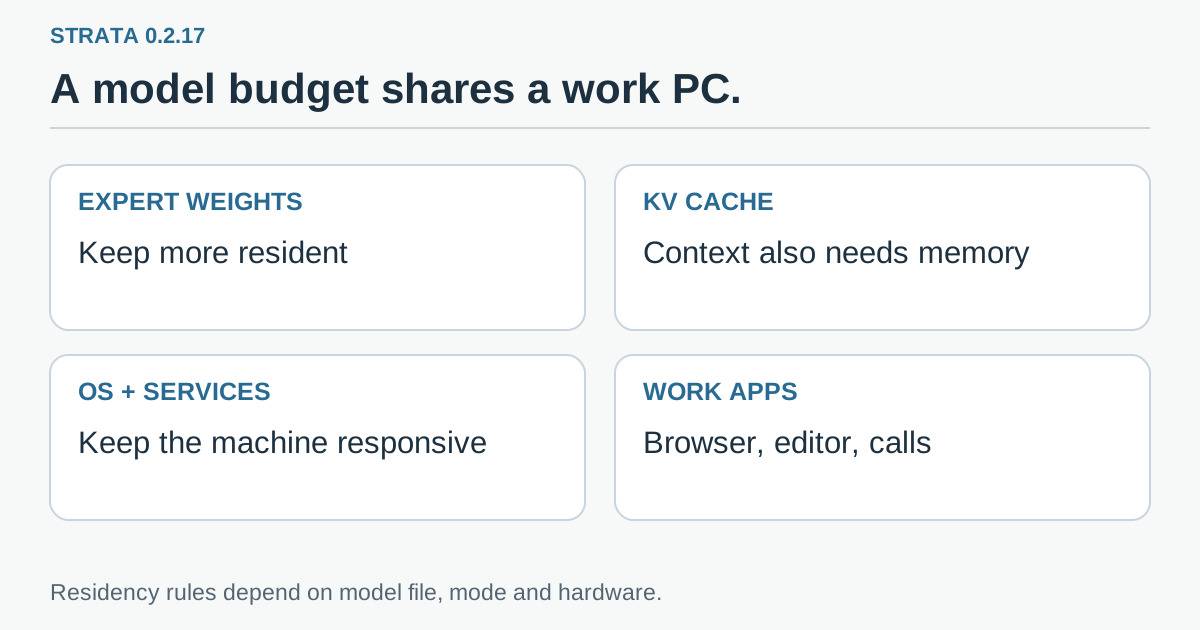 Gráfico explicativo original: los pesos de expertos, la caché variable del entorno y las aplicaciones habituales comparten la memoria. La regla de residencia de la versión solo se aplica a las configuraciones de modelo indicadas.
Reservar memoria para trabajar es un buen punto de partida
Pensemos en una estación de desarrollo a modo de ejemplo. Tiene una larga sesión de navegador, un IDE que indexa un repositorio y un asistente local que prepara una respuesta a partir de un documento extenso. La configuración aislada más rápida del asistente resulta menos útil si el IDE empieza a usar intensamente la memoria de intercambio o si una videollamada pierde estabilidad. La referencia adecuada es la sesión de trabajo completa.
La aplicación Strata ofrece una opción llamada «Leave 20% for my work». Según las notas, mantiene el presupuesto anterior: 40 GiB en el ejemplo de 64 GiB. Terminal, strata serve, Docker y el modo de máximo rendimiento de la aplicación utilizan la nueva asignación. Un presupuesto o una reserva definidos explícitamente por el usuario tienen prioridad. Las instalaciones 0.2.16 existentes pueden recibir la migración única del presupuesto con el primer comando Strata tras actualizar, sin repetir la configuración por separado, salvo que el usuario haya fijado expresamente la asignación.
La diferencia importa cuando dos personas dicen haber probado los valores predeterminados. Una puede usar el modo de reserva de la aplicación de escritorio y la otra iniciar un servidor desde Terminal. Pueden ejecutar la misma versión con decisiones distintas de residencia. Anota el modo de inicio junto con la versión antes de comparar resultados.
La versión también describe excepciones. Las máquinas con memoria CPU/GPU compartida, como Strix Halo, y la vía que divide capas entre dos tarjetas conservan la reserva anterior. Los demás archivos citados —IQ2_XS, IQ3_XXS, IQ3_S y Q2_0— no reciben este presupuesto de residencia en ninguna de las dos versiones. Copiar la regla de un ejemplo no sustituye la comprobación del modelo exacto.
En Windows, el nuevo motor también limita su asignación inicial a la memoria libre disponible menos 4.25 GiB. Una máquina ocupada puede arrancar por debajo de la asignación anunciada de 47 GiB. Las notas aclaran que este comportamiento de Windows no se midió en el ejemplo. También ajustan la clasificación de un equipo Windows nominalmente de 64GB cuando el sistema informa de unos 63.1 GiB. Estos detalles ayudan a entender una asignación observada diferente; no convierten la prueba publicada en un benchmark de Windows.
Nuestra recomendación práctica es empezar por la reserva en un ordenador de uso interactivo. Prueba la asignación mayor como comparación deliberada con la carga prevista en marcha, en lugar de aprovechar la memoria de aplicaciones que has cerrado solo para hacer la prueba.
Las respuestas rápidas y las respuestas fieles necesitan ajustes separados
El segundo cambio importante afecta a «Skip rarely used parts of the model», un ajuste Expert representado por STRATA_ROUTE_TAIL_SKIP. No es el presupuesto de RAM.
Las notas explican que, bajo la condición de enrutamiento correspondiente, la optimización puede omitir trabajo de expertos que de otro modo se copiaría y calcularía. Antes funcionaba de forma predeterminada en las vías NVIDIA y Radeon RX 9000. Los mantenedores cambiaron el comportamiento automático tras recibir informes de pérdida de calidad. En 0.2.17 está desactivada salvo que el usuario la haya activado explícitamente.
Hay una diferencia importante entre mantener un peso necesario más cerca del procesador y decidir no realizar parte del trabajo del modelo. Lo primero cambia dónde se encuentran los datos. Lo segundo cambia el cálculo. Aunque ambas técnicas mejoren el rendimiento, sus riesgos para las respuestas no deben evaluarse como si fueran lo mismo.
En el ejemplo del mantenedor con RTX 5090, UD-Q4_K_XL y DFlash2, cinco tipos de petición durante dos rondas produjeron velocidades medias de 73.4 tokens/s con la omisión desactivada y de 94.5 con ella activada. Las mismas notas incluyen una medida de divergencia con tokens forzados. Es una comparación de configuraciones publicada por el proyecto, no una puntuación sobre la utilidad, seguridad o corrección de las respuestas en tu aplicación.
La consecuencia cotidiana es que actualizar puede reducir el rendimiento de una vía concreta mientras restablece un enrutamiento más completo. Ese puede ser el resultado buscado. Si necesitas comprobar cifras exactas, generar resultados estructurados o seguir una instrucción difícil, conservar el comportamiento deseado puede valer más que recibir texto a mayor velocidad.
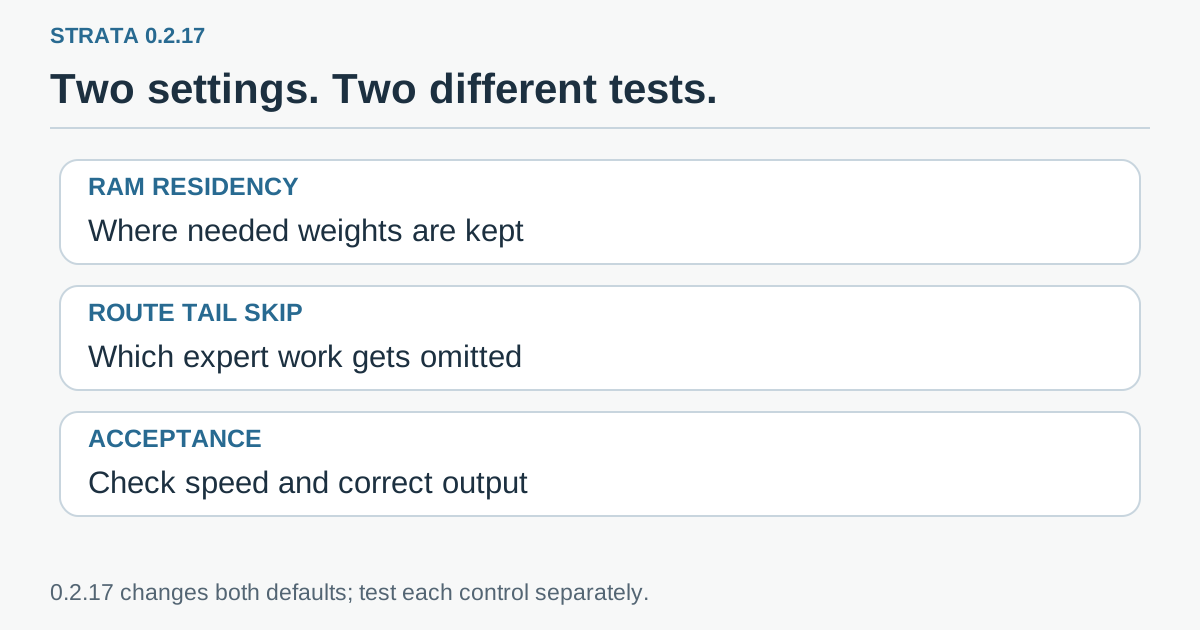 Lista de evaluación original: mide la presión sobre los recursos por separado de la calidad de las respuestas. Cambiar la residencia en memoria y cambiar la omisión de rutas son experimentos distintos.
Los ajustes personalizados forman parte del historial de actualización
Los valores automáticos y las selecciones explícitas no migran de la misma manera. Si nunca cambiaste el ajuste de rutas, o utilizabas su valor automático, el nuevo comportamiento automático queda desactivado. Si elegiste explícitamente el rango 7 u otro rango, las notas dicen que esa elección se conserva. Un cero explícito sigue desactivado.
Esto protege una configuración deliberada, pero también significa que actualizar dos máquinas no hace necesariamente que se comporten igual. Una puede conservar un experimento antiguo activado hace meses. Antes de diagnosticar una regresión, comprueba qué ajustes se han mantenido.
La versión documenta strata launch --set STRATA_ROUTE_TAIL_SKIP=7 como forma de activar el comportamiento de rango 7. Trátalo como un experimento voluntario, no como un paso de actualización que todo el mundo deba ejecutar. Si intentas resolver respuestas inconsistentes, comprueba primero que la optimización esté desactivada, en vez de activarla para recuperar una cifra antigua de rendimiento.
En 0.2.17 hay otros valores predeterminados, incluidos cambios en la lectura de peticiones y la decodificación que dependen del hardware. Algunos pueden alterar el texto generado. Es otra razón para no cambiar varios ajustes a la vez y atribuir toda la diferencia a la RAM. La versión, el archivo del modelo, la vía de hardware y las anulaciones explícitas forman la configuración que realmente probaste.
Compara con las aplicaciones que piensas mantener abiertas
Una prueba útil no necesita laboratorio, pero sí una pregunta repetible. En un PC de trabajo, pregunta si el asistente completa una tarea representativa mientras el resto del equipo sigue siendo utilizable. En un servidor dedicado, comprueba si el presupuesto elegido admite los servicios simultáneos previstos sin fallos de memoria.
- Anota la configuración inicial. Registra las versiones de aplicación y motor, sistema operativo, RAM, GPU, archivo exacto del modelo, modo de inicio, tamaño de contexto y ajustes explícitos de memoria o rutas. Mantén el modelo y la cuantización sin cambios durante la comparación.
- Elige tres trabajos representativos. Por ejemplo, una pregunta breve, una petición sobre un documento largo y una extracción estructurada con campos obligatorios conocidos. Son casos sugeridos, no tareas ejecutadas para este artículo.
- Establece la referencia con reserva para trabajar. Mantén abiertos el navegador, el editor y las demás aplicaciones habituales. Observa la memoria libre, actividad de almacenamiento, demora inicial, velocidad de generación y capacidad de respuesta de esas aplicaciones.
- Cambia solo la residencia. Compara la asignación orientada al rendimiento con el mismo ajuste de rutas. Vigila la presión de memoria durante la tarea y cuando se inicie después otra aplicación habitual.
- Evalúa la respuesta. Comprueba los datos requeridos, el formato, el seguimiento de instrucciones y la consistencia entre repeticiones. Considera un fallo una extracción sintácticamente válida que omita un elemento obligatorio.
- Prueba la omisión de rutas por separado si la necesitas. Conserva el presupuesto de residencia elegido. Compara las respuestas con tus ejemplos de aceptación y decide si la ganancia de rendimiento compensa los cambios observados.
Con un documento largo, registra tanto el arranque en frío como una petición repetida. La caché puede hacer que la segunda ejecución difiera mucho de la primera. No mezcles el resultado en caliente de una configuración con el primer acceso al documento de otra.
Registra también los fallos, en vez de hacerlos desaparecer al calcular medias. Una respuesta rápida seguida de un error por falta de memoria no es un buen resultado para un servicio en segundo plano. Una sesión de edición ininterrumpida puede ser decisiva en un portátil de trabajo, aunque otro ajuste gane en la columna de velocidad de decodificación.
El mejor ajuste deja espacio para tu trabajo real
Strata 0.2.17 hace que la inferencia local se parezca menos a un benchmark aislado de acelerador y más a gestionar un pequeño ordenador compartido. La memoria es una mesa común: colocar más material del modelo puede reducir los viajes al almacenamiento, pero el trabajo sigue necesitando su espacio.
En una máquina dedicada, la nueva asignación invita a medir si reducir las lecturas mejora la carga que atiendes. En una estación de trabajo cotidiana, la reserva es un punto de partida sensato. En ambos casos, conserva la fidelidad de las respuestas como criterio de aceptación propio. Un ajuste más rápido se gana su sitio cuando mejora la tarea completa, no solo el contador de tokens.
Fuentes y material oficial
- Strata 0.2.17, 20 de noviembre de 2026: ajustes, mediciones contextualizadas y comportamiento de actualización.
- Notas de transición del motor Strata 0.2.16.
- Ilustración oficial de la interfaz de Strata. El enlace muestra el producto real; los gráficos incluidos son explicaciones originales.
Las mediciones anteriores se atribuyen al proyecto y conservan sus condiciones de hardware y modelo. El procedimiento de evaluación es una propuesta de trabajo para el lector.
Recomendación de Telli.sh: Guarda juntas tus configuraciones, peticiones representativas y notas comparativas para que la siguiente actualización parta de una referencia útil. Crea tu primera nota con Telli.sh.