Nova-3 añadió su idioma número 58 este mes. Solo 10 de ellos funcionan en la misma frase.
El 4 de agosto de 2026 Deepgram añadió punyabí y nepalí a Nova-3; el 7 de agosto sumó armenio y mejoró tamil, indonesio y bielorruso. Hace nueve meses el modelo cubría 31 idiomas — hoy la documentación lista 58. Pero el cambio de código sigue funcionando en exactamente 10, y el propio changelog de agosto muestra el indonesio mejorando en batch mientras el bielorruso mejoraba solo en streaming. Un repaso al ritmo de la cobertura lingüística en reconocimiento de voz, y a lo que la palabra «compatible» está escondiendo en realidad.
El 4 de agosto de 2026, Deepgram añadió el punyabí y el nepalí a su modelo de reconocimiento de voz Nova-3. Tres días después incorporó el armenio, junto con modelos monolingües mejorados para tamil, indonesio y bielorruso.
Dos entradas de changelog, once líneas de texto entre ambas, ninguna nota de prensa. Y sin embargo, para quien celebra reuniones en esos idiomas, es lo más importante que le ha pasado al reconocimiento de voz este mes.
El patrón que hay detrás de esas entradas vale más que las entradas mismas. En diciembre de 2025, las propias notas de versión de Deepgram situaban a Nova-3 en 31 idiomas totales. Al contar hoy, 31 de agosto de 2026, los códigos de idioma base distintos en el Models & Languages Overview de Deepgram, salen 58. Ese es el ritmo al que se mueve toda la industria, y ha cambiado en silencio lo que deberías esperar de una transcripción.
Este artículo hace tres cosas. Pone cifras y fechas a esa expansión usando fuentes primarias. Explica por qué un recuento de idiomas en un titular es casi inútil por sí solo — y qué tres preguntas hay que hacer en su lugar. Y desarrolla qué cambian concretamente las incorporaciones de agosto para una reunión con hablantes de punyabí, nepalí, armenio, tamil o indonesio en la sala.
En resumen:
- 58 frente a 31. La documentación de Nova-3 listaba 31 idiomas totales el 10 de diciembre de 2025 y 58 códigos de idioma base distintos el 31 de agosto de 2026 — 39 idiomas añadidos a lo largo de nueve entradas de changelog fechadas.
- La cobertura no es un solo número. El modo de cambio de código
language=multide Deepgram cubre exactamente 10 idiomas (inglés, español, francés, alemán, hindi, ruso, portugués, japonés, italiano, neerlandés). Los otros 48 son de un idioma cada vez.- Batch y streaming son productos distintos. La versión del 7 de agosto mejoró el tamil en ambos, el indonesio solo en batch y el bielorruso solo en streaming. Una misma entrada de changelog, tres resultados diferentes.
- El monolingüe sigue ganando. Para 48 de los 58 idiomas de Nova-3, un modelo dedicado no solo es mejor que el modo multilingüe: es la única opción que existe.
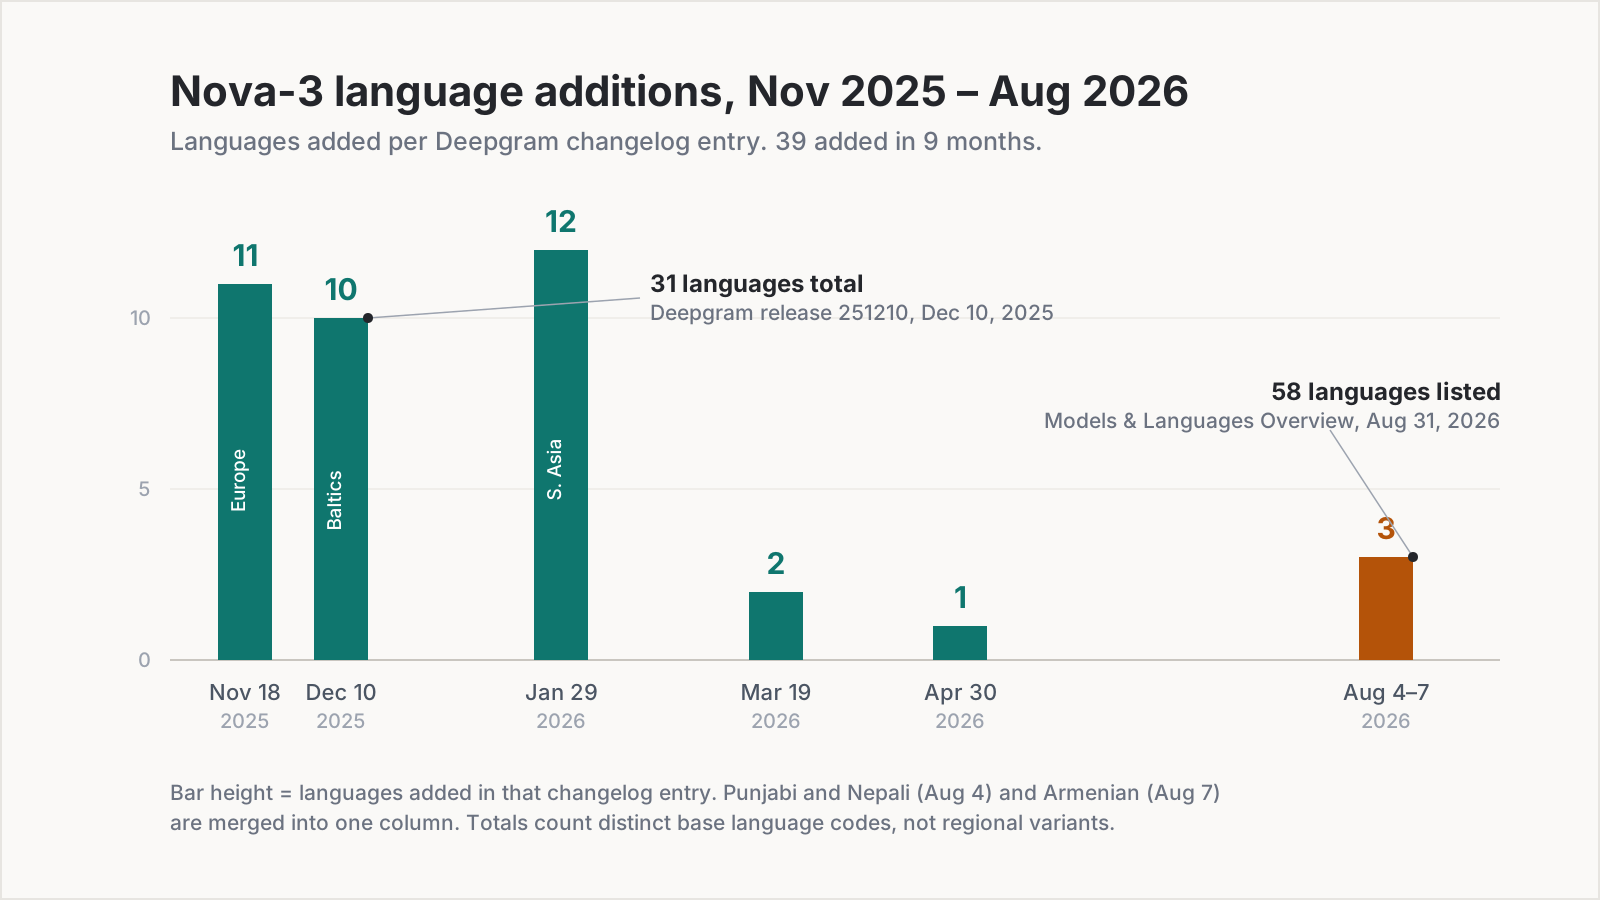
Gráfico: Telli.sh, elaborado a partir de las entradas del changelog de Deepgram fechadas entre el 18 de noviembre de 2025 y el 10 de agosto de 2026, y del Models & Languages Overview consultado el 31 de agosto de 2026.
Treinta y un idiomas en diciembre, cincuenta y ocho en agosto
Los proveedores de reconocimiento de voz rara vez anuncian la cobertura lingüística como anuncian la precisión. Llega en notas de versión, de puñado en puñado, y el efecto acumulado se pasa por alto salvo que vuelvas atrás y sumes. Así que lo hicimos.
La versión 251118 de Deepgram, fechada el 18 de noviembre de 2025, amplió el soporte monolingüe de Nova-3 con 11 idiomas nuevos: búlgaro, checo, finés, hindi, húngaro, japonés, coreano, polaco, ruso, ucraniano y vietnamita. La versión 251210, tres semanas más tarde, el 10 de diciembre de 2025, sumó otros 10 repartidos entre el sur de Europa, el Báltico y el Sudeste Asiático: griego, rumano, eslovaco, catalán, lituano, letón, estonio, flamenco, alemán suizo y malayo. Esa nota de versión contiene la frase más útil de toda esta historia: «Nova-3 admite ahora 31 idiomas en total».
A partir de ahí las incorporaciones no pararon. La versión 260129, del 29 de enero de 2026, añadió 12 más, entre ellos bielorruso, bengalí, bosnio y croata. La versión 260319, del 19 de marzo de 2026, trajo el tailandés y el cantonés. La versión 260430, del 30 de abril de 2026, añadió el guyaratí. Y luego agosto: punyabí y nepalí el día 4, armenio el día 7.
Suma las incorporaciones documentadas entre el 18 de noviembre de 2025 y el 10 de agosto de 2026 y salen 39 idiomas en algo menos de nueve meses. Eso es aproximadamente un idioma nuevo cada siete días, de forma sostenida, y de un solo proveedor.
Hay un detalle que merece atención, porque dice algo sobre cómo llegan realmente estas versiones hasta ti. El changelog de la nube fecha la incorporación de punyabí y nepalí el 4 de agosto de 2026. La versión autoalojada que empaqueta esos mismos modelos, la 260812, está fechada el 12 de agosto. Ocho días de retraso entre la API alojada y la imagen del contenedor. Si ejecutas Deepgram en tu propio hardware, «compatible» llegó más de una semana después que para todos los demás.
«Compatible» no es una sola cosa: son tres preguntas
Ahora la parte que los números de titular esconden. Cuando un proveedor dice que un idioma es compatible, esa única palabra está haciendo al menos tres trabajos, y se separan constantemente.
¿Puedes usarlo en tiempo real o solo a posteriori? La transcripción en batch y la transcripción en streaming ejecutan modelos distintos con restricciones distintas. Un modelo de streaming tiene que comprometerse con las palabras antes de haber oído el final de la frase; un modelo batch dispone de toda la grabación. Los proveedores los publican por separado, y no siempre los publican a la vez.
¿Qué tal es el modelo, en realidad? «Compatible» te dice que se aceptará un código, no que la salida sirva para un consejo de administración. Un idioma añadido el mes pasado y otro que ha pasado por cuatro rondas de mejora aparecen en la misma celda de la misma tabla.
¿Se puede mezclar con otro idioma? Esta es la que casi nadie comprueba hasta que se rompe. Transcribir una reunión en la que todos hablan nepalí es un problema técnico distinto de transcribir una reunión en la que la gente alterna entre nepalí e inglés a mitad de frase, y el segundo problema está resuelto para muchos menos idiomas.
El changelog de agosto es la ilustración más limpia de la primera pregunta que hemos visto en un año. La entrada del 7 de agosto mejoró cuatro cosas, y no las mejoró de manera uniforme.
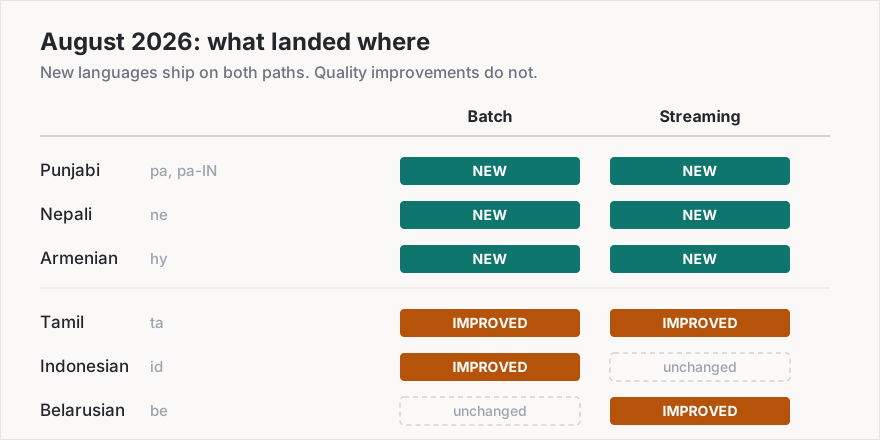
Gráfico: Telli.sh, a partir de las entradas del changelog de Deepgram del 4 y el 7 de agosto de 2026.
El punyabí, el nepalí y el armenio llegaron por ambas vías — Deepgram afirma sin rodeos que «los modelos batch y streaming están disponibles para estos idiomas». El tamil recibió un modelo mejorado tanto en batch como en streaming. El indonesio recibió un modelo batch mejorado y nada nuevo para streaming. El bielorruso recibió un modelo streaming mejorado y nada nuevo para batch.
Si transcribes entrevistas grabadas en indonesio, el 7 de agosto fue un buen día para ti. Si celebras reuniones en indonesio en directo, el 7 de agosto no cambió nada. Ambos hechos viven dentro de una sola lista de viñetas de una sola entrada de changelog, y ningún resumen de esa entrada te dirá cuál de los dos te aplica.
Esa asimetría no es descuido. Refleja que de verdad son modelos distintos, con presupuestos de entrenamiento y validación distintos, y es el argumento más sólido para leer los changelogs de los proveedores al nivel del idioma concreto y no del titular.
El acantilado de cobertura: 58 idiomas, 10 conversaciones
Vamos con la tercera pregunta, que es donde vive la brecha interesante.
El modo multilingüe de cambio de código de Deepgram se activa con un único parámetro, language=multi, y permite que una sola petición gestione a hablantes que saltan de un idioma a otro dentro de una frase. Es genuinamente útil y está disponible en Nova-2, Nova-3 y Flux Multilingual. También es mucho más estrecho que el catálogo monolingüe.
En Nova-3, language=multi cubre exactamente diez idiomas: inglés, español, francés, alemán, hindi, ruso, portugués, japonés, italiano y neerlandés. En Nova-2, el mismo parámetro cubre dos: español e inglés.
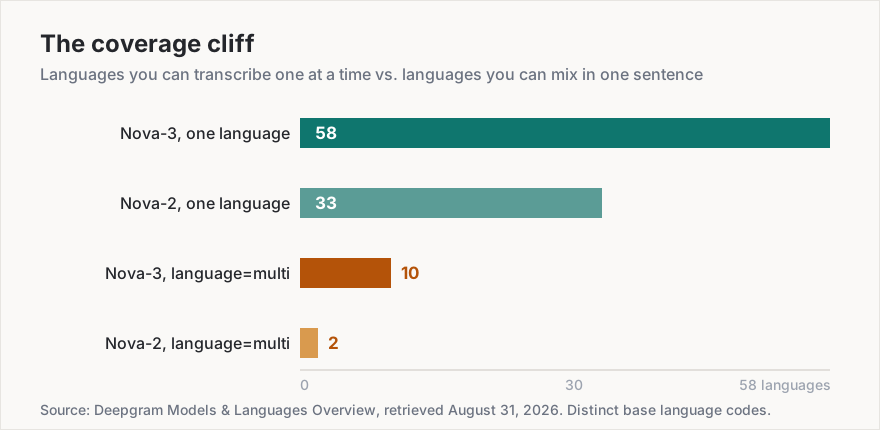
Gráfico: Telli.sh, a partir del Models & Languages Overview de Deepgram, consultado el 31 de agosto de 2026. Los recuentos son de códigos de idioma base distintos, excluyendo variantes regionales y de escritura.
Llámalo el acantilado de cobertura: la caída entre el idioma que un proveedor lista y el idioma en el que tu reunión real, desordenada y medio en inglés acaba siendo procesada. Cincuenta y ocho idiomas se asoman a ese acantilado. Diez sobreviven a la caída.
Para los 48 idiomas del lado equivocado — punyabí, nepalí, armenio, tamil, bengalí, tailandés, coreano, vietnamita, malayo y el resto — el modelo monolingüe dedicado no es simplemente la mejor opción. Es la única. No hay ninguna vía de cambio de código con la que compararlo.
Aquí está el asunto, y va contra la intuición de que un modo multilingüe es estrictamente más capaz: para la mayoría de los idiomas del mundo, el modelo monolingüe es la opción avanzada, no el recurso de emergencia. Un modelo dedicado se entrena con la fonética de un idioma, la distribución de vocabulario de un idioma, los números y las fechas de un idioma. El modelo multilingüe tiene que sostener diez de esos en tensión y decidir, palabra a palabra, cuál está oyendo. Cuando sabes que la reunión es en tamil, decírselo al motor no es una limitación que aceptas: es la configuración de mayor precisión a tu alcance.
language=multi (cambio de código) | Modelo de idioma dedicado | |
|---|---|---|
| Cobertura de idiomas en Nova-3 | 10 idiomas | 58 idiomas |
| Cobertura de idiomas en Nova-2 | 2 idiomas (español + inglés) | 33 idiomas |
| Gestiona el cambio a mitad de frase | Sí | No — el habla en otro idioma se degrada |
| Precisión en un único idioma conocido | Menor; el modelo arbitra entre candidatos | Mayor; el modelo está especializado |
| Keyterm prompting | Sí en Nova-3 Multi, hasta 500 tokens (~100 palabras), desde el 10 de dic. de 2025 | Sí |
| Ajuste recomendado en streaming | endpointing=100 según la guía de Deepgram | Endpointing por defecto |
| Disponible para punyabí, nepalí, armenio, tamil | No | Sí |
La lectura práctica de esa tabla: si tu reunión mezcla de verdad inglés y español frase a frase, usa multi y asume la pérdida de precisión. Si tu reunión es en tamil con algún préstamo ocasional del inglés — que es lo que en realidad son la mayoría de las reuniones «multilingües» — pon language=ta y deja que el modelo dedicado haga su trabajo.
Quién tiene realmente mejores reuniones este mes
Basta de arquitectura. Seis idiomas cambiaron de estado en agosto de 2026, y detrás de cada código hay una población que llevaba transcribiendo mal sus reuniones, o directamente no transcribiéndolas.
| Idioma | Código | Hablantes | Qué cambió en agosto de 2026 |
|---|---|---|---|
| Punyabí | pa, pa-IN | ~125 millones | Nuevo en Nova-3, batch y streaming (4 ago.) |
| Nepalí | ne | ~16 millones | Nuevo en Nova-3, batch y streaming (4 ago.) |
| Armenio | hy | ~6,7 millones | Nuevo en Nova-3, batch y streaming (7 ago.) |
| Tamil | ta | ~75 millones nativos | Modelo mejorado, batch y streaming (7 ago.) |
| Indonesio | id | ~199 millones incl. segunda lengua | Modelo batch mejorado solamente (7 ago.) |
| Bielorruso | be | ~7,6 millones | Modelo streaming mejorado solamente (7 ago.) |
Cifras de hablantes: recuentos de Ethnologue agregados en Wikidata (propiedad P1098), consultados el 31 de agosto de 2026. Redondeados.
Son unos 430 millones de personas cuyo idioma recibió un reconocimiento de voz mensurablemente mejor en una sola semana, y alrededor de 148 millones de ellas — las hablantes de punyabí, nepalí y armenio — pasaron de no tener ninguna opción de primera clase en Nova-3 a tenerla tanto en batch como en streaming.
Piensa en lo que eso significa dentro de una sala. La reunión diaria de un equipo de ingeniería en Chandigarh, que antes se hacía en un segundo idioma por comodidad de las herramientas o se quedaba sin transcribir, ahora genera una transcripción en tiempo real. El informe de campo de una ONG en Katmandú se convierte en un registro consultable en lugar de en los apuntes a mano de alguien. Una declaración jurídica en armenio puede transcribirse en directo en vez de enviarse fuera para transcripción manual a tanto el minuto.
Hay un efecto de segundo orden que importa más que la transcripción en sí. En cuanto el habla en un idioma pasa a ser legible por máquina en tiempo real, todo lo que viene después se desbloquea de golpe: traducción en directo para participantes remotos, resúmenes automáticos, tareas extraídas, búsqueda sobre un año entero de reuniones. El reconocimiento de voz es la etapa cuello de botella. Cada idioma que la supera hereda toda la cadena que se construyó para el inglés.
Si estás en un equipo donde alguien cambia al inglés por costumbre porque «la herramienta no habla lo nuestro», esta es la actualización que pone fin a ese compromiso concreto.
Cómo elegir el ajuste de idioma para una reunión multilingüe
Las mejoras del motor solo sirven si configuras bien la sesión, y los valores por defecto se equivocan a menudo con los equipos multilingües. Cinco pasos, en orden:
- Determina si la reunión tiene un idioma dominante o si mezcla de verdad. Algún préstamo ocasional del inglés en una reunión en tamil es un idioma. Alternar frases completas entre español e inglés son dos. Solo el segundo caso necesita cambio de código.
- Si es un solo idioma, decláralo explícitamente. Usa
model=nova-3con el código concreto:language=papara punyabí,language=nepara nepalí,language=hypara armenio. No lo dejes en detección automática; tú ya sabes la respuesta, y decírselo al modelo no cuesta nada. - Si de verdad mezcla, contrasta los idiomas con la lista de diez. Pon
language=multisolo si todos los idiomas de la sala están entre inglés, español, francés, alemán, hindi, ruso, portugués, japonés, italiano y neerlandés. Si alguno no está,multino te ayudará, y el modelo del idioma dominante es tu mejor opción disponible. - Para sesiones en directo con
multi, ponendpointing=100. La propia guía de cambio de código de Deepgram recomienda 100 ms específicamente para el cambio de código, frente al valor por defecto más alto. Un endpointing más largo hace que una frase en el idioma conmutado se absorba en el segmento equivocado. - Verifica batch y streaming por separado antes de prometer nada. Como demostró el 7 de agosto, una mejora en uno no es una mejora en el otro. Pasa la misma muestra de 10 minutos por ambas vías y compara, en vez de dar por hecho que una entrada de changelog aplica a tu vía.
Cubrimos otra parte de esto en junio — la actualización de mitad de año de Deepgram sobre sesiones en directo adaptativas y diarización, incluido el control UpdateListen que permite a una sesión en marcha cambiar sus pistas de idioma sin reconectar. El paso 2 de arriba y esa capacidad encajan bien: fija el idioma explícitamente al empezar y ajústalo a mitad de reunión si la sala cambia de verdad.
En resumen: la cobertura dejó de ser un número y pasó a ser una matriz
El instinto al comparar motores de voz es buscar el número más grande. El tokenizador Whisper de OpenAI declara 100 tokens de idioma desde 2022 — casi el doble de los 58 de Nova-3 — y esa comparación no te dice casi nada, porque Whisper no tiene vía nativa de streaming y un token declarado no es un modelo validado en producción. Nova-3 lista menos idiomas y los entrega, idioma a idioma, modo a modo, con pruebas fechadas.
El número que describe la cobertura real de un motor no es un recuento. Es una matriz: idioma × modo × nivel de calidad. Cincuenta y ocho idiomas de uno en uno. Diez de ellos mezclables. Un idioma mejorado en batch y no en streaming, otro en streaming y no en batch, en la misma versión, el mismo día.
Así que la pregunta que hay que llevar a tu próxima evaluación de proveedores no es «cuántos idiomas admitís». Es: para mi idioma, en mi vía, ¿a fecha de cuándo?
Dónde encaja Telli.sh: todo lo anterior es detalle de la capa del motor, y creemos que la mayoría de los equipos no debería tener que saber nada de esto. Telli.sh se sitúa encima de esa capa y toma por ti las decisiones de la lista numerada de arriba: elige el modelo dedicado cuando la reunión tiene un solo idioma, mantiene las subidas en batch y las sesiones en directo en sus vías correctas, y hereda mejoras de motor como las de agosto la misma semana en que salen, no en tu próxima migración. Sobre la transcripción ejecutamos traducción en directo a 44 idiomas de destino y una interfaz en 15 idiomas, de modo que quien se une desde Varsovia a tu reunión en punyabí la lee en polaco mientras ocurre.
Empieza una nota de reunión traducida en directo
Fuentes
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update — punyabí (
pa,pa-IN) y nepalí (ne), disponibles tanto en batch como en streaming - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — armenio (
hy) nuevo; modelos batch mejorados para tamil e indonesio; modelos streaming mejorados para tamil y bielorruso - Deepgram Models & Languages Overview — tablas completas de idiomas de Nova-3 y Nova-2 y la lista de idiomas
multi, consultado el 31 de agosto de 2026 - Deepgram Multilingual Codeswitching guide — uso de
language=multiy la recomendación deendpointing=100, consultado el 31 de agosto de 2026 - Deepgram Self-Hosted release 251210, December 10, 2025 — «Nova-3 admite ahora 31 idiomas en total»; keyterm prompting multilingüe hasta 500 tokens
- Deepgram Self-Hosted release 251118, November 18, 2025 — 11 idiomas nuevos, además del modelo de detección de 36 idiomas
- Deepgram Self-Hosted release 260129, January 29, 2026 — 12 nuevos idiomas en Nova-3, entre ellos bielorruso, bengalí, bosnio y croata
- Deepgram Self-Hosted release 260319, March 19, 2026 — tailandés y cantonés
- Deepgram Self-Hosted release 260430, April 30, 2026 — guyaratí
- Deepgram Self-Hosted release 260812, August 12, 2026 — el paquete autoalojado con nepalí y punyabí, ocho días después de la entrada en la nube
- OpenAI Whisper tokenizer language table — 100 tokens de idioma declarados, consultado el 31 de agosto de 2026
- Wikidata property P1098 (number of speakers) — recuentos de hablantes derivados de Ethnologue para
pa,ne,hy,ta,id,be, consultados el 31 de agosto de 2026 - Nuestra cobertura de junio de 2026 sobre las actualizaciones de sesiones en directo y diarización de Deepgram