Nova-3 hat diesen Monat seine 58. Sprache bekommen. Nur 10 davon funktionieren im selben Satz.
Am 4. August 2026 hat Deepgram Punjabi und Nepali zu Nova-3 hinzugefügt, am 7. August folgten Armenisch sowie Verbesserungen für Tamil, Indonesisch und Belarussisch. Vor neun Monaten deckte das Modell 31 Sprachen ab — heute listet die Dokumentation 58. Code-Switching funktioniert aber in genau 10 davon, und das Changelog vom August zeigt: Indonesisch wurde nur im Batch-Betrieb besser, Belarussisch nur im Streaming. Eine Bestandsaufnahme zum Tempo der Sprachabdeckung in der Spracherkennung — und dazu, was das Wort „unterstützt“ tatsächlich verdeckt.
Am 4. August 2026 hat Deepgram Punjabi und Nepali in sein Spracherkennungsmodell Nova-3 aufgenommen. Drei Tage später kam Armenisch hinzu, zusammen mit verbesserten monolingualen Modellen für Tamil, Indonesisch und Belarussisch.
Zwei Changelog-Einträge, elf Zeilen Text dazwischen, keine Pressemitteilung. Und doch ist es für alle, die ihre Besprechungen in diesen Sprachen führen, das folgenreichste Ereignis, das der Spracherkennung in diesem Monat widerfahren ist.
Das Muster hinter diesen Einträgen wiegt schwerer als die Einträge selbst. Im Dezember 2025 wies Deepgram in den eigenen Release Notes für Nova-3 insgesamt 31 Sprachen aus. Zählt man heute, am 31. August 2026, die eindeutigen Basis-Sprachcodes in Deepgrams Models & Languages Overview, kommt man auf 58. In diesem Tempo bewegt sich die gesamte Branche, und das hat still und leise verändert, was Sie von einem Transkript erwarten dürfen.
Dieser Beitrag leistet drei Dinge. Er belegt diese Expansion mit Zahlen und Daten aus Primärquellen. Er erklärt, warum eine bloße Sprachanzahl für sich genommen kaum Aussagekraft hat — und welche drei Fragen Sie stattdessen stellen müssen. Und er zeigt konkret, was die August-Ergänzungen für eine Besprechung bedeuten, in der Punjabi, Nepali, Armenisch, Tamil oder Indonesisch gesprochen wird.
Kurz gefasst:
- 58 statt 31. Die Nova-3-Dokumentation nannte am 10. Dezember 2025 insgesamt 31 Sprachen und listete am 31. August 2026 58 eindeutige Basis-Sprachcodes — 39 Sprachen kamen über neun datierte Changelog-Einträge hinzu.
- Abdeckung ist keine einzelne Zahl. Deepgrams Code-Switching-Modus
language=multiumfasst genau 10 Sprachen (Englisch, Spanisch, Französisch, Deutsch, Hindi, Russisch, Portugiesisch, Japanisch, Italienisch, Niederländisch). Die übrigen 48 gibt es nur einzeln, eine Sprache pro Sitzung.- Batch und Streaming sind getrennte Produkte. Das Release vom 7. August verbesserte Tamil in beiden Modi, Indonesisch nur im Batch-Betrieb und Belarussisch nur im Streaming. Ein Changelog-Eintrag, drei verschiedene Ergebnisse.
- Monolingual bleibt vorn. Für 48 der 58 Nova-3-Sprachen ist ein dediziertes Modell nicht nur besser als der mehrsprachige Modus — es ist die einzige existierende Option.
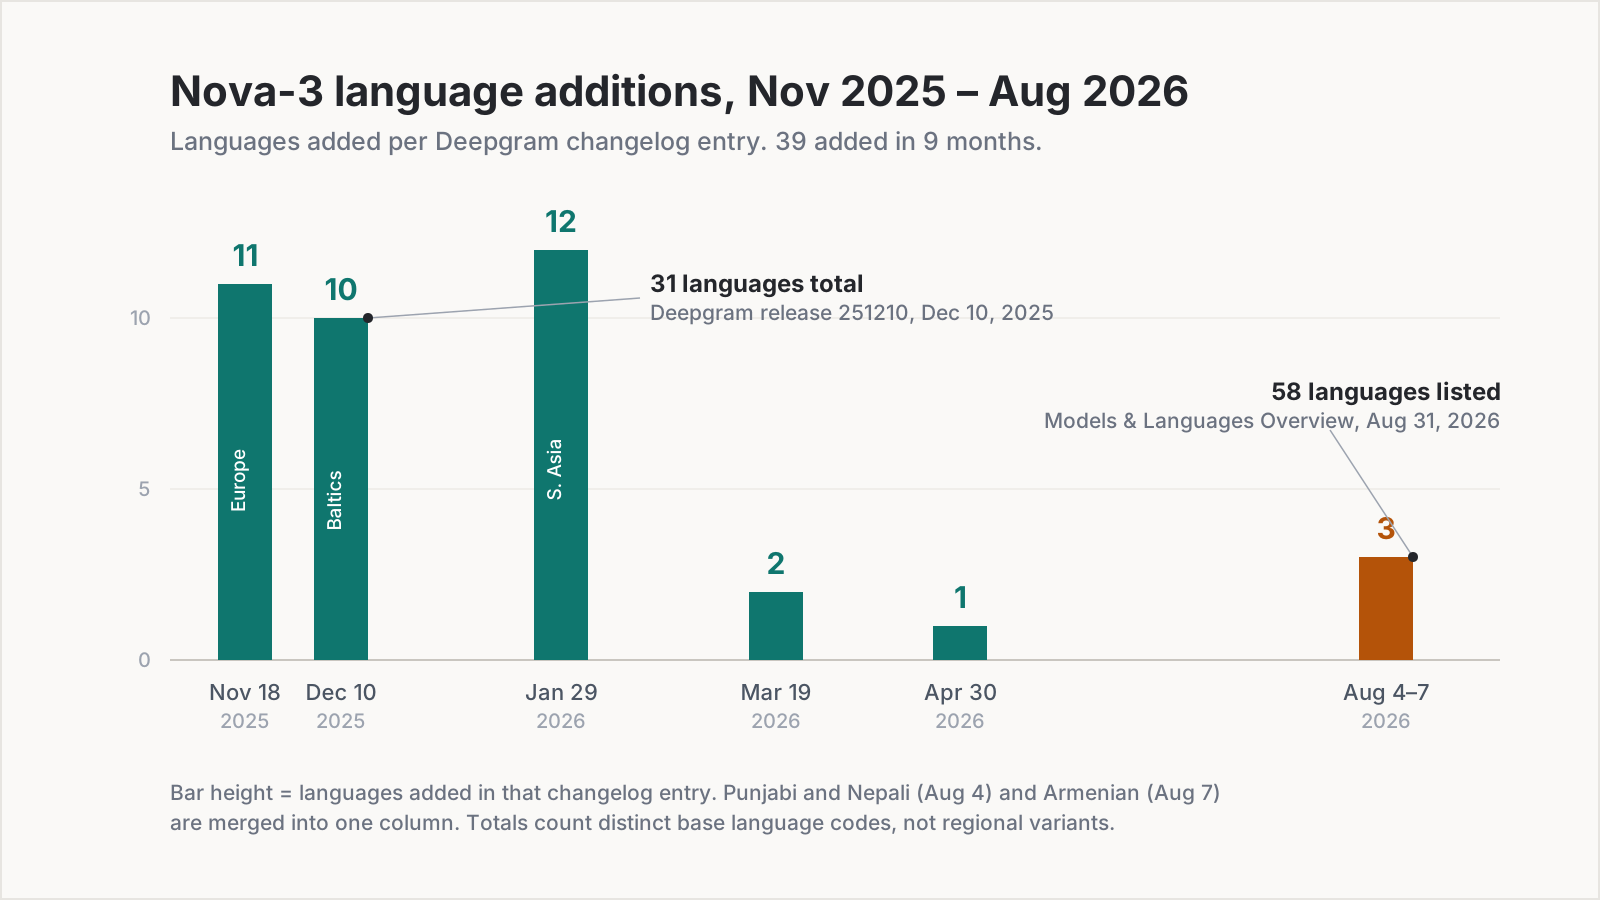
Diagramm: Telli.sh, erstellt aus den Deepgram-Changelog-Einträgen vom 18. November 2025 bis 10. August 2026 sowie dem Models & Languages Overview, abgerufen am 31. August 2026.
Einunddreißig Sprachen im Dezember, achtundfünfzig im August
Anbieter von Spracherkennung kündigen Sprachabdeckung selten so an wie Genauigkeit. Sie erscheint in Release Notes, immer nur eine Handvoll auf einmal, und der kumulative Effekt entgeht einem leicht, wenn man nicht zurückgeht und zusammenzählt. Genau das haben wir getan.
Deepgrams Release 251118 vom 18. November 2025 erweiterte die monolinguale Unterstützung von Nova-3 um 11 neue Sprachen: Bulgarisch, Tschechisch, Finnisch, Hindi, Ungarisch, Japanisch, Koreanisch, Polnisch, Russisch, Ukrainisch und Vietnamesisch. Release 251210, drei Wochen später am 10. Dezember 2025, ergänzte 10 weitere aus Südeuropa, dem Baltikum und Südostasien: Griechisch, Rumänisch, Slowakisch, Katalanisch, Litauisch, Lettisch, Estnisch, Flämisch, Schweizerdeutsch und Malaiisch. Diese Release Note enthält den nützlichsten Satz der ganzen Geschichte: „Nova-3 now supports 31 total languages.“
Danach ging es Schlag auf Schlag weiter. Release 260129 vom 29. Januar 2026 brachte 12 weitere Sprachen, darunter Belarussisch, Bengalisch, Bosnisch und Kroatisch. Release 260319 vom 19. März 2026 fügte Thai und Kantonesisch hinzu. Release 260430 vom 30. April 2026 lieferte Gujarati. Und dann der August: Punjabi und Nepali am 4., Armenisch am 7.
Rechnet man die dokumentierten Ergänzungen vom 18. November 2025 bis zum 10. August 2026 zusammen, ergeben sich 39 Sprachen in knapp neun Monaten. Das entspricht ungefähr einer neuen Sprache alle sieben Tage, dauerhaft, von einem einzigen Anbieter.
Ein Detail lohnt die Aufmerksamkeit, weil es zeigt, wie diese Releases tatsächlich bei Ihnen ankommen. Das Cloud-Changelog datiert die Aufnahme von Punjabi und Nepali auf den 4. August 2026. Das Self-Hosted-Release, das dieselben Modelle bündelt — 260812 —, trägt das Datum 12. August. Acht Tage Verzug zwischen der gehosteten API und dem Container-Image. Wer Deepgram auf eigener Hardware betreibt, für den kam „unterstützt“ mehr als eine Woche später an als für alle anderen.
„Unterstützt“ ist nicht eine Sache, sondern drei Fragen
Jetzt zu dem Teil, den die Schlagzeilenzahlen verdecken. Wenn ein Anbieter sagt, eine Sprache sei unterstützt, erledigt dieses eine Wort mindestens drei Aufgaben — und die fallen ständig auseinander.
Können Sie die Sprache in Echtzeit nutzen oder erst im Nachhinein? Batch-Transkription und Streaming-Transkription laufen auf unterschiedlichen Modellen mit unterschiedlichen Zwängen. Ein Streaming-Modell muss sich auf Wörter festlegen, bevor es das Satzende gehört hat; ein Batch-Modell bekommt die vollständige Aufnahme. Anbieter liefern beide getrennt aus, und sie liefern sie nicht immer gemeinsam.
Wie gut ist das Modell wirklich? „Unterstützt“ sagt Ihnen, dass ein Sprachcode akzeptiert wird, nicht dass die Ausgabe für eine Vorstandssitzung taugt. Eine Sprache, die letzten Monat hinzukam, und eine Sprache mit vier Verbesserungsrunden stehen in derselben Tabellenzelle.
Lässt sie sich mit einer anderen Sprache mischen? Das ist der Punkt, den fast niemand prüft, bis er bricht. Eine Besprechung zu transkribieren, in der alle Nepali sprechen, ist ein anderes technisches Problem, als eine Besprechung zu transkribieren, in der die Teilnehmenden mitten im Satz zwischen Nepali und Englisch wechseln — und das zweite Problem ist für weit weniger Sprachen gelöst.
Das Changelog vom August ist die sauberste Illustration der ersten Frage, die uns seit einem Jahr untergekommen ist. Der Eintrag vom 7. August verbesserte vier Dinge, und er verbesserte sie nicht einheitlich.
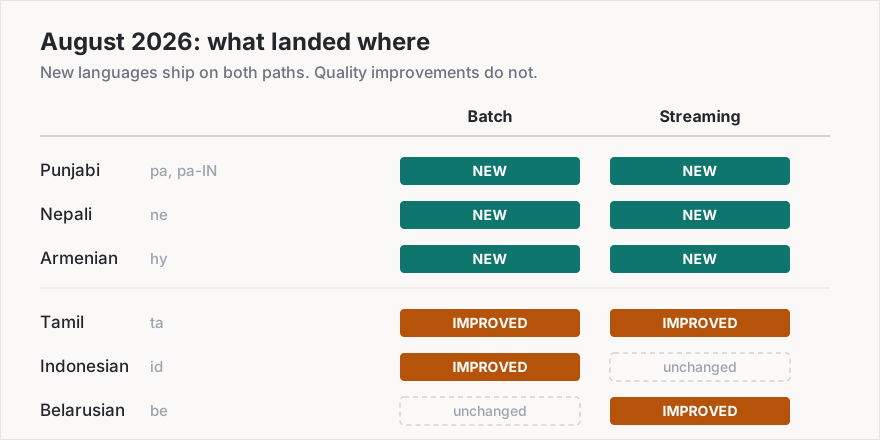
Diagramm: Telli.sh, aus den Deepgram-Changelog-Einträgen vom 4. und 7. August 2026.
Punjabi, Nepali und Armenisch kamen auf beiden Wegen an — Deepgram schreibt unmissverständlich: „batch and streaming models are both available for these languages.“ Tamil erhielt ein verbessertes Modell sowohl im Batch-Betrieb als auch im Streaming. Indonesisch bekam ein verbessertes Batch-Modell und nichts Neues fürs Streaming. Belarussisch bekam ein verbessertes Streaming-Modell und nichts Neues für Batch.
Wenn Sie aufgezeichnete Interviews auf Indonesisch transkribieren, war der 7. August ein guter Tag für Sie. Wenn Sie indonesische Besprechungen live mitschreiben lassen, hat der 7. August nichts verändert. Beide Tatsachen stecken in einer einzigen Aufzählung in einem einzigen Changelog-Eintrag, und keine Zusammenfassung dieses Eintrags wird Ihnen sagen, welche der beiden für Sie gilt.
Diese Asymmetrie ist keine Nachlässigkeit. Sie spiegelt, dass es sich wirklich um verschiedene Modelle mit verschiedenen Trainings- und Validierungsbudgets handelt, und sie ist das stärkste Einzelargument dafür, Anbieter-Changelogs auf Ebene der einzelnen Sprache zu lesen statt auf Ebene der Überschrift.
Die Abdeckungskante: 58 Sprachen, 10 Gespräche
Nun zur dritten Frage — dort sitzt die interessante Lücke.
Deepgrams mehrsprachiger Code-Switching-Modus wird mit einem einzigen Parameter aktiviert, language=multi, und er erlaubt es, in einer Anfrage Sprechende zu verarbeiten, die innerhalb eines Satzes die Sprache wechseln. Er ist wirklich nützlich, und es gibt ihn für Nova-2, Nova-3 und Flux Multilingual. Er ist zugleich deutlich schmaler als der monolinguale Katalog.
Auf Nova-3 deckt language=multi genau zehn Sprachen ab: Englisch, Spanisch, Französisch, Deutsch, Hindi, Russisch, Portugiesisch, Japanisch, Italienisch und Niederländisch. Auf Nova-2 deckt derselbe Parameter zwei ab — Spanisch und Englisch.
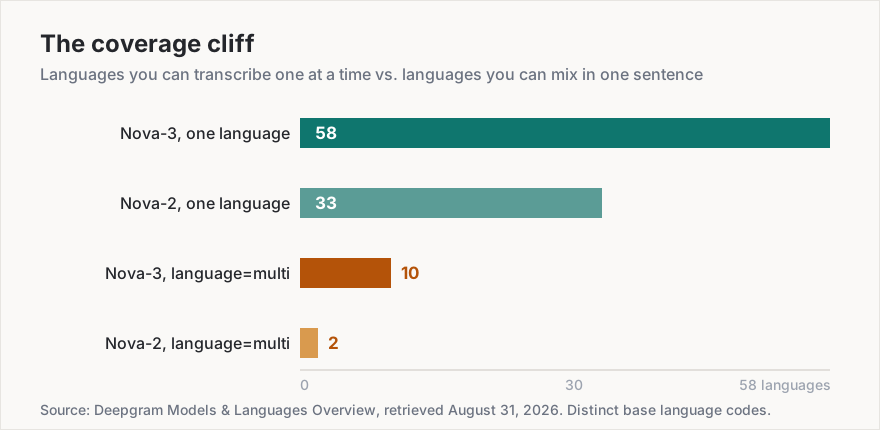
Diagramm: Telli.sh, aus dem Deepgram Models & Languages Overview, abgerufen am 31. August 2026. Gezählt werden eindeutige Basis-Sprachcodes ohne regionale Varianten und Schriftvarianten.
Nennen wir es die Abdeckungskante: der Absturz zwischen der Sprache, die ein Anbieter listet, und der Sprache, in der Ihre tatsächliche, unordentliche, halb englische Besprechung verarbeitet wird. Achtundfünfzig Sprachen stehen oben auf dieser Kante. Zehn davon überleben den Fall.
Für die 48 Sprachen auf der falschen Seite — Punjabi, Nepali, Armenisch, Tamil, Bengalisch, Thai, Koreanisch, Vietnamesisch, Malaiisch und die übrigen — ist das dedizierte monolinguale Modell nicht bloß die bessere Wahl. Es ist die einzige Wahl. Es gibt keinen Code-Switching-Pfad, mit dem man es vergleichen könnte.
Hier ist der entscheidende Punkt, und er läuft der Intuition zuwider, ein mehrsprachiger Modus sei grundsätzlich leistungsfähiger: Für die meisten Sprachen der Welt ist das monolinguale Modell die fortgeschrittene Option, nicht die Notlösung. Ein dediziertes Modell ist auf die Phonetik einer Sprache trainiert, auf die Wortschatzverteilung einer Sprache, auf die Zahlen und Datumsformate einer Sprache. Das mehrsprachige Modell muss zehn davon gleichzeitig in der Schwebe halten und Wort für Wort entscheiden, welche es gerade hört. Wenn Sie wissen, dass die Besprechung auf Tamil läuft, ist es keine Einschränkung, das der Engine mitzuteilen — es ist die genaueste Konfiguration, die Ihnen zur Verfügung steht.
language=multi (Code-Switching) | Dediziertes Sprachmodell | |
|---|---|---|
| Sprachabdeckung Nova-3 | 10 Sprachen | 58 Sprachen |
| Sprachabdeckung Nova-2 | 2 Sprachen (Spanisch + Englisch) | 33 Sprachen |
| Verarbeitet Wechsel mitten im Satz | Ja | Nein — fremdsprachige Passagen verschlechtern das Ergebnis |
| Genauigkeit bei einer bekannten Einzelsprache | Niedriger; das Modell wägt zwischen Kandidaten ab | Höher; das Modell ist spezialisiert |
| Keyterm Prompting | Ja bei Nova-3 Multi, bis zu 500 Token (ca. 100 Wörter), seit 10. Dezember 2025 | Ja |
| Empfohlene Streaming-Einstellung | endpointing=100 laut Deepgram-Leitfaden | Standard-Endpointing |
| Verfügbar für Punjabi, Nepali, Armenisch, Tamil | Nein | Ja |
Praktisch gelesen bedeutet diese Tabelle: Wenn Ihre Besprechung tatsächlich Satz für Satz zwischen Englisch und Spanisch wechselt, nutzen Sie multi und nehmen den Genauigkeitsverlust in Kauf. Wenn Ihre Besprechung auf Tamil läuft und nur vereinzelt englische Lehnwörter enthält — und so sehen die meisten „mehrsprachigen“ Besprechungen tatsächlich aus —, setzen Sie language=ta und lassen das dedizierte Modell arbeiten.
Wer diesen Monat wirklich bessere Besprechungen bekommt
Genug Architektur. Sechs Sprachen haben im August 2026 ihren Status geändert, und hinter jedem Code steht eine Bevölkerung, deren Besprechungen bisher schlecht oder gar nicht transkribiert wurden.
| Sprache | Code | Sprechende | Was sich im August 2026 geändert hat |
|---|---|---|---|
| Punjabi | pa, pa-IN | ca. 125 Millionen | Neu auf Nova-3, Batch und Streaming (4. Aug.) |
| Nepali | ne | ca. 16 Millionen | Neu auf Nova-3, Batch und Streaming (4. Aug.) |
| Armenisch | hy | ca. 6,7 Millionen | Neu auf Nova-3, Batch und Streaming (7. Aug.) |
| Tamil | ta | ca. 75 Millionen Muttersprachler | Verbessertes Modell, Batch und Streaming (7. Aug.) |
| Indonesisch | id | ca. 199 Millionen inkl. Zweitsprachler | Nur verbessertes Batch-Modell (7. Aug.) |
| Belarussisch | be | ca. 7,6 Millionen | Nur verbessertes Streaming-Modell (7. Aug.) |
Sprecherzahlen: Ethnologue-Angaben in der Aggregation von Wikidata (Property P1098), abgerufen am 31. August 2026. Gerundet.
Das sind rund 430 Millionen Menschen, deren Sprache innerhalb einer einzigen Woche messbar bessere Spracherkennung erhalten hat, und etwa 148 Millionen davon — die Sprechenden von Punjabi, Nepali und Armenisch — hatten zuvor überhaupt keine vollwertige Nova-3-Option und haben nun eine, für Batch und Streaming.
Überlegen Sie, was das in einem Raum bedeutet. Das Standup eines Engineering-Teams in Chandigarh, bisher entweder der Werkzeuge zuliebe in einer Zweitsprache geführt oder gar nicht mitgeschrieben, erzeugt jetzt ein Echtzeit-Transkript. Das Feld-Debriefing einer NGO in Kathmandu wird zu einem durchsuchbaren Protokoll statt zu handschriftlichen Notizen. Eine armenische Zeugenvernehmung lässt sich live transkribieren, statt sie zur manuellen Transkription nach Minutentarif außer Haus zu geben.
Es gibt einen Effekt zweiter Ordnung, der schwerer wiegt als das Transkript selbst. Sobald Sprache in einer Sprache maschinenlesbar in Echtzeit wird, schaltet alles Nachgelagerte auf einmal frei: Live-Übersetzung für entfernte Teilnehmende, automatische Zusammenfassungen, extrahierte Aufgaben, Suche über ein Jahr an Besprechungen. Die Spracherkennung ist der Flaschenhals. Jede Sprache, die ihn passiert, erbt die gesamte Pipeline, die für Englisch gebaut wurde.
Wenn in Ihrem Team jemand gewohnheitsmäßig ins Englische wechselt, weil „das Tool unsere Sprache nicht kann“, dann ist dies das Update, das genau diesen Kompromiss beendet.
So wählen Sie die Spracheinstellung für eine mehrsprachige Besprechung
Die Verbesserungen der Engine nützen nur, wenn die Sitzung richtig konfiguriert ist, und die Standardwerte sind für mehrsprachige Teams häufig falsch. Fünf Schritte, in dieser Reihenfolge:
- Klären Sie, ob die Besprechung eine dominante Sprache hat oder tatsächlich mischt. Vereinzelte englische Lehnwörter in einer Besprechung auf Tamil sind eine Sprache. Abwechselnd vollständige Sätze auf Spanisch und Englisch sind zwei. Nur der zweite Fall braucht Code-Switching.
- Wenn es eine Sprache ist, legen Sie diese Sprache explizit fest. Nutzen Sie
model=nova-3mit dem konkreten Code —language=pafür Punjabi,language=nefür Nepali,language=hyfür Armenisch. Lassen Sie es nicht auf automatischer Erkennung; Sie kennen die Antwort, und sie dem Modell mitzuteilen kostet nichts. - Wenn wirklich gemischt wird, prüfen Sie die Sprache gegen die Zehnerliste. Setzen Sie
language=multinur, wenn jede Sprache im Raum unter Englisch, Spanisch, Französisch, Deutsch, Hindi, Russisch, Portugiesisch, Japanisch, Italienisch und Niederländisch vorkommt. Fehlt eine, hilft Ihnenmultinicht, und das Modell der dominanten Sprache ist Ihre beste verfügbare Option. - Setzen Sie für Live-Sitzungen mit
multiden Wertendpointing=100. Deepgrams eigener Code-Switching-Leitfaden empfiehlt 100 ms speziell für Code-Switching, entgegen dem höheren Standardwert. Längeres Endpointing führt dazu, dass eine Passage in der gewechselten Sprache im falschen Segment aufgeht. - Prüfen Sie Batch und Streaming getrennt, bevor Sie irgendetwas zusagen. Wie der 7. August gezeigt hat, ist eine Verbesserung des einen keine Verbesserung des anderen. Lassen Sie dieselbe 10-Minuten-Probe über beide Wege laufen und vergleichen Sie, statt anzunehmen, ein Changelog-Eintrag gelte für Ihren Weg.
Einen anderen Ausschnitt davon haben wir im Juni behandelt — Deepgrams Halbjahres-Update zu adaptiven Live-Sitzungen und Diarisierung, einschließlich der Steuerung UpdateListen, mit der eine laufende Sitzung ihre Sprachhinweise ohne Neuverbindung ändern kann. Schritt 2 oben und diese Fähigkeit ergänzen sich gut: Legen Sie die Sprache zu Beginn explizit fest und passen Sie sie mitten in der Besprechung an, wenn der Raum tatsächlich umschwenkt.
Fazit: Abdeckung ist keine Zahl mehr, sondern eine Matrix
Der erste Reflex beim Vergleich von Spracherkennungs-Engines ist die Suche nach der größten Zahl. Der Tokenizer von OpenAIs Whisper führt seit 2022 100 Sprach-Token — fast doppelt so viele wie die 58 von Nova-3 —, und dieser Vergleich sagt Ihnen fast nichts, denn Whisper hat keinen nativen Streaming-Pfad, und ein deklariertes Token ist kein validiertes Produktionsmodell. Nova-3 listet weniger Sprachen und liefert sie aus, pro Sprache, pro Modus, mit datierten Belegen.
Die Zahl, die die reale Abdeckung einer Engine beschreibt, ist keine Anzahl. Sie ist eine Matrix: Sprache × Modus × Qualitätsstufe. Achtundfünfzig Sprachen, jeweils einzeln. Zehn davon mischbar. Eine Sprache im Batch-Betrieb verbessert und nicht im Streaming, eine andere im Streaming und nicht im Batch — im selben Release, am selben Tag.
Die Frage für Ihre nächste Anbieterprüfung lautet daher nicht „Wie viele Sprachen unterstützen Sie?“. Sie lautet: Für meine Sprache, auf meinem Weg, mit welchem Stand?
Wo Telli.sh ins Bild kommt: All das ist Detailwissen auf Engine-Ebene, und wir finden, die meisten Teams sollten nichts davon wissen müssen. Telli.sh sitzt auf dieser Ebene auf und trifft die Entscheidungen aus der obigen Liste für Sie — es wählt das dedizierte Modell, wenn die Besprechung eine Sprache hat, hält Batch-Uploads und Live-Sitzungen auf ihren jeweils richtigen Wegen und übernimmt Engine-Verbesserungen wie die vom August in der Woche ihrer Veröffentlichung statt erst bei Ihrer nächsten Migration. Auf dem Transkript setzt Live-Übersetzung in 44 Zielsprachen auf, dazu eine Oberfläche in 15 Sprachen — damit die Person, die aus Warschau zu Ihrem Punjabi-Standup dazukommt, live auf Polnisch mitliest.
Live übersetzte Besprechungsnotiz starten
Quellen
- Deepgram changelog, August 4, 2026 — Nova-3 Model Update — Punjabi (
pa,pa-IN) und Nepali (ne), Batch und Streaming beide verfügbar - Deepgram changelog, August 7, 2026 — Nova-3 Adds Armenian, Plus Improved Models for Tamil, Indonesian, and Belarusian — Armenisch (
hy) neu; verbesserte Batch-Modelle für Tamil und Indonesisch; verbesserte Streaming-Modelle für Tamil und Belarussisch - Deepgram Models & Languages Overview — vollständige Sprachtabellen für Nova-3 und Nova-2 sowie die
multi-Sprachliste, abgerufen am 31. August 2026 - Deepgram Multilingual Codeswitching guide — Einsatz von
language=multiund die Empfehlungendpointing=100, abgerufen am 31. August 2026 - Deepgram Self-Hosted release 251210, December 10, 2025 — „Nova-3 now supports 31 total languages“; mehrsprachiges Keyterm Prompting bis zu 500 Token
- Deepgram Self-Hosted release 251118, November 18, 2025 — 11 neue Sprachen sowie das Spracherkennungsmodell für 36 Sprachen
- Deepgram Self-Hosted release 260129, January 29, 2026 — 12 neue Nova-3-Sprachen, darunter Belarussisch, Bengalisch, Bosnisch und Kroatisch
- Deepgram Self-Hosted release 260319, March 19, 2026 — Thai und Kantonesisch
- Deepgram Self-Hosted release 260430, April 30, 2026 — Gujarati
- Deepgram Self-Hosted release 260812, August 12, 2026 — das Self-Hosted-Bundle mit Nepali und Punjabi, acht Tage nach dem Cloud-Eintrag
- OpenAI Whisper tokenizer language table — 100 deklarierte Sprach-Token, abgerufen am 31. August 2026
- Wikidata property P1098 (number of speakers) — von Ethnologue abgeleitete Sprecherzahlen für
pa,ne,hy,ta,id,be, abgerufen am 31. August 2026 - Unsere Berichterstattung vom Juni 2026 zu Deepgrams Updates für Live-Sitzungen und Diarisierung