Czy głosowa AI działająca bez internetu na Macu zaczeka na swoją kolej?
Sophon-Realtime na Apple Silicon przetwarza dźwięk lokalnie. W próbnej rozmowie sprawdź osobno pamięć, czas reakcji, echo i możliwość przerwania wypowiedzi.
Wyobraź sobie ćwiczenie rozmowy rekrutacyjnej przy kuchennym stole. Zaczynasz wyjaśniać, jak udało Ci się rozwiązać problem, robisz krótką pauzę, żeby znaleźć słowo, a rozmówca wchodzi Ci w zdanie, jakby odpowiedź już się skończyła. Chwilę później próbujesz go poprawić, ale dalej mówi. Obie sytuacje zdarzają się nawet w aplikacji, której głos brzmi znakomicie na odtworzonych nagraniach.
13 listopada 2026 r. Adventists AI ogłosiło lokalną wersję Sophon-Realtime na Maca. Model głosowy Flash-4bit działa na Apple Silicon przy użyciu środowiska MLX od Apple. Projekt zaleca dla tej wersji co najmniej 36 GB pamięci zunifikowanej, wymienia funkcje zmiany rozmówcy i przerywania wypowiedzi oraz podaje, że instalacja pobiera około 24 GB plików modelu. Ogłoszone osobno 14 listopada hostowane API przetwarza rozmowę po stronie usługi.
Najciekawsze pytanie dotyczy przebiegu całej rozmowy bez połączenia z internetem. Krótka próbna rozmowa pomoże to sprawdzić. Zmierzymy oczekiwanie na pierwszy dźwięk odpowiedzi, osobno sprawdzimy moment przejęcia głosu, a potem przyjrzymy się zasobom dostępnym do innych prac na tym samym komputerze.
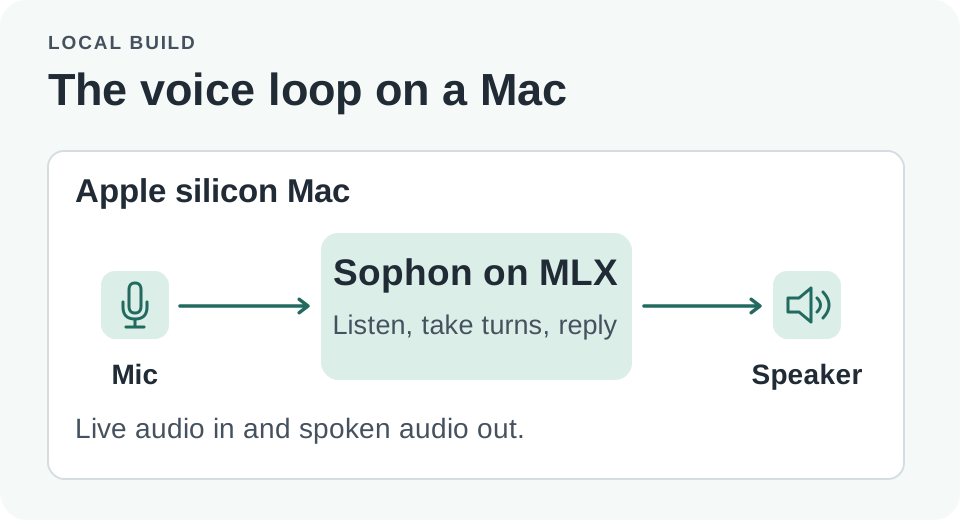
Po instalacji wersja lokalna przetwarza dźwięk na urządzeniu. Hostowane API korzysta z odrębnej ścieżki.
Jak zmierzyć deklarowaną sekundę?
Dla M4 Max z 36 GB zespół podaje 0,9–1,1 sekundy od końca wypowiedzi do pierwszego dźwięku, gdy model jest pewien, że użytkownik skończył. Gdy potrzebuje więcej czasu na podjęcie decyzji, podaje oczekiwanie do około 2,5 sekundy. To wyniki projektu z tej konkretnej konfiguracji. Przed próbą odtworzenia wyniku zdecyduj, kiedy przyjmujesz koniec wypowiedzi. Na nagraniu możesz oznaczyć ostatnią słyszalną sylabę. System sam określa, kiedy kończy się kolej użytkownika. Te znaczniki może dzielić pauza zupełnie naturalna dla człowieka. Karta modelu na Maca.
Czas do pierwszego dźwięku obejmuje wszystko między końcem Twojej wypowiedzi a początkowym słyszalnym fragmentem odpowiedzi. Czasem opóźnienie wynika z pracy modelu, czasem z oczekiwania na potwierdzenie, że użytkownik skończył. Nawet szybki model może przerywać przy każdej pauzie, jeśli za wcześnie uznaje ciszę za koniec. Dobrze działający system bywa ostrożniejszy tam, gdzie trudno rozpoznać zmianę rozmówcy. Sam stoper nie mówi, z którym rozmawia się wygodniej.
Weź pytanie „Dlaczego zdecydowaliście się na pamięć podręczną?”. Odpowiedz krótko, zakończ wyraźnie i zaczekaj na aplikację. Za drugim razem powiedz „Wybraliśmy pamięć podręczną, ponieważ…” i zrób pauzę w połowie zdania. Za trzecim powtórz odpowiedź przy pracującym wentylatorze. Aplikacja może uzyskać dobry czas do pierwszego dźwięku przy pierwszej próbie i kiepsko wypaść przy dwóch pozostałych. Porównuj czasy po sprawdzeniu, czy odpowiedź zaczyna się we właściwym momencie.
| Sytuacja w rozmowie | Co zanotować | Co pozwala sprawdzić |
|---|---|---|
| Odpowiedź wyraźnie zakończona | Czas od ostatniej sylaby do pierwszego słyszalnego dźwięku | Czy po skończonej wypowiedzi czeka się zbyt długo |
| Pauza w połowie zdania | Czy asystent zaczekał, czy zaczął mówić | Czy cisza oznacza dla systemu zgodę na zabranie głosu |
| Poprawka podczas odtwarzania | Czas do zatrzymania dźwięku i przyjęcie poprawki | Czy użytkownik może odzyskać głos |
| Mikrofon przechwytuje dźwięk z głośnika | Samoczynne odpowiedzi lub powtarzanie tekstu | Jak działa echo w danym pomieszczeniu |
Te obserwacje można zebrać w domu z własnym głosem. Zapisz warunki wraz z danymi. Głośniki i słuchawki tworzą różne warunki dla echa. Wentylator to próba w praktycznej, trudniejszej sytuacji. Porównanie z opóźnieniami na serwerach wymaga kontrolowanego pomiaru według odrębnej metodyki.
Sprawdź obie części przerwania odpowiedzi
Sophon opisuje wersję na Maca jako działającą w pełnym dupleksie, z obsługą wchodzenia w słowo i redukcją echa. Przydatne przerwanie wymaga zatrzymania dźwięku i zachowania nowej informacji. System, który po słowach „Przepraszam, chodziło mi o wtorek” od razu milknie, ale dalej analizuje czwartek, rozwiązał tylko połowę problemu.
W próbnej rozmowie poproś o dłuższy dalszy wywód, a potem powiedz „Chwileczkę, mówię o migracji bazy danych, nie o premierze dla klientów”. Sprawdź, czy asystent przestał mówić, czy przyjął korektę i czy następne pytanie ją uwzględniło. Spróbuj przerwać konkretną poprawką oraz krótkim dźwiękiem, takim jak kaszel. Aplikacja powinna umieć rozróżnić te zdarzenia. Dobra reakcja w jednej próbie może ukrywać skłonność do gwałtownego przerywania odtwarzania w zwykłym otoczeniu.
Echo sprawdź oddzielnie od wchodzenia w słowo. Wypróbuj słuchawki i głośniki przy komfortowej głośności. Jeśli krótkie potwierdzenie samo uruchamia kolejny odcinek nagrania, ustawienie mikrofonu lub redukcja echa mogą mieć większe znaczenie niż mniejszy model. Zmieniaj sprzęt, model i ustawienia dźwięku pojedynczo. Dzięki temu ustalisz, dlaczego następna próba poszła lepiej lub gorzej.
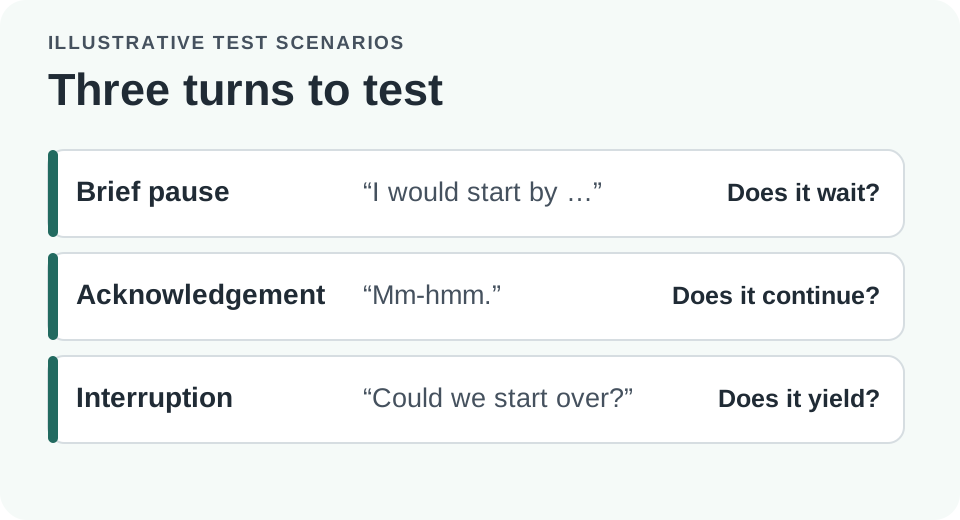
Osobno sprawdź krótką pauzę i celową poprawkę. W obu może pojawić się cisza, lecz aplikacja powinna zareagować inaczej.
Zapas pamięci wpływa na wygodę używania wersji na Maca
Na Apple Silicon lokalna wersja korzysta z MLX i ma zalecenie co najmniej 36 GB pamięci zunifikowanej. Około 24 GB pobieranych plików oznacza zajętość dysku. Zużycie pamięci podczas pracy może być inne. Model, bufory, dźwięk i pozostałe aplikacje współdzielą zasoby. Instrukcja instalacji na Macu.
Przy pierwszej próbie zamknij aplikacje zużywające dużo pamięci i użyj krótkiego scenariusza. W Monitorze aktywności obserwuj obciążenie pamięci i to, czy rośnie użycie pliku wymiany. Potem otwórz aplikacje, które faktycznie będą działały równolegle z asystentem, i powtórz próbę. Nawet jeśli model się uruchamia, rosnące obciążenie pamięci lub zacinający się dźwięk mogą utrudnić codzienną pracę. Szukaj wygodnej konfiguracji. Jednorazowy udany start na słabszym sprzęcie to zbyt mało, by go polecić.
16 listopada projekt ogłosił osobne warianty 4B na konsumenckie karty graficzne. Informacje o wydaniu odróżniają te warianty GPU od wersji 32B Flash-4bit MLX na Maca. Mniejsze zapotrzebowanie na VRAM w innym środowisku nie zmienia zalecenia dla Maca. Dane z hostowanego API, serwerowych GPU i lokalnego MLX różnią się też modelem oraz warunkami obciążenia. Przed zestawieniem liczb z repozytorium wybierz dokładnie tę wersję, której chcesz używać.
W pracy z mową liczy się też oficjalna lista języków. Repozytorium wymienia koreański jako planowany. Pierwszą próbę zrób w udokumentowanym języku, na przykład po angielsku. Sam fakt, że model obsługuje wiele języków, nie daje pewności co do jakości głosu, rozpoznawania i płynnej zmiany rozmówcy w każdym z nich. Jeśli potrzebujesz rozmów po koreańsku, obecne wydanie pozwoli opracować próbę, a wsparcie koreańskiego trzeba potwierdzić oddzielnie.
Sprawdź tryb offline po pobraniu plików
Do przygotowania potrzebujesz internetu, aby pobrać zależności projektu i wagi modelu. Postępuj według instrukcji, przeczytaj skrypty przed uruchomieniem i sprawdź, gdzie zostaną zapisane pliki. Dostęp do mikrofonu na urządzeniu ustawia się oddzielnie od modelu. Zacznij od własnego dźwięku i pytaj o zgodę, zanim nagrasz inną osobę.
- Postępuj według instrukcji dla Maca, najlepiej z wybraną i zapisaną wersją projektu. Poczekaj na koniec pobierania i przeprowadź jedną rozmowę w obsługiwanym języku przy działającym połączeniu.
- Po zakończeniu konfiguracji odłącz sieć. Uruchom nową lokalną sesję i sprawdź, czy na nowe pytania głosowe pojawiają się nowe odpowiedzi zamiast zapisanych próbek.
- Przećwicz kilka pełnych odpowiedzi, pauz w połowie zdania i poprawek przy tych samych ustawieniach mikrofonu i głośnika. Zanotuj model urządzenia, pamięć, błędy i zmierzone czasy.
- Powtórz część próby z codziennym zestawem otwartych programów. Jeśli rośnie opóźnienie lub pogarsza się dźwięk, sprawdź obciążenie pamięci i pozostałe różnice między próbami przed sformułowaniem wniosku.
Deweloperzy mogą wypróbować projekt bez konfiguracji lokalnego modelu. To przydatne przy porównaniu interakcji lub budowie integracji. W tej wersji aplikacja wysyła dźwięk do usługi, która ma własne warunki sieciowe i zasady prywatności. Przejście między usługą a wierszem poleceń na Macu zmienia zarówno miejsce przetwarzania dźwięku, jak i sposób uruchomienia. Ogłoszenie hostowanego API z 14 listopada.
Tryb offline może ograniczyć ilość danych opuszczających urządzenie, co przydaje się podczas powtarzania poufnej rozmowy lub budowy prototypu, który ma działać przy słabym połączeniu. Sprawdź, co klient przechowuje na dysku, w tym nagrania, transkrypcje i dzienniki. Próba po odłączeniu sieci może potwierdzić działanie rozmowy bez internetu. Pozostałe właściwości prywatności przyszłej aplikacji wymagają odrębnej weryfikacji.
Drugie zastosowanie to prototyp formularza głosowego. Załóżmy, że osoba odpowiada na cztery pytania i przed przejściem dalej może zmienić ostatnią odpowiedź. Aplikacja powinna trzymać przyjętą odpowiedź oddzielnie od najnowszej interpretacji modelu. Gdy poprawka padnie w trakcie odtwarzania, właściwe pole należy zmienić po zrozumieniu jej treści. Obsługa głosowa ułatwia pracę bez użycia rąk. O tym, kiedy robocza odpowiedź trafia do formularza, nadal decyduje aplikacja.
Przed porównaniem dwóch wersji zapisz warunki zaliczenia próby. Przykładowo system ma zaczekać przez zaplanowaną pauzę, zatrzymać odtwarzanie po rzeczywistej poprawce i zadać następne pytanie o zmieniony temat. Zanotuj osobno liczbę ukończonych prób. Przy dostatecznej liczbie powtórzeń w podobnych warunkach użyj mediany i rozstępu czasów. Rejestruj też powtórki, żeby wynik nie opierał się na najczystszej wymianie. W małej domowej próbie konkretna nieudana wypowiedź często mówi więcej niż pojedyncza średnia.
Porównuj ten sam scenariusz w sieci i bez niej. Hostowana usługa daje punkt odniesienia dla prototypu, któremu brakuje pamięci na obsługę mowy lokalnie. Jeśli używa innego głosu, konfiguracji tur, modelu lub dostępu do urządzenia, odnotuj różnice. Mniejsze opóźnienie w jednej wersji nie rozstrzyga, która poradzi sobie lepiej podczas zawahania użytkownika albo bez internetu. Wyniki mają pomóc dobrać rozwiązanie do danej aplikacji.
Warto zapewnić prototypowi jasny sposób powrotu do pracy. Użytkownik może przerwać wypowiedź asystenta i zamilknąć. Krótki sygnał wizualny lub lokalny wskaźnik stanu pokaże, że aplikacja nadal słucha i czeka. Jeśli urządzenie audio zostanie odłączone lub model zakończy działanie z braku pamięci, sprawdź, czy aplikacja przechodzi do przewidywalnego stanu oczekiwania przed uruchomieniem kolejnej sesji. Czas powrotu mierz oddzielnie od opóźnienia odpowiedzi. Szybki system w prostych przypadkach może nadal przeszkadzać, jeśli rozmowa odbiega od scenariusza.
Dobra rozmowa na urządzeniu zostawia miejsce dla mówiącego
Najbardziej wymowna próba może potrwać niecałą minutę. Zacznij odpowiedź, zrób przerwę, dokończ zdanie i pozwól asystentowi zabrać głos. Zmień jeden szczegół, gdy jeszcze mówi. Jeśli każdy etap przebiega zgodnie z zamiarem, głos staje się wygodnym sposobem obsługi aplikacji. Wersja na Maca pozwala sprawdzić to lokalnie na sprzęcie z odpowiednią pamięcią. Efekt zależy od komputera, języka, otoczenia i oprogramowania.
Źródła
- Projekt Sophon-Realtime i informacje o wydaniach z 13, 14 i 16 listopada
- Oficjalna instrukcja konfiguracji Apple Silicon i MLX
Trzymaj pytania, notatki z próbnych rozmów i wyniki lokalnych testów w jednym miejscu. Utwórz pierwszą notatkę w Telli.sh.