Un’IA vocale offline sul Mac sa aspettare il suo turno?
La versione Apple Silicon di Sophon-Realtime gestisce la voce in locale. Una simulazione di colloquio aiuta a distinguere memoria, latenza, eco e interruzioni.
Immagina di esercitarti per un colloquio di lavoro al tavolo della cucina. Cominci a spiegare come hai risolto un problema, ti fermi per cercare la parola giusta e chi ti fa il colloquio interviene come se avessi finito. Poco dopo provi a correggerlo e continua a parlare sopra di te. Entrambi i problemi possono presentarsi in un’app vocale che, riascoltata in seguito, sembra rispondere benissimo.
Il 13 novembre 2026 Adventists AI ha annunciato una versione locale per Mac di Sophon-Realtime. Abbina il modello vocale Flash-4bit all’ambiente di esecuzione MLX di Apple su Apple Silicon. Il progetto consiglia almeno 36 GB di memoria unificata, indica fra le funzionalità l’alternanza dei turni di parola e la possibilità di interrompere e spiega che la configurazione per Mac scarica circa 24 GB di file del modello. L’API ospitata annunciata separatamente il 14 novembre elabora il flusso vocale sul servizio remoto.
La domanda interessante riguarda l’intero scambio: senza rete, funziona come una conversazione? Un breve colloquio simulato aiuta a scoprirlo. Misureremo l’attesa fino alla prima risposta udibile e, separatamente, verificheremo quando l’app decide di parlare. Poi vedremo quante risorse restano per il resto del lavoro sul computer.
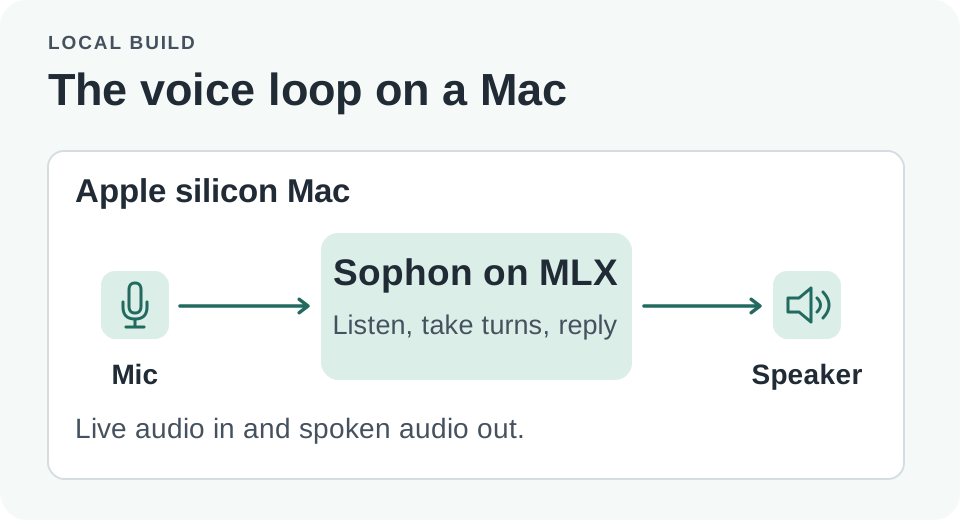
Dopo la configurazione, l’elaborazione locale dell’audio rimane sul dispositivo. L’API ospitata usa il servizio remoto.
Come misuri il secondo stimato?
Per un M4 Max con 36 GB, la scheda del modello per Mac indica da 0,9 a 1,1 secondi dalla fine del parlato al primo audio quando il modello ritiene concluso il turno. Se gli serve più tempo per decidere, riporta attese fino a circa 2,5 secondi. Sono i risultati del progetto per quella configurazione. Prima di riprodurre la prova, definisci quando il parlato si considera finito. In una registrazione puoi segnare l’ultima sillaba udibile. Il sistema decide autonomamente quando termina il turno in ingresso. Fra i due istanti può esserci una pausa del tutto naturale per una persona.
Il ritardo fino al primo audio comprende tutto ciò che accade tra la fine del tuo intervento e il primo suono della risposta del modello. Una parte del tempo può servire al modello per elaborare, un’altra per stabilire se il turno si è concluso. Anche un modello veloce può interromperti a ogni pausa se interpreta troppo presto il silenzio come fine della risposta. Un sistema ben regolato può prendersi un po’ più di tempo quando il passaggio di turno è incerto. Il cronometro da solo non basta per capire quale conversazione è andata meglio.
Prendi la domanda «Perché avete scelto di usare una cache?». Rispondi brevemente, chiudi con decisione e lascia rispondere l’app. Al secondo tentativo, di’ «Abbiamo scelto di usare una cache perché…» e fai una pausa prima di continuare. Al terzo, dai la stessa risposta con un ventilatore acceso vicino a te. Un’app può avere lo stesso ritardo fino al primo audio nel primo caso e funzionare male negli altri due. Confronta i tempi dopo aver verificato che abbia iniziato a parlare al momento giusto.
| Evento durante la conversazione | Cosa registrare | Perché conta |
|---|---|---|
| Una risposta chiaramente conclusa | Tempo dall’ultima sillaba al primo audio di risposta | Indica se l’attesa dopo un turno concluso sembra lunga |
| Una pausa a metà frase | L’assistente ha aspettato o ha iniziato a rispondere? | Mostra se interpreta il silenzio come un via libera a parlare |
| Una correzione durante la riproduzione | Quanto impiega a tacere e se capisce la correzione | Verifica se chi usa l’app può riprendere la parola |
| Audio riprodotto captato dal microfono | Eventuali risposte autoattivate o testo ripetuto | Mostra come si comporta l’eco nella stanza |
Puoi rilevare questi dati a casa con la tua voce. Annota condizioni e misure insieme. Altoparlanti e cuffie creano percorsi diversi per l’eco. Il ventilatore è una prova pratica sotto stress. Per un benchmark vocale standardizzato o un confronto con le latenze dei server servono condizioni controllate.
La prova delle interruzioni ha due parti
Sophon descrive la versione per Mac come full duplex e cita la possibilità di intervenire mentre il sistema parla e la cancellazione dell’eco. In un’app interattiva, interrompere è utile se l’output si ferma e l’informazione nuova viene recepita. Un sistema che tace subito dopo «Scusa, intendevo martedì» e poi continua a ragionare su giovedì ha risolto solo metà del problema.
Durante il colloquio simulato, chiedi un approfondimento lungo e poi di’ «Aspetta, sto parlando della migrazione del database, lasciamo da parte il lancio al cliente». Annota se la risposta si ferma, se l’app riconosce la correzione e se la domanda successiva ne tiene conto. Prova a interrompere con una correzione che cambia il senso e con un rumore breve come un colpo di tosse. L’app dovrebbe poterli trattare come eventi diversi. Superare il primo test può nascondere quanto facilmente il sistema interrompa l’audio in una stanza reale.
Eco e interruzione si provano separatamente. Testali entrambi in cuffia e poi con gli altoparlanti a un volume confortevole. Se una conferma dell’assistente avvia da sola un nuovo turno di registrazione, spostare il microfono o cambiare il sistema di cancellazione dell’eco può incidere più di un modello piccolo. Cambia una sola cosa alla volta tra hardware, modello e impostazioni audio. Al tentativo successivo potrai capire cosa è migliorato o peggiorato.
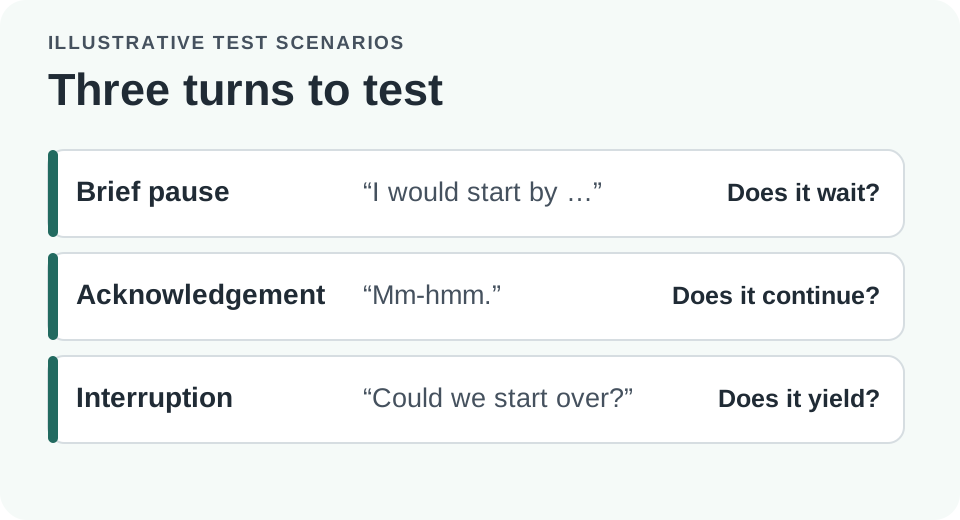
Prova separatamente una pausa e una correzione intenzionale. Entrambe possono includere del silenzio, ma l’app dovrebbe reagire in modo diverso.
Sul Mac la memoria incide sull’esperienza d’uso
La guida all’installazione per Mac descrive la configurazione Apple Silicon con MLX e consiglia almeno 36 GB di memoria unificata. I circa 24 GB del download indicano spazio su disco. La memoria effettiva occupata durante l’uso va misurata a parte. Il modello, le cache, l’elaborazione audio e le altre applicazioni condividono le risorse.
Per la prima prova, chiudi le app che occupano molta memoria e usa un breve copione. In Monitoraggio Attività controlla la pressione della memoria e verifica se aumenta lo swap durante la prova. Poi apri gli strumenti che useresti normalmente insieme all’assistente e ripeti. Anche quando il modello si carica, la pressione sulla memoria o i difetti di riproduzione possono rendere l’esperienza inadatta all’uso regolare. Cerca la configurazione con cui puoi lavorare senza problemi. Riuscire ad avviare il programma è solo il primo controllo.
Il 16 novembre il progetto ha annunciato varianti separate da 4 miliardi di parametri per le GPU consumer. Le note di rilascio le distinguono dalla versione 32B Flash-4bit MLX per Mac. Un fabbisogno di VRAM più basso su un altro ambiente di esecuzione lascia invariata la raccomandazione per Mac. I risultati dell’API ospitata, delle GPU server e di MLX in locale riguardano inoltre modelli e condizioni di carico diversi. Prima di interpretare i numeri del repository, individua la configurazione che vuoi usare.
In un flusso vocale, verifica anche le lingue supportate ufficialmente. Il repository indica il coreano come pianificato. Per la prima prova usa una lingua già documentata, come l’inglese. Per altre lingue occorre controllare a parte la voce, il riconoscimento e l’alternanza dei turni. Se ti serve fare colloqui in coreano, la versione attuale aiuta a impostare il test della conversazione. La convalida del coreano dovrà aspettare il relativo supporto.
Prova a usare l’app offline dopo il download
La preparazione richiede la rete per scaricare dipendenze e pesi del modello, come spiega la guida per Mac. Segui le istruzioni del progetto, esamina gli script prima di installarli e verifica dove verranno salvati i file locali. I permessi del microfono si gestiscono separatamente dall’installazione. Per iniziare usa audio su cui hai il controllo e chiedi il consenso prima di registrare altre persone.
- Segui la guida per Mac, indicando una revisione precisa del progetto quando possibile. Lascia terminare i download documentati e, mentre sei ancora connesso, prova uno scambio in una lingua supportata.
- Disconnettiti dalla rete una volta terminata la configurazione. Avvia una nuova sessione locale e verifica che a nuove domande vocali corrispondano risposte nuove, distinte dagli esempi già in cache.
- Prova più risposte complete, pause a metà frase e correzioni con le stesse impostazioni di microfono e altoparlante. Annota il dispositivo, la memoria, gli errori e i tempi osservati.
- Ripeti un breve tratto con le app che usi di solito aperte. Se latenza o audio peggiorano, controlla la pressione della memoria e le condizioni della prova prima di trarre conclusioni.
L’annuncio dell’API ospitata del 14 novembre offre a chi sviluppa un modo per provare il progetto senza configurare un modello locale. Può servire per confrontare un’interazione o sviluppare un’integrazione. In questo caso l’app invia l’audio a un servizio con condizioni proprie per la privacy e la rete. Passando dal servizio ospitato alla riga di comando del Mac, cambiano anche il percorso dei dati e le dipendenze necessarie.
L’uso offline può ridurre la quantità di dati che esce dal dispositivo. È utile per esercitarsi a raccontare qualcosa di delicato o per costruire un prototipo che funzioni con una connessione debole. Il client può comunque scrivere dati su disco. Controlla il comportamento per registrazioni, trascrizioni e log. Una prova senza rete dimostra che la conversazione può funzionare in quelle condizioni. Le altre caratteristiche di privacy dell’app richiedono verifiche proprie.
Un secondo uso è il prototipo di un modulo da compilare a voce. Supponi che una persona risponda a quattro domande e possa correggere l’ultima risposta prima di proseguire. L’app dovrebbe mantenere separata la risposta accettata dall’interpretazione più recente del modello. Se arriva una correzione mentre l’assistente parla, il campo corretto va aggiornato dopo averla compresa. Il flusso vocale senza mani può rendere più semplice l’interazione. È l’app a decidere quando una risposta preliminare entra nel registro.
Per confrontare due versioni, definisci prima le condizioni di riuscita. Puoi richiedere che l’assistente aspetti per tutta la pausa prevista, interrompa la riproduzione dopo una correzione effettiva e faccia la domanda successiva sul tema corretto. Annota a parte il numero di prove completate. Se le ripetizioni comparabili sono sufficienti, usa mediana e intervallo per i tempi. Registra i tentativi ripetuti e includi anche gli scambi con problemi. In una prova casalinga, osservare il singolo turno andato male spesso dice più di una media.
Per confrontare uso online e offline, prova lo stesso compito. Un servizio ospitato è un buon termine di confronto per un prototipo su un computer che non ha memoria sufficiente per l’audio locale. Indica eventuali differenze in voce, impostazioni dei turni, modello e accesso al dispositivo. Una latenza più bassa per una configurazione lascia aperta la domanda su quale funzioni meglio quando la persona esita o deve lavorare senza rete. Usa i risultati per orientare il progetto dell’app.
Vale anche la pena verificare come il prototipo si riprende dopo un problema. Immagina che la persona interrompa l’assistente mentre parla e poi resti in silenzio. Un breve segnale visivo o un indicatore di stato locale può mostrare che il sistema è in ascolto. Se si scollega un dispositivo audio o il modello si chiude per pressione sulla memoria, verifica che l’app torni a uno stato di attesa noto prima di avviare la sessione successiva. Misura la ripresa separatamente dal ritardo di risposta. Un sistema veloce nei turni regolari può comunque diventare frustrante quando la conversazione devia dal copione.
Un buon colloquio in locale lascia spazio a chi parla
La prova più indicativa può durare meno di un minuto. Inizia a rispondere, fai una pausa, termina, lascia parlare l’assistente e correggi un dettaglio mentre sta ancora rispondendo. Se ogni passaggio funziona come previsto, la voce comincia a sembrare un’interfaccia utile per conversare. La versione Mac permette di provarla in locale a chi ha memoria a sufficienza. Il risultato dipende ancora dal computer, dalla lingua, dalla stanza e dal software usato.
Fonti
- Progetto Sophon-Realtime e note di rilascio del 13, 14 e 16 novembre
- Guida ufficiale alla configurazione con Apple Silicon e MLX
Raccogli le domande del colloquio, gli appunti delle prove e le osservazioni sui test locali. Crea la tua prima nota con Telli.sh.