Une IA vocale hors ligne sur Mac sait-elle attendre son tour ?
La version Apple Silicon de Sophon-Realtime traite les échanges vocaux en local. Un entretien simulé permet d’évaluer la mémoire, le délai de réponse, l’écho et la gestion des interruptions.
Imaginez que vous répétiez un entretien d’embauche à la table de la cuisine. Vous expliquez comment vous avez résolu un problème, vous cherchez un mot et l’interlocuteur enchaîne comme si vous aviez terminé. Un peu plus tard, vous tentez de le corriger et il continue de parler. Les deux problèmes peuvent survenir dans une application vocale dont les réponses sont pourtant très agréables à réécouter.
Le 13 novembre 2026, Adventists AI a annoncé une version locale de Sophon-Realtime pour Mac. Elle associe son modèle vocal Flash-4bit au moteur MLX d’Apple sur Apple Silicon. Le projet recommande au moins 36 Go de mémoire unifiée pour cette version, indique qu’elle gère les tours de parole et les interruptions et précise que l’installation télécharge environ 24 Go de fichiers du modèle. L’API hébergée, annoncée séparément le 14 novembre, ne traite pas cet échange vocal sur votre Mac.
On cherche à savoir si tout l’échange se comporte comme une conversation sans utiliser le réseau. Un bref entretien simulé permet de l’essayer. On distinguera le délai nécessaire pour produire la première réponse parlée du moment où l’application choisit de prendre la parole. On regardera ensuite quelles ressources restent disponibles pour vos autres logiciels.
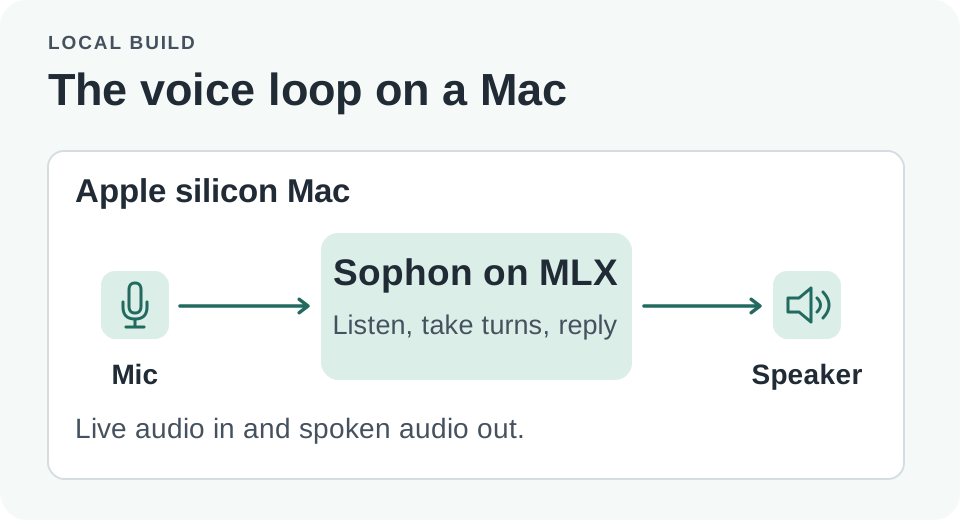
Après l’installation, la version locale traite le son sur l’appareil. L’API hébergée suit un autre chemin.
Comment mesurer le délai d’environ une seconde ?
Pour un M4 Max de 36 Go, la fiche du modèle Mac indique de 0,9 à 1,1 seconde jusqu’au premier son émis après l’arrêt de la parole lorsque le modèle est sûr que le tour est terminé. L’attente peut atteindre environ 2,5 secondes s’il met plus de temps à trancher. Ces résultats sont ceux du projet dans cette configuration. Avant d’essayer de les reproduire, définissez ce que signifie « arrêter de parler ». Dans un enregistrement, vous pouvez marquer la dernière syllabe audible. Le système détermine lui-même à quel moment le tour de l’utilisateur prend fin. Ces deux instants peuvent être séparés par une pause qui paraît naturelle à une personne.
Le délai avant le premier son couvre ce qui se passe entre la fin de votre phrase et le début de la réponse audible. Il peut venir du calcul du modèle ou du temps nécessaire pour déterminer que le tour est fini. Même un modèle rapide peut vous interrompre à chaque pause s’il traite trop tôt le silence comme une fin de réponse. À l’inverse, un système qui se comporte bien peut attendre un peu plus longtemps pour lever le doute. Un chronomètre seul ne suffit pas à juger le confort de l’échange.
Prenez la question « Pourquoi avez-vous choisi la mise en cache ? » Répondez brièvement, terminez de façon nette, puis laissez l’application répondre. Au deuxième essai, dites « Nous avons choisi la mise en cache parce que… » et marquez une pause avant de poursuivre. Au troisième, reprenez la même réponse près d’un ventilateur allumé. Une application peut obtenir un bon délai au premier essai et s’en sortir très mal dans les deux autres. Comparez les chronos après avoir vérifié qu’elle a commencé à parler au bon moment.
| Événement dans la conversation | Observation à consigner | Pourquoi c’est important |
|---|---|---|
| Réponse clairement achevée | Temps de la dernière syllabe à la première réponse audible | Indique si le temps mort après la fin du tour gêne |
| Pause au milieu d’une phrase | L’assistant a-t-il attendu ou commencé à répondre ? | Montre si le silence vaut permission de prendre la parole |
| Correction pendant la lecture | Délai avant l’arrêt de la réponse et bonne compréhension de la correction | Vérifie si l’utilisateur peut reprendre la parole |
| Son du haut-parleur capté par le micro | Nouveau tour déclenché par l’application elle-même ou texte répété | Montre comment se comporte l’écho dans la pièce |
Vous pouvez relever ces mesures à la maison avec votre propre voix. Indiquez les conditions en même temps que les chiffres. Le haut-parleur et le casque ne produisent pas le même écho. L’essai avec ventilateur est un test pratique dans une situation plus difficile. Un essai domestique sans environnement contrôlé ne suffit pas pour comparer la latence à celle d’un serveur.
Une interruption met à l’épreuve deux capacités
Sophon décrit le fonctionnement sur Mac comme bidirectionnel simultané, avec interruption de la réponse en cours et annulation de l’écho. En pratique, une bonne interruption exige que le son s’arrête et que la nouvelle information soit conservée. Si le système se tait au moment où vous dites « Pardon, je voulais dire mardi », puis poursuit son raisonnement sur jeudi, seule la première moitié du travail est faite.
Pendant l’entretien simulé, demandez une longue relance puis dites « Attendez, je parle de la migration de la base de données, pas du lancement chez le client. » Notez si la réponse s’arrête, si l’application prend acte de la correction et si sa prochaine question en tient compte. Essayez aussi avec un son bref, par exemple une toux. L’application devrait pouvoir distinguer ce bruit d’une correction. Un bon résultat au premier essai peut masquer une tendance à interrompre trop souvent la lecture dans une vraie pièce.
L’écho mérite son propre test, indépendamment de la reprise de parole. Essayez les deux au casque, puis avec un haut-parleur à volume confortable. Si le son d’un accusé de réception déclenche de lui-même un nouveau tour d’enregistrement, changer la place du micro ou le traitement de l’écho peut compter davantage que réduire la taille du modèle. Ne changez pas le matériel, le modèle et les réglages audio dans un même essai. Vous pourrez ainsi expliquer pourquoi le suivant se passe mieux ou moins bien.
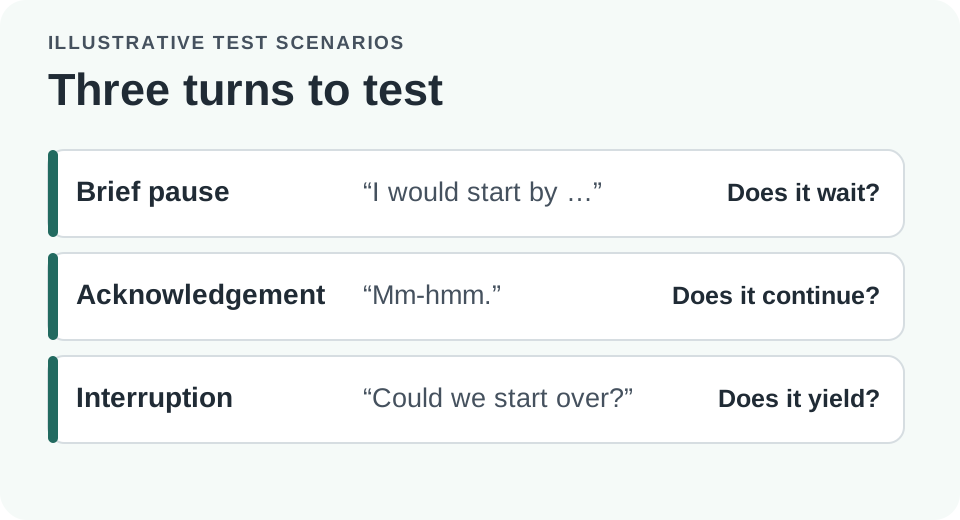
Testez séparément une pause et une correction volontaire. Les deux peuvent comporter un silence, mais l’application doit les traiter différemment.
Sur Mac, la mémoire disponible se ressent à l’usage
Le guide d’installation sur Mac décrit la version Apple Silicon avec MLX et recommande au moins 36 Go de mémoire unifiée. Le téléchargement d’environ 24 Go correspond à l’espace de stockage. La mémoire mobilisée pendant l’utilisation peut différer. Le modèle, les caches, le traitement audio et les autres applications partagent les ressources de la machine.
Pour commencer, fermez les logiciels gourmands en mémoire et utilisez un court scénario. Consultez la pression mémoire dans le Moniteur d’activité et regardez si la mémoire d’échange augmente pendant l’essai. Puis ouvrez les outils que vous garderiez normalement avec l’assistant et recommencez. Même si le modèle se charge, une pression mémoire croissante ou des coupures audio peuvent le rendre pénible au quotidien. Cherchez une configuration confortable au lieu de considérer la machine la plus modeste qui réussit à lancer le programme comme celle que le projet recommande.
Le 16 novembre, le projet a annoncé des variantes distinctes de 4 milliards de paramètres pour les GPU grand public. Les notes de version présentent ces possibilités séparément du modèle Mac de 32 milliards Flash-4bit avec MLX. Un besoin moindre en VRAM avec un autre moteur ne change pas la recommandation pour Mac. Les résultats d’une API hébergée, d’un GPU serveur et d’une installation MLX locale varient aussi selon le modèle et les conditions de trafic. Choisissez d’abord la version que vous voulez utiliser pour interpréter les chiffres du dépôt.
Les langues officiellement prises en charge comptent pour un outil vocal. Le dépôt indique que le coréen est prévu. Pour le premier essai, utilisez une langue documentée, comme l’anglais. La capacité multilingue d’un modèle ne garantit pas la même qualité des voix, de la reconnaissance et des tours de parole dans chaque langue. Si vous préparez des entretiens en coréen, la version actuelle peut servir à apprendre comment tester l’interaction. La prise en charge de la langue devra faire l’objet d’une validation distincte.
Testez le hors ligne après le téléchargement
La préparation nécessite une connexion pour récupérer les dépendances et les poids du modèle indiqués dans le guide Mac. Suivez les instructions du projet, relisez les scripts avant de les exécuter et repérez l’emplacement des fichiers locaux. Sur l’appareil, l’accès au micro fait l’objet d’une autorisation distincte de l’installation. Commencez avec du son que vous maîtrisez et recueillez l’accord des autres personnes avant de les enregistrer.
- Suivez le guide d’installation Mac, en utilisant une révision fixe du projet si possible. Attendez la fin des téléchargements et faites un essai dans une langue prise en charge pendant que l’appareil est connecté.
- Une fois l’installation terminée, coupez le réseau. Démarrez une nouvelle session locale et vérifiez que de nouvelles questions parlées obtiennent des réponses inédites.
- Répétez des fins de phrases nettes, des pauses au milieu des phrases et des corrections avec les mêmes réglages de microphone et de haut-parleur. Notez le modèle de la machine, la mémoire, les erreurs et les temps relevés.
- Refaites un court passage avec vos applications habituelles ouvertes. Si la latence ou le son se dégradent, regardez la pression mémoire et les différences de conditions avant de conclure.
L’annonce de l’API hébergée le 14 novembre offre aux développeurs un moyen d’essayer le projet sans installer de modèle local. C’est utile pour comparer une interaction ou développer une intégration. L’application envoie alors le son à un service qui a ses propres conditions réseau et de confidentialité. Passer du service hébergé à la ligne de commande Mac change l’environnement de l’essai et le parcours de l’audio.
L’usage hors ligne peut réduire les données qui quittent l’appareil, par exemple lorsque vous travaillez sur un récit sensible ou un prototype censé fonctionner avec une mauvaise connexion. Des fichiers peuvent toutefois être écrits sur le disque. Vérifiez ce que fait le client avec les enregistrements, les transcriptions et les journaux. Un essai déconnecté peut établir que la conversation fonctionne sans réseau. Pour les garanties de confidentialité d’une future application, il faut examiner d’autres aspects.
Un prototype de formulaire vocal fournit un deuxième cas d’usage. Imaginons que l’utilisateur réponde à quatre questions et puisse corriger la dernière réponse avant de passer à la suite. L’application devrait conserver la réponse acceptée à part de la dernière interprétation du modèle. Si une correction survient pendant la lecture, elle ne devrait modifier le bon champ qu’après avoir été comprise. Une interface mains libres facilite l’échange. L’application reste responsable du moment où le brouillon devient une donnée enregistrée.
Pour comparer deux versions, fixez les critères de réussite avant de lancer l’une ou l’autre. Vous pouvez attendre que l’assistant laisse passer la pause prévue, arrête de parler après une correction réelle et pose la prochaine question sur le sujet corrigé. Gardez à part le nombre d’essais terminés. Si vous avez assez de répétitions comparables, calculez la médiane et l’étendue des délais. Notez les reprises au lieu de ne retenir que l’échange le plus fluide. Dans un petit essai à domicile, le détail d’un tour raté renseigne souvent mieux qu’une moyenne unique.
Comparez les deux versions sur la même tâche. Un service hébergé sert de point de référence lorsqu’un prototype manque de mémoire pour traiter la parole localement. Indiquez les différences s’il utilise une autre voix, une autre configuration des tours, un autre modèle ou d’autres autorisations matérielles. Un délai plus court ne permet pas de savoir ce qui se passe si l’utilisateur hésite ou se retrouve sans connexion. Interprétez les résultats en fonction de l’application que vous développez.
Prévoyez aussi une façon claire de reprendre après un incident. Imaginez que l’utilisateur interrompe l’assistant puis se taise. Un indicateur visuel peut montrer que le système est à l’écoute. Si un périphérique audio est débranché ou si le modèle s’arrête par manque de mémoire, assurez-vous que l’application revient à un état de repos connu avant une nouvelle session. Mesurez la reprise séparément de la latence de réponse. Un système rapide quand tout va bien peut se révéler frustrant dès que l’échange s’écarte du scénario.
Un bon entretien en local laisse à chacun le temps de parler
L’essai le plus révélateur peut prendre moins d’une minute. Commencez à répondre, faites une pause, terminez, laissez l’assistant prendre la parole, puis changez un détail pendant qu’il parle. Si chaque transition se passe comme prévu, on commence à pouvoir utiliser la voix comme interface de conversation. La version Mac permet d’essayer cet échange hors ligne sur une machine suffisamment dotée en mémoire. Le résultat dépend encore de l’ordinateur, de la langue, de la pièce et du logiciel utilisés.
Sources
- Projet Sophon-Realtime et notes des 13, 14 et 16 novembre
- Guide officiel d’installation pour Apple Silicon et MLX
Regroupez vos questions d’entretien, notes d’entraînement et observations d’essai. Créez votre première note avec Telli.sh.